👋 关于作者
你好,这里是一条泥憨鱼 | 专注于 后端开发、AI 前沿技术与计算机基础 。
🏠 个人主页:一条泥憨鱼
通过技术博客记录技术成长,分享学习心得与经验。期待与您共同交流!
📚 精选技术专栏:
| ❄️后端开发 | ❄️Redis| 黑马点评 |
| ❄️从0开始学习计算机网络 | ❄️数据结构与算法 |
| ❄️苍穹外卖 | ❄️探秘AI与agent |
用户说的是“上周”,Agent 却把 startDate 填成了 2026-01-01,工具照常执行,链路毫无异常。这篇从这个安静的故障讲起,拆开模型生成参数不可信的原因、错误的三类形态、校验该落在哪一层,以及错误怎么回传才不会让 Agent 原地打转。
参数错误的三种来源
把参数错误当成一个整体来看是没法处理的,因为它们的拦截位置完全不同。按“错在哪一层”拆开,大致是三类。
第一类:格式合法但取值越界。 模型生成了一个长得像 ORD-2024-88731 的订单号,格式完全正确,只是这个订单号不存在;或者工具描述里列了 PENDING / PAID / SHIPPED / CLOSED 四个状态,模型生成了 PROCESSING。这类错误的共同点是:值域问题,结构上看不出毛病。JSON Schema 能告诉你 status 是 string,但如果你没写 enum,它不会告诉你 PROCESSING 不在白名单里;即使写了 enum,模型也可能在长上下文里把枚举值记串。
第二类:类型正确但语义错位。时间、单位、相对指代是重灾区。用户说“上周”,模型需要把它换算成一个具体区间,这一步涉及当前时间、时区、周起始日是周一还是周日,任何一环出错结果都是错的,但参数依然是一个合法的日期字符串。单位错位同样隐蔽:接口要的是毫秒时间戳,模型给了秒;金额字段要的是“分”,模型给了“元”。还有一类是指代错位,用户说“把这个订单取消掉”,上下文里有两个订单号,模型挑了错的那个。这些错误在类型层面完全合法。
第三类:结构正确但业务前置条件不满足。 参数全对,但当前状态不允许执行。订单已经是 CLOSED,工具却被调用来“取消订单”;用户没有该订单所属商户的操作权限;库存已经为 0 却要下单。这类问题连业务参数本身都没错,错的是“现在能不能做这件事”。
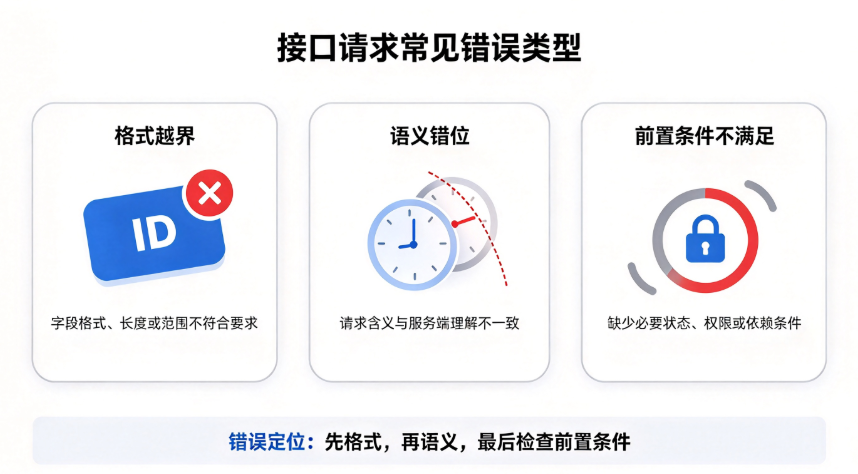
三类错误的共同点是:它们都发生在 JSON Schema 的视野之外。Schema 描述的是“数据长什么样”,不是“数据对不对”。把校验全部押在 Schema 上,等于只检查了信封有没有贴邮票,没检查里面装的是不是要寄的东西。
为什么模型天生不可靠
要理解为什么提示词治不了这个问题,得先看清楚模型在生成参数时到底在做什么。
模型做的是 token 概率采样,不是数据库查询。给它一段工具描述和用户意图,它逐个 token 地生成最可能的下一个字符。它内部没有一个“订单表”可以查,也就没有“知道这个 ID 不存在”的能力。它能做的,是生成一个在统计上看起来最像订单号的字符串。这就是为什么编造出来的 ID 往往格式极其逼真——它学的就是真实 ID 的分布。
这个机制决定了三件事。
其一,模型不会主动说“我不知道这个订单号”,因为它的输出目标不是表达不确定性,而是续写最可能的序列。
其二,temperature 只是把这个采样的分布调平或调尖,调低能让输出更确定,但确定地输出一个错误答案和随机地输出一个错误答案,对下游来说没有区别。
其三,上下文越长、工具越多、描述越含糊,采样时被干扰的因素就越多,参数串味的概率越高。
工具描述的歧义会直接放大问题。如果两个工具都叫“查询订单”,一个按订单号一个按用户 ID,模型选错的概率相当高;如果参数叫 date,没写清楚是下单时间还是支付时间,模型只能猜。这不是模型笨,是它拿到的信息本来就不足以确定。
所以指望用一句“请确保参数准确”的提示词解决问题,方向就错了。提示词能改善概率,不能提供保证。而副作用操作需要的是保证。
校验该放在哪一层
结论很直接:校验必须放在代码里,而且要分层。模型负责“提议”,代码负责“裁决”。
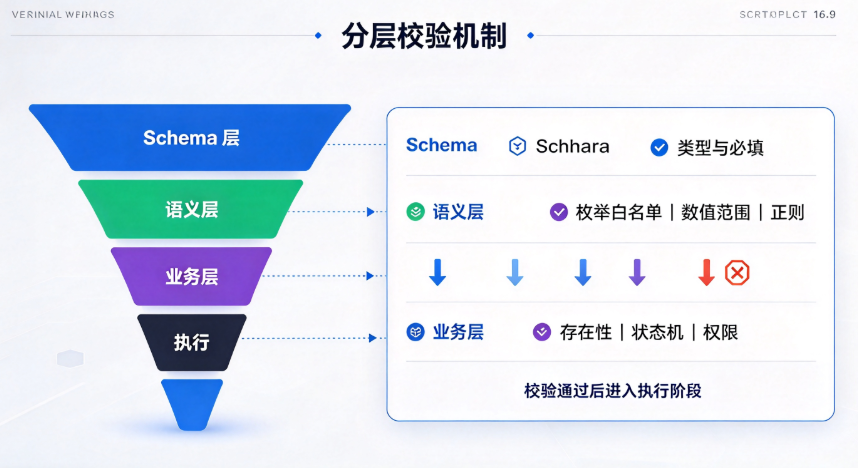
三层各自管什么,边界要划清楚:
Schema 层管类型、必填、基本结构。这一层最便宜,也最容易被当成全部。它能拦住“该给数组给了字符串”这种低级错误,但对取值一无所知。
语义层管值域。枚举必须写成白名单,数值必须有上下界,字符串必须过正则。这一层的关键是把“合法取值”显式写进代码,而不是留在工具描述里让模型自觉遵守。
业务层管现实世界。ID 存不存在要查库,状态机允不允许要判断,权限够不够要鉴权。这一层最贵,但它是唯一能拦住“订单号格式正确但不存在”的地方。
下面是一个把三层串起来的工具执行器骨架,用 Java 写,思路和语言无关:
public class OrderToolExecutor {
// 语义层:枚举白名单,不依赖模型自觉
private static final Set<String> ALLOWED_STATUS =
Set.of("PENDING", "PAID", "SHIPPED", "CLOSED");
public ToolResult execute(CancelOrderArgs args, UserContext user) {
// 1. Schema 层通常由框架完成,这里只做兜底
if (args.orderId() == null || args.orderId().isBlank()) {
return ToolResult.retryable("缺少 orderId,请从上下文中的订单号重新提取");
}
// 2. 语义层:格式与值域
if (!args.orderId().matches("^ORD-\\\\d{4}-\\\\d{5}$")) {
return ToolResult.retryable("orderId 格式应为 ORD-年份-5位数字,收到的值不合法");
}
if (args.targetStatus() != null && !ALLOWED_STATUS.contains(args.targetStatus())) {
return ToolResult.retryable("targetStatus 只能是 " + ALLOWED_STATUS);
}
// 3. 业务层:存在性、状态机、权限
Order order = orderRepository.findById(args.orderId()).orElse(null);
if (order == null) {
return ToolResult.retryable("订单 " + args.orderId() + " 不存在,请确认订单号");
}
if (!order.getStatus().equals("PENDING") && !order.getStatus().equals("PAID")) {
return ToolResult.fatal("订单当前状态为 " + order.getStatus() + ",不允许取消");
}
if (!permissionService.canOperate(user, order)) {
return ToolResult.fatal("当前用户无权操作该订单");
}
orderService.cancel(order);
return ToolResult.ok("订单 " + args.orderId() + " 已取消");
}
}
这段代码里有几个刻意的设计。业务层查库那一步不能省,因为它是唯一能确认“这个 ID 真实存在”的地方;状态判断放在存在性判断之后,因为对一个不存在的订单谈状态没有意义;权限判断放在最后,避免在无权限时泄露订单状态信息。
工具的参数定义里如果有 enum,一定要和代码里的白名单来自同一个常量源。两边各写一份,迟早会漂移,而漂移之后的错误极难排查——模型按描述生成的值被代码拒绝,日志里看起来像是模型不听话,实际是配置不一致。
错误回传给模型的方式
校验拦住之后,错误怎么返回,直接决定了 Agent 接下来是自我纠正还是原地打转。
第一个原则:返回可读、可纠正的信息,不要抛堆栈。模型看不懂 NullPointerException at OrderToolExecutor.java:47,但它能理解“订单 ORD-2024-88731 不存在,请确认订单号”。错误信息里应该包含三样东西:哪个参数错了、期望是什么、下一步该怎么做。
第二个原则:区分可重试和不可重试。参数错误、ID 不存在这类问题,模型拿到明确提示后有机会改对,属于可重试;权限不足、系统内部错误这类问题,重试多少次结果都一样,属于不可重试,应该直接终止并如实告知用户。
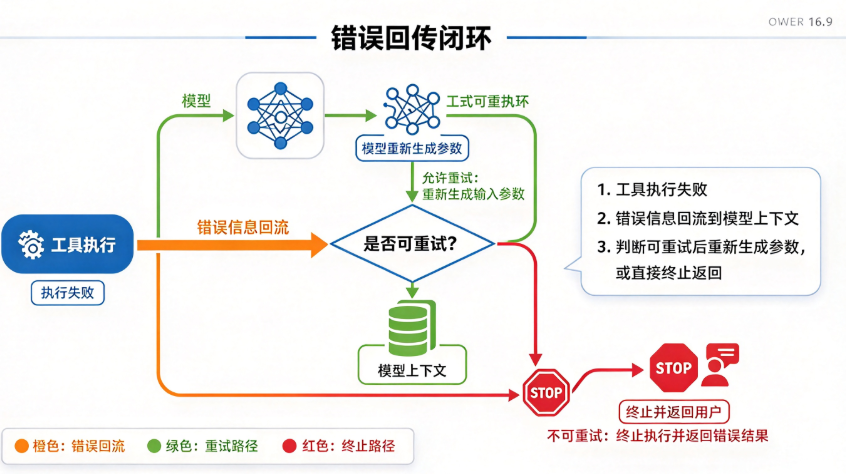
第三个原则,也是最容易被忽略的:必须有重试上限和降级策略。模型在收到“订单不存在”之后,很可能再编一个订单号,然后又被拒绝,如此循环。实际项目里这个循环能烧掉不少 token,还会让用户等很久。常见的做法是给同一个工具的调用次数设上限(比如 3 次),超限后不再把错误喂回模型,而是直接向用户输出“我没能完成这个操作,原因是……”。
// 伪代码:带重试上限的调用循环
int attempts = 0;
while (attempts < MAX_TOOL_ATTEMPTS) {
ToolCall call = model.nextToolCall();
ToolResult result = executor.execute(call);
if (result.isOk()) return result;
if (!result.isRetryable()) return fallbackToUser(result.message());
// 只有可重试错误才把信息喂回模型
model.appendToolResult(call.id(), result.message());
attempts++;
}
return fallbackToUser("多次尝试仍未成功,请人工确认参数");
result.isRetryable() 这个判断发生在把错误喂回模型之前。不可重试的错误一旦喂回去,模型往往会换个说法再试一次,徒增一轮无效调用。
判断方法
回到开头那个故障:如果查询工具在拿到 2024-01-01 时能问一句“这个日期和用户说的‘上周’对得上吗”,问题当场就会暴露。但工具没有用户原话,做不了这个判断,所以真正的防线应该更靠前——在把参数交给工具之前,先明确这个值是怎么来的、有没有被验证过。
可以迁移到任何 Agent 工具调用场景的判断方法是:凡是模型生成的参数要进入有副作用的操作之前,都问一句“这个值如果错了,下游能不能自己发现”。查询类工具错了顶多返回空结果,下游还有机会察觉;但取消订单、扣款、发消息这类操作,一旦执行就收不回来,下游没有任何机制能发现参数是错的。对后者,校验不能寄希望于模型自觉,必须在调用前用代码拦住,拦住之后再把清晰的错误交给模型去纠正。