/* MD / 富文本中的 .toc(含博客园搬家等嵌套结构);.toc-box 在侧栏,不受影响 */
#content_views .toc,
/* 编辑器常在目录前后插入空 p(:empty 仍占 20px),一并去掉避免顶空隙 */
#content_views.markdown_views > p:empty:has(+ .toc),
#content_views.markdown_views > .toc + p:empty,
/* 富文本旧版目录标记 */
#content_views.htmledit_views #main-toc,
#content_views.htmledit_views #hr-toc,
#content_views.htmledit_views p[id*=\”-toc\”] {
display: none !important;
}
/* 目录去掉后,紧跟的首个标题不再多出一块上边距 */
#content_views.markdown_views > .toc + h1,
#content_views.markdown_views > .toc + h2,
#content_views.markdown_views > .toc + h3,
#content_views.markdown_views > .toc + h4,
#content_views.markdown_views > .toc + p:empty + h1,
#content_views.markdown_views > .toc + p:empty + h2,
#content_views.markdown_views > .toc + p:empty + h3,
#content_views.markdown_views > .toc + p:empty + h4 {
margin-top: 0 !important;
}
Spring AI 2:ChatClient Advisors 把 Memory 与 RAG 串成链
多轮对话要记上下文、回答要检索私有知识时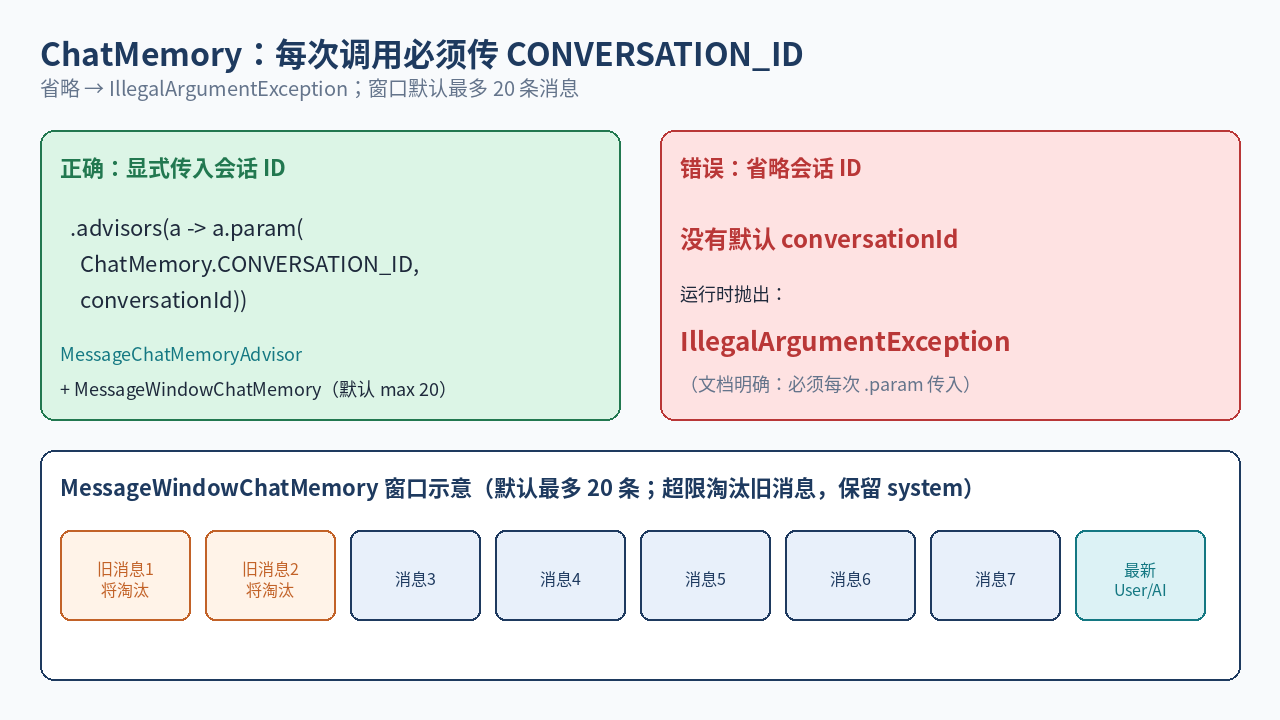
,用 defaultAdvisors 按序挂 Memory 与 QuestionAnswer,别漏 CONVERSATION_ID。
一、痛点:ChatClient 会调模型,但不会自动「记得」和「查库」
把业务接到 Spring AI 的 ChatClient 之后,第一周通常只做单轮问答。需求一加码就出现两件独立的事:
若把「拼接历史消息」和「先查向量再拼 Prompt」都写进 Service,很快就是满屏复制粘贴:每个入口都要取历史、裁剪窗口、拼系统提示,再决定要不要检索。工具调用一开更乱:中间轮次的消息进不进记忆、检索要不要看到工具结果,这些规则会散落在多个 if 里。
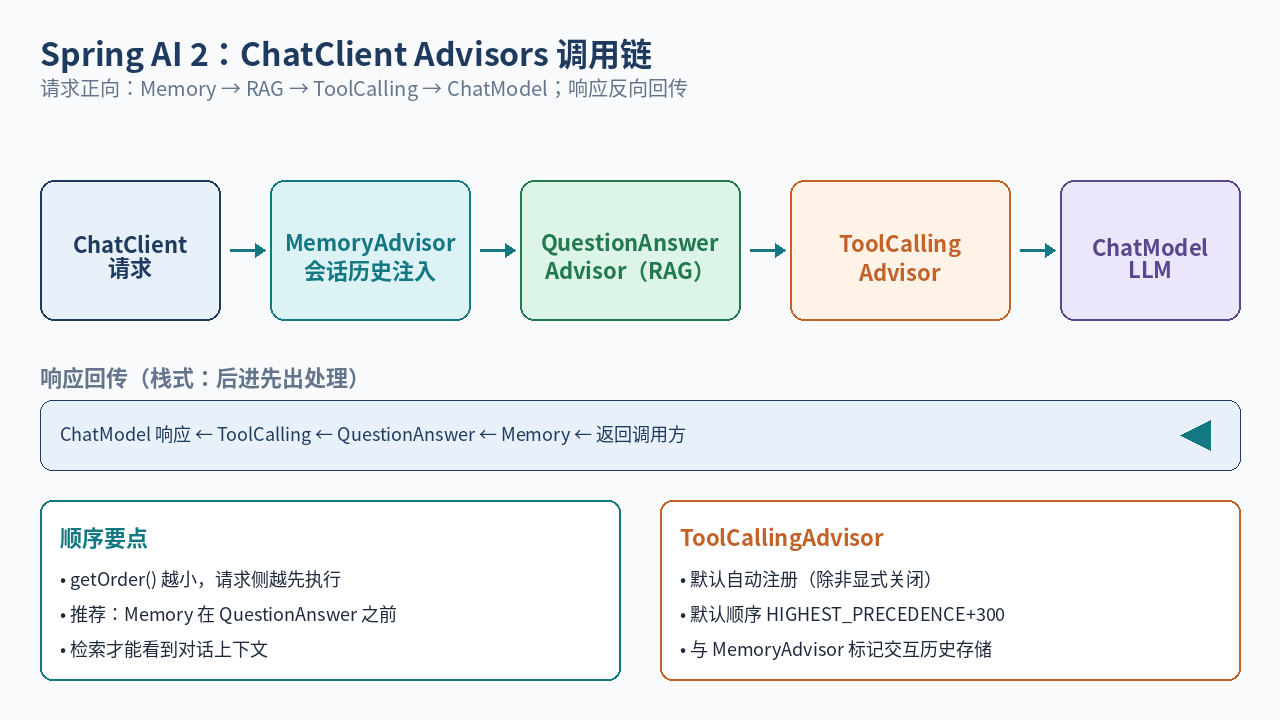
这两件事都适合做成 Advisor:在请求进模型前改 Prompt,在响应回来后写回状态。官方 Advisors 与 ChatClient 文档给出的组合是:MessageChatMemoryAdvisor 管会话历史,QuestionAnswerAdvisor(或模块化 RAG 的 RetrievalAugmentationAdvisor)管检索增强。下面依据 Spring AI 2.x 当前参考文档,只谈 Advisors 链、会话 ID、Memory/RAG 顺序与 ToolCalling 自动注册。MCP 工具如何显式接到 ChatClient,见本账号 2026-09-25 那篇。这里不重复绑定细节,也不宣称「装了 MCP starter 就会自动带上远程工具」。

二、注册:defaultAdvisors,顺序就是契约
推荐在 Builder 上用 defaultAdvisors(…) 注册,避免每个请求重复拼链:
@Configuration
public class ChatClientConfig {
private final ChatModel chatModel;
private final VectorStore vectorStore;
public ChatClientConfig(ChatModel chatModel, VectorStore vectorStore) {
this.chatModel = chatModel;
this.vectorStore = vectorStore;
}
@Bean
ChatClient chatClient() {
ChatMemory chatMemory = MessageWindowChatMemory.builder().build();
return ChatClient.builder(chatModel)
.defaultAdvisors(
MessageChatMemoryAdvisor.builder(chatMemory).build(),
QuestionAnswerAdvisor.builder(vectorStore).build())
.build();
}
}
MessageWindowChatMemory 默认窗口大约 20 条消息:超出后淘汰更早的消息,并尽量保留 system;若又写入新的 system,旧的 system 会被清掉,保证指令面不互相打架。需要持久化时,再换带 ChatMemoryRepository 的实现(内存 / JDBC / Redis / Mongo 等,见 Chat Memory 文档),Advisor 侧仍是同一套 MessageChatMemoryAdvisor。另一种 VectorStoreChatMemoryAdvisor 把记忆检索进 system 文本,适合超长历史的相关性召回。但它的语义和「整段消息列表回放」不同,选哪个要看模型是否擅长吃结构化历史。
顺序规则(Advisors API):
- getOrder() 越小,请求侧越先执行;
- 链是栈:请求正向穿过,响应反向穿过——先处理请求的 Advisor,最后处理响应;
- 同 order 值不保证相对次序,关键路径不要靠「碰巧的注册顺序」。
官方 ChatClient 文档对 Memory + RAG 的推荐很明确:先挂 Memory,再挂 QuestionAnswerAdvisor。这样检索查询能看到已经注入的对话上下文,不会只拿「当前这一句用户输入」做孤立检索。举个例子:用户第一句说「只看华东仓」,第二句说「库存多少」。如果 RAG 看不到第一句,检索词会缺少地域约束,答案质量会明显漂移。
更复杂的 RAG 可改用 RetrievalAugmentationAdvisor,并依赖 org.springframework.ai.rag(模块化 RAG)拼检索、增强与后处理;Naive RAG 场景 QuestionAnswerAdvisor.builder(vectorStore) 通常就够作为起点。Advisor 还接入可观测性,链路与指标里能看到各顾问耗时,排障时先分清是记忆写入慢还是检索慢,别笼统怪模型。
三、硬约束:每次调用都要带 CONVERSATION_ID
Memory Advisor 按会话键读写历史。文档反复强调:
- 参数名是 ChatMemory.CONVERSATION_ID;
- 必须在每一次使用 Memory Advisor 的调用里,通过 .advisors(a -> a.param(…)) 传入;
- 没有默认会话 ID;省略会在运行时抛出 IllegalArgumentException。
@RestController
public class SupportController {
private final ChatClient chatClient;
public SupportController(ChatClient chatClient) {
this.chatClient = chatClient;
}
@PostMapping("/support/chat")
public String chat(@RequestParam String conversationId, @RequestParam String userText) {
return chatClient.prompt()
.advisors(a -> a.param(ChatMemory.CONVERSATION_ID, conversationId))
.user(userText)
.call()
.content();
}
}
把会话 ID 当成和「用户文本」同级的请求必填项来设计:登录用户可用稳定业务键,匿名前端可在首轮生成 UUID 并回传,网关也可透传追踪号。但框架不会替你猜。共用一个全局 ID 会导致串话;每次新建却从不复用,又会让窗口记忆形同虚设。
升级注意(对照当前参考文档与迁移习惯):旧版若存在「conversationId 流式辅助方法」,在 2.x 文档路径下应改为 param 显式传入。若记忆里只剩「最终一问一答」、工具中间轮次丢失,先检查 Advisor 顺序,再对照文档看是否需要调整 tool-calling 相关顺序,或关闭内部会话历史选项(例如文档中的 disableInternalConversationHistory 一类能力;具体以你锁定的 Spring AI 2.x 参考页为准,勿抄过期方法名)。

四、ToolCallingAdvisor:自动在链上,但别和 Memory 打架
ChatClient 默认自动注册 ToolCallingAdvisor(可用属性或单次参数关闭),默认顺序约为 Ordered.HIGHEST_PRECEDENCE + 300。它负责模型发起的工具调用循环,直到不再需要 tool call。即便你没有在 Builder 上静态配置工具,运行时由别的 Advisor 注入的工具定义也能被它接住,这就是「循环上提」的好处。
和 Memory 同时开时,注意两件事:
关闭自动注册的常见方式(文档):
- 全局:spring.ai.chat.client.tool-calling.enabled=false;
- 单次:AdvisorParams.toolCallingAdvisorAutoRegister(false);
- 或自行提供实现了 ToolAdvisor 的顾问,抑制默认那一个。
自动注册的 ToolCallingAdvisor 默认位置是 Ordered.HIGHEST_PRECEDENCE + 300,可用 spring.ai.chat.client.tool-calling.advisor-order 调整;这个值要小于所有需要在工具循环内运行的顾问的 order。经验上:希望「每轮工具迭代都再跑一遍」的顾问,order 要落在工具循环内侧;只想在用户请求进出时各跑一次的顾问,则放在外侧。MCP 这里不展开;需要远程工具时,仍按 09-25 的方式显式 .defaultTools(…) / .tools(…),由同一条 ToolCalling 循环执行。
五、联调时怎么验证链真的生效
配置写对只是第一步,联调时还得能「看见」顾问链,光看最终字符串不够:
若使用流式 stream(),记得选同时支持流式的顾问实现,或确认内置顾问对 stream 路径的行为;阻塞调用与流式调用不要混用两套记忆写入假设。把上面几步写进接口验收,比只贴一段 Builder 代码靠谱,能避开「演示环境碰巧有上下文、生产却没有会话键」这种坑。
和 09-25 那篇 MCP 文的分工很简单:那篇解决「工具回调从哪来」,这篇解决「记忆与检索在链上怎么排」。完整的助手往往两者都要。但塞进同一篇文章,容易把「显式 tools」和「defaultAdvisors」两套生命周期搅在一起,所以日更拆开更清晰。
六、落地清单与常见坑
上线多轮问答或内部知识助手时,按下面勾一遍:
收个尾:Advisors 把「记忆」和「检索」从业务代码里抽成可排序的中间件。 先 Memory 后 RAG,每次带上 ChatMemory.CONVERSATION_ID,再让自动注册的 ToolCallingAdvisor 跑工具循环。这条链比在 Service 里手拼 Prompt 更稳,也更好观测。