本篇是《智能体演化史》系列第 3 篇 系列主线不是"某年出现了某技术",而是"因为上一步崩了,所以下一步才出现"。 全系列共用一个从 34 行长到 600 行的 tiny-agent,本篇是它的 v0.3。
怎么读这篇
- 🚶 12 分钟版:只看「崩坏现场」「一句话原理」和四道刹车那张图,知道该装哪四个开关。
- 🏃 40 分钟版(推荐):加读 ReAct 闭环、O(n²) 成本曲线和 v0.3 代码,你会理解为什么大多数 Agent 不是"不够聪明",而是"停不下来"。
- 🤿 深潜版:想清楚最后一节那个反转——当模型自己学会反思,2023 年那套手写反思循环还剩下多少价值。
01 · 崩坏现场:它跑了两个小时,交出一张白卷
2023 年 3 月底,一个叫 AutoGPT 的开源项目上线。几周之内,它在 GitHub 上冲到 10 万 star,是当时史上增长最快的仓库之一。
它的承诺非常诱人:你给 GPT-4 一个目标,它自己拆解成子任务、自己执行、自己检查结果,直到完成——全程没有人在回路里。
第一批跑通它的人,前五分钟是真的被震住的。看着它自言自语"我应该先搜 X,然后把结果存进文件,接着……“,然后真的去做了——那种感觉,有人形容为"它重新排列了你对可能性的认知”。
然后现实来了。
AutoGPT 最典型的失败模式,是一个今天听起来很荒诞、当时却天天发生的东西——递归验证循环:
第 1 轮:搜索"人工智能的历史" → 保存 10 篇文章
第 2 轮:检查完整性 → 判断"还需要更多来源"
第 3 轮:搜索"AI 历史时间线" → 保存 8 篇
第 4 轮:检查完整性 → 判断"缺少近期进展"
第 5 轮:搜索"AI 最新突破" → 保存 12 篇
第 6 轮:检查完整性 → 判断"需要学术来源"
……
第 300+ 轮:用户手动按停。两个小时。产出:零。
有用户记录到:让它整理 Downloads 文件夹,结果文件夹被按"类型→日期→项目→大小→再回到类型"反复重组了 15 次以上,几千个文件被搬来搬去,电脑卡死,最后结构回到原点。
同一年,亚马逊科学家在一项研究里给出过一个更冷的数字:AutoGPT 在标准化购物任务上的成功率是 24%。
它缺什么? 不是模型不够强,不是工具不够多,也不是没记忆。它有循环、有工具、有记忆——它唯独没有一个可靠的"什么时候算做完"的定义。 它让模型用自然语言判断任务是否完成,而一个语言模型在被问"还能再完善吗"时,几乎永远会回答"可以"。
这个毛病在社区里有个名字,叫完美主义偏差:模型总能找到还能改的地方,它脑子里没有"够好了"这三个字。
02 · 一句话原理
循环让一问一答变成持续行动; 而循环的全部难点,不在"转起来",在于"停得下来"。
让循环转起来,是 for step in range(N) 一行的事。而让它在该停的时候停下,是 Agent 工程里最贵的一课。
03 · 闭环:Thought → Action → Observation
循环跑起来的标准形式,来自 2022 年底的一篇论文,模式叫 ReAct(Reason + Act):
#mermaid-svg-U3fPEDx36L9KkEs6{font-family:\”trebuchet ms\”,verdana,arial,sans-serif;font-size:16px;fill:#333;}@keyframes edge-animation-frame{from{stroke-dashoffset:0;}}@keyframes dash{to{stroke-dashoffset:0;}}#mermaid-svg-U3fPEDx36L9KkEs6 .edge-animation-slow{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 50s linear infinite;stroke-linecap:round;}#mermaid-svg-U3fPEDx36L9KkEs6 .edge-animation-fast{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 20s linear infinite;stroke-linecap:round;}#mermaid-svg-U3fPEDx36L9KkEs6 .error-icon{fill:#552222;}#mermaid-svg-U3fPEDx36L9KkEs6 .error-text{fill:#552222;stroke:#552222;}#mermaid-svg-U3fPEDx36L9KkEs6 .edge-thickness-normal{stroke-width:1px;}#mermaid-svg-U3fPEDx36L9KkEs6 .edge-thickness-thick{stroke-width:3.5px;}#mermaid-svg-U3fPEDx36L9KkEs6 .edge-pattern-solid{stroke-dasharray:0;}#mermaid-svg-U3fPEDx36L9KkEs6 .edge-thickness-invisible{stroke-width:0;fill:none;}#mermaid-svg-U3fPEDx36L9KkEs6 .edge-pattern-dashed{stroke-dasharray:3;}#mermaid-svg-U3fPEDx36L9KkEs6 .edge-pattern-dotted{stroke-dasharray:2;}#mermaid-svg-U3fPEDx36L9KkEs6 .marker{fill:#333333;stroke:#333333;}#mermaid-svg-U3fPEDx36L9KkEs6 .marker.cross{stroke:#333333;}#mermaid-svg-U3fPEDx36L9KkEs6 svg{font-family:\”trebuchet ms\”,verdana,arial,sans-serif;font-size:16px;}#mermaid-svg-U3fPEDx36L9KkEs6 p{margin:0;}#mermaid-svg-U3fPEDx36L9KkEs6 .label{font-family:\”trebuchet ms\”,verdana,arial,sans-serif;color:#333;}#mermaid-svg-U3fPEDx36L9KkEs6 .cluster-label text{fill:#333;}#mermaid-svg-U3fPEDx36L9KkEs6 .cluster-label span{color:#333;}#mermaid-svg-U3fPEDx36L9KkEs6 .cluster-label span p{background-color:transparent;}#mermaid-svg-U3fPEDx36L9KkEs6 .label text,#mermaid-svg-U3fPEDx36L9KkEs6 span{fill:#333;color:#333;}#mermaid-svg-U3fPEDx36L9KkEs6 .node rect,#mermaid-svg-U3fPEDx36L9KkEs6 .node circle,#mermaid-svg-U3fPEDx36L9KkEs6 .node ellipse,#mermaid-svg-U3fPEDx36L9KkEs6 .node polygon,#mermaid-svg-U3fPEDx36L9KkEs6 .node path{fill:#ECECFF;stroke:#9370DB;stroke-width:1px;}#mermaid-svg-U3fPEDx36L9KkEs6 .rough-node .label text,#mermaid-svg-U3fPEDx36L9KkEs6 .node .label text,#mermaid-svg-U3fPEDx36L9KkEs6 .image-shape .label,#mermaid-svg-U3fPEDx36L9KkEs6 .icon-shape .label{text-anchor:middle;}#mermaid-svg-U3fPEDx36L9KkEs6 .node .katex path{fill:#000;stroke:#000;stroke-width:1px;}#mermaid-svg-U3fPEDx36L9KkEs6 .rough-node .label,#mermaid-svg-U3fPEDx36L9KkEs6 .node .label,#mermaid-svg-U3fPEDx36L9KkEs6 .image-shape .label,#mermaid-svg-U3fPEDx36L9KkEs6 .icon-shape .label{text-align:center;}#mermaid-svg-U3fPEDx36L9KkEs6 .node.clickable{cursor:pointer;}#mermaid-svg-U3fPEDx36L9KkEs6 .root .anchor path{fill:#333333!important;stroke-width:0;stroke:#333333;}#mermaid-svg-U3fPEDx36L9KkEs6 .arrowheadPath{fill:#333333;}#mermaid-svg-U3fPEDx36L9KkEs6 .edgePath .path{stroke:#333333;stroke-width:2.0px;}#mermaid-svg-U3fPEDx36L9KkEs6 .flowchart-link{stroke:#333333;fill:none;}#mermaid-svg-U3fPEDx36L9KkEs6 .edgeLabel{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-U3fPEDx36L9KkEs6 .edgeLabel p{background-color:rgba(232,232,232, 0.8);}#mermaid-svg-U3fPEDx36L9KkEs6 .edgeLabel rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-U3fPEDx36L9KkEs6 .labelBkg{background-color:rgba(232, 232, 232, 0.5);}#mermaid-svg-U3fPEDx36L9KkEs6 .cluster rect{fill:#ffffde;stroke:#aaaa33;stroke-width:1px;}#mermaid-svg-U3fPEDx36L9KkEs6 .cluster text{fill:#333;}#mermaid-svg-U3fPEDx36L9KkEs6 .cluster span{color:#333;}#mermaid-svg-U3fPEDx36L9KkEs6 div.mermaidTooltip{position:absolute;text-align:center;max-width:200px;padding:2px;font-family:\”trebuchet ms\”,verdana,arial,sans-serif;font-size:12px;background:hsl(80, 100%, 96.2745098039%);border:1px solid #aaaa33;border-radius:2px;pointer-events:none;z-index:100;}#mermaid-svg-U3fPEDx36L9KkEs6 .flowchartTitleText{text-anchor:middle;font-size:18px;fill:#333;}#mermaid-svg-U3fPEDx36L9KkEs6 rect.text{fill:none;stroke-width:0;}#mermaid-svg-U3fPEDx36L9KkEs6 .icon-shape,#mermaid-svg-U3fPEDx36L9KkEs6 .image-shape{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-U3fPEDx36L9KkEs6 .icon-shape p,#mermaid-svg-U3fPEDx36L9KkEs6 .image-shape p{background-color:rgba(232,232,232, 0.8);padding:2px;}#mermaid-svg-U3fPEDx36L9KkEs6 .icon-shape .label rect,#mermaid-svg-U3fPEDx36L9KkEs6 .image-shape .label rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-U3fPEDx36L9KkEs6 .label-icon{display:inline-block;height:1em;overflow:visible;vertical-align:-0.125em;}#mermaid-svg-U3fPEDx36L9KkEs6 .node .label-icon path{fill:currentColor;stroke:revert;stroke-width:revert;}#mermaid-svg-U3fPEDx36L9KkEs6 :root{–mermaid-font-family:\”trebuchet ms\”,verdana,arial,sans-serif;}
带着新结果
它判断做完了
目标你只给终点
Thought 思考我现在该干嘛
Action 行动写一份申请书
Observation 观察看到真实结果
退出循环
三个环节的分工很清楚:Thought 是模型自己想的,Action 是它写的申请书,Observation 是你的代码执行后递回来的真实结果。 关键在最后一步——观察结果必须回到上下文里,模型才能基于真实反馈继续思考,而不是基于自己的想象。
| ReAct | 思考→行动→观察,逐轮推进 | 简单、稳健、能纠错 | 贪心,走错分支回不去 | 默认选择 |
| Plan-and-Execute | 先一次性列计划,再逐步执行 | 长任务有连贯性,计划可审查 | 计划错了很难重来 | 步骤结构稳定的任务 |
| Reflexion | 做完之后自我批评,再重做一遍 | 能抓出明显错误 | 成本翻倍,且常常自我认同 | 见第 08 节(有反转) |
| Tree Search | 同时展开多个分支,打分剪枝 | 难题成功率高 | 成本 3-20 倍,调试困难 | 数学、竞赛级编码 |
对绝大多数业务场景,ReAct 就是正确答案。后面三种都是为了解决特定问题才出现的,而它们各自引入的复杂度,往往比解决的问题更多。
04 · 四道刹车:退出条件不能只有一个
既然模型自己判断"做完了"不可靠,那就必须在它之外,硬塞几个它无法违反的出口。 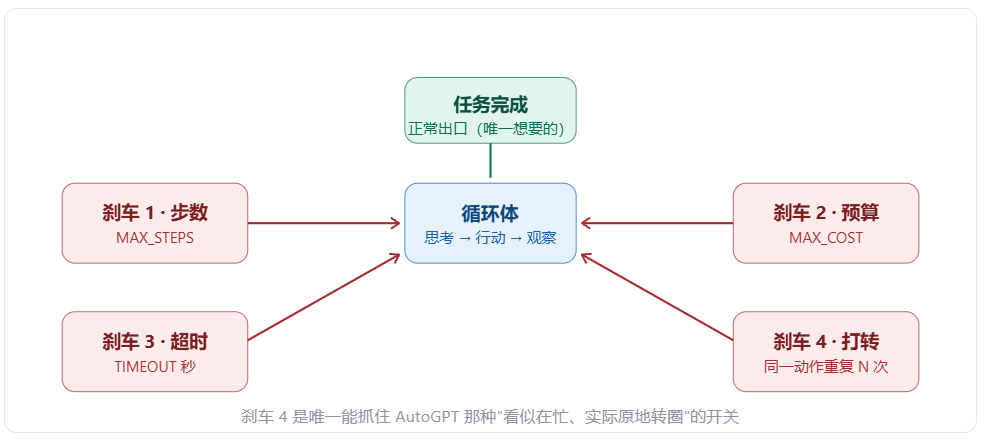
循环的四个强制出口。绿色那个是"它真的做完了",红色四个是"不管它愿不愿意,到此为止"。生产级 Agent 必须四个都装。
四道刹车分别防什么
| 步数上限 | 跑飞、规划偏差累积 | 单任务 8-20 步 | 一夜跑完一个月预算 |
| 预算上限 | 成本失控 | 按任务价值定,如 $0.5 | 一个死循环烧掉几百美元 |
| 超时 | 卡在某个慢工具上不动 | 60-300 秒 | 请求悬挂,用户干等 |
| 原地打转检测 | 递归验证循环、重复动作 | 同一动作 ≥3 次 | AutoGPT 那种"跑 300 轮零产出" |
前三个很直觉,第四个值得多说两句。
原地打转检测是唯一能抓住"伪进展"的开关。 前三个刹车看的是"跑了多少",而打转检测看的是"有没有往前走"。做法是给每个动作记一个指纹(工具名 + 参数),同一个指纹出现 N 次就判定卡住。AutoGPT 那个 300 轮的案例,用这一条能在第 4 轮就拦下来。
05 · 最小实现:v0.3 装上四道刹车
版本 diff: v0.2 → v0.3 · 46 行 → 55 行
- 新增预算累计(按 usage 实时算钱)
- 新增超时检查
- 新增原地打转检测(动作指纹计数)
- 结束时必须打印"停止原因",让每次退出都可归因
# tiny-agent v0.3 —— 循环跑起来了,现在给它装四道刹车
import os, json, time, subprocess
from openai import OpenAI
client = OpenAI(api_key=os.environ.get("OPENAI_API_KEY"))
MAX_STEPS = 12 # 刹车 1:步数上限
MAX_COST = 0.50 # 刹车 2:预算上限(美元)
TIMEOUT = 120 # 刹车 3:超时(秒)
MAX_REPEAT = 3 # 刹车 4:同一个动作最多允许重复几次
PRICE_IN, PRICE_OUT = 0.15 / 1e6, 0.60 / 1e6 # gpt-4o-mini 公开定价
TOOLS = [{"type": "function", "function": {"name": "run_python", "description": "执行一段 Python 代码并返回 stdout", "parameters": {"type": "object", "properties": {"code": {"type": "string", "description": "要执行的 Python 代码"}}, "required": ["code"]}}}]
def run_python(code):
r = subprocess.run(["python", "-c", code], capture_output=True, text=True, timeout=10)
return (r.stdout or r.stderr)[–2000:]
DISPATCH = {"run_python": run_python}
GOAL = "算出 1 到 100 的平方和,并验证一遍结果对不对"
messages = [{"role": "user", "content": GOAL}]
started, cost, history, stopped = time.time(), 0.0, [], None
for step in range(MAX_STEPS): # 刹车 1 生效处
if time.time() – started > TIMEOUT: # 刹车 3
stopped = f"超时({TIMEOUT}s)"; break
if cost >= MAX_COST: # 刹车 2
stopped = f"预算耗尽(${cost:.4f})"; break
resp = client.chat.completions.create(model="gpt-4o-mini", messages=messages, tools=TOOLS)
cost += resp.usage.prompt_tokens * PRICE_IN + resp.usage.completion_tokens * PRICE_OUT
msg = resp.choices[0].message
messages.append(msg)
if not msg.tool_calls:
print(f"最终回答 -> {msg.content}")
stopped = "任务完成"; break
for c in msg.tool_calls:
key = (c.function.name, c.function.arguments)
if history.count(key) >= MAX_REPEAT: # 刹车 4:原地打转检测
stopped = f"检测到原地打转:{c.function.name} 重复 {MAX_REPEAT} 次"; break
history.append(key)
fn = DISPATCH.get(c.function.name)
result = fn(**json.loads(c.function.arguments)) if fn else f"[拒绝] 无此工具"
messages.append({"role": "tool", "tool_call_id": c.id, "content": str(result)})
if stopped:
break
else:
stopped = f"达到步数上限({MAX_STEPS} 步)"
print(f"[结束] 原因:{stopped} | 走了 {step+1} 步 | 花费 ${cost:.4f}")
最后那行 print 别小看。"每次退出都要能说清原因"是一条硬纪律。 如果你的 Agent 结束时不告诉你它是"做完了"还是"被刹车了",那你在生产环境里遇到的一切都只能靠猜。
06 · 一条没人画的曲线:步数 ×3,token ×9
现在说一个循环最容易被低估的性质:它的成本不是线性增长的,是二次的。
原因很简单——messages 这个列表只增不减。第 10 轮的请求里,装着前 9 轮的全部内容;第 11 轮装着前 10 轮。所以第 n 轮的输入 token ≈ 前面所有轮次的总和,累加下来就是 O(n²)。
按"每轮新增约 600 token"这个保守假设实测(脚本可复现):
| 5 | 7,000 | 0.2x |
| 10 | 29,000 | 1.0x |
| 15 | 66,000 | 2.3x |
| 20 | 118,000 | 4.1x |
| 30 | 267,000 | 9.2x |
| 50 | 745,000 | 25.7x |
步数涨 3 倍,token 涨 9.2 倍。 这就是"多加几步而已"这句话的真实代价。
成本测算(按公开定价):
| gpt-4o-mini | $0.0195 | $19.50 | $585 |
| gpt-4o | $0.3250 | $325.00 | $9,750 |
单次任务几毛钱,看着不痛。但乘以调用量之后,这就是一条能决定项目生死的曲线。 Gartner 说那 40% 被取消的项目,第一个原因就是"成本不断攀升"——它不是突然爆掉的,是被这条二次曲线慢慢磨死的。
这也解释了为什么"步数上限"不只是一个安全开关,它同时是一个成本控制手段。把 MAX_STEPS 从 30 砍到 12,成本下降到约六分之一——而你砍掉的,往往是模型本来就在瞎转的那十几步。
07 · 现实对照:你忘了跟实习生说那句话
还是实习生那个类比。这次你注意一下交待活儿时的本能遗漏:
| 步数上限 | “最多折腾三版,够用了就交” | 他改到第七版,而前三版其实最好 |
| 预算上限 | “买资料最多报销 200 块” | 他买了 2000 块的行业报告 |
| 超时 | “今天下班前给我,不管做成啥样” | 他做到第三天,你的会已经开完了 |
| 打转检测 | “同一个方法试两次还不行,就换思路” | 他用同一个关键词搜了一下午 |
这四句话,你对真人说得出来,而且是本能会说——因为你知道人不会自己停。
但写给 Agent 的时候,绝大多数人只写了"目标"和"工具",把这四句全忘了。 为什么?因为演示的时候它一次就做对了,你没见过它卡住的样子。
所以有个很实用的自检方法:把你的 Agent 系统提示词读一遍,看里面有没有"什么时候停"这四个字。 如果没有,它迟早会给你一场 AutoGPT 式的表演。
08 · 一个反转:手写反思循环正在贬值
最后说一件到 2026 年才看清楚的事,这是本篇最"深"的一节。
2023-2024 年,行业里流行一类设计,叫 Reflexion(反思):让 Agent 做完之后,再调一次模型,让它批评自己的结果,然后重做。听起来很合理,很多框架都内置了。
但这里有个结构性缺陷:让犯错的那个模型去批评自己,它大概率会认同自己。 当时就有人指出,"自我批评"产出的往往是对错误的自信辩护。
然后事情变了。从 2024 年底开始,模型厂商把"慢思考"直接做进了模型内部——测试时计算、隐藏推理 token、在输出前内部展开多个分支并自我修正。到 2026 年,这已经是主流模型的标配。
于是那个尴尬的结论出现了:
模型自己会反思了,所以你手写在外的那套反思循环,正在变成纯粹的浪费。 你多花一轮 API 调用、多花一倍 token 去让模型"检查一遍",而它本来就在内部检查过了。更糟的是,外挂的反思循环还会把已经收敛的结果重新打开,反而降低稳定性。
这是个很有代表性的例子,说明了这个系列想讲的那件事:Agent 的很多"工程技巧",本质是在补模型的短板。模型一进步,那些补丁就变成了负债。
所以判断一个设计该不该做,有个简单的问法:它是在补模型的短板,还是在解决系统的问题?
- 「让模型一步步思考」——补模型短板,已被模型内化,可以删了
- 「限制它最多走 12 步」——解决系统问题(成本/安全),模型再强也得留着
- 「把工具结果回填给它」——解决系统问题(信息通路),永远需要
把这两类分开,你就不会在两年后维护一堆已经没人需要的脚手架。
09 · 下一篇:跑得越久,脑子越乱
看回第 06 节那张表。messages 只增不减,意味着到 30 步的时候,模型要在一个装着 26.7 万 token 的上下文里做判断——而这 26.7 万里,绝大部分是早就用不上的旧信息。
于是出现一个反直觉的现象:模型没变笨,但它被自己产生的信息埋住了。这就是上下文腐烂(Context Rot)。
下一篇:P4《上下文工程的诞生》,我们讲清楚为什么"提示词工程"这个岗位消失了,以及怎么给 Agent 装一个会自己收拾桌子的脑子。
思考题:你的 Agent 现在设了几步上限?试着把它砍一半,看看成功率掉多少、成本降多少——这两个数字的比例,会告诉你它之前有多少步是在瞎转。
欢迎在评论区聊聊。
系列导航
| P1 | Agent演化史(一)剥掉营销话术后,智能体只剩 34 行代码 | 已完稿 |
| P2 | Agent演化史(二)模型从没碰过你的工具:Function Calling 只是一份申请书 | 已完稿 |
| P3 | while True 的威力与恐怖:循环与四道刹车 | 本篇 |
本篇资产
- tiny-agent-v0.3.py —— 55 行,四道刹车齐全,可直接改造自用,可在资料库直接下载
- calc_metrics.py —— 本篇 O(n²) 与成本测算脚本,参数可改
- 测算假设:每轮新增 600 token(模型输出 150 + 工具结果 450),价格取公开定价,仅用于说明量级与增长形态
本文为盘子工具站生态原创技术专题系列,转载请注明出处。