从磁盘硬件到 ext2 文件系统:完整深度详解
第一部分:理解硬件
1.1 磁盘、服务器、机柜、机房
数据存储的物理层级是:
机房(IDC)
└─ 机柜(Rack,单位 U,常见 42U)
└─ 服务器 / 磁盘阵列(RAID / JBOD)
└─ 磁盘(HDD / SSD)
└─ 盘片、磁头、扇区
磁盘是持久化数据的最终载体。
相比内存(DRAM 掉电即失),磁盘断电后数据不丢,这是它成为"持久存储"的根本原因。
1.2 磁盘物理结构(HDD)
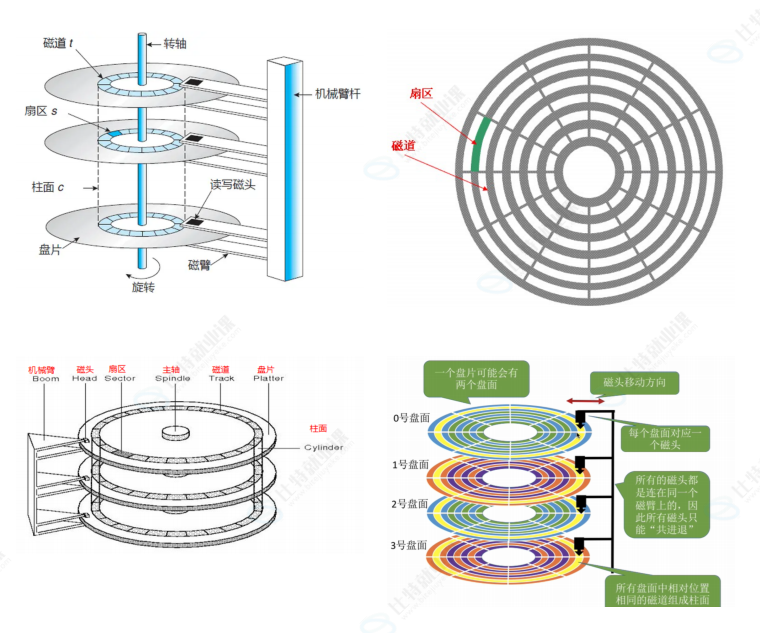
机械硬盘(Hard Disk Drive)由以下核心部件构成:
| 盘片 | Platter | 圆形,表面涂磁性材料,靠磁畴方向记录 0/1;一块盘有多张盘片 |
| 主轴 | Spindle | 带动盘片高速旋转(5400 / 7200 / 10000 / 15000 RPM) |
| 磁头 | Read/Write Head | 每个盘面对应一个磁头,读写数据,悬浮在盘片上方几纳米 |
| 磁头臂 | Actuator Arm | 带动磁头沿半径方向移动,定位磁道 |
| 磁道 | Track | 磁头不动、盘片旋转形成的同心圆 |
| 扇区 | Sector | 磁道被划分出的弧段,最小读写单位 |
| 柱面 | Cylinder | 所有盘片上相同半径磁道的集合 |
1.3 磁盘的存储结构
- 盘片表面是磁性材料,磁头通电产生磁场改变磁畴方向(写),磁畴变化在磁头感应出电流(读);
- 数据按扇区存放,每个扇区包括:数据区(512/4096 字节)+ 扇区头(编号、同步信息)+ ECC 校验;
- 读写必须以整个扇区为单位,哪怕只读 1 个字节,也要把整个扇区读出来。
1.4 磁盘的逻辑结构
1.4.1 理解过程:CHS 三维寻址
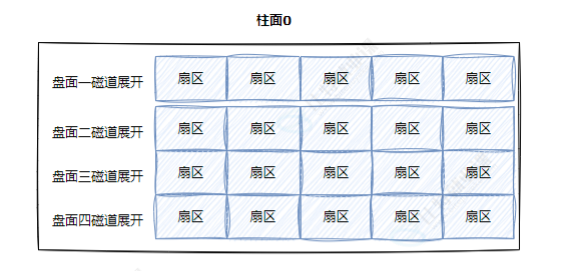
早期定位一个扇区,需要三个坐标:
- C(Cylinder,柱面):先移动磁头到某个半径;
- H(Head,磁头):选择哪个盘面;
- S(Sector,扇区):等目标扇区转到磁头下。
这就是 CHS 三维地址。
设计柱面的好处是:
同一柱面内切换磁头(电子切换,极快),不用移动磁头臂(机械寻道,很慢),所以早期操作系统尽量把连续数据放在同一柱面。
1.4.2 真实过程:LBA 线性寻址
CHS 有个致命假设:每个磁道扇区数相同。
但实际磁盘采用分区位记录(ZBR),外圈磁道周长更长、扇区更多。
CHS 无法表达真实布局,还带来容量上限。
于是现代磁盘统一使用 LBA(Logical Block Address,逻辑块地址):
- 把所有扇区从 0 开始线性编号:0, 1, 2, 3 …;
- 磁盘内部的控制器负责把 LBA 翻译成真实的 C/H/S;
- 对操作系统而言,磁盘就是一个"扇区(块)的一维数组"。
1.5 CHS 与 LBA 地址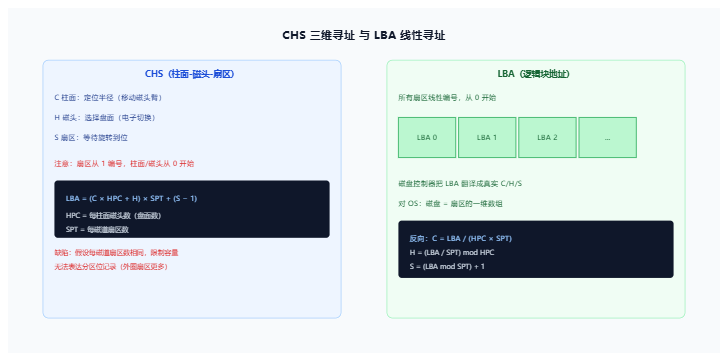
CHS转成LBA:
LBA转成CHS:
1.6 磁盘访问的性能拆解
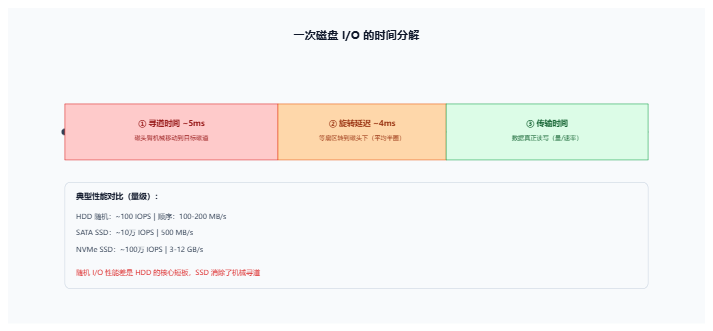
1.6.1 一次磁盘 I/O 的三段时间
| 寻道时间 | T_seek | 磁头臂移动到目标磁道 | 平均 3-10ms(约 5ms) |
| 旋转延迟 | T_rotation | 等待目标扇区转到磁头下 | 平均半圈 |
| 传输时间 | T_transfer | 数据实际读写 | 数据量 / 传输速率 |
平均旋转延迟 = 0.5 / (RPM/60):7200 RPM 约 4.17ms,15000 RPM 约 2ms。
平均访问时间 = 寻道 + 旋转延迟 + 传输。
1.6.2 IOPS 与吞吐量
- 随机 IOPS ≈ 1 / (寻道 + 旋转延迟):7200 转 HDD 约 110 IOPS;
- 顺序吞吐:连续读写几乎不寻道,HDD 约 100-200MB/s;
- 这解释了为什么顺序 I/O 远快于随机 I/O。
1.7 磁盘接口与现代存储
1.7.1 接口协议
| SATA | 6Gbps(~600MB/s) | AHCI 协议,单队列,消费级 |
| SAS | 12/24Gbps | 企业级,双端口,可靠性高 |
| NVMe | PCIe 3.0/4.0/5.0 | 4/8/16GB/s,64K 队列,多队列并行 |
1.7.2 SSD 内部原理
- NAND 闪存:按 SLC/MLC/TLC/QLC 区分每单元位数,位数越多越便宜、寿命越短;
- 以页(Page)读写、以块(Block)擦除:不能直接覆写,必须先擦后写;
- FTL(闪存转换层):
- LBA → PBA(物理地址)映射;
- 磨损均衡(Wear Leveling)、坏块管理;
- 垃圾回收(GC):把有效数据搬走再擦除整块;
- 写放大(WAF):实际写入闪存量 / 主机写入量,GC 导致放大;
- TRIM:通知 SSD 哪些 LBA 已删除,提升 GC 效率;
- OP 冗余空间:预留空间给 GC 和映射,降低写放大。
1.7.3 RAID 级别
| RAID 0 | 条带 | N 块 | 无 |
| RAID 1 | 镜像 | 1 块 | 高 |
| RAID 5 | 条带 + 分布式校验 | N-1 | 允许坏 1 块 |
| RAID 6 | 双校验 | N-2 | 允许坏 2 块 |
| RAID 10 | 镜像 + 条带 | N/2 | 高,性能好 |
第二部分:引入文件系统
裸磁盘上只有一堆扇区,无法直接管理文件。
文件系统就是在扇区之上建立的一套组织规则,核心引入三个概念:块、分区、inode。
2.1 引入"块"概念
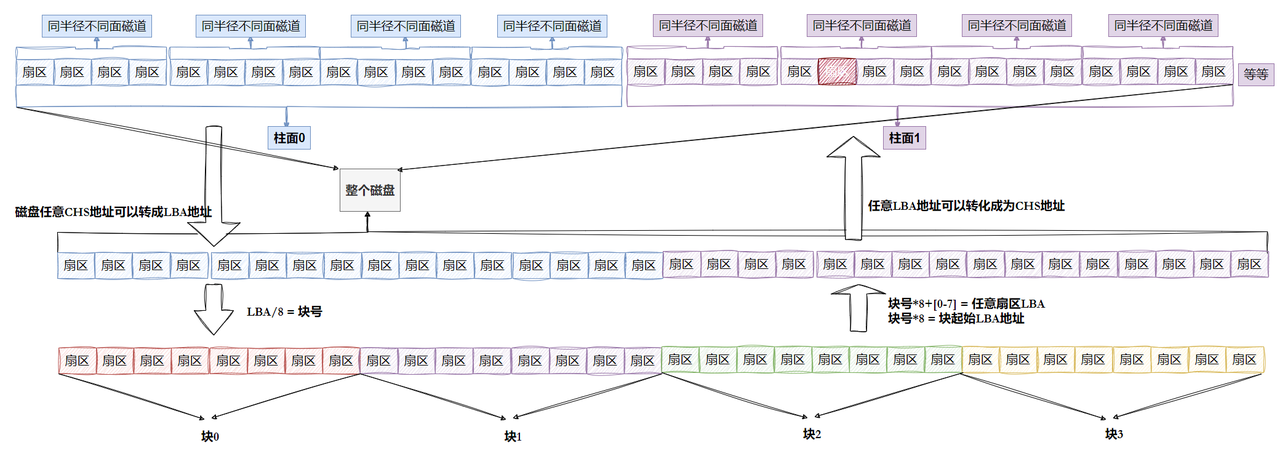
- 扇区(512B/4KB)是硬件的最小单位,对文件系统来说太小;
- 文件系统把若干连续扇区打包成一个块(Block),作为文件系统的最小分配单位:
- 块大小通常是 1KB / 2KB / 4KB(ext2 可选);
- 4KB 块 = 8 个连续的 512B 扇区;
- 为什么用块:
- 扇区太小,管理海量扇区的元数据开销巨大;
- 块越大,寻址和 I/O 效率越高,但小文件浪费空间(一个 1B 文件也要占一个块,即内部碎片)。
2.2 引入"分区"概念
分区是把一块磁盘划分成若干个逻辑独立区域,每个区域可以单独格式化、挂载、管理。
2.2.1 MBR 分区(位于 LBA 0,512 字节)
- 446 字节:引导代码(bootloader);
- 64 字节:分区表,最多 4 个主分区(每个 16 字节),需要更多分区用扩展分区 + 逻辑分区;
- 2 字节:魔数 0x55AA。
MBR 分区表项(16 字节)字段:
| 0 | 1 | 引导标志:0x80 活动,0x00 非活动 |
| 1-3 | 3 | 起始 CHS |
| 4 | 1 | 分区类型(0x83 Linux、0x82 swap、0x07 NTFS、0x0F 扩展、0xEE GPT 保护) |
| 5-7 | 3 | 结束 CHS |
| 8-11 | 4 | 起始 LBA |
| 12-15 | 4 | 扇区总数 |
4 字节扇区数 + 512B 扇区 → 单分区最大 2TB,这是 MBR 的硬限制。
2.2.2 GPT 分区(UEFI 标准)
| 0 | 保护 MBR(类型 0xEE) |
| 1 | GPT 头:签名 EFI PART、磁盘 GUID、当前/备份头位置、分区表起止、CRC |
| 2-33 | 分区表:默认 128 项,每项 128 字节 |
| 末尾 | 备份 GPT 头和分区表 |
每个 GPT 表项(128 字节):
分区类型 GUID、分区唯一 GUID、起始/结束 LBA、
属性标志、分区名(72 字节 UTF-16)。
2.3 引入"inode"概念
一个文件在磁盘上由两部分组成:
- 数据(Data):文件的实际内容,存放在数据块(Data Block);
- 元数据(Metadata):描述文件的属性,存放在 inode(index node):
- 文件大小、权限(rwx)、属主(uid/gid);
- 时间戳(atime/mtime/ctime)、硬链接计数;
- 数据块的位置指针(最关键);
- 注意:inode 不存文件名。文件名存放在它所属目录的"目录项"里,目录项记录「文件名 → inode 号」的映射。
[root@localhost linux]# ls -l
总⽤量 12
-rwxr-xr-x. 1 root root 7438 "9⽉ 13 14:56" a.out
-rw-r–r–. 1 root root 654 "9⽉ 13 14:56" test.c
每⾏包含7列:
• 模式
• 硬链接数
• ⽂件所有者
• 组
• ⼤⼩
• 最后修改时间
• ⽂件名
读取文件:
文件名 →(查目录)→ inode 号 → 找到 inode → 拿到数据块指针 → 读数据块
2.4 目录项结构(ext2_dir_entry_2)
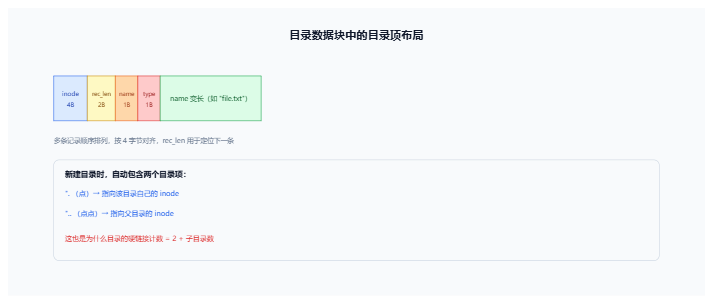
目录是一种特殊文件,其数据块里存放一条条目录项:
| inode | 4 | 该文件的 inode 号 |
| rec_len | 2 | 本条记录总长度(用于找下一条) |
| name_len | 1 | 文件名长度(最长 255) |
| file_type | 1 | 1 普通文件 / 2 目录 / 3 字符设备 / 4 块设备 / 5 FIFO / 6 socket / 7 符号链接 |
| name | 变长 | 文件名,按 4 字节对齐 |
2.5 硬链接与软链接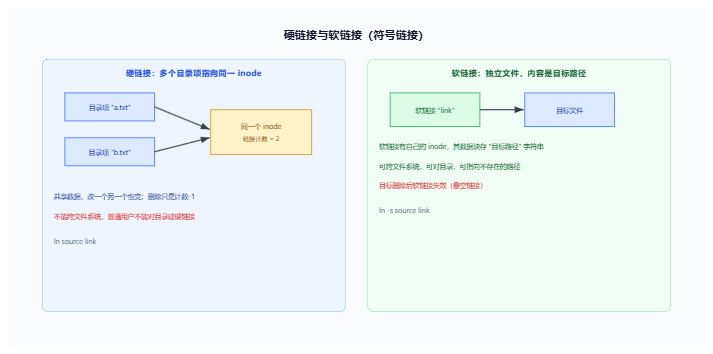
硬链接:
多个目录项指向同一个 inode,共享数据,链接计数 +1;
不能跨文件系统,不能对目录。
软链接:
独立文件,有自己的 inode,数据块存目标路径;
可跨文件系统、可对目录,目标删除后悬空。
第三部分:ext2 文件系统
3.1 宏观认识
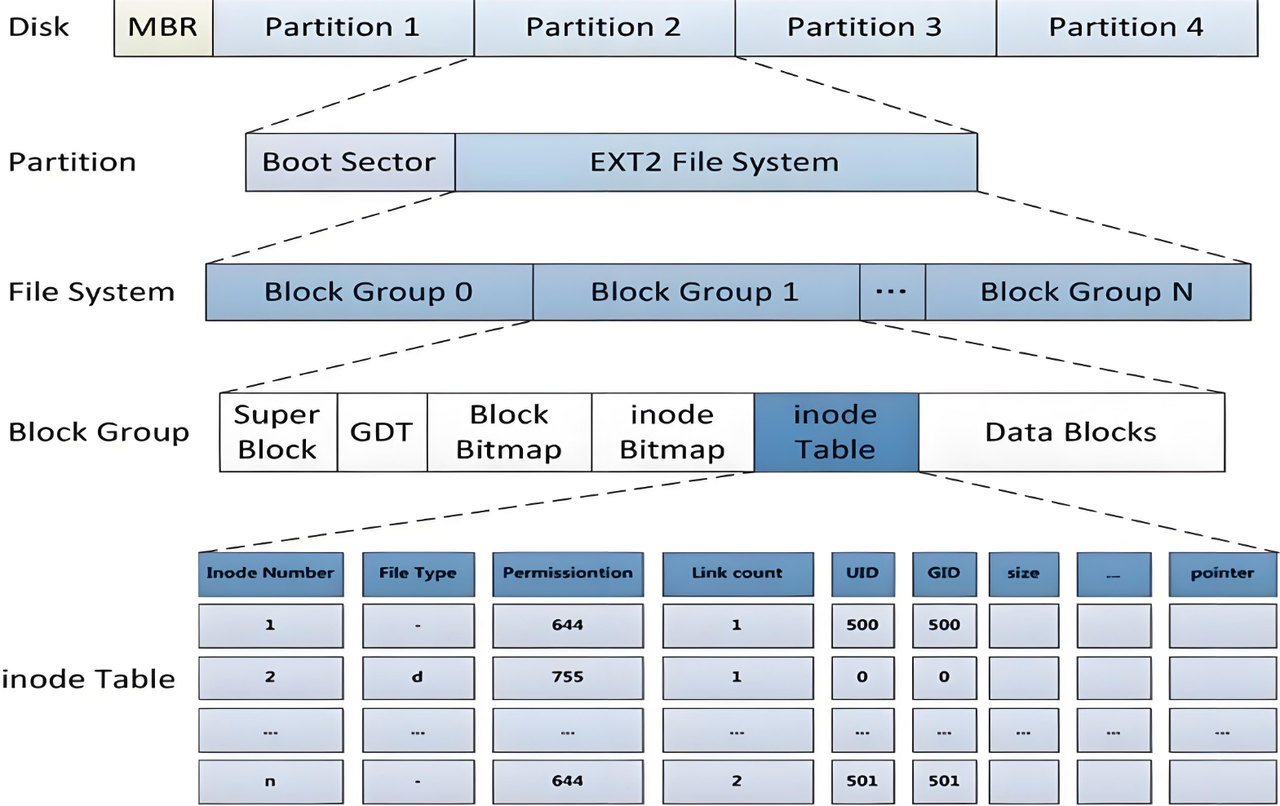
| 1 | Super Block | 超级块 | 整个文件系统 | 记录全局元信息(块 /inode 总数、空闲数、块大小) |
| 2 | GDT(Group Descriptor Table) | 组描述符表 | 所有块组 | 记录每个块组的位图位置、inode 表位置和空闲计数 |
| 3 | Block Bitmap | 块位图 | 本组数据块 | 用每一位标记数据块是否空闲,管块的分配 / 回收 |
| 4 | inode Bitmap | inode 位图 | 本组 inode | 用每一位标记 inode 是否空闲,管 inode 的分配 / 回收 |
| 5 | inode Table | inode 表 | 本组所有 inode | 连续存放该组全部 inode 结构 |
| 6 | Data Blocks | 数据块 | 文件 / 目录内容 | 真正存放文件数据和目录项 |
ext2(Second Extended Filesystem) 是 Linux 早期经典文件系统(1993 年),结构清晰、无日志,是理解 ext3/ext4 的基础:
- ext3 = ext2 + 日志(journal);
- ext4 = ext3 + extent、多块分配等。
一个分区被 mkfs.ext2 格式化后,布局如下:
[启动块 Boot Block][块组0][块组1][块组2] … [块组N]
- 启动块(Boot Block):前 1024 字节,不属于任何块组,存放系统引导程序;
- 其余空间被划分为多个块组(Block Group)。
3.2 Block Group(块组)
为什么把整个分区切成多个块组?
- 若位图、inode 表集中在一处,文件数据散落在全盘,读写一个文件要来回寻道;
- 分成块组后,一个文件的 inode 和数据块尽量分配在同一个块组内,减少磁头移动,提升性能;
- 每个块组自带管理信息,结构相同,也便于冗余备份。
3.3 块组内部构成
每个块组从前往后依次包含 6 个部分: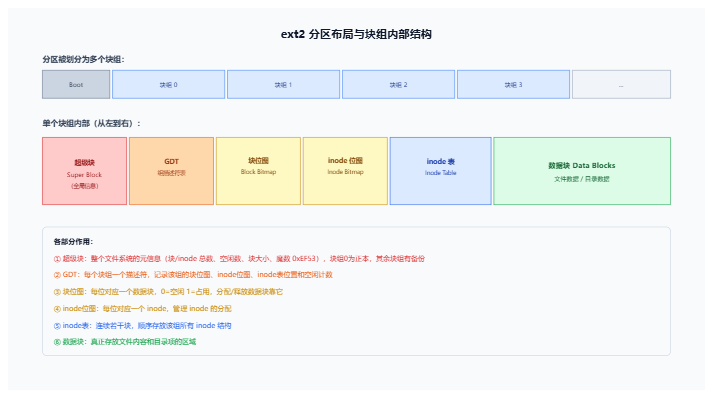
3.3.1 超级块(Super Block)
超级块是整个文件系统的"户口本",完整字段:
| s_inodes_count / s_blocks_count | inode / 块总数 |
| s_r_blocks_count | 保留给 root 的块数(默认 5%,磁盘满时管理员可用) |
| s_free_blocks_count / s_free_inodes_count | 空闲块 / inode 数 |
| s_first_data_block | 第一个数据块(1KB 块时为 1,否则 0) |
| s_log_block_size / s_log_frag_size | 块 / 片大小(2^n × 1024) |
| s_blocks_per_group / s_frags_per_group / s_inodes_per_group | 每组块 / 片 / inode 数 |
| s_mtime / s_wtime | 最后挂载 / 写入时间 |
| s_mnt_count / s_max_mnt_count | 挂载次数 / 强制检查的次数 |
| s_magic | 0xEF53 |
| s_state / s_errors | 状态(干净/脏)/ 出错策略 |
| s_creator_os / s_rev_level | 创建 OS / 修订级别 |
| s_def_resuid / s_def_resgid | 保留块默认 uid/gid |
| s_first_ino / s_inode_size | 第一个非保留 inode / inode 大小(动态版) |
| s_feature_compat / incompat / ro_compat | 兼容特性位图 |
3.3.2 GDT(Group Descriptor Table)
每个块组对应一个 32 字节的描述符:
| bg_block_bitmap | 块位图所在块号 |
| bg_inode_bitmap | inode 位图所在块号 |
| bg_inode_table | inode 表起始块号 |
| bg_free_blocks_count | 该组空闲块数 |
| bg_free_inodes_count | 该组空闲 inode 数 |
| bg_used_dirs_count | 该组目录数 |
3.3.3 块位图(Block Bitmap)
- 块位图占一个块,每一位对应块组里的一个数据块:0=空闲,1=占用;
- 分配时找 0 位置 1,释放时清 0;
- 一个 4KB 块有 4096 位,可管理 4096 个数据块(16MB)。
3.3.4 inode 位图(Inode Bitmap)
与块位图结构相同,每一位对应一个 inode,管理 inode 的分配与回收。
3.3.5 inode 表(Inode Table)
所有 inode 连续存放在 inode 表中,每个 ext2 inode 固定 128 字节,完整字段:
| i_mode | 文件类型 + 权限 |
| i_uid / i_gid | 属主 uid/gid |
| i_size | 文件大小(字节) |
| i_atime / i_ctime / i_mtime / i_dtime | 访问 / inode 改变 / 修改 / 删除时间 |
| i_links_count | 硬链接计数 |
| i_blocks | 占用块数(512B 为单位) |
| i_flags | 文件标志 |
| i_block[15] | 数据块指针(12 直接 + 3 间接) |
| i_generation | 文件版本(NFS 用) |
| i_file_acl / i_dir_acl | 访问控制块 |
3.3.6 数据块(Data Block)
存放文件实际内容;
目录的内容(目录项)也存放在数据块中。
3.4 inode 与数据块映射
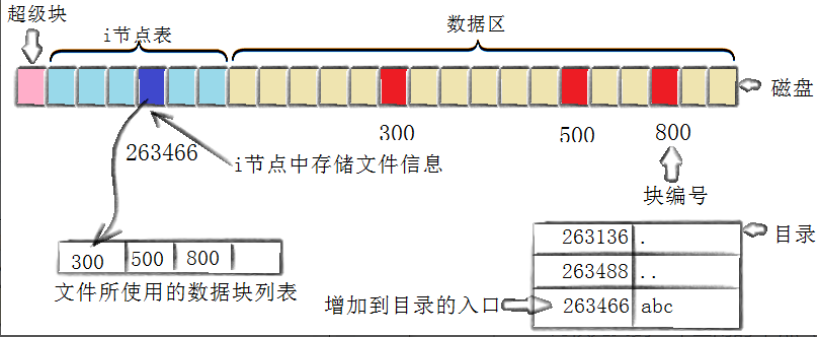
inode 中的 i_block[15] 有 15 个 4 字节指针,采用直接 + 多级间接寻址,兼顾小文件和大文件:

寻址能力(块大小 4KB,一个间接块可存 1024 个指针):
| 直接块 | [0]~[11] | 12 × 4KB = 48KB |
| 一级间接 | [12] | 1024 × 4KB = 4MB |
| 二级间接 | [13] | 1024² × 4KB = 4GB |
| 三级间接 | [14] | 1024³ × 4KB = 4TB |
设计思想:
小文件(绝大多数文件)只用直接块,一次定位、速度快;
大文件才用间接块,用多级索引换取超大寻址空间。
3.5 创建文件的完整流程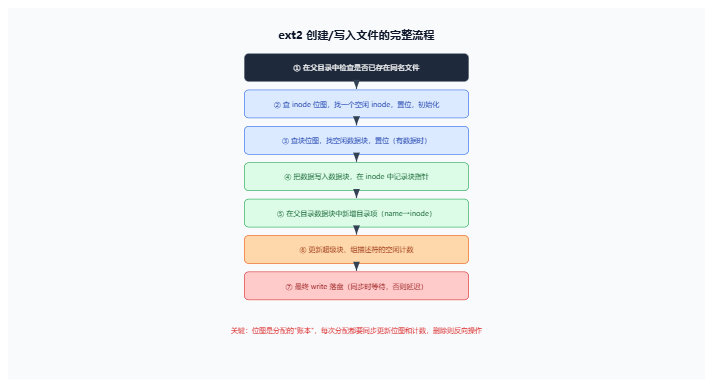
3.6 数据块寻址实例
块大小 4KB,一个间接块可存 4096/4 = 1024 个指针。读取文件偏移 100000 字节:
判断偏移落在哪个层级:
| 0-11 | 直接块 |
| 12-1035 | 一级间接(1024 项) |
| 1036-1049611 | 二级间接(1024² 项) |
| 1049612 以上 | 三级间接 |
第四部分:实操命令
# 查看磁盘扇区/分区
sudo fdisk -l
lsblk
# 格式化为 ext2 并查看文件系统信息
mkfs.ext2 /dev/sdb1
dumpe2fs /dev/sdb1 # 查看超级块、块组、GDT 详细信息
# 查看块大小和保留块
tune2fs -l /dev/sdb1 | grep -i block
# 挂载与查看
mount /dev/sdb1 /mnt
df -i # 查看 inode 使用情况
df -h # 查看空间使用情况
# 查看文件的 inode 与占用块
stat file
ls -ls file
ls -i file
# 链接
ln source link # 硬链接
ln -s source link # 软链接
# SSD TRIM
sudo fstrim -v /
第五部分:面试题(含答案)
磁盘的最小读写单位是什么?文件系统的最小分配单位是什么?
扇区(512B/4KB)是硬件最小单位;
块(Block,通常 4KB)是文件系统最小分配单位,由多个连续扇区组成。
磁道、扇区、柱面分别是什么?
磁道是同心圆,扇区是磁道上的弧段,柱面是所有盘片相同半径磁道的集合。
CHS 和 LBA 有什么区别?为什么现代磁盘用 LBA?
CHS 是三维物理寻址,假设每磁道扇区数相同,无法表达分区位记录、限制容量;
LBA 线性编号,由控制器翻译成真实 C/H/S,磁盘被抽象成扇区一维数组。
CHS 到 LBA 的转换公式?
LBA = (C × HPC + H) × SPT + (S − 1)。
一次磁盘访问包含哪几段时间?
寻道(机械移动)+ 旋转延迟(等扇区)+ 传输,HDD 随机 IOPS 约 100。
为什么顺序 I/O 比随机 I/O 快得多?
顺序几乎不寻道,随机每次都要付寻道 + 旋转延迟。
SSD 为什么快?FTL 做什么?
无机械结构;FTL 做 LBA→PBA 映射、磨损均衡、GC、坏块管理。
MBR 单分区为什么最大 2TB?
4 字节扇区数 × 512B ≈ 2TB,GPT 用 64 位 LBA 解决。
MBR 最多几个主分区?怎么扩展?
4 个主分区,用扩展分区 + 逻辑分区突破。
inode 存文件名吗?文件名存哪?
不存,文件名在父目录的目录项里,目录项记录 name→inode。
一个文件由哪两部分组成?
元数据(inode)+ 数据(数据块)。
硬链接和软链接的本质区别?
硬链接共享同一 inode(计数+1,不能跨 fs、不能对目录);
软链接是独立文件、存目标路径,可跨 fs、可对目录。
新建目录的链接计数为什么是 2?
自身 "." + 父目录 "..",每个子目录还会让它再 +1。
ext2 为什么分块组?
让一个文件的 inode 和数据块尽量在同一组,减少磁头移动、提升性能。
ext2 块组内部依次包含什么?
超级块 → GDT → 块位图 → inode 位图 → inode 表 → 数据块。
超级块记录什么?魔数是多少?
块/inode 总数、空闲数、块大小、每组块数等,魔数 0xEF53;
块组0为正本,其余有备份。
GDT 记录什么?
每个块组的块位图、inode 位图、inode 表位置和空闲计数。
位图的作用?
块位图/inode 位图用每一位表示块/inode 是否空闲,是分配的账本。
文件系统怎么分配一个空闲块?
查块位图找 0 位、置 1,更新组描述符和超级块空闲计数。
ext2 大文件怎么寻址?
12 直接 + 一/二/三级间接,4KB 块下三级间接可达 4TB。
保留块(reserved blocks)是干什么的?
留给 root,磁盘满时管理员仍能启动/恢复,默认 5%。
块大小怎么选?
大块顺序效率高,小文件浪费少,取决于典型文件大小和工作负载。
总结
整条链路的核心是把"磁盘怎么转、块怎么分、inode 怎么找到块"三件事打通:
记住这条主线:扇区 → 块 → inode → 数据块,磁盘与文件系统的底层原理就彻底打通了。