版权与内容来源声明
本文为原创整理。文中涉及官方文档、开源仓库、论文与公开报道的内容,均在附表 A 中标注来源;引用官方原文保持原样,不作改写。文中命令、版本号与界面截图以本文成文时的实测/核验结果为准,标注「待验证」的部分请以你本地环境实际输出为判断依据。本文不推荐任何不合规的软件获取方式,也不对任何收益结果作承诺。转载请注明出处。
一、测试条件先统一:把「删除」拆成标记、过滤、回收三步
向量库里的「删除」不是一次动作,而是三件互相独立的事:打墓碑、检索时过滤、后台压实;三个开关装在三个不同的地方,所以「删了还能被答出来」和「删了磁盘不降」从来不是同一个故障。
先看我跑出来的一组现象。2000 条 8 维向量灌进去,随机删掉 10%,立刻用 200 个查询各取 top-10:平均每条查询只返回 9.0 条,少掉的那 1.0 条正是刚删的那批。把取数逻辑改成「多取一截再筛」,10 条能凑满了,可内存占用一点没降、磁盘占用也一点没降。前一个现象出在过滤,后一个现象出在回收,中间还夹着一层「什么时候算真的删掉」。三件事混在一起查,到头来只能得到「删了三天还在被召回」这种没法定位的描述。
墓碑:删除请求先写一条「这条不算数」
墓碑(tombstone)就是数据库里一句「这条记录失效了」的记号,数据本身还躺在原来的位置。
这么做不是偷懒。原地删一行要改磁盘页、要留空洞、要让索引跟着重建;追加一条「第 1742 号已删除」的记号是顺序写,代价低一个档。Milvus 的官方问答把这件事写得很直:No, storage space will not be immediately released when you delete data in Milvus. Although deleting data marks entities as “logically deleted,” the actual space might not be freed instantly.(Product FAQ,截至 2026-10-27)Qdrant 的说法更直接:When a record is deleted, it isn’t removed right away but marked as deleted to avoid slow disk operations during queries.(Optimizer 页,截至 2026-10-27)pgvector 走的是另一条路——Postgres 的行被标记删除后成为 dead tuple,机制不同,结果一样:行还在文件里。
所以「删成功了」这句话只在标记这一层成立。后面两层没走完,你的删除就只是一句备注。
过滤:可见性的开关长在查询路径上
同一条墓碑,被「什么时候核对」决定了你会看到什么。
后过滤(post-filter)是先按向量距离取前 k 条,再拿墓碑把已删的剔掉。pgvector 的 README 把这件事说得毫无余地:With approximate indexes, filtering is applied after the index is scanned.(截至 2026-10-27)关键不是「剔掉了」,而是这些被剔掉的条目已经占掉了 k 个名额。名额是有限的,被死人占了,活人就进不来。
前过滤(pre-filter)是在遍历图的途中就用条件剪枝。Qdrant 的 filterable HNSW 是这么做的,原文写的是用 payload 值给图加额外的边,从而 apply filters as you search in the graph(Indexing 页,截至 2026-10-27)。它的代价不在查询上,在建索引上:同一页明确要求 payload 索引在灌数据之前建好,Payload indexes should be created before ingesting data.
一个吃名额,一个吃建索引的顺序。这就是为什么同样删掉 10%,在两套系统里能表现成完全不同的两件事。
回收:压实才动磁盘,而且它比可见性慢两跳
Milvus 的回收是两步串行:compaction 把带墓碑的段重写成新段、把旧段标成 Dropped,再由 GC 定期删掉这些 Dropped 段(Product FAQ,截至 2026-10-27)。这里有两个「稍后」叠在一起——压实是稍后,GC 是稍后的稍后。
Qdrant 的回收是段级 vacuum,它带一个明确门槛,后文要用:deleted_threshold: 0.2、vacuum_min_vector_number: 1000,两个都是每段的口径,注释原文是 the minimal fraction of deleted vectors in a segment, required to perform segment optimization(Optimizer 页,截至 2026-10-27)。
pgvector 的回收是 VACUUM,而 README 在 Vacuuming 一节只给了三行,信息量却不小:Vacuuming can take a while for HNSW indexes. Speed it up by reindexing first. 紧接着是 REINDEX INDEX CONCURRENTLY 再 VACUUM(截至 2026-10-27)——也就是说 HNSW 上的空间回收,官方建议的路径是重建索引,而不是等后台慢慢清。
| 标记(墓碑) | 删除请求本身 | 这条数据还算不算数 | 几乎没有:这一步极少失败 | 看删除接口返回的条目计数 |
| 过滤 | 查询路径(前过滤 / 后过滤) | 已删数据还会不会出现在结果里 | top-k 里混进已删、或返回条数不足 | 拿已删 id 反查一次 top-k |
| 回收 | 后台压实 / GC / VACUUM | 磁盘和内存什么时候真的降下来 | 删了一半,占用一点不降 | 看段级删除比例与段大小 |
这张表的用法是「先定位再动手」:拿一条已删 id 去查 top-k,它还在结果里,问题在过滤;它不在结果里但占用没降,问题在回收。两边的处理手段没有交集,混着调只会白折腾。
二、实测结果:删掉 10% 之后 top-10 里平均还剩 9 条,少的那 1 条是被墓碑占了名额
后过滤下,墓碑不是「被筛掉」这么轻——它先占掉一个名额,再被丢掉,所以返回条数按 k×(1−p) 掉,而不是「排序错了」。
把条件钉死,只留一个变量
这一组只改删除比例,别的全部固定:
- 2000 条 8 维向量,随机种子 20261027,10 个段每段 200 条(分段是为了后面对齐「按段压实」的口径);
- 200 个查询,top-k = 10,距离用平方 L2;
- 删除集合固定:把 id 打乱后按比例取前 N 条,五档 0 / 5 / 10 / 20 / 40;
- 检索用精确全量排序,不引入近似索引的误差,把变量压到「墓碑 + 过滤」这两个上;
- 过滤严格按后过滤:先取前 10,再把已删的丢掉,不补齐;
- 真值:只在存活点里排出来的前 10。
这是机制复刻,不是压测某款产品:2000 条、8 维、精确检索,结论不外推到亿级数据;它的用处是让「名额被占」这件事变成可数的数字。
🧪 实测环境:Python 3.13.12 / macOS / 仅标准库,固定种子 20261027;脚本 work/exp1027/e03_tomb.py
import random
random.seed(20261027)
N, DIM, K, QN = 2000, 8, 10, 200
pts = [[random.uniform(–1, 1) for _ in range(DIM)] for _ in range(N)]
qs = [[random.uniform(–1, 1) for _ in range(DIM)] for _ in range(QN)]
order = list(range(N))
random.shuffle(order)
def d2(a, b):
return sum((x – y) ** 2 for x, y in zip(a, b))
def pad(s, w):
n = sum(2 if ord(c) > 0x3000 else 1 for c in s)
return s + " " * max(0, w – n)
print(pad("删除比例", 10) + pad("top-10中已删", 14) + pad("有效结果", 12)
+ pad("与live真值重叠", 16) + pad("满10条查询", 12))
print("-" * 64)
for pct in (0, 5, 10, 20, 40):
dead = set(order[: N * pct // 100])
gone = eff = ov = full = 0
for q in qs:
rank = sorted(range(N), key=lambda i: d2(q, pts[i]))
got = [i for i in rank[:K] if i not in dead]
truth = [i for i in rank if i not in dead][:K]
gone += K – len(got)
eff += len(got)
ov += len(set(got) & set(truth))
full += len(got) == K
print(pad(f"{pct}%", 10) + pad(f"{gone / QN:.1f}", 14) + pad(f"{eff / QN:.1f}", 12)
+ pad(f"{ov / QN:.1f}", 16) + f"{full}/{QN}")
删除比例 top-10中已删 有效结果 与live真值重叠 满10条查询
—————————————————————-
0% 0.0 10.0 10.0 200/200
5% 0.5 9.5 9.5 113/200
10% 1.0 9.0 9.0 58/200
20% 2.1 7.9 7.9 16/200
40% 4.1 5.9 5.9 3/200
读表:前两列是 10p,第三列是 10(1−p)
「top-10 中已删」这一列 0.0 / 0.5 / 1.0 / 2.1 / 4.1,就是 10×p;「有效结果」10.0 / 9.5 / 9.0 / 7.9 / 5.9,就是 10×(1−p)。两条线都干净得像公式,因为它们确实是公式:后过滤的名额损失与向量距离无关,只与删除比例有关。
「与 live 真值重叠」那一列和「有效结果」逐行相等——这句是本文最容易被忽略的结论:排序没有错,丢的是条数。很多人排障时先去查召回质量、查 embedding 模型、查距离度量,方向从一开始就偏了;真实故障是 len(results) < k,下游代码假设了 10 条。
「满 10 条查询」这一列更接近线上体感:200 个查询里能拿满 10 条的,五档分别是 200、113、58、16、3。按独立同分布估 (1−p)^10×200 应该是 120 / 70 / 21 / 1.2,实测 113 / 58 / 16 / 3:5% 与 10% 两档低了 7 到 12 个,20% 低 5 个,40% 那档期望只有 1.2 个、3 和 1 的差别没有意义。我先用 50 个查询跑过一版,5% 那档是 25/50,换成 200 个查询后是 113/200,可见这列的抖动不小,所以它只作体感参考,判据用前两列。
这里的坑不在召回,在代码假设
如果检索层只返回 9 条,而业务代码除了 results[0] 还假设 len(results) == 10(拼提示词时按 10 条留位置、rerank 时按 10 条算权重),删除比例一高就会以「空结果」「少一条上下文」的形式暴露,而不是以「答错」的形式暴露——后者至少还有日志可查,前者往往只换来一句「模型今天不太行」。
后过滤本身不是错,错在把「取 k 条」和「要 k 条」当成同一件事。要 k 条就得取 k/(1−p) 条再截断,或者让引擎做前过滤——但补齐不免费,这是下一章要算的账。
三、我发现的偏差:真正难看的不是召回,是扫够 k 条要多扫 1/(1−p)
召回没坏,代价坏:墓碑均匀散布时,扫够 k 条有效结果平均要扫 k/(1−p) 条,空间也放大 1/(1−p) 倍,两条曲线是同一条;但墓碑在段之间并不均匀,所以全局删除比例不能直接当阈值用。
空间放大和扫描放大是同一条曲线
这一组用同一批数据,只把「补齐」打开——一直往下扫,直到凑够 10 条存活结果,数一数总共扫了多少条;同时数一数占用槽位和存活条数的比值。
🧪 实测环境:Python 3.13.12 / macOS / 仅标准库,固定种子 20261027;脚本 work/exp1027/e03_compact.py
import random
random.seed(20261027)
N, DIM, K, QN, SEG = 2000, 8, 10, 200, 10
pts = [[random.uniform(–1, 1) for _ in range(DIM)] for _ in range(N)]
qs = [[random.uniform(–1, 1) for _ in range(DIM)] for _ in range(QN)]
order = list(range(N))
random.shuffle(order)
def d2(a, b):
return sum((x – y) ** 2 for x, y in zip(a, b))
def pad(s, w):
n = sum(2 if ord(c) > 0x3000 else 1 for c in s)
return s + " " * max(0, w – n)
print(pad("状态", 14) + pad("存活", 8) + pad("占用槽位", 12) + pad("空间放大", 12)
+ pad("平均扫描", 12) + pad("理论k/(1-p)", 14))
print("-" * 72)
for pct in (0, 10, 20, 40):
dead = set(order[: N * pct // 100])
live = N – len(dead)
scan = 0
for q in qs:
seen = got = 0
for i in sorted(range(N), key=lambda i: d2(q, pts[i])):
seen += 1
if i not in dead:
got += 1
if got == K:
break
scan += seen
ret = 1.0 / (1.0 – pct / 100)
print(pad(f"压实前 {pct}%", 14) + pad(str(live), 8) + pad(str(N), 12)
+ pad(f"{N / live:.2f}x", 12) + pad(f"{scan / QN:.1f}", 12)
+ pad(f"{K * ret:.1f}", 14))
dead = set(order[: N * 40 // 100])
live = N – len(dead)
print(pad("压实后 40%", 14) + pad(str(live), 8) + pad(str(live), 12)
+ pad("1.00x", 12) + pad(f"{K:.1f}", 12) + pad(f"{K:.1f}", 14))
dead = set(order[: N * 20 // 100])
per = [sum(1 for i in range(s * 200, (s + 1) * 200) if i in dead) for s in range(SEG)]
print()
print("全局删除 20% 时,各段删除比例:")
print(" ".join(f"{c / 200:.0%}" for c in per))
print(f"最低 {min(per) / 200:.0%},最高 {max(per) / 200:.0%},相差 {max(per) – min(per)} 条")
状态 存活 占用槽位 空间放大 平均扫描 理论k/(1-p)
————————————————————————
压实前 0% 2000 2000 1.00x 10.0 10.0
压实前 10% 1800 2000 1.11x 11.1 11.1
压实前 20% 1600 2000 1.25x 12.7 12.5
压实前 40% 1200 2000 1.67x 16.8 16.7
压实后 40% 1200 1200 1.00x 10.0 10.0
全局删除 20% 时,各段删除比例:
20% 20% 17% 22% 21% 16% 18% 22% 22% 24%
最低 16%,最高 24%,相差 15 条
实测 12.7 条对理论 12.5 条、16.8 条对 16.7 条,差 0.1 到 0.2,是 200 个查询的抽样波动,原样贴出来不修。压实后槽位从 2000 掉到 1200、扫描回到 10.0——压实改的是分母,不改检索逻辑,所以它治不了可见性,只治钱和速度。
这里可以直接记一条容量账:删除比例 p 的空间放大就是 1/(1−p),p = 40% 时多占 67%。规划磁盘按这个留,别按「删了会变小」留。
真实世界的墓碑不均匀,所以全局比例不能当阈值
同一份输出最下面那两行才是重点:全局删掉 20% 时,十个段的删除比例是 20% / 20% / 17% / 22% / 21% / 16% / 18% / 22% / 22% / 24%,最低 16%、最高 24%,相差 15 条。也就是说「全局 20%」在段这一层根本不存在。
这解释了为什么产品的阈值是按段定的:Qdrant 的 deleted_threshold 注释写的是 a segment 的删除比例,不是全库。同一个全局 20%,可能是「十段都在 20% 上下」,也可能是「两段全删、八段干净」——前者要重写十段,后者只要动两段,压实成本差五倍,而全局比例一模一样。
所以判据得换成:看每段删除比例的最大值,不看全库平均值。全库平均值只能用来做趋势,不能用来做触发条件。
两条线:一条维护线,一条功能线
把上面两组数字合起来,阈值得出两条,差 3.75 倍:
- 维护线:单段删除比例 > 0.2 就排一次压实。0.2 这个数来自 Qdrant 的默认配置(截至 2026-10-27),是它的默认值,不是行业标准,别的产品要按自己的文档取值;选它当起点是因为 0.2 对应扫描放大 1.25 倍,正好是「能感觉慢一点但还不到告警」的位置。
- 功能线:p > 1 − k/候选池,后过滤连补齐都补不出来。用 pgvector README 自己的例子反推:hnsw.ef_search 默认 40,过滤条件只放过 10% 的行,平均只剩 4 行;换成 k = 10、池 40,就是 p > 0.75 必然凑不满 10 条。这条线以下,多取再截断还能救;这条线以上,只能前过滤或重建。
两条线之间那一大段(0.2 到 0.75),是「性能在慢慢变差但没人报警」的区间,也是绝大多数线上系统真实待着的地方。
四、找独立信源对一遍:三家都承认「删了还占位」,但「什么时候看不见」说的不是同一件事
三份文档在「删除不是物理移除」上完全一致,在「多久之后查询看不到」上却分别落在读侧时间戳、写侧确认、执行器过滤三个不同维度;把它们当成同一个「删除生效时间」来比,是误判的主要来源。
三家的原文我逐句核过
我核的是三家的现行文档,逐句对:
- Milvus:删除把实体标成 logically deleted,空间不立即释放,要 compaction 生成新段、旧段标 Dropped、GC 再删;需要立即可见时用它自己的话说是 For operations requiring immediate visibility, use a “Strong” consistency level.(Product FAQ,截至 2026-10-27)
- Qdrant:删除是 mark as deleted,不立即移除;回收靠 Vacuum Optimizer,触发条件是每段删除比例 ≥ 0.2 且该段至少有 1000 条向量(Optimizer 页,截至 2026-10-27)。
- pgvector:近似索引下过滤在索引扫描之后,匹配 10% 时 ef_search 40 只能剩 4 行;FAQ 一节还补了一句 There may be even less results due to dead tuples or filtering conditions in the query.(README,截至 2026-10-27)
| 删除在存储层是什么 | 实体被标记为逻辑删除 | 标记为已删除,不立即移除 | 行被标记删除,成为 dead tuple |
| 可见性由什么控制 | 一致性级别,默认 bounded staleness | 写入确认,wait=true 才代表已应用 | 事务提交 + 执行器:近似索引下过滤在扫描之后 |
| 空间何时回收 | compaction 重写段,GC 删 Dropped 段 | 段级 vacuum,每段删除比例过阈值才触发 | VACUUM,HNSW 上建议先 REINDEX |
| 过滤在哪一步 | 删除页未说明检索路径细节 | 检索时在图上应用(filterable HNSW) | 索引扫描之后(后过滤) |
| 与我实测对得上的地方 | 有效条数按 k(1−p) 掉 | 0.2 的阈值正落在扫描放大 1.25 倍 | 40×10% = 4 行,与 k/(1−p) 同源 |
三处对不上的地方,逐个说清
第一,「可见」指的不是同一个时刻。Milvus 的一致性级别是读侧的时间戳承诺——查询会等到某个时间点之前的数据都能被看见才返回;Qdrant 的 wait=true 是写侧确认——返回时操作已应用;pgvector 是事务语义,提交后别的会话就看不到那行了,但索引里的 dead tuple 还在。三个都叫「删了」,一个在管读、一个在管写、一个在管事务。
第二,回收的单位不同。段(Milvus、Qdrant)的回收是「重写」,空间是真的还回去;表(Postgres)的回收是「标记可复用」,文件大小经常不降,这是 Postgres 的常规行为,不是 pgvector 的问题。
第三,触发条件不同。Qdrant 给了明确的 0.2 / 1000;Milvus 只说了「后台自动压实」,按段状态触发,具体比例我没在现行文档里核到,所以本文不给数字。
核不到的地方,我摆在这里,不凑数
- Milvus 的 compact-data 页在 milvus.io 上打不开,截至 2026-10-27 返回 404。我改用同站的 Product FAQ 与 pymilvus 的 compact() 参考页取证,所以「Milvus 自动压实的触发比例」这条,本文空着。
- Milvus 的 delete-entities 页通篇是各语言的 API 示例,没有一句关于「删除后何时可见」的说明。可见性的结论我取自 Product FAQ 与 Consistency 页。这不是文档打架,是页面分工如此,但读者拿 delete 那一页去查可见性,一定查不到。
- 三份文档都没有给「删除延迟多少秒」这类数字,所以本文一个都不写。
还有一句必须说在前面:以上每一行都是该产品在它自己文档里的行为,不是「所有向量库都这样」。把某家的默认值当成行业默认,是选型时最容易犯的错——Qdrant 的 0.2 拿到另一套系统里,可能一辈子不触发,也可能每写一次就触发。
五、差异来自哪里:过滤时机、一致性级别、压实触发,三处各自独立
同一个 10% 删除比例在三套系统里表现不同,原因可以完整归到这三个开关上,而且它们互不替代——调一致性级别不会让磁盘降下来,压实也不会让已删数据提前一秒消失。
过滤时机:后过滤吃名额,前过滤吃建索引顺序
后过滤的成本是「名额」:候选池有多大,能捞回多少条就定死了。pgvector 的 40 与 10% 得出 4 行,就是这个算术。要更多结果,官方给的路是开迭代扫描(hnsw.iterative_scan),让它在不够时继续往下扫索引——本质还是「多扫」,只是把补齐这件事交给引擎。
前过滤的成本是「建索引的顺序」。Qdrant 要求 payload 索引先建、数据后灌,否则拿不到那些额外的边;如果先灌了数据再建 payload 索引,得重建 HNSW 才吃到红利。这条对上线排期有直接影响:先建 payload 索引,再灌第一批数据,别反过来。
一个在查询时付钱,一个在建库时付钱。前者随 QPS 线性增长,后者是一次性成本——如果你的删除比例长期在 0.3 以上、QPS 又不低,前过滤的账通常更好看。
一致性级别:决定「什么时候看不见」,不决定「什么时候不占空间」
Milvus 有四级,默认是 bounded staleness:Strong 要等到查询发起时那个系统时间戳之前的数据全部可见才返回,Session 保证同一个客户端写的东西自己立刻读得到,Eventually 跳过一致性检查直接查。官方在 Session 那一段举的例子正好是删除——删掉图书馆里一本书的记录、确认、刷新页面(换了个会话),这本书就不该再出现在搜索结果里。
Qdrant 把这件事放在写的确认上:REST 不带 wait(等价于 wait=false)时,返回只代表「收到了」,文档明说 This uses a form of eventual consistency;要保证「返回时已可查」就带 wait=true。附带一句容易踩的:Python、JavaScript、.NET、Java 客户端默认就把 wait 设成 true,所以你在这几个客户端里感受不到这层差异,换成 REST 直连才会遇到。
pgvector 最朴素:删在同一事务里,提交后别的会话就看不见了,没有「级别」可调。
这一节的结论很实用:如果你的需求是「删了立刻不能答」,要动的是这一层——Strong / Session、wait=true、或者读前先确认;压实解决不了可见性,调压实参数只会让你多等几天。
压实触发:决定「什么时候不占空间」,顺带解释「三天」是哪来的
Qdrant 的门槛是每段 0.2、段内至少 1000 条。反推一下就很清楚:一个段如果长期删除比例低于 20%,vacuum 永远不会为它触发,墓碑就一直躺在那里占名额、占空间。所谓「删了三天还在」,多数时候不是延迟,是没到触发条件——每天删几条、比例卡在 5% 上下,这个段可以带着墓碑跑几个月。
Milvus 是三个动作串行:压实生成新段、旧段标 Dropped、GC 再删。串行意味着空间回收天然比可见性慢两跳,而且每一跳都有自己的周期。
pgvector 是 VACUUM 与索引两条线,HNSW 上还得先 REINDEX。三家的共同点是:回收是后台行为,你能控制的只有「催不催它」,没人能保证一个具体的完成时刻。
《向量库删除与压实参数对照表》:把 Milvus / Qdrant / pgvector 三家的删除、压实、vacuum 相关参数按同一张表列出来,删除比例、触发条件和观测口径各占一列,和本章的三家对账表配套用。放在资料包里,扫码即可获取:
六、选型清单:每段过 20% 排压实,过 75% 只能改前过滤或重建
把观测口径从全局改成按段、把阈值拆成维护线和功能线,剩下的就是一张排障表;如果删除本身是整段下线,根本不该打墓碑。
先按现象分诊,再动手
| top-k 条数不足,排序看着没错 | 后过滤 + 墓碑占名额 | 已删 id 是否出现在前 k 条里 | 按 k/(1−p) 多取再截断,或改前过滤 |
| 同一会话里删完立刻查,还能答出来 | 一致性级别不够、或写入未确认 | 是否 bounded staleness、是否带 wait=true | 强一致读或写后确认,别指望压实 |
| 过了几分钟仍然能答出来 | 删除条件没命中,或读走了缓存 | 删除接口返回的条目数是否等于预期 | 先修条件,再单独失效缓存层 |
| 删了一半,磁盘和内存都不降 | 压实没触发 | 每段删除比例与段内条数是否过阈值 | 手动触发压实,或按段重建 |
| 延迟抖动、扫描变慢但结果还行 | 墓碑导致扫描放大 | 平均扫描条数 ÷ k | 压实,或按段重建 |
三条判据,全部按段算
三条可执行判据:
什么时候可以停手
什么条件下停手,也说清楚:
- 整段、整分区下线(某个文档源整体废弃、某个租户退租)→ 直接删分区或整段重建,别逐条打墓碑。这是最省的一次压实。
- 低频删除(每天几条、每段比例长期低于 5%)→ 不用手动压实,等自动触发;此时扫描放大只有 1.05 倍,为它专门排一次重写不划算。
- 合规要求「删除必须立刻不可答」→ 先解决一致性这一层,再谈压实;压实不是合规手段,它连可见性都不管。
落到一句可以贴在排障手册上的话:删除的可见性看过滤,删除的成本看压实,删除的承诺看一致性级别——三个问题,三条路径,别再用一个「删除生效时间」的指标去量它们。
《检索链路自检清单》:从过滤时机、压实触发到一致性级别,按上线前 / 上线后两栏列出要逐项核的东西,本章那三条判据就是从里面抽出来的。放在资料包里,扫码即可获取:
附表 A:本文引用事实与出处对照表
| 1 | 删除只把实体标成 logically deleted,空间不立即释放;compaction 合并小段并清掉逻辑删除的数据、旧段标 Dropped,GC 再删 Dropped 段 | Product FAQ,Milvus(Zilliz),https://milvus.io/docs/product_faq.md | 2026-10-27 | 第一章第三节、第四章 |
| 2 | 数据可见性由一致性级别管理;需要立即可见用 Strong;默认 bounded staleness;Session 的例子是删除图书馆书目后刷新页面不应再搜到 | Product FAQ + Consistency,Milvus(Zilliz),https://milvus.io/docs/product_faq.md 、https://milvus.io/docs/consistency.md | 2026-10-27 | 第四章、第五章第二节 |
| 3 | delete-entities 页只有各语言的删除 API 示例,没有「删除后何时可见」的表述;compact-data 页返回 404(本文因此未给 Milvus 自动压实的触发比例) | Delete Entities 页、Compact Data 页,Milvus(Zilliz),https://milvus.io/docs/delete-entities.md 、https://milvus.io/docs/compact-data.md | 2026-10-27 | 第四章「核不到的地方」 |
| 4 | 删除不是立即移除,而是 marked as deleted;Vacuum Optimizer 的触发条件是每段删除比例 deleted_threshold: 0.2 且段内至少 vacuum_min_vector_number: 1000 条 | Optimizer,Qdrant,https://qdrant.tech/documentation/concepts/optimizer/ | 2026-10-27 | 第一章第三节、第四章、第五章第三节、第六章 |
| 5 | 删除请求先写 WAL、异步应用;默认 wait=false 时属于最终一致;wait=true 才在操作完成后返回 | Points(Delete Points / Awaiting Result),Qdrant,https://qdrant.tech/documentation/concepts/points/ | 2026-10-27 | 第五章第二节 |
| 6 | filterable HNSW 用 payload 值给图加额外的边,边遍历边过滤(apply filters as you search in the graph);payload 索引必须在灌数据前创建 | Indexing(Filterable HNSW),Qdrant,https://qdrant.tech/documentation/concepts/indexing/ | 2026-10-27 | 第一章第二节、第五章第一节 |
| 7 | 近似索引下过滤在索引扫描之后;匹配 10% 时 hnsw.ef_search 默认 40 平均只剩 4 行;dead tuple 会让结果更少;HNSW 的 vacuum 慢,官方建议先 REINDEX INDEX CONCURRENTLY 再 VACUUM | README(Filtering / Iterative Index Scans / Vacuuming / FAQ),pgvector,https://github.com/pgvector/pgvector | 2026-10-27 | 第一章第二节、第三章第三节、第四章 |
写在最后:这篇用到的资料
写这篇文章时,把相关的官方文档和源码又翻了一遍,顺手也整理了几份配套的东西:
- 大模型学习路线图:从零基础到能自己动手做 Agent,按阶段说明每一步该学什么、哪些可以先跳过
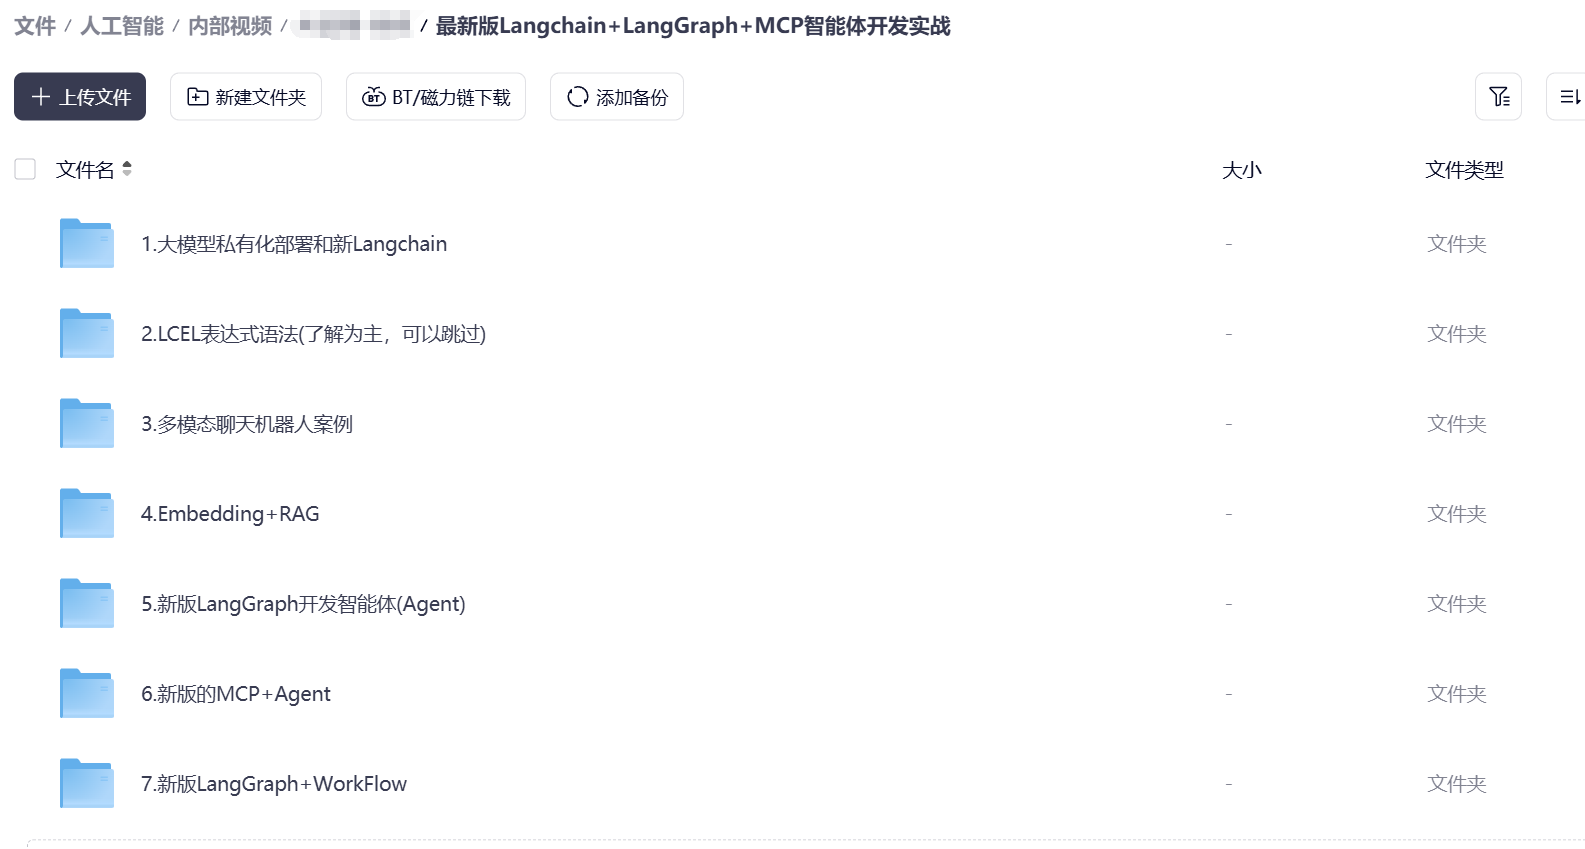
- 《LangChain + LangGraph + MCP 智能体开发实战》视频课:7 个模块,从私有化部署、Embedding+RAG 到 MCP+Agent 全流程
- AI 大模型知识库(在线可查):Agent Skills 从入门到落地、Claude Skills 完全指南等专题,按目录浏览即可
- 640 套 AI 大模型行业报告 + 经典 PDF 书籍:看行业落地案例和别人怎么做的时候用得上
- 大模型零基础到精通教学视频:跟着敲一遍,比只读文档快得多
资料是我自己整理的,放在下面这个码上,扫码即可获取:
添加时备注「AI」,优先通过。
资料按「先路线、再动手、最后查漏」的顺序整理好了,建议先看学习路线那一份,照着它挑一条适合自己当前基础的路径再往下看。