【深度学习数据集推荐】Intel自然场景6分类数据集,支持ResNet、MobileNet、ViT训练
今天分享一个适合深度学习、计算机视觉、图像分类和计算机毕业设计的公开数据集
该数据集包含6类自然场景图片,分别为建筑、森林、冰川、山脉、海洋和街道,可以用于训练CNN卷积神经网络,也适合开展ResNet、MobileNet、EfficientNet和Vision Transformer等模型的对比实验。
与需要自己标注图片的数据集不同,这份数据集已经按照类别整理,并提供训练集、验证集和测试集,下载后就可以进行模型训练。
如果正在做图像分类相关毕业设计,希望找一个类别清晰、容易训练、能够进行模型优化和Web系统开发的数据集,可以考虑这个方向。
一、数据集基本介绍
1.1 数据集概况
| 数据类型 | 自然场景RGB图像 |
| 分类数量 | 6类 |
| 数据格式 | 图片文件 |
| 数据划分 | Train、Val、Test |
| 主要任务 | 多类别图像分类 |
| 推荐算法 | CNN、ResNet、MobileNet、EfficientNet、ViT |
| 推荐框架 | PyTorch、TensorFlow |
| 适用方向 | 图像分类、迁移学习、模型优化、轻量化部署 |
1.2 数据集包含哪些类别?
| buildings | 建筑 | 楼房、建筑群等场景 |
| forest | 森林 | 树木、林地等场景 |
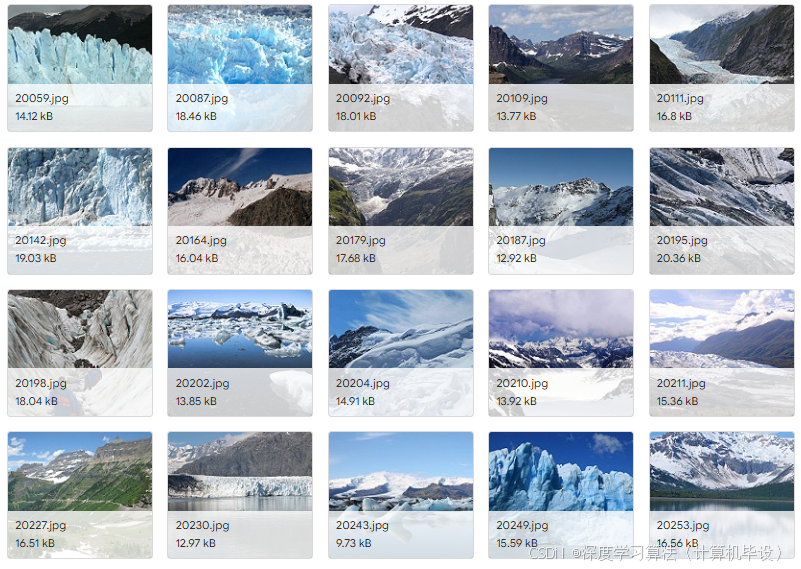
| glacier | 冰川 | 冰雪、冰川地貌 |
| mountain | 山脉 | 山峰、山地景观 |
| sea | 海洋 | 海面、海岸等场景 |
| street | 街道 | 道路、城市街景 |
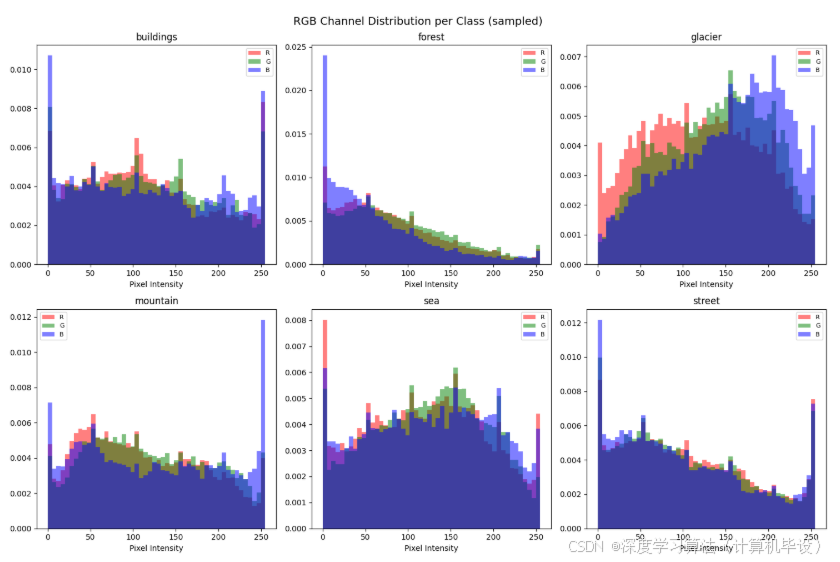
这些类别属于场景级图像分类,模型需要判断一张图片主要属于哪一种场景。
例如,输入一张森林图片,模型输出:
预测类别:forest
中文类别:森林
预测概率:0.96
这里的0.96只是预测结果展示示例,不代表该数据集训练后的实际模型性能。
1.3 数据集目录结构
dataset/
├── train/
│ ├── buildings/
│ ├── forest/
│ ├── glacier/
│ ├── mountain/
│ ├── sea/
│ └── street/
├── val/
│ ├── buildings/
│ ├── forest/
│ ├── glacier/
│ ├── mountain/
│ ├── sea/
│ └── street/
└── test/
├── buildings/
├── forest/
├── glacier/
├── mountain/
├── sea/
└── street/
这种结构可以直接使用PyTorch的ImageFolder读取,不需要另外编写复杂的标签解析程序。
需要注意,这个数据集是图像分类数据集,不是YOLO目标检测数据集。
它没有提供目标检测所需的边界框标签,因此不能直接用于训练YOLO目标检测模型。如果想用YOLO,也应该选择其分类任务版本,例如Ultralytics的YOLO分类模型,而不是检测模型。
二、这个数据集适合哪些深度学习算法?
| 自定义CNN | 网络结构简单,便于理解 | 基础分类实验 |
| ResNet18 | 残差连接,训练稳定 | 基线模型 |
| ResNet50 | 特征提取能力较强 | 模型对比 |
| MobileNetV3 | 参数量较小,适合轻量化 | 部署实验 |
| EfficientNet-B0 | 兼顾精度与计算量 | 分类性能对比 |
| ViT | 基于Transformer的视觉模型 | 深度学习扩展研究 |
如果是本科毕业设计,推荐先使用ResNet18作为基线模型,再加入MobileNetV3、EfficientNet-B0等模型进行对比。
如果希望增加研究深度,可以引入ViT或研究模型轻量化、数据增强、迁移学习等方向。
三、使用该数据集可以做哪些毕业设计?
下面推荐6个题目。
| 1 | 基于ResNet的自然场景图像分类系统设计与实现 | ResNet18、ResNet50 | ★★★ |
| 2 | 基于MobileNetV3的轻量化自然场景识别研究 | MobileNetV3 | ★★★ |
| 3 | 基于EfficientNet的自然场景图像分类方法研究 | EfficientNet-B0 | ★★★ |
| 4 | 基于CNN与Vision Transformer的自然场景分类对比研究 | CNN、ResNet、ViT | ★★★★ |
| 5 | 基于迁移学习的自然场景图像分类优化研究 | ResNet、迁移学习 | ★★★ |
| 6 | 基于深度学习的自然场景智能识别与可视化系统 | ResNet、Flask、Vue | ★★★ |
题目1:基于ResNet的自然场景图像分类系统设计与实现
推荐指数:★★★★★
研究目标:
训练一个能够识别6种自然场景的深度学习模型,并开发图片上传、分类预测和结果展示系统。
推荐算法:
- 自定义CNN
- ResNet18
- ResNet50
主要研究内容:
最终成果:
用户上传一张自然场景图片,系统自动识别场景类别,展示预测概率和模型结果。
题目2:基于MobileNetV3的轻量化自然场景识别研究
推荐指数:★★★★★
这个方向适合希望增加模型优化内容的同学。
研究目标:
在保证一定分类性能的前提下,降低模型参数量和推理计算开销。
推荐算法:
- ResNet18
- MobileNetV3-Small
- MobileNetV3-Large
主要实验:
- 不同模型准确率对比。
- 模型参数量对比。
- 模型文件大小对比。
- 单张图片推理时间对比。
- 不同输入图片尺寸对比。
最终成果:
一个能够在普通电脑或低成本硬件上运行的自然场景分类模型。
如果进一步开展部署实验,可以考虑ONNX格式导出。
题目3:基于EfficientNet的自然场景图像分类方法研究
推荐指数:★★★★☆
研究目标:
研究EfficientNet在六分类自然场景识别任务中的性能,并与传统CNN模型进行对比。
推荐算法:
- ResNet18
- ResNet50
- EfficientNet-B0
实验内容:
适合希望重点研究模型性能,而不是开发复杂系统的同学。
题目4:基于CNN与Vision Transformer的自然场景分类对比研究
推荐指数:★★★★☆
研究目标:
对比卷积神经网络与Vision Transformer在自然场景分类任务中的表现。
推荐算法:
- 自定义CNN
- ResNet18
- ViT-B/16
研究内容:
- 不同网络结构的训练。
- 迁移学习实验。
- 模型准确率对比。
- 模型参数量与推理效率对比。
- 分类错误案例分析。
ViT模型通常需要更多计算资源,建议优先使用预训练权重进行微调,而不是从零训练。
题目5:基于迁移学习的自然场景图像分类优化研究
推荐指数:★★★★★
研究目标:
比较不同迁移学习策略对分类效果的影响。
可以设计以下实验:
| 实验1 | 自定义CNN从零训练 |
| 实验2 | ResNet18冻结特征提取层 |
| 实验3 | ResNet18全网络微调 |
| 实验4 | 加入数据增强 |
| 实验5 | 调整学习率与优化器 |
最终成果:
通过多组实验,分析预训练权重、微调策略和数据增强对自然场景分类性能的影响。
四、Python代码:统计各类别图片数量
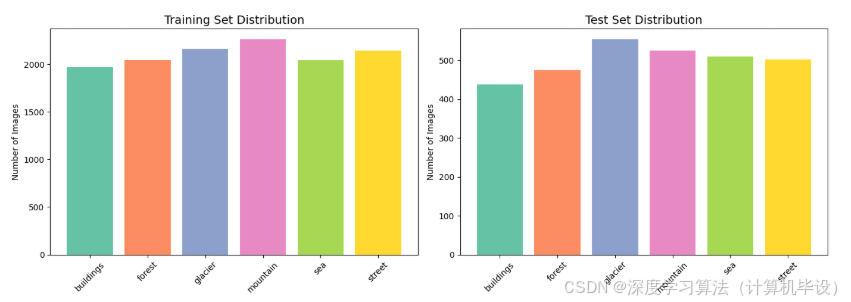
正式训练前,建议先统计数据集的图片数量,确认训练集、验证集和测试集是否完整。
from pathlib import Path
dataset_dir = Path("dataset")
splits = ["train", "val", "test"]
classes = [
"buildings",
"forest",
"glacier",
"mountain",
"sea",
"street"
]
extensions = {".jpg", ".jpeg", ".png", ".webp"}
for split in splits:
print(f"\\n{split} 数据集:")
total = 0
for cls in classes:
folder = dataset_dir / split / cls
count = sum(
1 for p in folder.rglob("*")
if p.is_file() and p.suffix.lower() in extensions
) if folder.exists() else 0
total += count
print(f"{cls}: {count}")
print(f"总计:{total}")
运行后可以得到:
train 数据集:
buildings: …
forest: …
glacier: …
mountain: …
sea: …
street: …
总计:…
val 数据集:
…
test 数据集:
…
具体数量由实际下载文件决定,不应直接使用其他版本Intel场景分类数据集的样本数量代替。
五、Python代码:基于ResNet18的自然场景分类训练
下面给出一份完整的PyTorch训练示例。
使用ResNet18预训练模型,对最后的分类层进行修改,实现6类自然场景识别。
5.1 安装依赖
pip install torch torchvision scikit-learn matplotlib pillow
如果需要GPU训练,应根据CUDA版本安装对应的PyTorch版本。
5.2 项目目录
Scene/
├── dataset/
│ ├── train/
│ ├── val/
│ └── test/
├── train.py
└── best_resnet18.pth
5.3 完整训练代码
import copy
import torch
import torch.nn as nn
from pathlib import Path
from torch.utils.data import DataLoader
from torchvision import datasets, transforms, models
# 1. 基础配置
DATA_DIR = Path("dataset")
BATCH_SIZE = 32
EPOCHS = 20
LR = 0.0001
NUM_CLASSES = 6
device = torch.device(
"cuda" if torch.cuda.is_available() else "cpu"
)
print("运行设备:", device)
# 2. 数据预处理
train_transform = transforms.Compose([
transforms.Resize((224, 224)),
transforms.RandomHorizontalFlip(),
transforms.RandomRotation(10),
transforms.ToTensor(),
transforms.Normalize(
mean=[0.485, 0.456, 0.406],
std=[0.229, 0.224, 0.225]
)
])
eval_transform = transforms.Compose([
transforms.Resize((224, 224)),
transforms.ToTensor(),
transforms.Normalize(
mean=[0.485, 0.456, 0.406],
std=[0.229, 0.224, 0.225]
)
])
# 3. 加载数据集
train_dataset = datasets.ImageFolder(
DATA_DIR / "train",
transform=train_transform
)
val_dataset = datasets.ImageFolder(
DATA_DIR / "val",
transform=eval_transform
)
test_dataset = datasets.ImageFolder(
DATA_DIR / "test",
transform=eval_transform
)
assert train_dataset.classes == val_dataset.classes
assert train_dataset.classes == test_dataset.classes
assert len(train_dataset.classes) == NUM_CLASSES
print("类别:", train_dataset.classes)
print("训练集:", len(train_dataset))
print("验证集:", len(val_dataset))
print("测试集:", len(test_dataset))
train_loader = DataLoader(
train_dataset,
batch_size=BATCH_SIZE,
shuffle=True,
num_workers=0
)
val_loader = DataLoader(
val_dataset,
batch_size=BATCH_SIZE,
shuffle=False,
num_workers=0
)
test_loader = DataLoader(
test_dataset,
batch_size=BATCH_SIZE,
shuffle=False,
num_workers=0
)
# 4. 加载ResNet18预训练模型
model = models.resnet18(
weights=models.ResNet18_Weights.DEFAULT
)
# 修改最后分类层
model.fc = nn.Linear(
model.fc.in_features,
NUM_CLASSES
)
model = model.to(device)
# 5. 损失函数与优化器
criterion = nn.CrossEntropyLoss()
optimizer = torch.optim.Adam(
model.parameters(),
lr=LR
)
best_acc = 0.0
best_state = None
# 6. 训练与验证
for epoch in range(EPOCHS):
model.train()
train_loss = 0.0
train_correct = 0
train_total = 0
for images, labels in train_loader:
images = images.to(device)
labels = labels.to(device)
optimizer.zero_grad()
outputs = model(images)
loss = criterion(outputs, labels)
loss.backward()
optimizer.step()
train_loss += loss.item() * images.size(0)
predictions = outputs.argmax(dim=1)
train_correct += (
predictions == labels
).sum().item()
train_total += labels.size(0)
train_acc = train_correct / train_total
avg_train_loss = train_loss / train_total
# 验证
model.eval()
val_correct = 0
val_total = 0
with torch.no_grad():
for images, labels in val_loader:
images = images.to(device)
labels = labels.to(device)
outputs = model(images)
predictions = outputs.argmax(dim=1)
val_correct += (
predictions == labels
).sum().item()
val_total += labels.size(0)
val_acc = val_correct / val_total
print(
f"Epoch [{epoch+1}/{EPOCHS}] "
f"Loss: {avg_train_loss:.4f} "
f"Train Acc: {train_acc:.4f} "
f"Val Acc: {val_acc:.4f}"
)
# 保存验证集表现最好的模型
if best_state is None or val_acc > best_acc:
best_acc = val_acc
best_state = copy.deepcopy(
model.state_dict()
)
# 7. 保存最佳模型
torch.save(
{
"model_state_dict": best_state,
"classes": train_dataset.classes
},
"best_resnet18.pth"
)
print("最佳验证集准确率:", best_acc)
# 8. 在测试集上评价最佳模型
model.load_state_dict(best_state)
model.eval()
test_correct = 0
test_total = 0
with torch.no_grad():
for images, labels in test_loader:
images = images.to(device)
labels = labels.to(device)
outputs = model(images)
predictions = outputs.argmax(dim=1)
test_correct += (
predictions == labels
).sum().item()
test_total += labels.size(0)
print(
"测试集准确率:",
test_correct / test_total
)
这段代码可以完成:
- 自动读取6类图像。
- 训练集数据增强。
- ResNet18迁移学习。
- 每轮训练与验证。
- 保存最佳模型权重。
- 使用独立测试集进行最终评价。
其中,EPOCHS=20只是基础实验配置,可以根据训练结果调整。
六、Python代码:加载模型并预测新图片
训练完成后,可以使用保存的模型对新图片进行分类。
import torch
import torch.nn as nn
from PIL import Image
from torchvision import models, transforms
device = torch.device(
"cuda" if torch.cuda.is_available() else "cpu"
)
# 1. 加载模型文件
checkpoint = torch.load(
"best_resnet18.pth",
map_location=device,
weights_only=True
)
classes = checkpoint["classes"]
# 2. 构建模型
model = models.resnet18(weights=None)
model.fc = nn.Linear(
model.fc.in_features,
len(classes)
)
model.load_state_dict(
checkpoint["model_state_dict"]
)
model = model.to(device)
model.eval()
# 3. 图片预处理
transform = transforms.Compose([
transforms.Resize((224, 224)),
transforms.ToTensor(),
transforms.Normalize(
mean=[0.485, 0.456, 0.406],
std=[0.229, 0.224, 0.225]
)
])
# 4. 读取新图片
image = Image.open(
"test_image.jpg"
).convert("RGB")
image_tensor = transform(
image
).unsqueeze(0).to(device)
# 5. 模型预测
with torch.no_grad():
outputs = model(image_tensor)
probabilities = torch.softmax(
outputs, dim=1
)[0]
pred_index = probabilities.argmax().item()
print("预测类别:", classes[pred_index])
print(
"预测概率:",
round(
probabilities[pred_index].item(),
4
)
)
将test_image.jpg替换成需要识别的图片路径,就可以输出预测类别和模型概率。
需要注意,Softmax概率是模型输出的分类置信度,并不必然等于真实正确概率。
七、毕业设计可以增加哪些实验?
如果只训练一个ResNet18模型,研究内容可能比较基础。
建议至少增加多模型对比、数据增强或迁移学习实验。
7.1 多模型对比实验
| 自定义CNN | 待实验 | 待实验 | 待统计 | 待测试 |
| ResNet18 | 待实验 | 待实验 | 待统计 | 待测试 |
| ResNet50 | 待实验 | 待实验 | 待统计 | 待测试 |
| MobileNetV3 | 待实验 | 待实验 | 待统计 | 待测试 |
| EfficientNet-B0 | 待实验 | 待实验 | 待统计 | 待测试 |
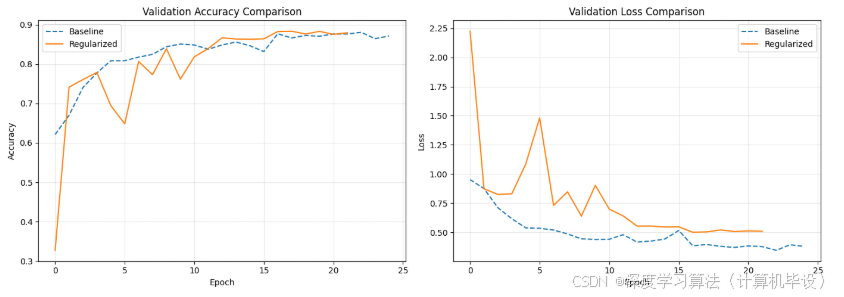
所有模型应尽量使用相同的数据划分,并记录训练环境、输入尺寸、训练轮数和优化器配置,保证实验结果可比较。
7.2 数据增强实验
| 实验1 | 不使用随机数据增强 |
| 实验2 | 随机水平翻转 |
| 实验3 | 水平翻转 + 随机旋转 |
| 实验4 | RandomResizedCrop |
| 实验5 | ColorJitter |
通过实验比较不同数据增强策略对模型泛化性能的影响。
7.3 迁移学习实验
可以比较以下三种方案:
比较验证集和测试集性能、训练时间及收敛情况。
7.4 分类错误分析
除了总体准确率,还建议绘制:
- 六分类混淆矩阵。
- 各类别Precision、Recall、F1-score。
- 错误分类样本图。
- 不同模型的错误案例对比。
例如,冰川和山脉、建筑和街道等类别可能存在视觉特征重叠,适合开展具体的错误案例分析,但实际混淆程度应以实验结果为准。
八、如果开发Web系统,可以设计哪些功能?
如果希望完成一个能够演示的毕业设计系统,可以采用:
PyTorch + Flask + Vue + ECharts
| 系统首页 | 展示六分类任务与模型信息 |
| 图片上传 | 上传自然场景图片 |
| 智能分类 | 自动预测场景类别 |
| 预测结果 | 显示类别与预测概率 |
| Top-3预测 | 展示概率最高的三个类别 |
| 模型对比 | 对比不同模型的分类结果 |
| 训练分析 | 展示Loss、Accuracy变化曲线 |
| 模型评价 | 展示混淆矩阵与分类报告 |
| 历史记录 | 保存并查询预测结果 |
系统可以分为两个部分:
模型训练端: 负责数据读取、模型训练、验证和模型保存。
Web应用端: 负责图片上传、模型推理和结果展示。
这样既能体现深度学习算法,也能展示完整的软件开发流程。