/* MD / 富文本中的 .toc(含博客园搬家等嵌套结构);.toc-box 在侧栏,不受影响 */
#content_views .toc,
/* 编辑器常在目录前后插入空 p(:empty 仍占 20px),一并去掉避免顶空隙 */
#content_views.markdown_views > p:empty:has(+ .toc),
#content_views.markdown_views > .toc + p:empty,
/* 富文本旧版目录标记 */
#content_views.htmledit_views #main-toc,
#content_views.htmledit_views #hr-toc,
#content_views.htmledit_views p[id*=\”-toc\”] {
display: none !important;
}
/* 目录去掉后,紧跟的首个标题不再多出一块上边距 */
#content_views.markdown_views > .toc + h1,
#content_views.markdown_views > .toc + h2,
#content_views.markdown_views > .toc + h3,
#content_views.markdown_views > .toc + h4,
#content_views.markdown_views > .toc + p:empty + h1,
#content_views.markdown_views > .toc + p:empty + h2,
#content_views.markdown_views > .toc + p:empty + h3,
#content_views.markdown_views > .toc + p:empty + h4 {
margin-top: 0 !important;
}
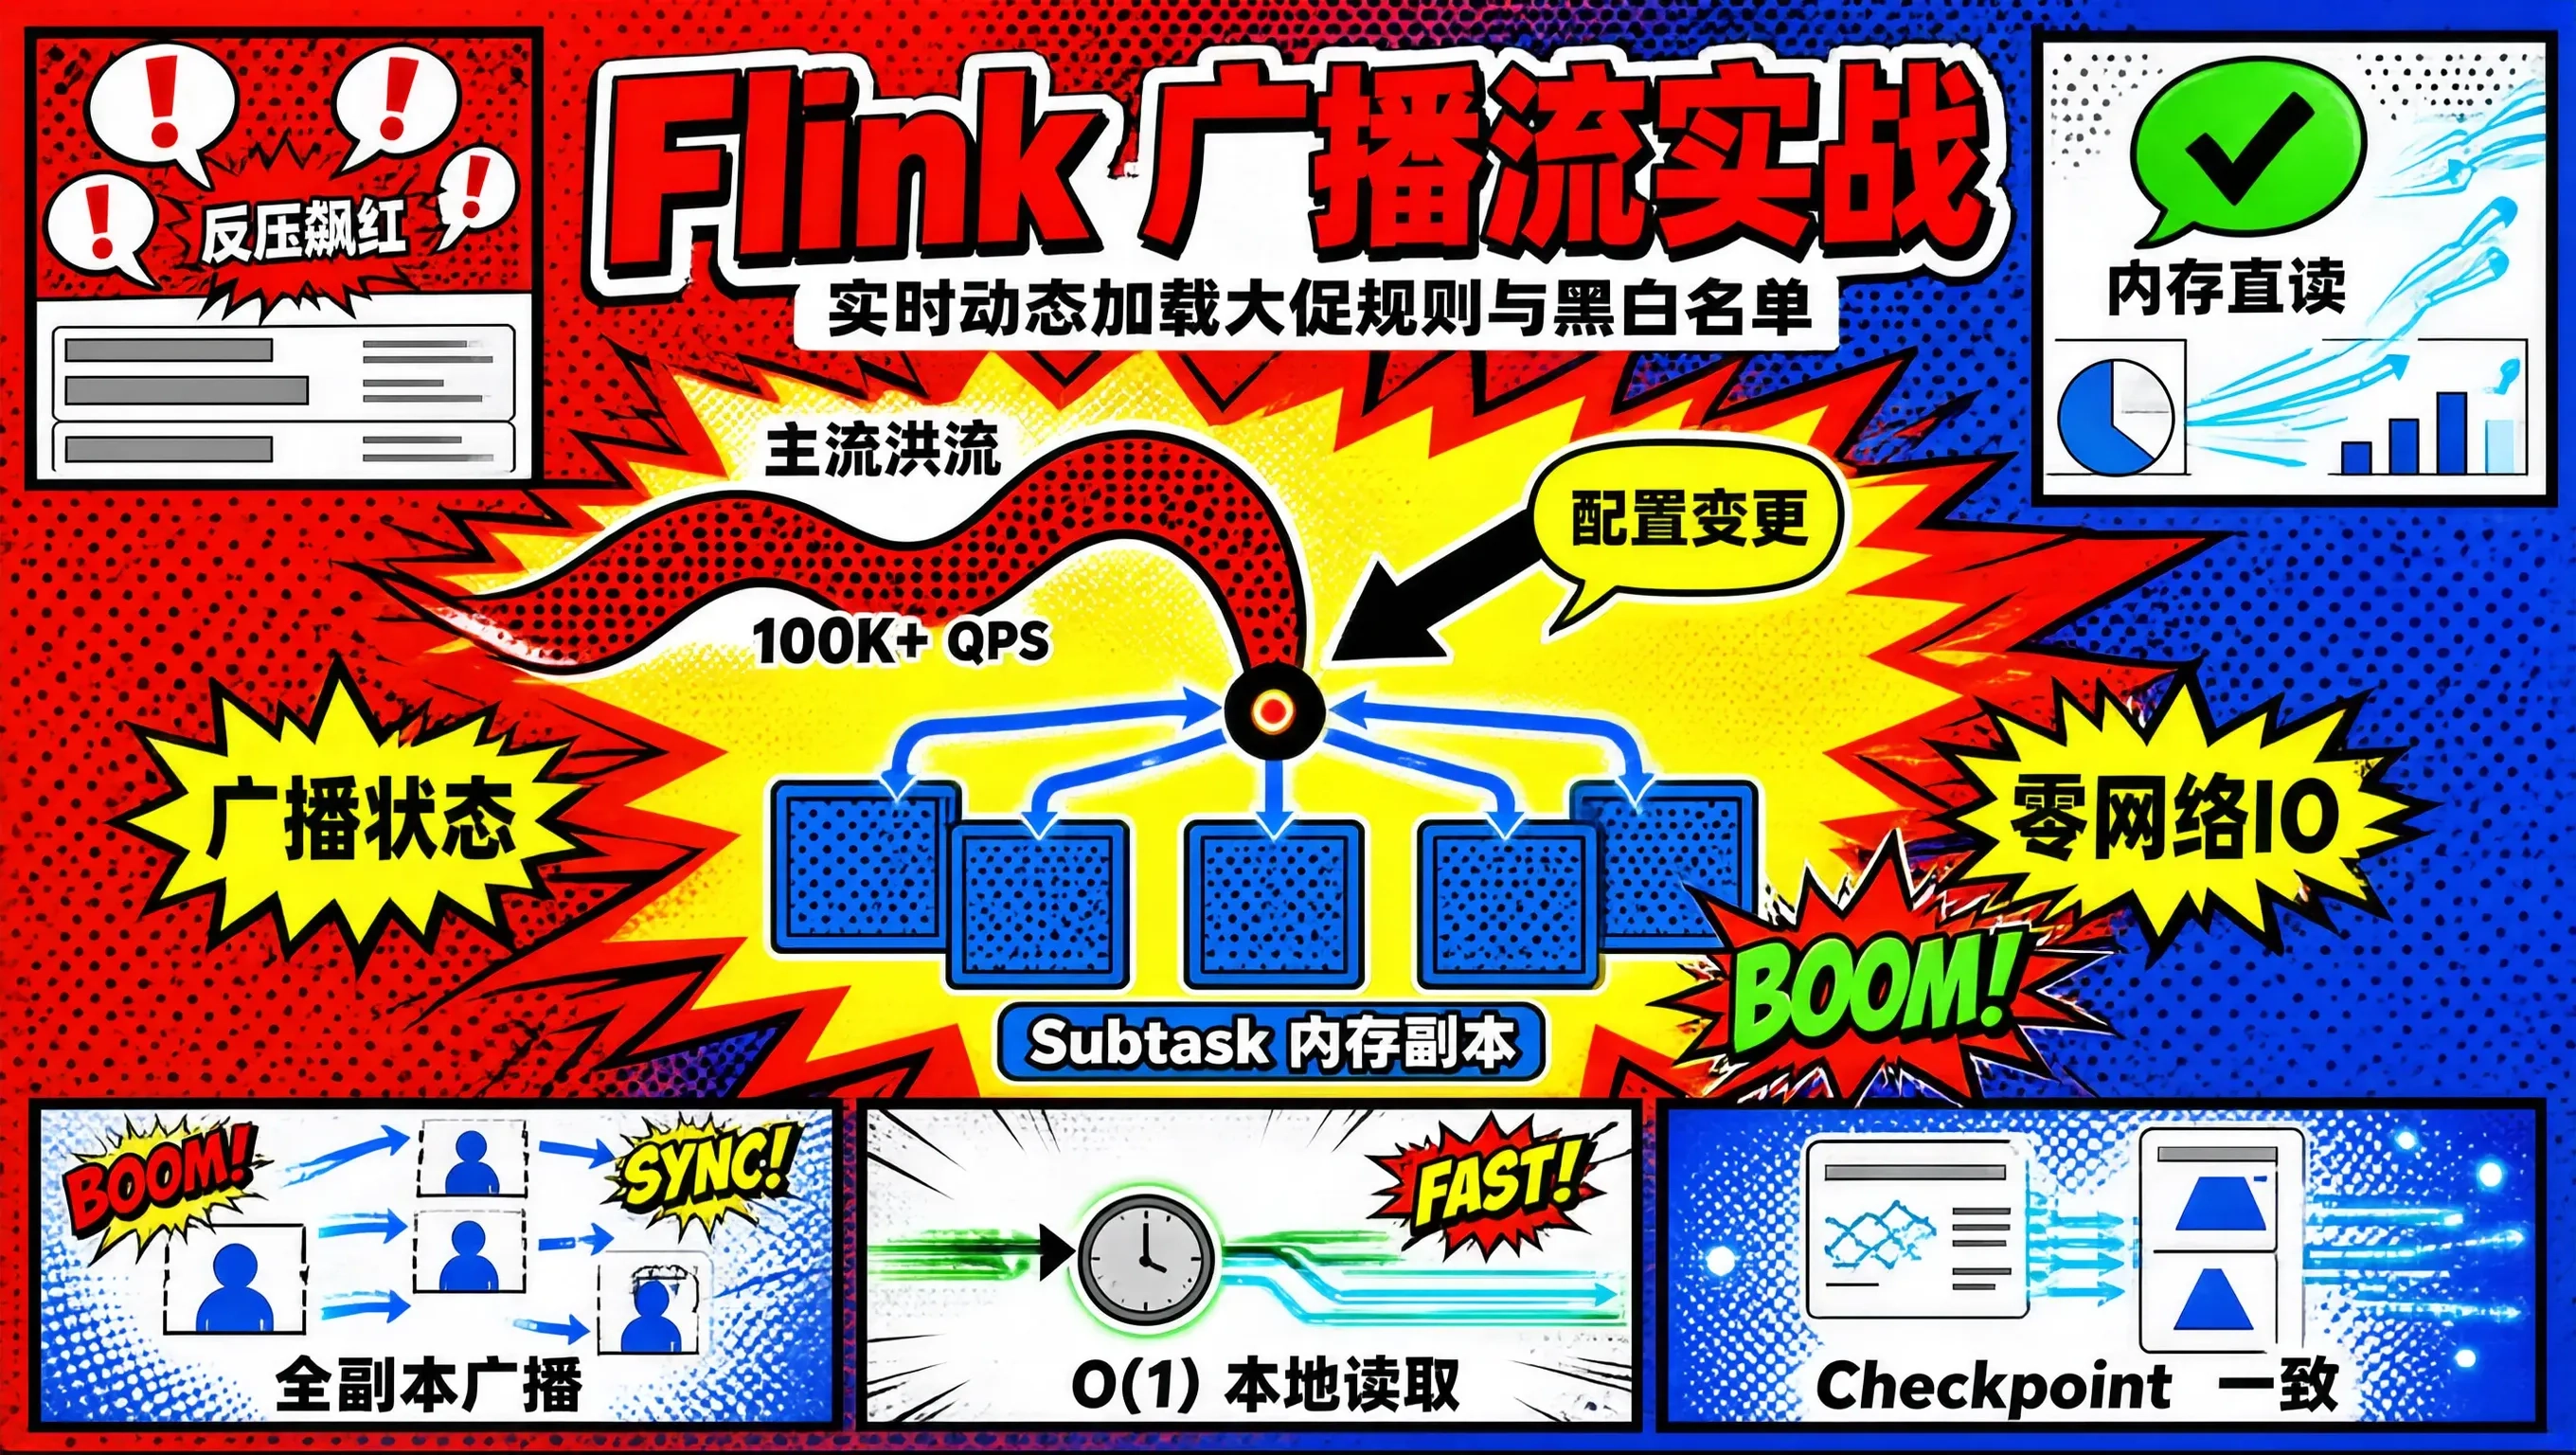
在每年的双 11 或大型促销战役中,实时风控和营销计算引擎面临着极具挑战的“冰与火之歌”:
- 火(高吞吐主流):全网订单流和支付流水如同狂暴的洪流,峰值并发高达每秒数十万条(100K+ QPS);
- 冰(低频动态配置):运营人员在后台动态调整的促销满减规则、高危黑产 IP 黑名单、以及商户特权白名单,变更频率极低(几分钟甚至几小时更新一次),但要求在毫秒级内对全网正在运行的流计算算子实时生效。
针对这种场景,很多刚接触实时计算的同学会写出如下的“致命代码”:在 Flink 的 RichMapFunction 或 ProcessFunction 中,针对每一条进来的订单数据,直接发起一次同步或异步的 Redis / MySQL 查询去读取最新的规则配置。
在平峰期可能相安无事,但在大促洪峰到达的瞬间,几万个并发 Task 同时狂轰滥炸外部缓存,不仅连接池瞬间打爆,网络 I/O 阻塞导致 Flink 反压(Backpressure)直接飙红,甚至会导致 Redis 集群当场雪崩。
解决这一工业级痛点的标准架构,正是 Flink 为低频配置动态加载量身打造的神器——广播状态流(Broadcast State Pattern)。
一、架构解析:Broadcast State 的底层运转机制
要用好广播流,首先要深刻理解它在 Flink 分布式物理拓扑中的内存布局。
[主流: 亿级订单事件流] ───────────┐
│
▼ connect()
┌───────────────────────────────┐
│ Flink BroadcastProcessFunction│
│ ┌───────────────────────────┐ │
│ │ 每一个 TaskManager 内存: │ │
│ │ 独立的只读 Broadcast State │ │
│ └───────────────────────────┘ │
└───────────────────────────────┘
▲
│ broadcast()
[配置流: MySQL CDC / Kafka] ─────┘
(低频变更的促销规则与黑名单)
1. 内存全副本广播(Broadcast Distribution)
普通的 DataStream 在经过 keyBy 后,数据会按照 Hash 路由打散到不同的并行子任务(Subtask)中。而对于配置流,我们调用 .broadcast(MapStateDescriptor) 之后,Flink 会将该流中的每一条配置变更事件,以全量广播的方式复制下发给下游该算子的每一个并发 Subtask。
2. 纯内存本地读取,零网络 I/O
在每个 Subtask 内部,Flink 会开辟一块专属于该算子的 BroadcastState。当配置流数据到达时,触发 processBroadcastElement,在本地内存中更新规则 Map;当主流海量订单数据到达时,触发 processElement,直接以 $O(1)$ 的速度在本地内存读取该规则进行匹配计算。整个判定逻辑完全在 CPU 缓存和物理内存中完成,没有任何外部 RPC、没有网络阻塞,吞吐量直接跑满硬件极限!
二、生产级实战:完整工程代码实现
下面是一个完整的生产级 Java 工程模板:主流消费 Kafka 订单流,配置流通过 Canal / Debezium CDC 监听 MySQL 促销规则表。
1. 核心状态描述符与处理函数
import org.apache.flink.api.common.state.MapStateDescriptor;
import org.apache.flink.api.common.typeinfo.BasicTypeInfo;
import org.apache.flink.api.common.typeinfo.TypeInformation;
import org.apache.flink.streaming.api.datastream.BroadcastStream;
import org.apache.flink.streaming.api.datastream.DataStream;
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;
import org.apache.flink.streaming.api.functions.co.KeyedBroadcastProcessFunction;
import org.apache.flink.util.Collector;
public class DynamicPromotionEngine {
// 1. 定义广播状态描述符:以 RuleId 为 Key,存储具体的规则实体
public static final MapStateDescriptor<String, PromotionRule> PROMOTION_RULE_STATE =
new MapStateDescriptor<>(
"promotion-rules-broadcast-state",
BasicTypeInfo.STRING_TYPE_INFO,
TypeInformation.of(PromotionRule.class)
);
public static void main(String[] args) throws Exception {
StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();
// 2. 主流:订单事件流 (高并发)
DataStream<OrderEvent> orderStream = env.fromSource(…)
.name("Order-Event-Source");
// 3. 配置流:规则变更流 (通过 MySQL CDC 或特定 Topic,低频)
DataStream<PromotionRule> ruleStream = env.fromSource(…)
.name("Promotion-Rule-CDC-Source");
// 4. 将配置流转化为广播流
BroadcastStream<PromotionRule> broadcastRuleStream = ruleStream.broadcast(PROMOTION_RULE_STATE);
// 5. 将主流按商户进行 keyBy,随后与广播流连接 (connect)
DataStream<EnrichedOrder> enrichedStream = orderStream
.keyBy(OrderEvent::getMerchantId)
.connect(broadcastRuleStream)
.process(new DynamicPromotionMatchingFunction());
enrichedStream.addSink(…).name("Result-Kafka-Sink");
env.execute("Flink-Dynamic-Promotion-Broadcast-Job");
}
/**
* 核心连接处理函数:
* 参数泛型依次为: Key, 主流元素类型, 广播流元素类型, 输出类型
*/
public static class DynamicPromotionMatchingFunction
extends KeyedBroadcastProcessFunction<String, OrderEvent, PromotionRule, EnrichedOrder> {
/**
* 处理主流订单事件 (每一笔订单都会进入此方法,极致性能)
*/
@Override
public void processElement(OrderEvent order, ReadOnlyContext ctx, Collector<EnrichedOrder> out) throws Exception {
// 获取广播状态的只读句柄 (只读,保证多线程与快照安全)
org.apache.flink.api.common.state.ReadOnlyBroadcastState<String, PromotionRule> state =
ctx.getBroadcastState(PROMOTION_RULE_STATE);
PromotionRule activeRule = state.get(order.getRuleId());
boolean isHitPromo = false;
double finalAmount = order.getPayAmount();
if (activeRule != null && activeRule.isEnabled()) {
// 校验黑名单与满足门槛
if (!activeRule.getBlacklistUsers().contains(order.getUserId())) {
if (order.getPayAmount() >= activeRule.getThresholdAmount()) {
finalAmount -= activeRule.getDiscountAmount();
isHitPromo = true;
}
}
}
out.collect(new EnrichedOrder(
order.getOrderId(),
order.getUserId(),
order.getPayAmount(),
finalAmount,
isHitPromo
));
}
/**
* 处理广播流规则变更 (仅在后台修改促销规则或增减黑名单时触发)
*/
@Override
public void processBroadcastElement(PromotionRule rule, Context ctx, Collector<EnrichedOrder> out) throws Exception {
// 获取广播状态的可写句柄
org.apache.flink.api.common.state.BroadcastState<String, PromotionRule> state =
ctx.getBroadcastState(PROMOTION_RULE_STATE);
if (rule.isDeleted()) {
// 运营在后台删除了该规则,从本地状态移除
state.remove(rule.getRuleId());
} else {
// 新增或更新规则,直接写入本地状态
state.put(rule.getRuleId(), rule);
}
}
}
}
三、Checkpoint 快照一致性保障
很多架构师会担心:“既然广播流是复制给每个并发 Subtask 的,那在分布式快照(Checkpoint)时,状态会不会被重复保存好几份,导致快照文件极其臃肿?”
Flink 针对广播状态进行了专门的快照设计:
四、生产避坑四大守则
广播流虽然威力巨大,但在生产落地中如果使用不当,依然可能引发隐蔽故障:
五、总结
在实时数仓的高并发赛场上,**“把高频查询的数据留在离 CPU 最近的地方”**是性能调优的永恒真理。
Flink 广播状态流完美解决了流计算中动静结合的实时配置同步难题。它不仅让业务运营能够享受秒级调整大促策略的敏捷,更为底层引擎卸下了沉重的外部依赖包袱,是每一位流计算架构师必须精通的实战重器。


