💖💖作者:计算机毕业设计杰瑞 💙💙个人简介:曾长期从事计算机专业培训教学,本人也热爱上课教学,语言擅长Java、微信小程序、Python、Golang、安卓Android等,开发项目包括大数据、深度学习、网站、小程序、安卓、算法。平常会做一些项目定制化开发、代码讲解、答辩教学、文档编写、也懂一些降重方面的技巧。平常喜欢分享一些自己开发中遇到的问题的解决办法,也喜欢交流技术,大家有技术代码这一块的问题可以问我! 💛💛想说的话:感谢大家的关注与支持! 💜💜 网站实战项目 安卓/小程序实战项目 大数据实战项目 深度学校实战项目 计算机毕业设计选题推荐
目录
- 基于深度学习的面部表情识别研究介绍
- 基于深度学习的面部表情识别研究演示视频
- 基于深度学习的面部表情识别研究演示图片
- 基于深度学习的面部表情识别研究代码展示
- 基于深度学习的面部表情识别研究文档展示
基于深度学习的面部表情识别研究介绍
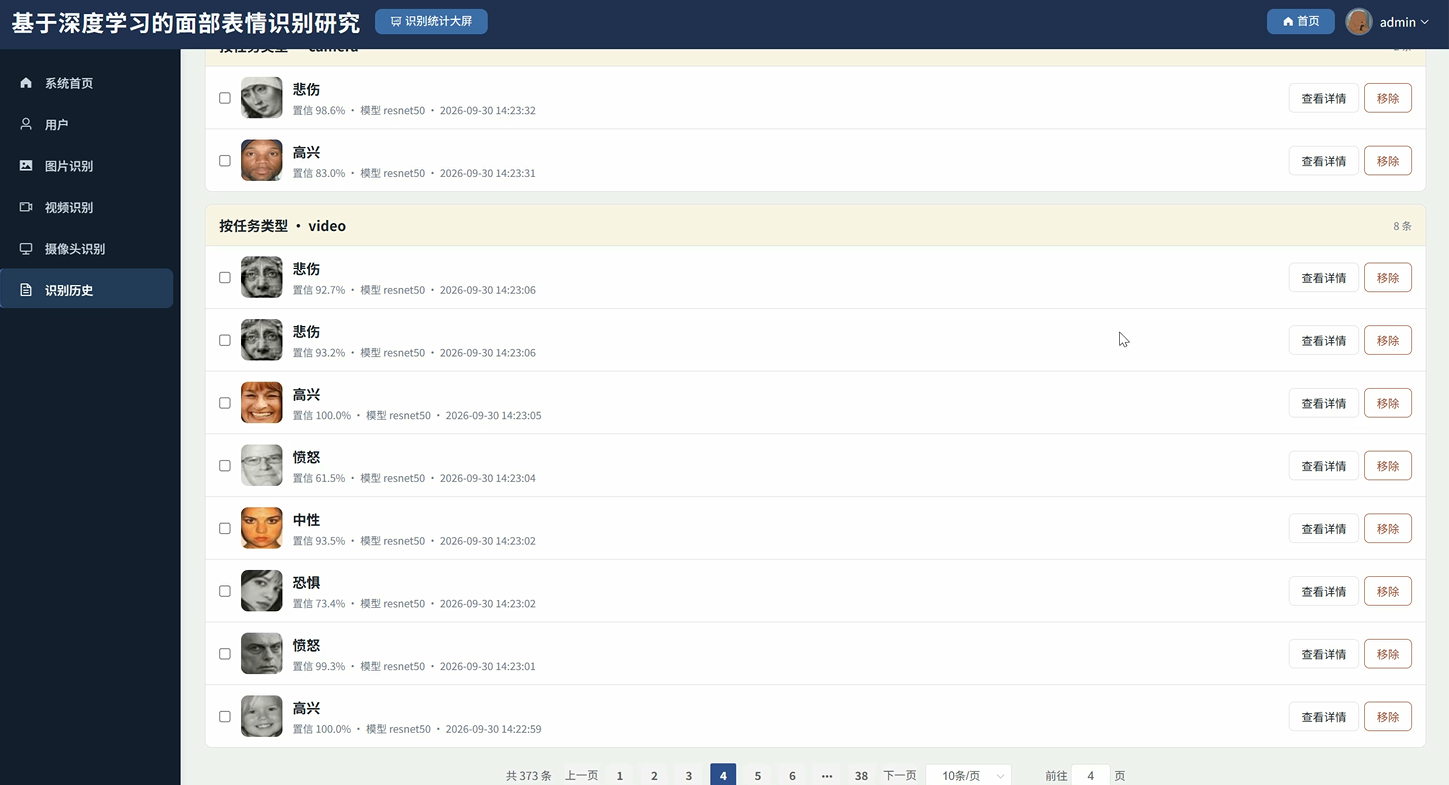
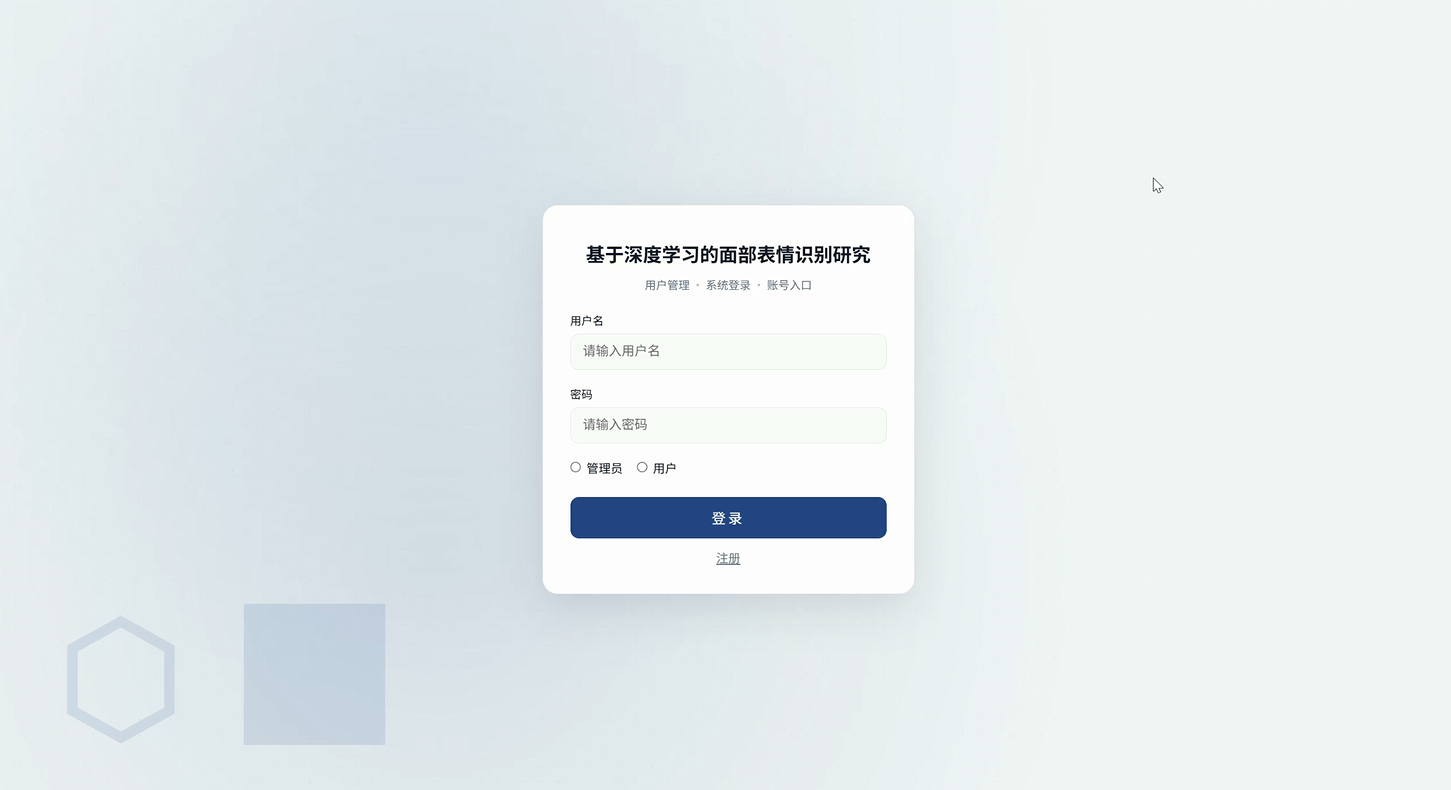
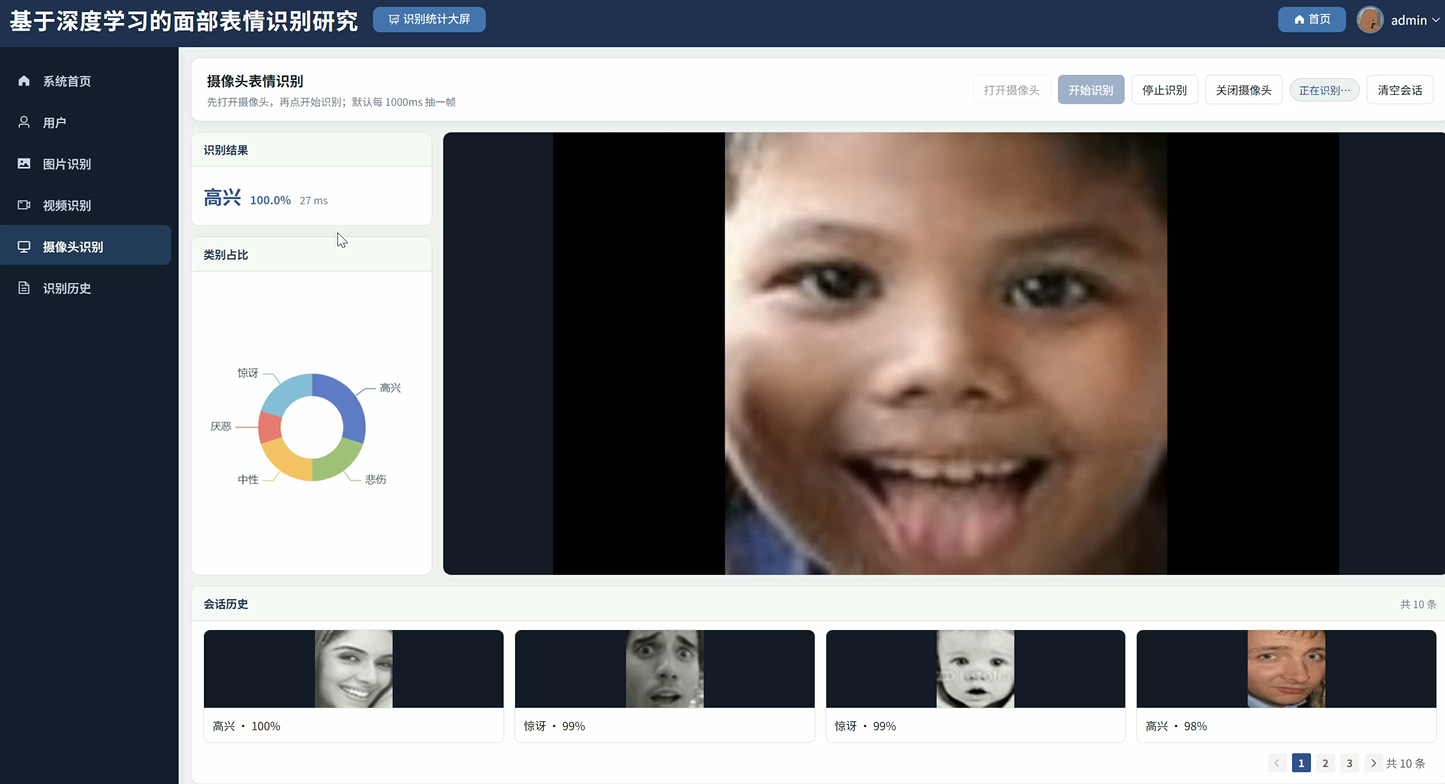
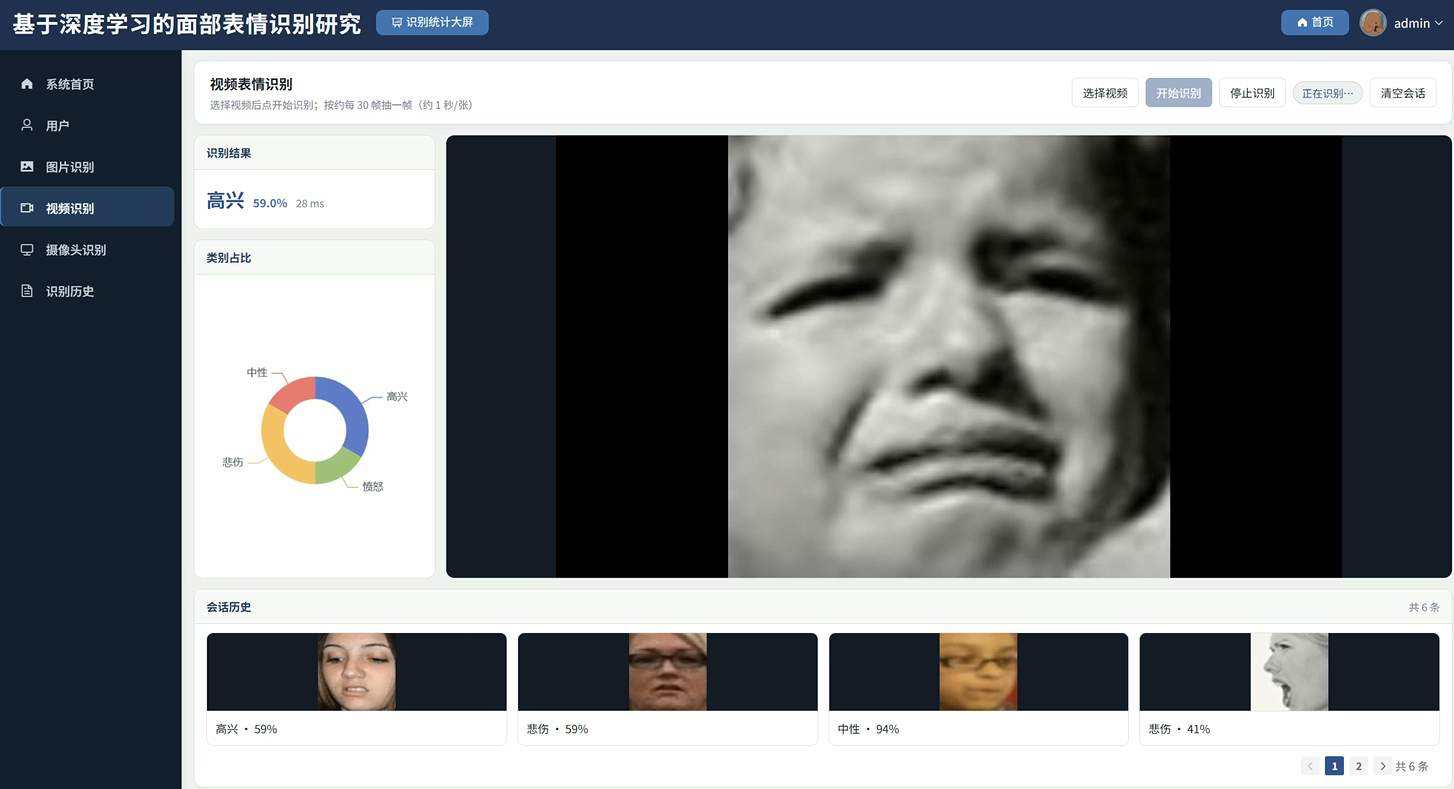
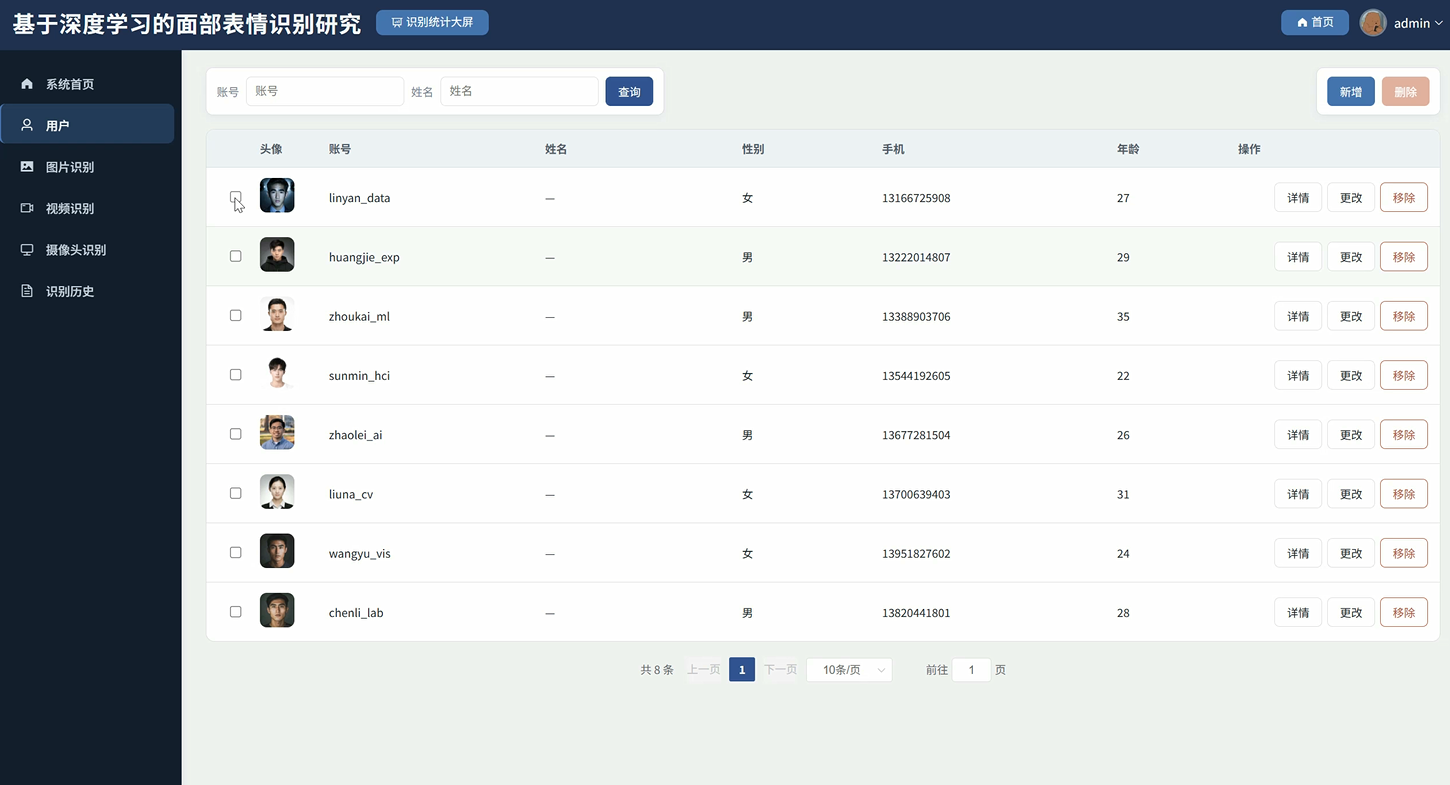
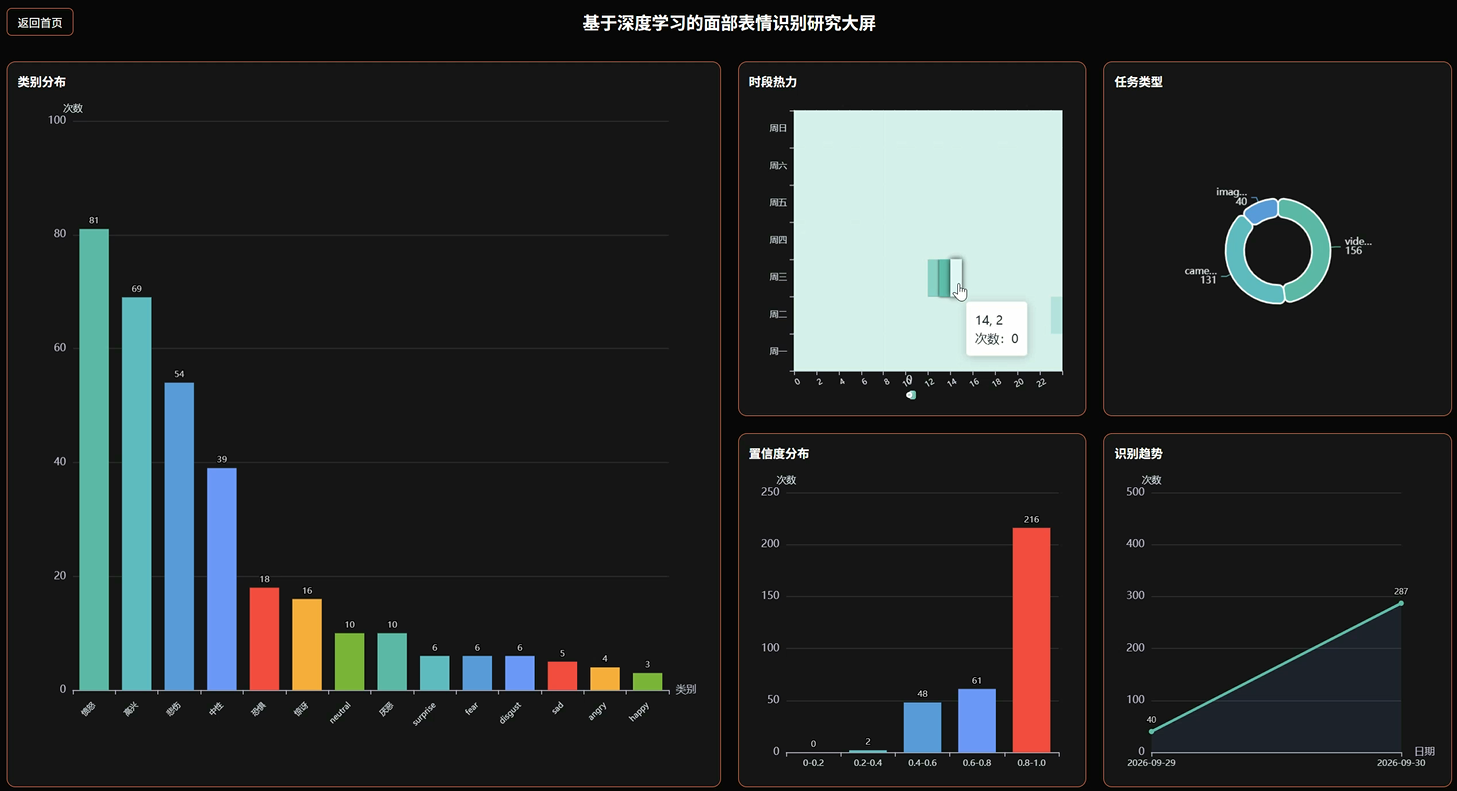
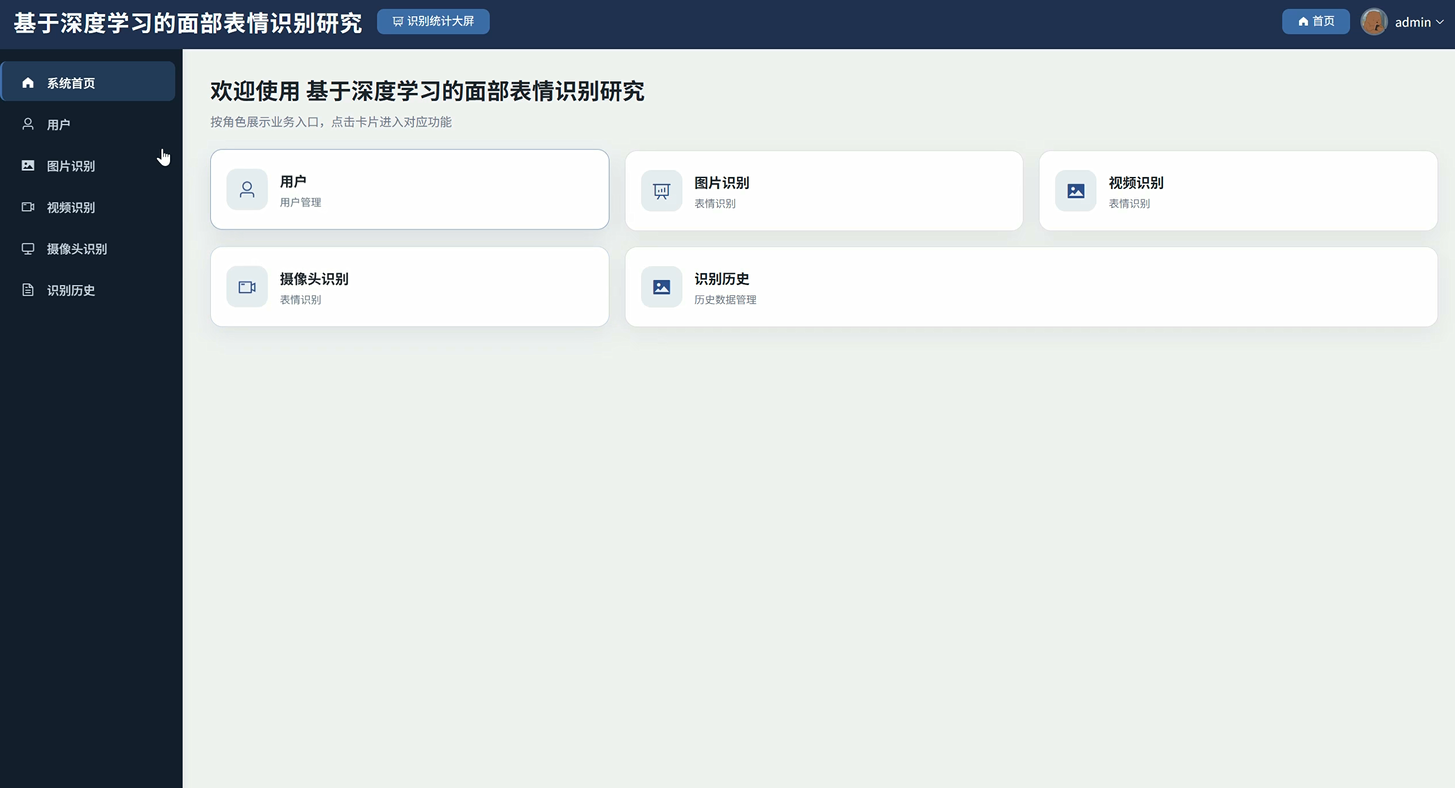
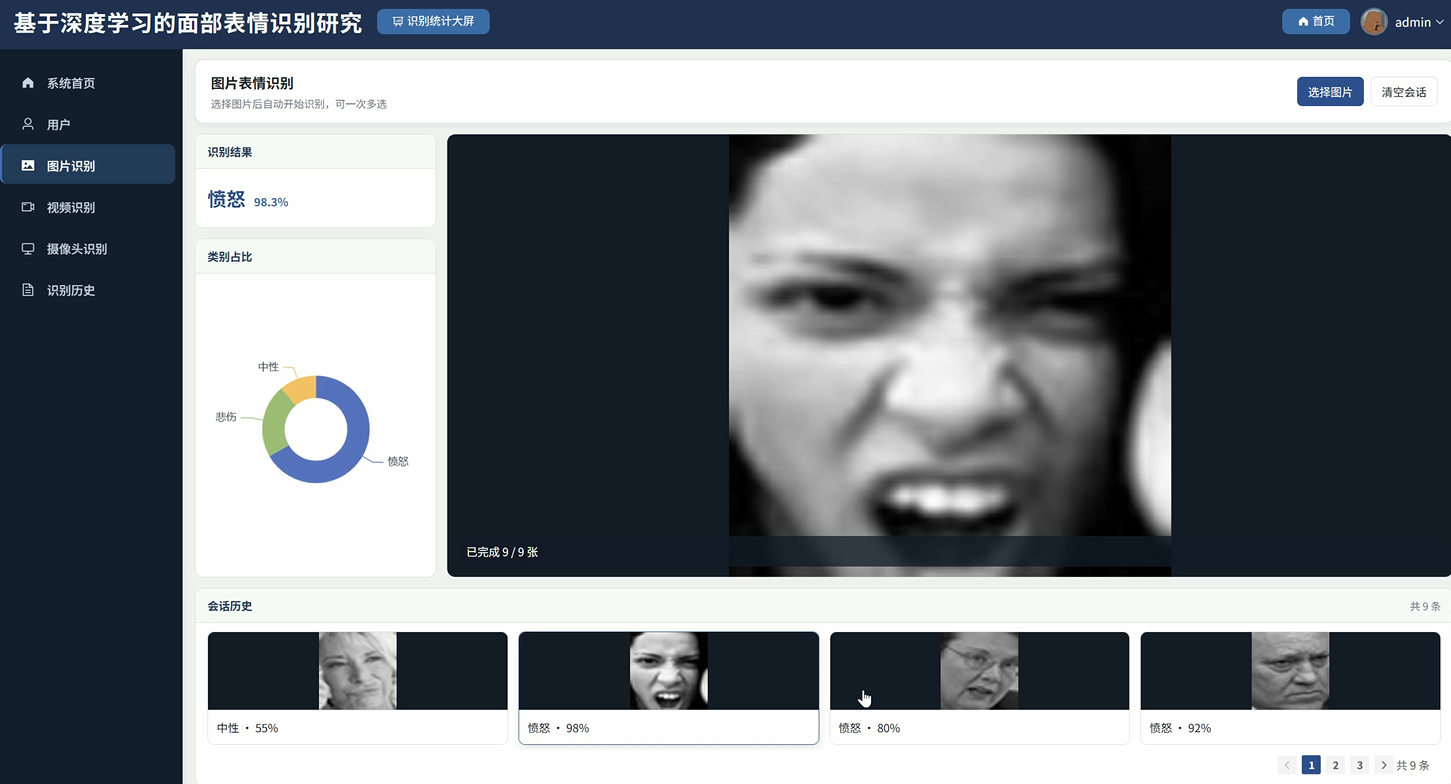
本系统名为《基于深度学习的面部表情识别研究》,采用Python语言与Django框架搭建后端服务,核心识别能力依托深度学习模型实现,面向毕业设计场景完成从模型调用到业务落地的完整闭环。系统包含系统首页、用户、图片识别、视频识别、摄像头识别、识别历史六个功能模块。用户模块负责账号注册登录与身份校验,为后续识别业务提供会话基础;图片识别模块接收用户上传的静态人脸图像,经过预处理后送入深度学习模型推理,返回表情类别与置信度;视频识别模块对上传的视频文件逐帧抽取人脸区域并批量推理,汇总整段视频的表情分布结果;摄像头识别模块调用本地摄像头实时采集画面,按帧完成在线表情判别并即时反馈;识别历史模块将每次识别的类型、时间、结果与置信度持久化存储,支持用户按条件回查与结果复盘。各模块围绕深度学习推理这条主线组织,前后端通过Django视图与模板协同完成请求响应,形成一套结构清晰、功能完整、可运行可演示的面部表情识别系统。
基于深度学习的面部表情识别研究演示视频
演示视频
基于深度学习的面部表情识别研究演示图片
基于深度学习的面部表情识别研究代码展示
from pyspark.sql import SparkSession
from django.shortcuts import render, redirect
from django.http import JsonResponse
from django.contrib.auth.decorators import login_required
from django.core.files.storage import default_storage
from datetime import datetime
import os
import cv2
import numpy as np
from .models import RecognitionHistory
from .emotion_model import predict_emotion
spark = SparkSession.builder.appName("FacialEmotionRecognition").master("local[*]").getOrCreate()
@login_required
def image_recognition(request):
if request.method != "POST":
return render(request, "recognition/image.html")
upload_file = request.FILES.get("image")
if not upload_file:
return JsonResponse({"code": 400, "msg": "未检测到上传图片"})
save_path = default_storage.save("uploads/images/" + upload_file.name, upload_file)
abs_path = default_storage.path(save_path)
image_data = cv2.imread(abs_path)
if image_data is None:
return JsonResponse({"code": 400, "msg": "图片读取失败,请更换文件"})
gray = cv2.cvtColor(image_data, cv2.COLOR_BGR2GRAY)
face_cascade = cv2.CascadeClassifier(cv2.data.haarcascades + "haarcascade_frontalface_default.xml")
faces = face_cascade.detectMultiScale(gray, scaleFactor=1.1, minNeighbors=5, minSize=(48, 48))
if len(faces) == 0:
return JsonResponse({"code": 400, "msg": "未在图片中检测到人脸"})
x, y, w, h = faces[0]
face_region = image_data[y:y + h, x:x + w]
face_resized = cv2.resize(face_region, (48, 48))
emotion_label, confidence = predict_emotion(face_resized)
record = RecognitionHistory.objects.create(user=request.user, recog_type="image", source_name=upload_file.name, emotion=emotion_label, confidence=round(float(confidence), 4), create_time=datetime.now())
df = spark.createDataFrame([(record.user_id, record.recog_type, record.emotion, record.confidence)], ["user_id", "recog_type", "emotion", "confidence"])
df.write.mode("append").format("parquet").save("/data/emotion_history_parquet")
return JsonResponse({"code": 200, "msg": "识别成功", "emotion": emotion_label, "confidence": round(float(confidence), 4), "record_id": record.id})
@login_required
def video_recognition(request):
if request.method != "POST":
return render(request, "recognition/video.html")
upload_file = request.FILES.get("video")
if not upload_file:
return JsonResponse({"code": 400, "msg": "未检测到上传视频"})
save_path = default_storage.save("uploads/videos/" + upload_file.name, upload_file)
abs_path = default_storage.path(save_path)
capture = cv2.VideoCapture(abs_path)
if not capture.isOpened():
return JsonResponse({"code": 400, "msg": "视频无法打开,请更换文件"})
face_cascade = cv2.CascadeClassifier(cv2.data.haarcascades + "haarcascade_frontalface_default.xml")
frame_count = 0
valid_count = 0
emotion_counter = {}
confidence_sum = {}
while True:
ret, frame = capture.read()
if not ret:
break
frame_count += 1
if frame_count % 5 != 0:
continue
gray = cv2.cvtColor(frame, cv2.COLOR_BGR2GRAY)
faces = face_cascade.detectMultiScale(gray, scaleFactor=1.1, minNeighbors=5, minSize=(48, 48))
if len(faces) == 0:
continue
x, y, w, h = faces[0]
face_region = frame[y:y + h, x:x + w]
face_resized = cv2.resize(face_region, (48, 48))
emotion_label, confidence = predict_emotion(face_resized)
valid_count += 1
emotion_counter[emotion_label] = emotion_counter.get(emotion_label, 0) + 1
confidence_sum[emotion_label] = confidence_sum.get(emotion_label, 0.0) + float(confidence)
capture.release()
if valid_count == 0:
return JsonResponse({"code": 400, "msg": "视频中未检测到有效人脸"})
main_emotion = max(emotion_counter, key=emotion_counter.get)
avg_confidence = round(confidence_sum[main_emotion] / emotion_counter[main_emotion], 4)
record = RecognitionHistory.objects.create(user=request.user, recog_type="video", source_name=upload_file.name, emotion=main_emotion, confidence=avg_confidence, create_time=datetime.now())
df = spark.createDataFrame([(record.user_id, record.recog_type, record.emotion, record.confidence, frame_count, valid_count)], ["user_id", "recog_type", "emotion", "confidence", "frame_count", "valid_count"])
df.write.mode("append").format("parquet").save("/data/emotion_video_parquet")
return JsonResponse({"code": 200, "msg": "视频识别完成", "main_emotion": main_emotion, "confidence": avg_confidence, "valid_frames": valid_count, "record_id": record.id})
@login_required
def camera_recognition(request):
if request.method != "POST":
return render(request, "recognition/camera.html")
frame_file = request.FILES.get("frame")
if not frame_file:
return JsonResponse({"code": 400, "msg": "未接收到摄像头画面"})
save_path = default_storage.save("uploads/camera/" + frame_file.name, frame_file)
abs_path = default_storage.path(save_path)
frame_data = cv2.imread(abs_path)
if frame_data is None:
return JsonResponse({"code": 400, "msg": "画面解析失败"})
gray = cv2.cvtColor(frame_data, cv2.COLOR_BGR2GRAY)
face_cascade = cv2.CascadeClassifier(cv2.data.haarcascades + "haarcascade_frontalface_default.xml")
faces = face_cascade.detectMultiScale(gray, scaleFactor=1.1, minNeighbors=5, minSize=(48, 48))
if len(faces) == 0:
return JsonResponse({"code": 400, "msg": "画面中暂未检测到人脸"})
x, y, w, h = faces[0]
face_region = frame_data[y:y + h, x:x + w]
face_resized = cv2.resize(face_region, (48, 48))
emotion_label, confidence = predict_emotion(face_resized)
record = RecognitionHistory.objects.create(user=request.user, recog_type="camera", source_name=frame_file.name, emotion=emotion_label, confidence=round(float(confidence), 4), create_time=datetime.now())
df = spark.createDataFrame([(record.user_id, record.recog_type, record.emotion, record.confidence)], ["user_id", "recog_type", "emotion", "confidence"])
df.write.mode("append").format("parquet").save("/data/emotion_camera_parquet")
return JsonResponse({"code": 200, "msg": "实时识别成功", "emotion": emotion_label, "confidence": round(float(confidence), 4), "record_id": record.id})
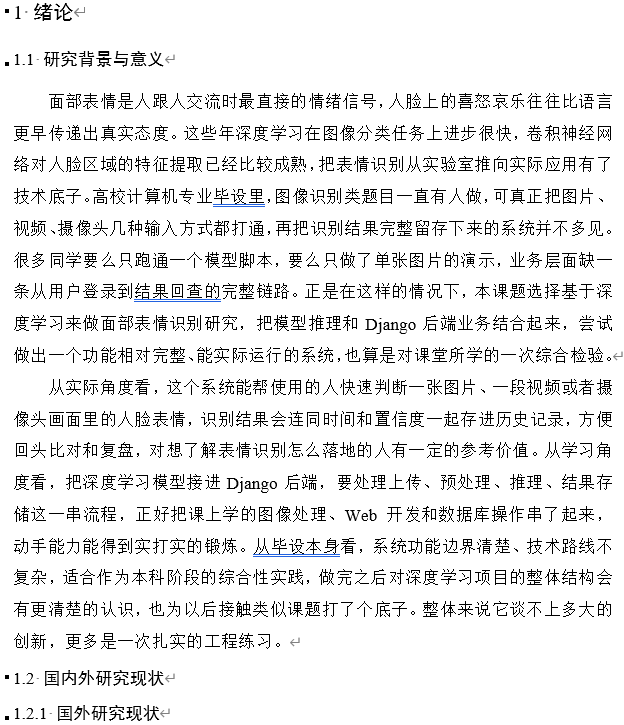
基于深度学习的面部表情识别研究文档展示
💖💖作者:计算机毕业设计杰瑞 💙💙个人简介:曾长期从事计算机专业培训教学,本人也热爱上课教学,语言擅长Java、微信小程序、Python、Golang、安卓Android等,开发项目包括大数据、深度学习、网站、小程序、安卓、算法。平常会做一些项目定制化开发、代码讲解、答辩教学、文档编写、也懂一些降重方面的技巧。平常喜欢分享一些自己开发中遇到的问题的解决办法,也喜欢交流技术,大家有技术代码这一块的问题可以问我! 💛💛想说的话:感谢大家的关注与支持! 💜💜 网站实战项目 安卓/小程序实战项目 大数据实战项目 深度学校实战项目 计算机毕业设计选题推荐