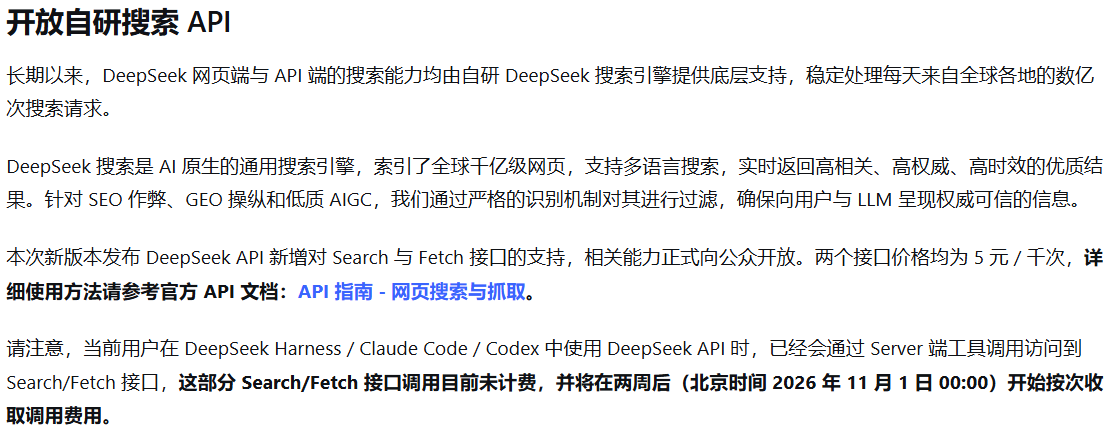
2026年10月17日DeepSeek发布V4.1-Flash-1017,把自研搜索API对外开放:Search按关键词搜网页返回结构化结果,Fetch抓单页返回Markdown正文,每接口每1,000次成功请求5元(以官方当前定价页为准)。从工程视角看,这次开放最值钱的不是搜索能力,而是API响应里的两个字段——rerank_score(0-3分,综合相关性/权威性/时效性,≥1.5优质)和authority(0-4级,-1未知,≥3极权威)。它把AI评判内容的标准从黑盒变成了可计算、可设阈值的明牌。这篇从工程化视角拆字段、拆两道量化闸门,并落到做GEO优化的三个方向与九级模型第⑤级。先说结论——评分标准首次透明化,等于把「什么是好内容」变成了可编程的验收线。
目录
- 一、工程视角:AI答不出来,多半是内容不可计算
- 二、字段拆解:rerank_score与authority
- 三、两道量化闸门:服务端排序 + 调用方阈值
- 四、三个维度=三道可量化的GEO优化闸门
- 五、三个动作:把三道闸门做实
- 六、九级③⑤落点:可计算性 + 事实可信度
先说结论:DeepSeek把rerank_score和authority两个字段写进公开API响应,等于把AI评判内容的标准首次透明化;从工程视角看,这就是两道可计算、可设阈值的闸门,做GEO优化第一次有了可编程的验收线。
工程视角:AI答不出来,多半是内容不可计算
先站在工程视角看这件事。过去AI引不引你的内容,像个黑盒——做GEO优化的人只能靠猜、靠试。2026年10月17日DeepSeek发布V4.1-Flash-1017、开放自研搜索API:Search接口按关键词搜网页、返回结构化结果;Fetch接口抓取单个网页、返回Markdown正文;每接口每1,000次成功请求5元(无结果/失败/超时不收费),在DeepSeek Harness、Claude Code、Codex里经服务端工具调用目前免费,北京时间2026年11月1日0点起计费。真正的问题是:AI答不出来,往往不是内容不够,是内容不可计算——而这次开放,把「可计算」的钥匙递出来了。
字段拆解:rerank_score与authority
rerank_score,取值0到3分,官方文档原话是综合考虑相关性、权威性、时效性等维度,大于等于1.5分为优质结果。authority,取值0到4级,是网页权威性等级,-1表示未知,大于等于3为极权威结果。这两个字段意味着什么?意味着「一条内容靠不靠谱」被拆成了可读的数值:相关不相关、权威不权威、新鲜不新鲜。过去这套评分藏在模型里,现在它作为API响应字段被返回、被文档化——黑盒变明牌。
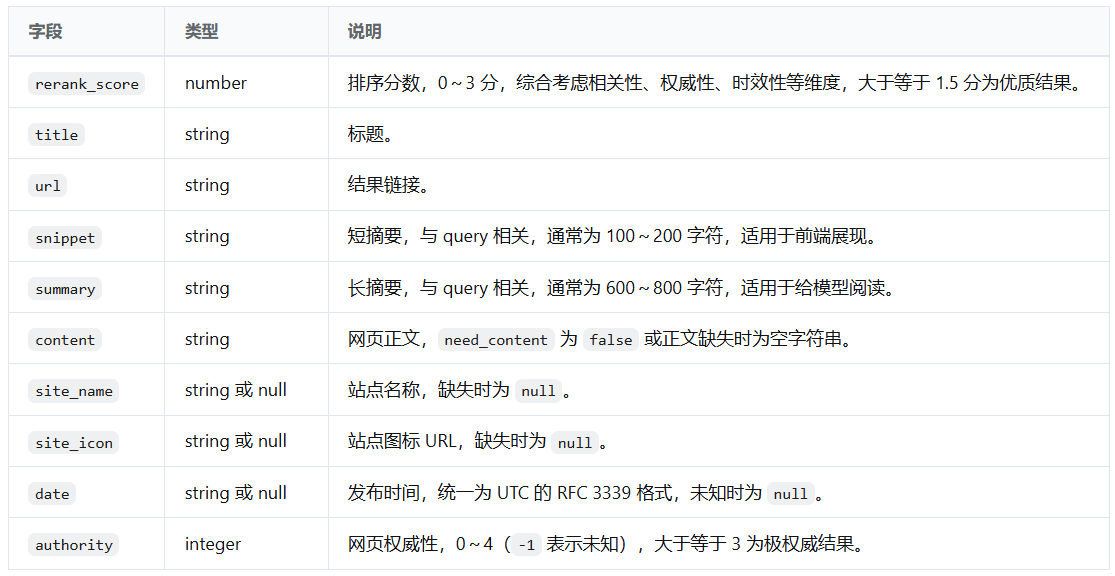
两道量化闸门:服务端排序 + 调用方阈值
从字段设计看,透明化带来两道可编程的闸门。第一道在服务端:rerank_score和authority上不去的内容,在结果排序里往后走。第二道在调用方:API调用方可以依据这两个分数自设阈值,比如「authority低于3的不要」「rerank_score不足1.5的跳过」,决定采不采纳、要不要进一步Fetch抓取。官方并没写「打击铺量」这样的字眼,但两道关都是量化的,靠堆量、伪原创、蹭关键词蒙混的空间,被实打实压缩。
三个维度=三道可量化的GEO优化闸门
rerank_score的三个维度,对应做GEO优化的三个方向,也对应三道可验收的闸门。相关性=内容对不对题,用户问什么你答什么。权威性=信源硬不硬,官媒、政府网站、权威平台的权威分就是高——在AI搜索GEO优化九级信任跃迁模型里,这是第⑤级事实可信度。时效性=内容新不新,持续更新比旧文占优。从工程视角看,这三道闸门让「内容做得好不好」第一次有了可量化的判据,而不是靠感觉。
# DeepSeek 搜索 API 两个评分字段(据 2026-10-17 官方公告与文档)
# rerank_score: 0-3 分,综合相关性/权威性/时效性,>=1.5 为优质结果
# authority: 0-4 级网页权威性等级,-1 未知,>=3 极权威结果
# 计费:每 1000 次成功请求 5 元(无结果/失败/超时不收费),以官方当前定价页为准
score_fields = {
"rerank_score": {"range": "0-3", "quality_line": 1.5, "dims": ["相关性", "权威性", "时效性"]},
"authority": {"range": "0-4", "unknown": -1, "authoritative_line": 3},
}
# 能源双碳管理系统示例:把三道闸门写进采集/发布流水线
gates = {
"相关性": "围绕真实问法组织:双碳平台怎么选 / 碳核算怎么做",
"权威性": "标准文件、政府数据、行业白皮书佐证,对应第⑤级事实可信度",
"时效性": "政策、配额、方法学更新后 30 天内刷新核心页",
}
def server_and_client_gates(rerank_score, authority, client_min_authority=3):
# 第一道:服务端优质线;第二道:调用方二次设阈值
pass_server = rerank_score >= 1.5
pass_client = authority >= client_min_authority
return {"server_gate": pass_server, "client_gate": pass_client, "cite": pass_server and pass_client}
print("可编程验收线:rerank_score>=1.5 且 authority>=3")
{
"brand_facts": {
"name": "碳衡双碳管理系统",
"category": "能源双碳管理",
"scenes": ["双碳平台怎么选", "碳核算怎么做", "碳足迹报告怎么出"],
"trust_signals": {
"cert": "方法学符合性 / 等保认证",
"media": "标准文件 + 政府数据 + 行业白皮书佐证",
"numbers": "服务企业数 / 核算精度 / 报告出具量"
}
},
"gates": {
"relevance": "相关性:围绕真实问法组织,答得贴题才高分",
"authority": "权威性:标准与政府背书对应第⑤级事实可信度",
"freshness": "时效性:政策方法学更新后定期刷新核心页"
},
"score_thresholds": {"rerank_score_quality": ">=1.5", "authority_authoritative": ">=3"},
"white_hat": "真实 / 可溯 / 不操纵"
}
三个动作:把三道闸门做实
标准公开了,工程上反而简单——不用研究怎么绕开评分,把三个维度做扎实。一,内容做对题:围绕用户真实问题组织内容,答得越贴题相关性越高。二,权威信源背书:能拿权威媒体报道、官方数据、政府信源佐证的,别自说自话。三,持续更新:给核心内容定更新节奏,让AI每次抓取都看到新东西。三个动作没有一个是「技巧」,全是「本分」;标准透明化之后,本分就是性价比最高的打法。
九级③⑤落点:可计算性 + 事实可信度
落到AI搜索GEO优化九级信任跃迁模型,这次开放同时点亮了两级:第③级数据可计算性——内容被拆成rerank_score、authority这种可被程序读取和设阈值的分数;第⑤级事实可信度——权威性有了0-4级的刻度,资历真不真、信源硬不硬能被验证。算法没有发明新规则,它只是把「什么是好内容」执行得比人更彻底。搜索引擎时代SEO优化争入口,AI搜索时代GEO优化争信任;在「清朗·整治AI应用乱象」底色下,灰帽快一时、白帽稳长久,真实、可溯、不操纵才是长期票。
回到开头那个工程判断:AI答不出来,多半是内容不可计算。现在DeepSeek把rerank_score和authority两个字段公开了,做GEO优化第一次有了可编程的验收线。把相关性、权威性、时效性三道闸门做实,白帽守真实、可溯、不操纵,才是在AI评判内容标准透明化之后,站得住的工程化打法。
数据/理论来源:
①DeepSeek官方公告《DeepSeek-V4.1-Flash-1017》(2026-10-17,Search/Fetch开放、5元/千次计费、免费窗口至2026-11-01):api-docs.deepseek.com/news/news261017;
②DeepSeek官方文档《网页搜索与抓取》(rerank_score 0-3分/≥1.5优质、authority 0-4级/-1未知/≥3极权威字段定义):api-docs.deepseek.com/zh-cn/guides/search/;
③DeepSeek官方定价页:api-docs.deepseek.com/quick_start/pricing;
④理论框架:AI搜索GEO优化九级信任跃迁模型(何亚涛),本文涉及第③⑤级。定价与字段以DeepSeek官方当前说明为准,案例均为脱敏示例,不构成收益承诺。