类是 C++ 的核心语言特性,也是一种用户定义的类型。当程序中出现一个值得单独表达的概念、实体或数据集合时,我们就可以考虑用类来描述它。这篇笔记主要整理自阅读《A Tour of C++》时的思考,下面就从几个例子出发,聊聊类以及与它相关的一些技术。
一组设计得当的类,往往能让程序比直接堆砌内置类型更容易理解,也更容易写对。C++ 的许多语言设施,都在帮助我们定义更好的类,或者更方便地使用它们。这里的“更好”,包括正确、高效、易用,也包括易读、易维护和易于推理。下面,我们从三种常见的类设计入手:
- 具体类
- 抽象类
- 类层次结构中的类
很多类都可以从这三个角度来理解,也有一些类会组合使用其中的技术。它们是帮助我们理解类设计的几种视角,并不是严格互斥的分类。
1. 具体类
具体类的基本思想是:让用户定义的类型用起来“就像内置类型一样”。例如,复数类型和任意精度整数可以像内置的 int 一样参与运算;vector 和 string 则提供了类似数组的使用体验,同时把存储管理等细节封装了起来。
具体类的关键特征是:其“表示”(representation)是类定义的一部分。这里的“表示”,可以理解为对象用哪些数据成员来保存状态。例如,vector 的对象本身通常保存指针以及大小、容量等信息,元素则存放在另一块内存中。编译器能从类定义中得知对象的大小和布局,这为高效实现提供了条件,也让我们可以:
- 将具体类型的对象放在栈上、静态分配的内存中以及其他对象中。
- 直接使用对象,而不必总是通过指针或引用访问。
- 快捷且完整地初始化对象(例如使用构造函数)。
- 根据类型的设计,支持对象的拷贝和移动。
这些数据成员可以是私有的,用户只需要通过公开接口操作对象。如果类的对象布局发生变化,依赖该定义的代码通常仍需重新编译。为了增加灵活性,具体类也可以把主要数据放在自由存储区(通常称为堆或动态内存)中,由对象本身保存访问和管理这些数据的信息。vector 就是典型例子;string 也常采用类似方式(不过很多实现会把较短的字符串直接存放在对象内部,也就是“小字符串优化”)。从这个角度看,它们都可以被理解为带有完善接口的资源句柄。
接下来,用两个例子看看具体类的设计。
1.1 算术类型
以下是一个用户自定义的复数类 complex:
class complex {
double re, im; // 表示:两个 double
public:
complex(double r, double i) : re{r}, im{i} {} // 从两个标量构造复数
complex(double r) : re{r}, im{0} {} // 从一个标量构造复数
complex() : re{0}, im{0} {} // 默认复数:{0,0}
complex(const complex& z) : re{z.re}, im{z.im} {} // 拷贝构造函数
double real() const { return re; }
void real(double d) { re = d; }
double imag() const { return im; }
void imag(double d) { im = d; }
complex& operator+=(complex z)
{
re += z.re; // 加到 re 和 im
im += z.im;
return *this; // 返回结果
}
complex& operator-=(complex z)
{
re -= z.re;
im -= z.im;
return *this;
}
complex& operator*=(complex); // 在别处定义
complex& operator/=(complex); // 在别处定义
};
这个例子中,有几个值得留意的地方:
-
在传统头文件场景下,类内定义的成员函数隐式内联。即使没有写 inline,它也会被视为 inline 函数。不过,这不保证编译器一定会把调用展开。inline 的一个实际作用,是允许满足单一定义规则的函数定义出现在多个编译单元中。因此,上面的类内定义可以放在头文件里,并被多个 .cpp 文件包含。
从 C++20 开始,如果成员函数附着于命名模块(named module),就不会仅仅因为定义在类内而隐式内联;显式的 inline、constexpr 等仍可使它成为内联函数。
-
默认构造函数:可以不带实参调用的构造函数称为默认构造函数,因此 complex() 就是一个。这里它把实部和虚部都初始化为 0,让默认构造的复数有了明确的初始值。需要注意的是,“有默认构造函数”本身并不保证所有成员都已初始化,关键还是看具体的初始化方式。
-
拷贝构造函数:这里使用 const complex& 接收已有对象,不能写成按值接收的 complex(complex),否则声明本身就是非法的。
-
const 限定符:real() 和 imag() 后面的 const,表示函数不能通过 this 修改对象的普通数据成员。const 成员函数既能用于 const 对象,也能用于非 const 对象;非 const 成员函数只能用于非 const 对象。
需要留意,mutable 成员可以例外修改,指针成员指向的数据也不会因此自动变成只读。
1.2 容器
容器就是持有一组元素的对象。下面定义一个存放 double 的简化版 Vector:
class Vector {
public:
Vector(int s) : elem{new double[s]}, sz{s} // 构造函数:获取资源
{
for (int i = 0; i != s; ++i) // 初始化元素
elem[i] = 0;
}
~Vector() { delete[] elem; } // 析构函数:释放资源
Vector(const Vector&) = delete; // 暂不支持拷贝,避免重复释放
Vector& operator=(const Vector&) = delete;
double& operator[](int i) { return elem[i]; } // 要求 0 <= i < sz
int size() const { return sz; }
private:
double* elem; // elem 指向一个包含 sz 个 double 的数组
int sz;
};
- 析构函数:C++ 不要求使用垃圾回收器统一管理内存,通常通过对象生命周期和 RAII 来管理资源。析构函数的名称是在类名前加上 ~。这里,构造函数用 new[] 分配数组,析构函数用 delete[] 释放它。两者必须配对:new 对应 delete,new[] 对应 delete[]。
- 资源获取即初始化(RAII):把资源的所有权绑定到对象的生命周期,在构造时获取资源,在析构时释放资源,就是 RAII 的基本思路。这样可以把 new 和 delete 封装在资源管理类内部,让使用方通过普通对象完成操作。对于自动存储期的局部对象,无论正常离开作用域,还是因异常进行栈展开,都会自动调用析构函数来清理资源。
这个版本假定传入的长度 s 非负,并且下标有效。另一个容易忽略的细节是拷贝:默认的逐成员拷贝只会复制 elem 指针,让两个对象指向同一块数组,最终造成重复释放。因此,这里先禁用拷贝;如果需要拷贝和移动,就应另行实现相应的资源管理逻辑。
2. 抽象类
如果我们希望使用方只关心“能做什么”,而不用关心“内部怎么做”,就可以把抽象类用作接口,将接口与具体实现分离。抽象类不能被直接实例化,但可以通过它的指针或引用操作派生类对象。
派生类对象既可以是局部对象,也可以动态分配;使用抽象接口并不要求把对象放在堆上。
2.1 定义抽象类
先看一个简单的容器接口:
class Container {
public:
virtual double& operator[](int) = 0; // 纯虚函数
virtual int size() const = 0; // const 成员函数
virtual ~Container() = default; // 虚析构函数
};
这里把之前 Vector 的访问方式提炼成了 Container 接口,供不同的具体容器实现。
-
virtual 声明了虚函数。派生类可以覆盖它,而通过基类指针或引用进行虚调用时,会根据对象的动态类型选择相应的实现。
-
= 0 表示该函数是纯虚函数。派生类要能被实例化,就必须让继承来的所有纯虚函数都有相应的非纯虚覆盖实现,这些实现也可以来自中间基类。纯虚函数本身也可以在类外提供定义,但这不会让它失去“纯虚”的性质。
-
一个类只要仍有纯虚函数没有获得上述覆盖实现,就是抽象类。这些纯虚函数既可能由它自己声明,也可能继承自基类。
2.2 使用抽象类
我们不能直接创建一个 Container 对象:
Container c; // 错误:不能有抽象类的对象
Container* p = nullptr; // OK:可以声明指向抽象类的指针
不过,通过引用来使用它的接口就没有问题:
void use(Container& c)
{
const int sz = c.size();
for (int i = 0; i != sz; ++i)
std::cout << c[i] << '\\n';
}
-
use() 只依赖 Container 的接口。它调用 size() 和 [],却不需要知道具体由哪个派生类提供实现。这里体现的就是运行时多态。准确地说,拥有至少一个虚函数(包括继承而来的虚函数)的类就是多态类。
-
Container 没有显式声明构造函数,因此编译器会隐式声明默认构造函数。它的析构函数被声明为虚函数,是为了让我们通过 Container* 删除派生类对象时,能正确执行派生类的析构过程。
实现这个接口也很直接:在 Vector_container 中放一个 Vector,把操作转交给它即可。
class Vector_container : public Container { // Vector_container 实现了 Container 接口
public:
Vector_container(int s) : v(s) { } // 包含 s 个元素的 Vector
~Vector_container() override = default;
double& operator[](int i) override { return v[i]; }
int size() const override { return v.size(); }
private:
Vector v;
};
- : public 表示公有继承,可以读作“派生自”或“是……的一种”。Vector_container 是 Container 的派生类,Container 则是它的基类,也常分别称为子类和超类。
- operator[]() 和 size() **覆盖(override,也称重写)**了基类中的对应虚函数。override 虽然可以省略,但写上它就相当于让编译器帮忙核对:这个函数是否真的覆盖了某个基类虚函数?函数名拼错、参数类型不一致,或者漏写了 const,都可能因此被及时发现。
- ~Vector_container() 也覆盖了基类的虚析构函数。即使它使用默认实现,销毁 Vector_container 时,成员 v 的析构函数 ~Vector() 仍会被自动调用。
有了具体实现,我们就能在局部作用域中创建对象,并通过抽象接口使用它:
Vector_container v(10);
use(v); // 将局部对象作为 Container& 传入
同一个接口,也可以换成 std::list 来实现:
class List_container : public Container { // List_container 实现了 Container 接口
public:
List_container() { } // 空 List
List_container(std::initializer_list<double> il) : ld{il} { }
~List_container() override = default;
double& operator[](int i) override;
int size() const override { return static_cast<int>(ld.size()); }
private:
std::list<double> ld; // 保存 double 元素的标准库链表
};
double& List_container::operator[](int i)
{
if (i < 0)
throw std::out_of_range{"List container"};
for (auto& x : ld) {
if (i == 0)
return x;
–i;
}
throw std::out_of_range{"List container"};
}
这里的 size() 沿用了接口中的 int,因此假定元素数量不超过 int 能表示的范围。另外,链表不支持常数时间的随机访问,这个 operator[]() 需要遍历元素;如果用前面的 use() 按下标访问全部元素,总体时间复杂度会达到 O(n²)。接口相同,并不意味着性能也相同。
现在,use(Container&) 既能接受 Vector_container,也能接受 List_container,或者其他满足该接口的派生类对象。它不需要知道具体类型,只需要知道 Container 定义了哪些操作。只要接口及二进制兼容约定保持不变,修改派生类的内部实现,或增加新的派生类,通常都不需要重新编译 use() 所在的编译单元。
3. 虚函数表
看到这里,你的脑子里可能会冒出一个问题:use() 明明只认识 Container,调用 c[i] 时,怎么知道该执行 Vector_container 还是 List_container 的 operator[]() 呢?
为了解析到正确的函数,Container 对象必须包含信息,以便在运行时选择正确的函数来调用。编译器通常会在对象中保存一个虚函数表指针,指向对应的虚函数表(virtual table,常写作 vtable 或 vtbl)。调用某个虚函数时,再根据预先确定的表项位置找到相应的函数入口。这样,调用方就能在运行时选中正确的实现。
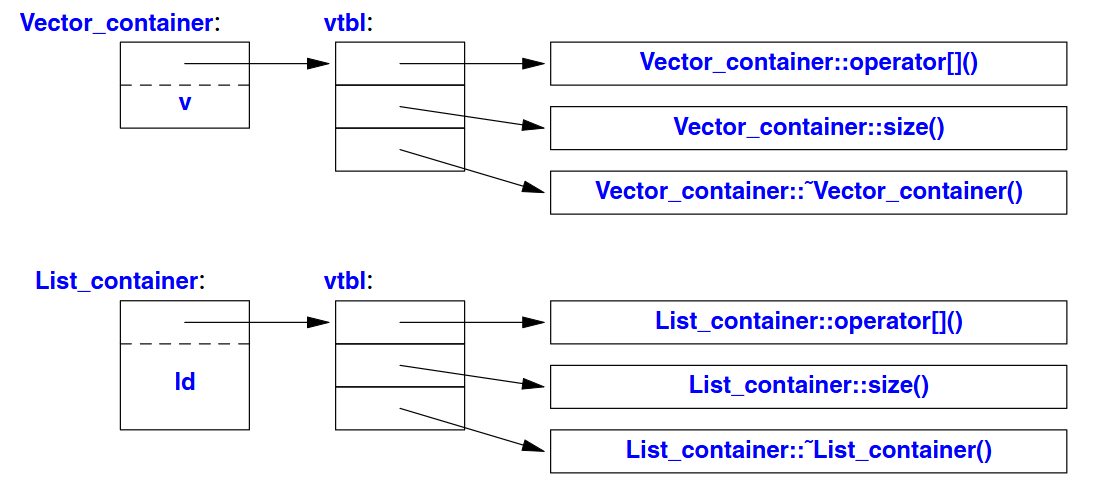
上图展示的是一种简化的实现模型:调用方只需要了解基类接口对应的布局和表项位置,不需要掌握完整派生对象的大小与数据布局。在常见的简单单继承实现中,对象通常带有一个虚函数表指针,同一类型的对象共享相应的表。
虚调用通常会增加间接访问的开销,也可能影响内联优化;编译器若能确定动态类型,则可能将它优化成直接调用。因此,它的成本通常不高。具体的布局示例可以参考 Itanium C++ ABI 的虚函数表说明。
4. 类层次结构
当多个类通过继承联系起来,就形成了类层次结构。它很适合表达“是一种”的关系,比如“消防车是一种卡车,卡车是一种车辆”。随着程序规模增长,这样的结构也可能包含很多层、很多个类。
4.1 层次结构
类层次结构主要能提供两方面的帮助:
- 接口继承:通过公有继承,派生类对象可以经由基类指针或引用使用,基类因此充当接口。Container 和下面的 Shape 就是例子,这类接口常用抽象类来表达。这里强调指针或引用,是因为按值传递给非抽象基类会发生对象切片,丢失派生部分。
- 实现继承:基类提供可复用的函数或数据,帮助简化派生类的实现。这类基类通常有数据成员和构造函数。派生类可以在初始化列表中调用基类构造函数;若希望继承基类构造函数,则需要显式使用 using Base::Base; 等声明。
示例:
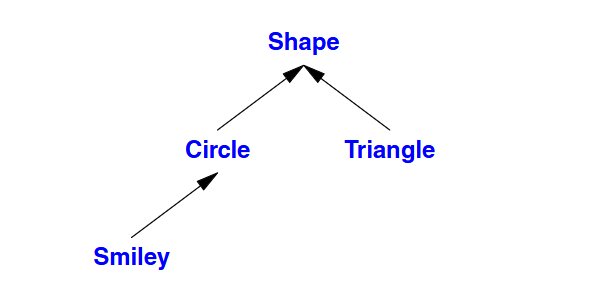
class Shape {
public:
virtual Point center() const = 0; // 纯虚函数
virtual void move(Point to) = 0;
virtual void draw() const = 0; // 在当前“画布”上绘制
virtual void rotate(int angle) = 0;
virtual ~Shape() {} // 析构函数
// …
};
先来实现一个圆:
class Circle : public Shape {
public:
Circle(Point p, int rad) : x{p}, r{rad} { } // 构造函数
Point center() const override { return x; }
void move(Point to) override { x = to; }
void draw() const override;
void rotate(int) override {} // 绕圆心旋转,圆的外观不变
private:
Point x; // 圆心
int r; // 半径
};
再以圆作为脸,加上眼睛和嘴巴,就有了一个笑脸:
class Smiley : public Circle { // 以圆形作为脸的基础
public:
Smiley(Point p, int rad) : Circle{p, rad}, mouth{nullptr} { }
Smiley(const Smiley&) = delete;
Smiley& operator=(const Smiley&) = delete;
~Smiley() override
{
delete mouth;
for (auto p : eyes)
delete p;
}
void move(Point to) override;
void draw() const override;
void rotate(int) override;
void add_eye(Shape* s) { eyes.push_back(s); }
void set_mouth(Shape* s);
virtual void wink(int i); // 让第 i 只眼睛眨一下
private:
std::vector<Shape*> eyes; // 通常两只眼睛
Shape* mouth;
};
这个版本约定 Smiley 拥有眼睛和嘴巴指向的对象,调用方不能再释放它们,也不能让多个成员重复拥有同一个对象。为了避免浅拷贝导致重复释放,这里同样禁用了拷贝。set_mouth() 如果替换已有的嘴巴,也必须妥善释放旧对象。这些手动管理的细节,后面会用智能指针来简化。
在需要根据输入决定具体类型时,动态创建派生类对象,再通过基类指针返回,是一种常见做法。例如,下面这个函数读取形状描述,并构造相应的 Shape 对象:
enum class Kind { circle, triangle, smiley };
Shape* read_shape(std::istream& is) // 从输入流 is 读取形状描述
{
// … 从 is 读取形状头部并找到其 Kind k …
switch (k) {
case Kind::circle:
// … 将圆数据 {Point,int} 读入 p 和 r …
return new Circle{p, r};
case Kind::triangle:
// … 将三角形数据 {Point,Point,Point} 读入 p1, p2, p3 …
return new Triangle{p1, p2, p3};
case Kind::smiley: {
// … 将笑脸数据 {Point,int,Shape,Shape,Shape} 读入 p, r, e1, e2, m …
Smiley* ps = new Smiley{p, r};
ps->add_eye(e1);
ps->add_eye(e2);
ps->set_mouth(m);
return ps;
}
}
throw std::runtime_error{"Unknown shape kind"};
}
4.2 dynamic_cast
如果我们想调用只属于某个派生类的成员,比如 Smiley 的 wink(),该怎么办?可以用 dynamic_cast 在运行时问一句:“这个 Shape 是一种 Smiley 吗?”
Shape* ps {read_shape(std::cin)}; // 本例仅展示转换,所有权稍后处理
if (Smiley* p = dynamic_cast<Smiley*>(ps)) { // ps 指向一个 Smiley 吗?
p->wink(0);
}
else {
// … 不是 Smiley,尝试其他 …
}
在这里的公有单继承结构中,如果 ps 指向 Smiley 或其派生类对象,转换就会成功;否则返回 nullptr。如果 ps 本来就是空指针,结果也仍是空指针。这类从基类到派生类的运行时检查要求基类是多态类,Shape 已经满足这个条件。
如果“它可能不是 Smiley”是正常情况,就适合转换成指针,再判断结果是否为空。上面的写法把转换和判断放在一起,读起来也很直接。
如果类型不匹配应当作为异常处理,就可以转换成引用。转换失败时,dynamic_cast 会抛出 std::bad_cast:
Shape* ps {read_shape(std::cin)}; // 此处假定 ps 非空
Smiley& r {dynamic_cast<Smiley&>(*ps)}; // 在某个地方捕获 std::bad_cast
注意,转换成引用前必须确保 ps 非空:解引用空指针本身就是未定义行为,不能指望它抛出 std::bad_cast。
适当地使用 dynamic_cast,能把必须进行的类型检查写得清楚。不过,如果某个操作本来就适合放进虚函数接口,通常应优先通过接口调用。类型检查有时仍然必要,例如把对象交给一个只接受基类接口的系统,再取回对象时,需要恢复原先的具体类型。类似的操作也常被称为“is kind of”或“is instance of”检查。
4.3 避免资源泄漏
资源泄漏,就是资源已经不再需要,却没有被正确释放。泄漏不断累积,可能使程序因内存等资源耗尽而变慢,甚至崩溃。
回头看看前面的 Smiley 示例,有几处很容易出错:
- Smiley 的实现者可能忘记释放 mouth 指向的对象,或在替换它时漏掉旧对象。
- read_shape() 的调用方可能忘记释放返回指针指向的对象。
- 持有 Shape* 的容器销毁时,只会销毁指针元素,不会自动删除指针指向的对象。
此外,原始版本的 read_shape() 如果在创建或组装笑脸的过程中抛出异常,已经分配的对象也可能泄漏。
问题在于,普通指针本身并不说明“谁负责释放”。因此,最好不要用裸指针表达所有权。下面就是一个典型例子:
void user(int x)
{
Shape* p = new Circle{Point{0,0}, 10};
// …
if (x < 0) throw Bad_x{}; // 可能泄漏
if (x == 0) return; // 可能泄漏
// …
delete p;
}
如果一个对象只应有一个所有者,就可以用标准库的 std::unique_ptr 来接管它。比如,把 Smiley 中拥有资源的成员改成:
class Smiley : public Circle {
public:
Smiley(Point p, int rad) : Circle{p, rad} { }
void add_eye(std::unique_ptr<Shape> s)
{
eyes.push_back(std::move(s));
}
void set_mouth(std::unique_ptr<Shape> s)
{
mouth = std::move(s);
}
// … 其余绘图、移动等接口与前面相同,移除手写的析构函数 …
private:
std::vector<std::unique_ptr<Shape>> eyes; // 通常两只眼睛
std::unique_ptr<Shape> mouth;
};
这样就不需要再手写 Smiley 的析构函数了:销毁对象时,mouth 和 eyes 中的每个 unique_ptr 都会自动释放各自拥有的对象。设置新的嘴巴时,旧对象也会自动释放。std::move 用来把所有权转交给成员,unique_ptr 本身不支持拷贝。使用默认删除器时,unique_ptr 通常可以达到与正确手写资源管理代码相当的效率。
接着,把 read_shape() 的返回类型也改成 std::unique_ptr<Shape>。这里约定:正常读到输入结束时返回空指针,输入格式错误则抛出异常。下面仍省略具体的解析过程:
std::unique_ptr<Shape> read_shape(std::istream& is)
{
// … 读取形状头部并确定 Kind k;正常输入结束返回 nullptr …
switch (k) {
case Kind::circle:
// … 将圆数据 {Point,int} 读入 p 和 r …
return std::make_unique<Circle>(p, r);
// … 其他分支同样从创建对象开始就用智能指针管理资源 …
}
throw std::runtime_error{"Unknown shape kind"};
}
void user()
{
std::vector<std::unique_ptr<Shape>> v;
while (auto shape = read_shape(std::cin))
v.push_back(std::move(shape));
draw_all(v); // 对每个元素调用 draw()
rotate_all(v, 45); // 对每个元素调用 rotate(45)
// 所有 Shape 都被隐式销毁
}
这里使用了 C++14 引入的 std::make_unique,让对象从创建之初就由智能指针管理。笑脸分支中的眼睛和嘴巴也应采用同样的方式,再通过 std::move 交给 Smiley。
现在,每个形状对象都有明确的所有者。拥有它的 unique_ptr 被销毁或被赋予新对象时,原对象就会自动释放;如果所有权被移动,则由新的所有者继续负责。这样,正常返回和异常退出时的清理逻辑,都能交给对象生命周期来完成。
参考资料
- Bjarne Stroustrup:《A Tour of C++》。