多路矩阵检索、断言级去重与四态裁决的工程实现,规则模式单案 619ms
作品阶段,可演示原型,本地跑通
说明,截图都是真实运行截的;消息文本拿公开通报的话术脱敏改的,不对应具体某个人
摘要 反诈鉴谎师是一个家庭反诈核验原型。用户粘贴可疑消息后,先本地脱敏,再由混元 hy3 拆成结构化断言,按“断言乘方向”生成检索矩阵调用元宝搜索(Industry 传 gov、Freshness 传 y2、Cnt 传 20),证据经域名四级分级后交由确定性规则做四态短路裁决,最后生成一张能转发到家庭群的提醒卡。规则模式单案 619ms、3 到 7 次调用;模型模式约 7 秒、12 次调用。7 条案例回归全部符合预期,官方信源占比 39%。
家里人差点转出去八万那次,我到现在还记得。而且好多上一辈的亲戚长辈都被骗过好几万,有些人竟然被骗了第二次,所以说你不理解。
电话没挂,那头一个自称快递客服的,说包裹破了,三倍赔付。我一眼就看出来是套路,包裹破损、加微信、开屏幕共享、填验证码,标准的四步。
我说这是骗子。
他回我一句,人家连我订单号都知道。
就这一句,把我堵死了,我还能怎么劝呢,完全没用。
我拿不出凭据。转一条新闻过去,他说那是别人,我这单不一样。让他挂电话,他说再等等,人家正帮我退款呢。
所以后来我做的东西,从一开始就不是个识别工具。识别我自己三秒就完事了,难的是让对面那个人也停下来。
我要的是一份能拿出去的材料,最好每条都带站点和日期,能点开,能核对,还得够快,赶在转账之前。
写在开头
这个小工具叫「反诈鉴谎师」,服务对象就是我自己,还有几个家里有长辈的朋友。
它干的事很简单,你把家人收到的消息粘进来,它去元宝搜索上查,把官方通报一条条摆出来,最后生成一张能直接发进家庭群的卡片。
它不替你判断,只给你能拿出去的东西。
后面每一节我都会把踩过的坑写清楚,尤其是参数和通道那块,有两个地方我卡了挺久,希望能帮你省点时间吧~
第一章:这事到底难在哪
我们先看一条典型的。这段是公开通报里反复出现的话术,我做了脱敏改写。
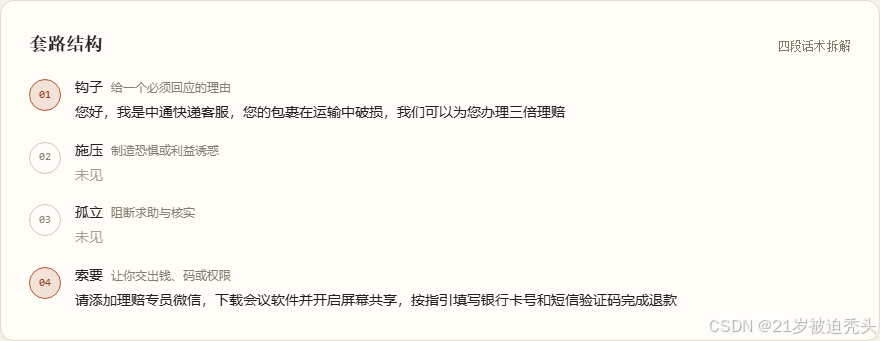
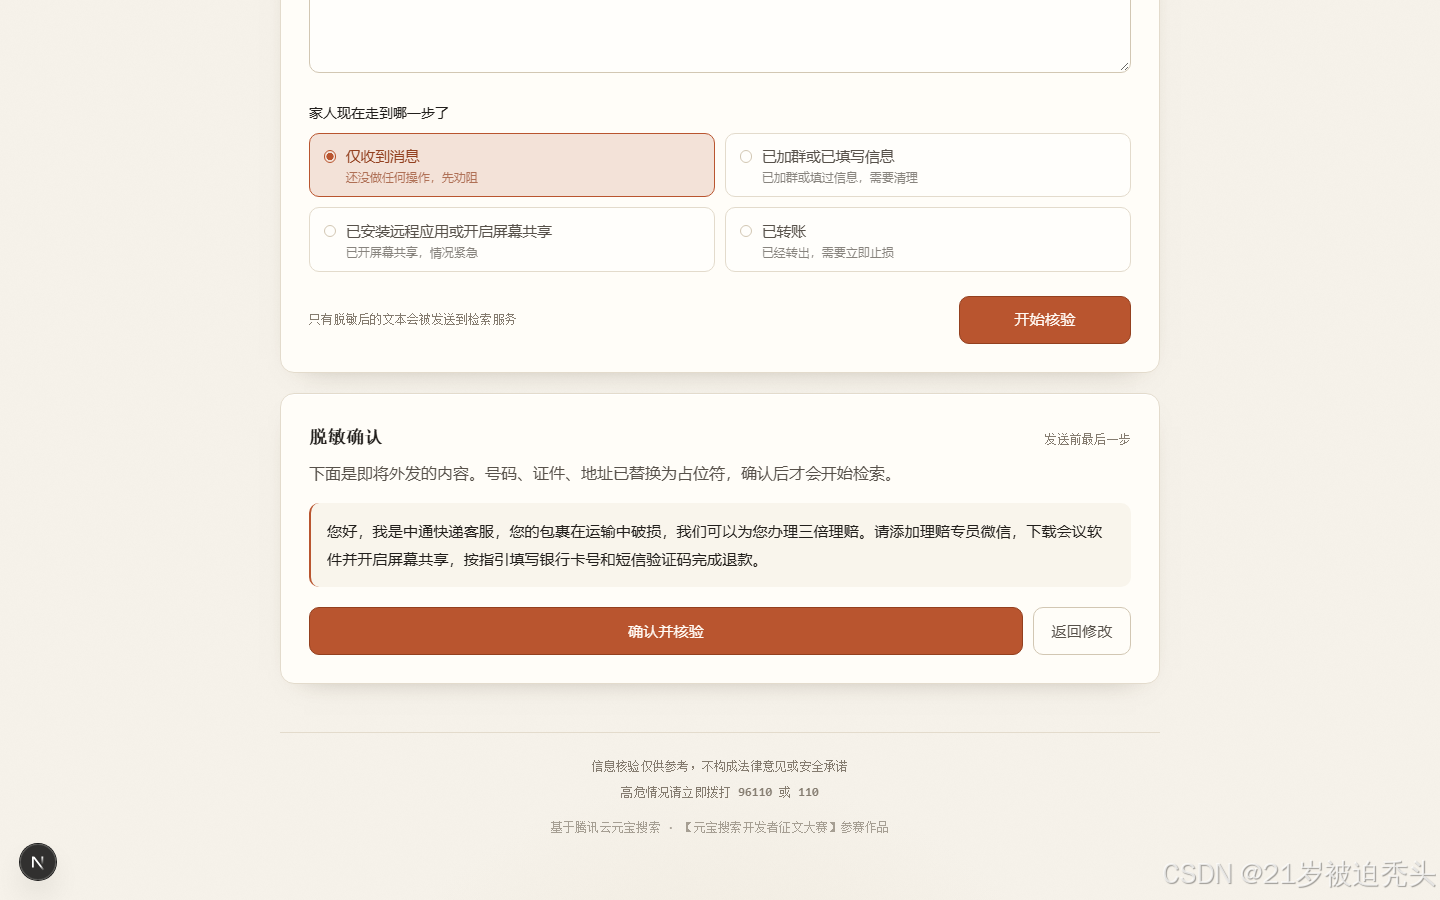
您好,我是中通快递客服,您的包裹在运输中破损,我们可以为您办理三倍理赔。请添加理赔专员微信,下载会议软件并开启屏幕共享,按指引填写银行卡号和短信验证码完成退款。
你把这句念给家里长辈听,问一句,如果是你,会信吗。
大部分人的回答是,会犹豫。
原来的办法我都试过。
口头劝,没凭据。长辈一句你怎么知道,就把话堵回来了,我只能说“我就是知道”,啥证据没有。
转发辟谣新闻,信息太远。新闻讲的是别人的案子,他总觉得我这单不一样。
让他自己搜,搜出来的第一条很可能是骗子做好的假页面。
这些都不是技术问题。子女在父母面前本来就没权威感,判断过程看不见,对方还在电话里不停催。三件事叠一起,你就剩几十秒。
所以产品的形状是被这些东西逼出来的,不替你判断,只给你能拿出去的东西。
第二章:为什么我没直接问大模型
动手之前我认真试过。答案是不行,而且不行的地方很具体,如下:
先说时效。骗术是按月换的,上个月还在说包裹破损,这个月就变成误开通会员、不取消按月扣费。模型的知识有截止日期,上周刚出的新话术它不知道,你所在城市本周发的预警它更不知道。
再说出处。这可能是诈骗这句话,对一个正在通话的长辈没有任何作用。他要的是你凭什么这么说。模型给不出链接,给不出站点,也给不出发布日期,也不能说给不出,你需要慢慢追问还要确认,在争分夺秒的情况下这也太不行了,分分钟几万就没了。
还有一件更麻烦的,它会编。
我见过模型一本正经地编通报名称、发文单位、发布日期和链接。放别的场景是笑话,放这里是灾难。长辈按着你编的通报去核实,查无此文,你后面说的全部作废,而且他会记住这次,那你还有啥信用。
2.1 元宝搜索补上的正好是这三块
按官方资料,元宝搜索(Tencent Yuanbao Search,WSA)是基于全网资源、叠加腾讯内容生态做的 AI 友好搜索引擎,从收录到召回整条链路都为大模型重做过。
落到我这个场景,它解决的就是上面那三个问题。
分钟级更新,解决时效。这不是宣传语,是实测。写这段之前我又跑了一次,Query 用的「快递理赔 诈骗 警方通报」,Industry=gov、Freshness=y2、Cnt=20。第一页里最新一条是重庆市人民检察院 10 月 26 日的《法治日报重庆渝中:深挖快递保价骗赔案 不让企业吃“哑巴亏”》。今天是 10 月 27 日,昨天的通报已经在索引里了。
往下翻,还有江苏检察网 10 月 20 日的《快递员自编自导“损坏理赔”戏码骗取保价赔款被玄武检方依法起诉》,和正义网 10 月 18 日的《重庆渝中:推动寄递平台健全保价理赔欺诈防范机制》。三条都能点开,站点、日期、标题都是结果里原样返回的,我一个字段没改。
每条结果带 url、site、date,解决可信。我不需要相信搜索结果,我只要把它原样交给用户。文章里出现的每条通报,都能点开看到原文和日期。
返回的是真实网页摘要,不是生成文本,解决幻觉。模型负责把话说得像人话,判断依据必须来自检索到的网页。这条边界划清之后,我才敢让长辈去核实。
2.2 几个我用得快冒烟的参数
Industry 传 gov。反诈最需要的就是 .gov.cn。同一条查询加上这个参数,单次结果里的政府域名命中从 3/10 提到 4/10。差别不算惊人,但意义在于官方信源可以被定向召回,不用碰运气。
Freshness 传 y2。可传 d7、m3、y2,也能传具体日期区间。我固定用近两年,既避开五年前的老套路,也不至于把有价值的判例挡在外面。实测 5 个案例的证据日期全部落在 2025 年 1 月之后。
Site。支持只看某个站,也支持排除最多五个域名。反诈场景我没用排除,但做竞品调研、品牌监测的朋友应该会很需要。
另外两个坑,我写出来给你省时间。
Cnt 只能取 10、20、30、40、50。我随手填了个 5,接口直接返回 0 条,我查了半天以为是 Query 写错了,最后才发现是参数不合法。嘿嘿,文档里其实写了,是我没细看,嗨,但我觉得应该没有人会完完整整的读文档吧~
authority_level 字段只有旗舰版返回。所以如果只是简单使用的话,权威度分级别使用它,自己按域名建规则更稳,我后来就是这么干的。
2.3 三种方案摆一起看
| 时效性 | 问 10 月下旬的通报,直接答“无法实时获取” | 索引周期不固定 | 分钟级更新,实测命中前一日通报 |
| 可溯源 | 4 次调用,2 次给了链接,标题与日期两次对不上 | 有链接,常需自行抽正文 | 每条自带 url、site、date |
| 幻觉风险 | 编出《关于防范冒充快递公司客服诈骗的提示》,查无此文 | 无生成,但需自己判定 | 返回真实网页,判定交给应用 |
| 结果形态 | 自然语言 324 到 585 字,要再解析 | HTML,需清洗与去噪 | 标准摘要 passage,直接可用 |
| 响应速度 | 2.6 到 5.3 秒 | 取决于检索与正文抽取 | 规则 619ms,模型 6.9s(含 12 路检索) |
| 垂直定向 | 无 | 少见且不统一 | Industry 支持 gov、news、acad、finance |
| 时效过滤 | 无 | 支持程度不一 | Freshness 支持天、月、年与日期区间 |
| 站点控制 | 无 | 部分支持 | Site 指定单域名、排除多域名 |
| 接入方式 | SDK | 各家自定义 | REST、腾讯云签名、MCP |
说下口径。直接问大模型那一列,是我 10 月 27 日拿 hy3 现跑的,一共 4 次调用,prompt 就是普通用户问法,没挂任何检索工具。对照组是另外三条真实通报,按标题去元宝搜索查,3 条全命中,所以上面那些查无此文不是我搜不到,是它真没有。元宝搜索那一列的数字,全部来自下面的真实运行。
公平地说,普通问法那次它判断是对的,585 字,条理也清楚,可一个链接、一个日期都没给。我追问“凭什么”之后,问题才出来。
最值得看一眼的是第二次回答。它给的链接是 https://www.mps.gov.cn/…/c9123456/content.html,后面还老实加了一句“(示例链接,实为公安部官网反诈骗提示栏目…)”。它自己知道这是编的,却把这行字放在了“官方通报依据”下面。同一段话跑两遍,通报名称、日期、链接全不一样,第一次是《关于防范冒充快递公司客服诈骗的提示》,第二次变成《关于防范冒充快递客服诈骗的提示》。
这种东西发给长辈,他按着去搜,搜不到,下次你说什么他都不信了。
第三章:接入和踩坑记录
3.1 先看整条链路长什么样
我们先把整条链路摊开看一眼:
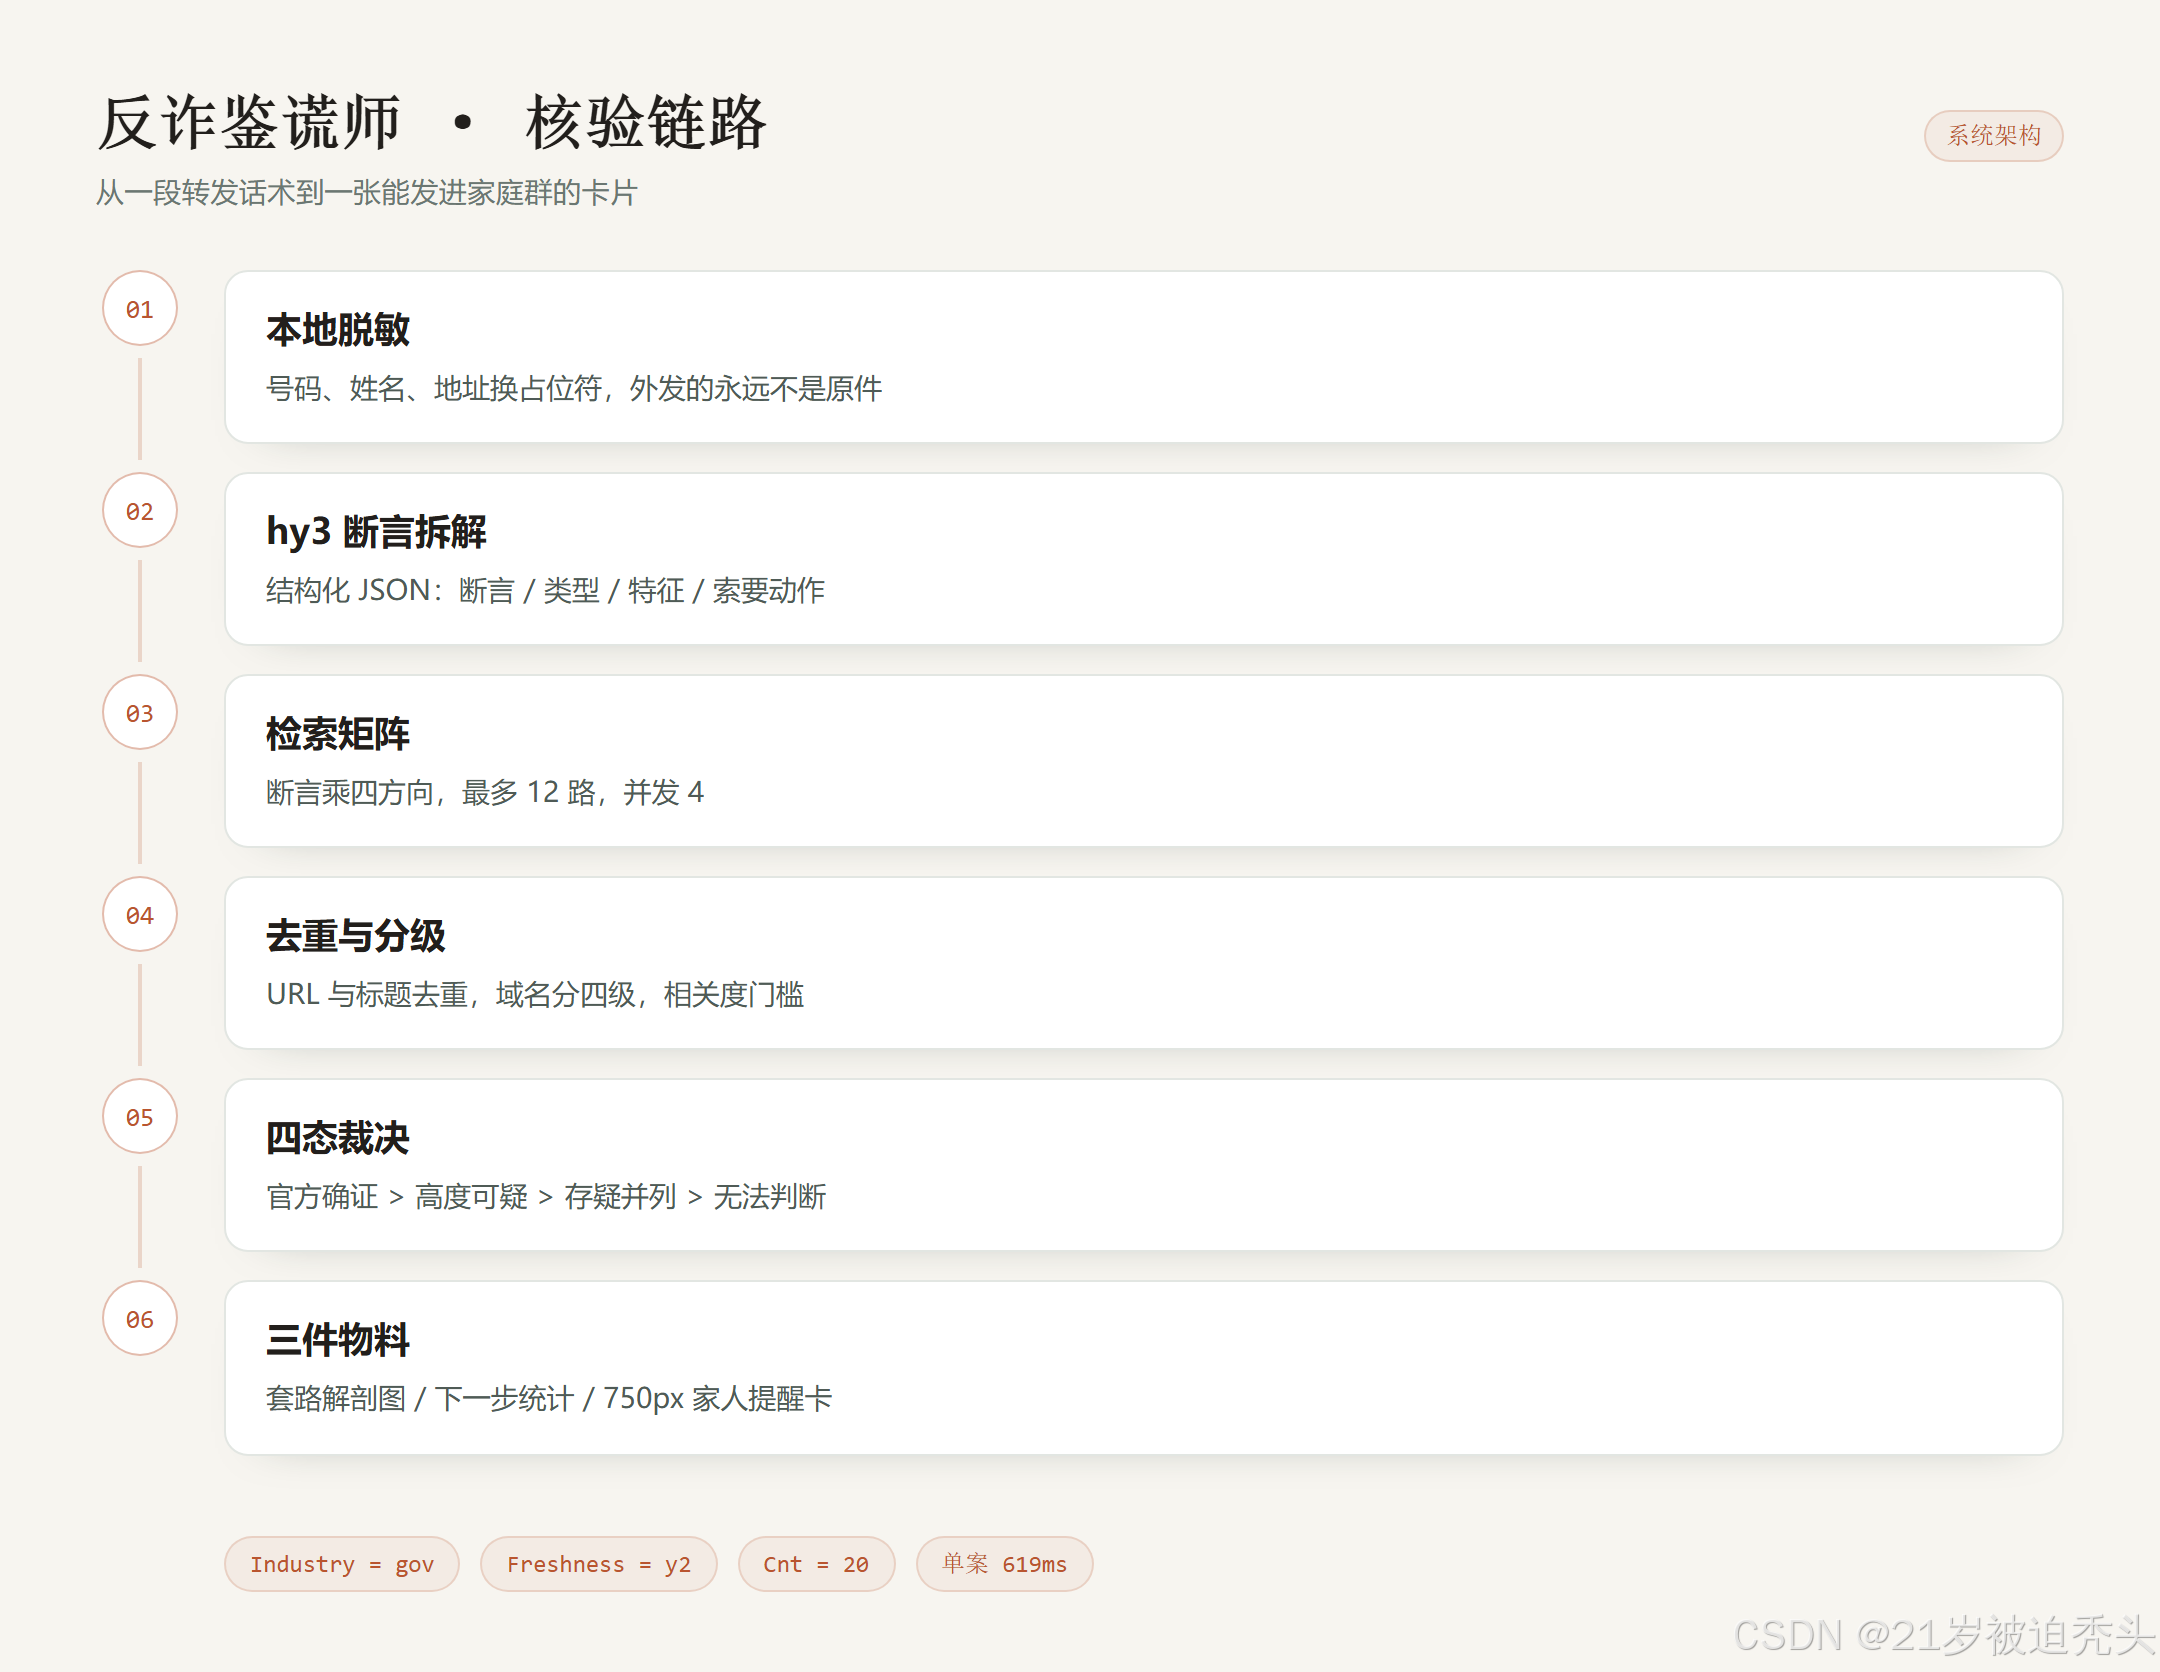
这条链路里,模型只干一件活,把一段人话拆成机器能查的断言。判断谁来做,后面再说。
3.2 模型和搜索怎么接力
这一段是最该讲清楚的,我们拆开说。
你可能觉得,接个大模型加个搜索就完了。实际接力点只有三处,每一处都可能掉链子,如下:
| 特征解构 | 混元 hy3 | 脱敏后的原始话术 | 系统提示词约束类型、特征、索要动作 | 结构化 JSON,1 到 10 条断言 |
| 精准检索 | 元宝搜索 | 断言生成的检索式 | Industry=gov、Freshness=y2、Cnt=20 | 带 url、date 的去噪摘要 |
| 多态裁决 | 规则引擎 | 证据库加相关度 | 双重门槛加四态短路 | 高危或无法判断等结论 |
系统提示词是这么写的,原文在仓库里。
你是反诈信息核验系统的断言拆解器。把用户给出的可疑消息拆成可被外部证据验证的断言。
硬性规则:
1. 只使用原文中出现的信息,禁止补充原文没有的机构名、金额或事实。
2. 输出 1 到 10 条断言。
3. 每条断言的 excerpt 必须是原文的连续片段。
4. type 取值:fact / identity / process / money。
5. verifiability 取值:verifiable / unverifiable。
6. features 取值:hook / threat / isolation / demand。
7. demands 只能取:verification_code / screen_share / transfer / install_app / secrecy。
只输出 JSON 数组,不要任何解释文字。
第 1 条和第 3 条是防幻觉的关键。模型输出后,我会在代码里再校验一次,excerpt 不在这段原文里,这条断言直接丢掉。模型可以自由发挥,但编出来的东西进不了下一环。
接通过程里踩了两个坑,都挺值钱。
第一个坑,你如果想接模型但没有token,那你可以与我一样白嫖10亿token,接到当前工作肯定够用一段时间了。那就是去注册一个微信小程序,领取成长计划,除了10亿token还有10万张混元生图,但使用时千万别直接拼 HTTP。我按文档拼了 /chat/completions 直接 POST,返回 403,因为如下:
AI_CHANNEL_NOT_ALLOWED
小程序成长计划仅支持小程序 SDK 和云开发 SDK 调用
换成 @cloudbase/node-sdk,用 API Key 初始化,才走通。
const app = tcb.init({ env: envId, accessKey: process.env.LLM_API_KEY });
const model = app.ai().createModel("cloudbase");
const res = await model.generateText({ model: "hy3", messages: […] });
第二个坑更隐蔽。第一次跑完整链路,结论是 no_anomaly。一条明显的诈骗话术,被判成了没异常。
查下来是模型把“下载会议软件”“填写验证码”标成了主观描述,裁决层就不去检索它们。修法是加一条兜底,身份声称、带索要动作或者施压特征的断言,一律按可核验处理。改完,同一段话的官方来源从 19 条涨到 69 条,结论回到高危。
这件事让我更确定一个判断,模型的活是拆结构,不是下结论。它连“这句话能不能查”都会判错,让它判是不是诈骗更不靠谱。
3.3 搜索词千万别整段丢进去
这是我踩得最深的一个坑。
最开始我把整段消息原样当 Query 发出去,返回 0 条。我还以为是接口有问题,换了几个 case 才反应过来,长句在搜索引擎里不是更精确,是没有匹配。
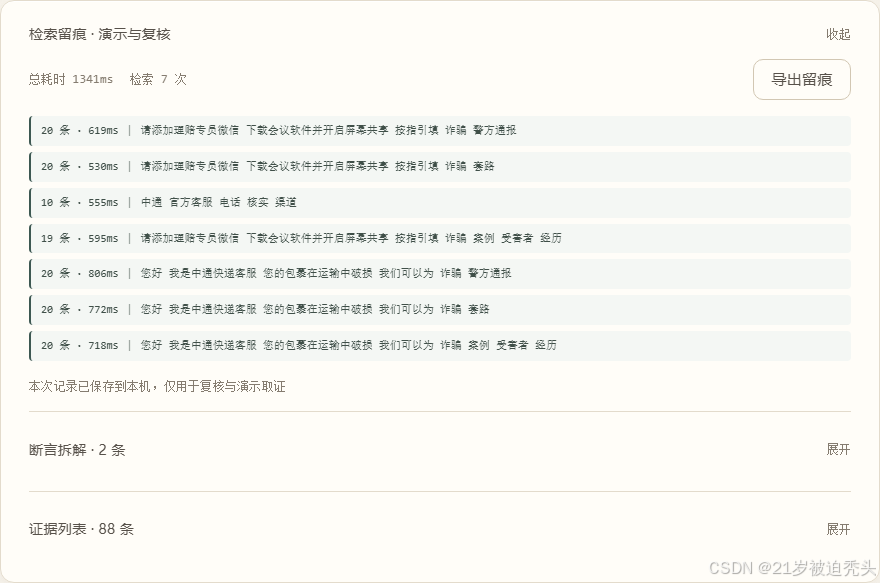
后来我们改成断言加方向的矩阵。先把消息拆成能独立验证的句子,每条断言生成 2 到 4 条检索式,方向固定四类。
| 官方通报 | 找官方定性 | 快递理赔 诈骗 警方通报 |
| 套路命名 | 找同类手法 | 快递理赔 诈骗 套路 |
| 机构渠道 | 找真实客服 | 中通 官方客服 电话 核实 |
| 同类案例 | 找受害者经历 | 快递理赔 诈骗 案例 受害者 |
检索式按断言优先级乘方向权重排序,总量上限 12 次,并发 4,单次超时 8 秒。含索要动作的断言排前面,它最可能是骗局的核心环节。
3.4 证据分级,以及为什么不把裁决交给模型
搜回来的东西质量参差,直接丢给模型总结最容易出错。我们一条条看。
我先做三件事,按 URL 和标题去重,按域名分四级(部委与公安法院、央媒、机构公告、自媒体),把既没诈骗语境又跟断言弱相关的内容丢掉。
然后是最关键的一个决定,裁决写成确定性规则,不交给模型。
// 官方确证,必须同时满足断言含实质可疑行为和证据与断言相关
const substantive = claim.features.filter((f) => f !== "hook").length;
const gate = substantive >= 2 ? 0.2 : 0.25;
const confirmed = official.filter((e) =>
hasFraudCue(e.text) && relevance(claim.excerpt, e.text) >= gate
).length > 0;
// 四态短路,官方确证 → 高度可疑 → 存疑并列 → 无法判断
理由很实际。交给模型的话,同一段话两次运行可能结论不同,截图对不上,用户问起来也答不出凭什么。
规则化之后,每条结论都能追到哪条规则、哪条证据、什么日期,这才满足需求。
3.5 去噪到底省在哪
官方把大模型友好、自动去噪、节省 Token 列为卖点,我用自己的数据量了一下。
一次核验拿到 88 条结果,passage 平均 747 字,合计约 6.5 万字符,全是标准化正文摘要,整个过程没有抓取任何一个网页。
如果自己搜网页,88 个页面按每页 3000 到 5000 字算,是 26 到 44 万字符,还要去导航、去广告、去相关推荐。
字符数和 token 大致同量级,差的是四五倍输入成本,外加一整套正文抽取的工程。
3.6 速度,两种模式差了一个数量级
规则模式每案并发 3 到 7 路检索。实测单次请求最短 82ms,最长 601ms,平均 116 到 352ms。整案从提交到结果渲染完成,619ms。
这个量级你可以自己感受一下。用户点完核验,还没把手机放下,结果就出来了。对对方正在通话这个场景,这是硬指标。
接入 hy3 之后,单案变成 6.8 到 7 秒,模型拆解要 5.4 到 5.6 秒,检索 1 到 2 秒。慢了十倍,换来的是断言更细。
所以我把两条路都留着。DECOMPOSER_MODE 传 llm 走模型,传 rule 只走规则,模型调用失败会自动降级回规则版。演示用规则模式保证不卡,真实使用用模型模式提高覆盖。你也可以按自己的场景选,别硬上模型。
| 规则 | 2 | 7 | 87 | 23 | 619ms |
| 模型 hy3 | 6 | 12 | 167 | 69 | 6.9s |
单次运行的数据,检索结果本身有轻微波动。
第四章:跑起来是什么样
我们拿开头那条消息,规则模式完整跑一次。
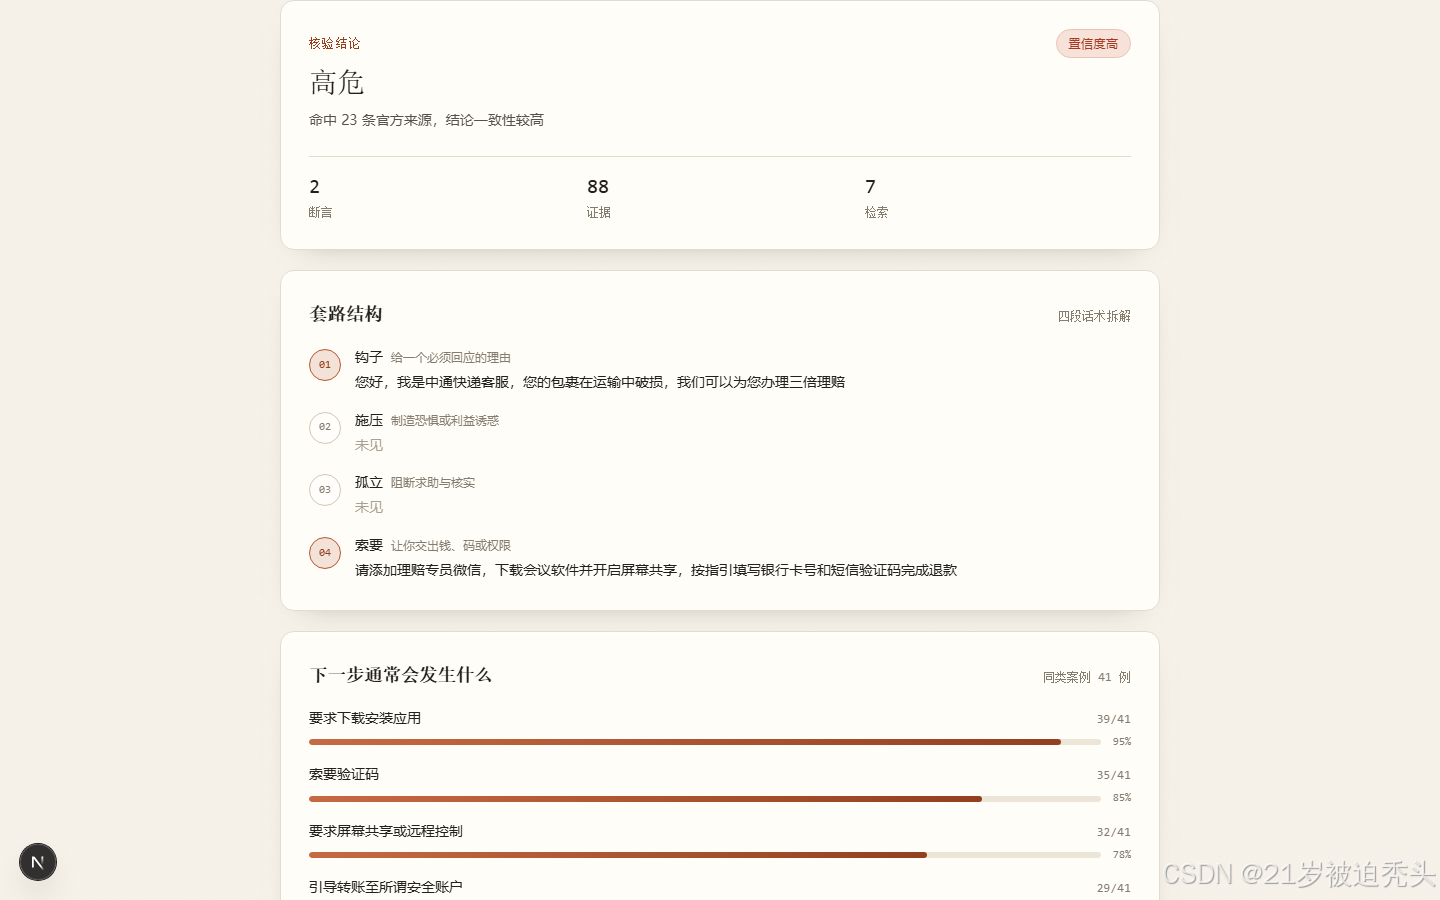
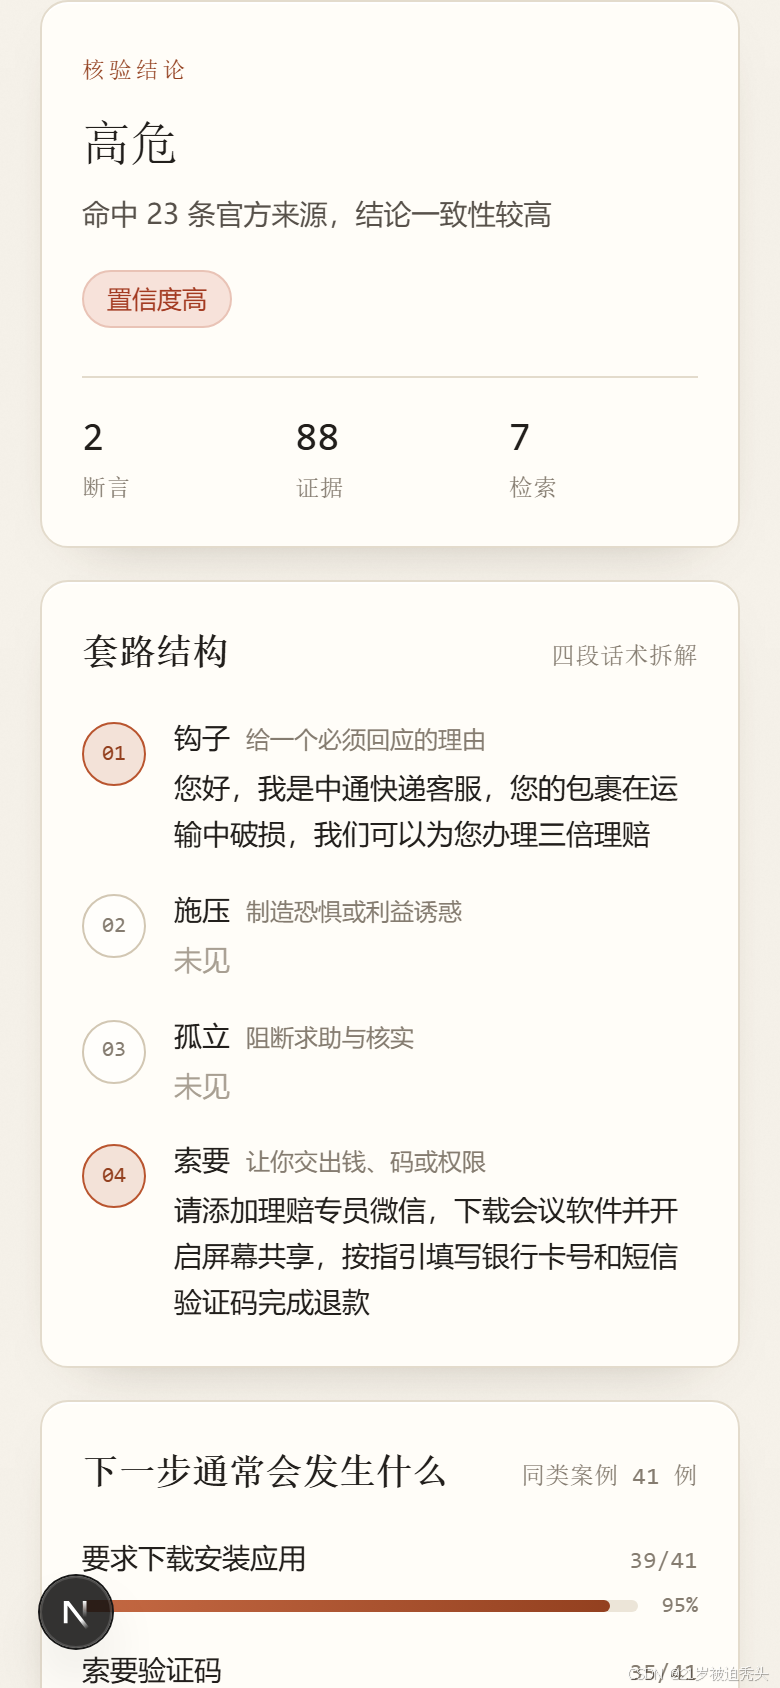
拆出 2 条断言,生成 7 路检索。
去重后留下 87 条证据,同日另一次运行是 88 条。其中 23 条是一级官方来源。
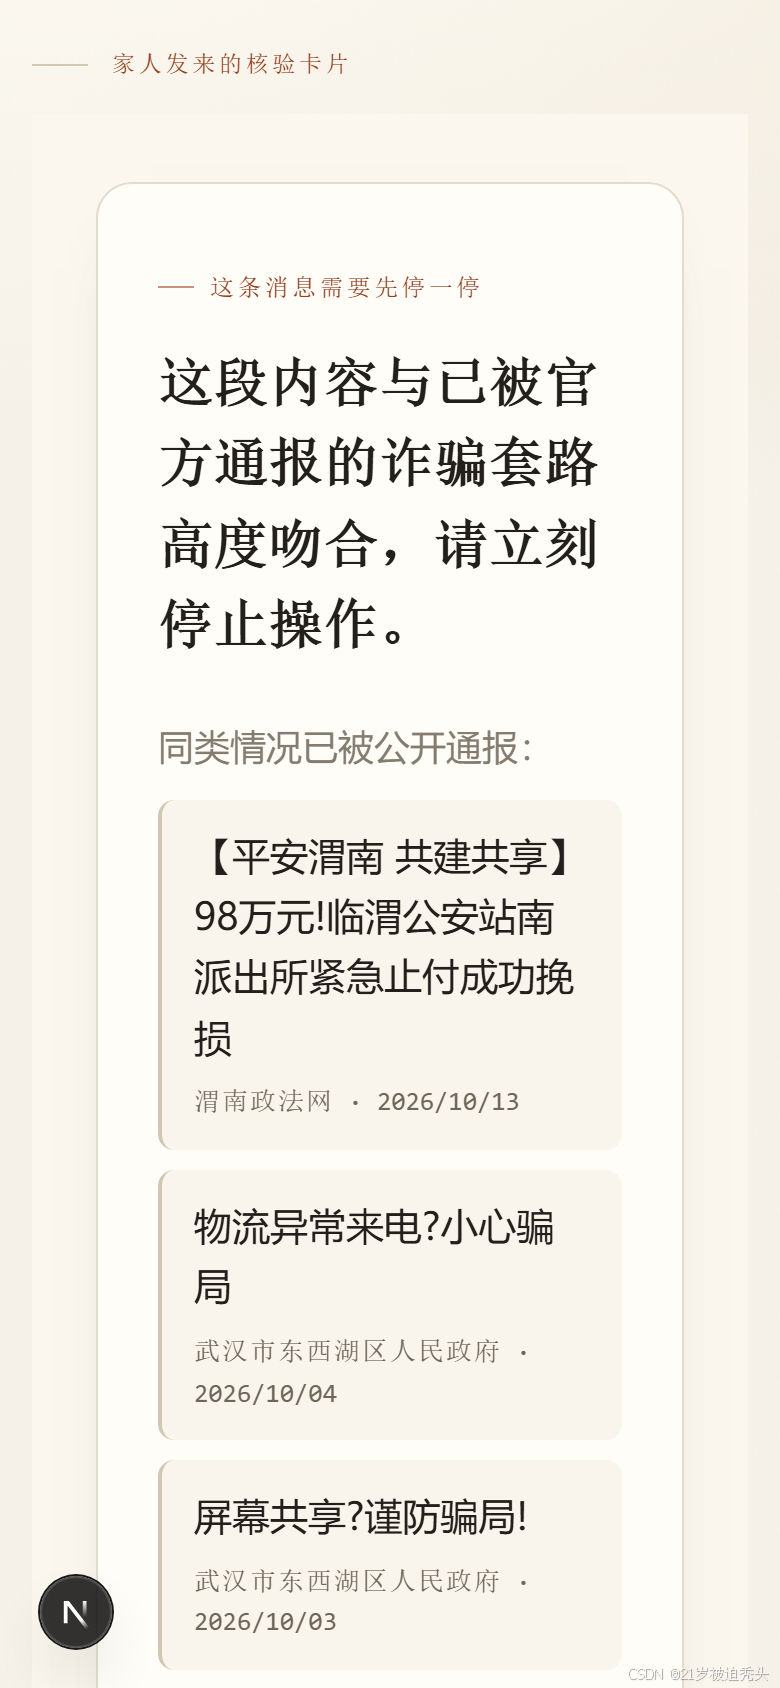
命中的通报里,有武汉市东西湖区人民政府的《物流异常来电?小心骗局》(2026-10-04)、《屏幕共享?谨防骗局!》(2026-10-03),还有渭南政法网的《98万元!临渭公安站南派出所紧急止付成功挽损》(2026-10-13)。
裁决高危,置信度高,总耗时 619ms。
工具输出三样东西,对应三个使用时刻。
套路解剖图把话术拆成四段,钩子、施压、孤立、索要。命中的段落附原文,长辈能看见自己被推到了第几步。
下一步统计给的是同类案例里各种索要动作的频次。只做统计,不做预测。预测错一次,信任就没了。
家人提醒卡语气不带指责,每条依据都有站点和日期。可以存长图,也能生成分享链接。
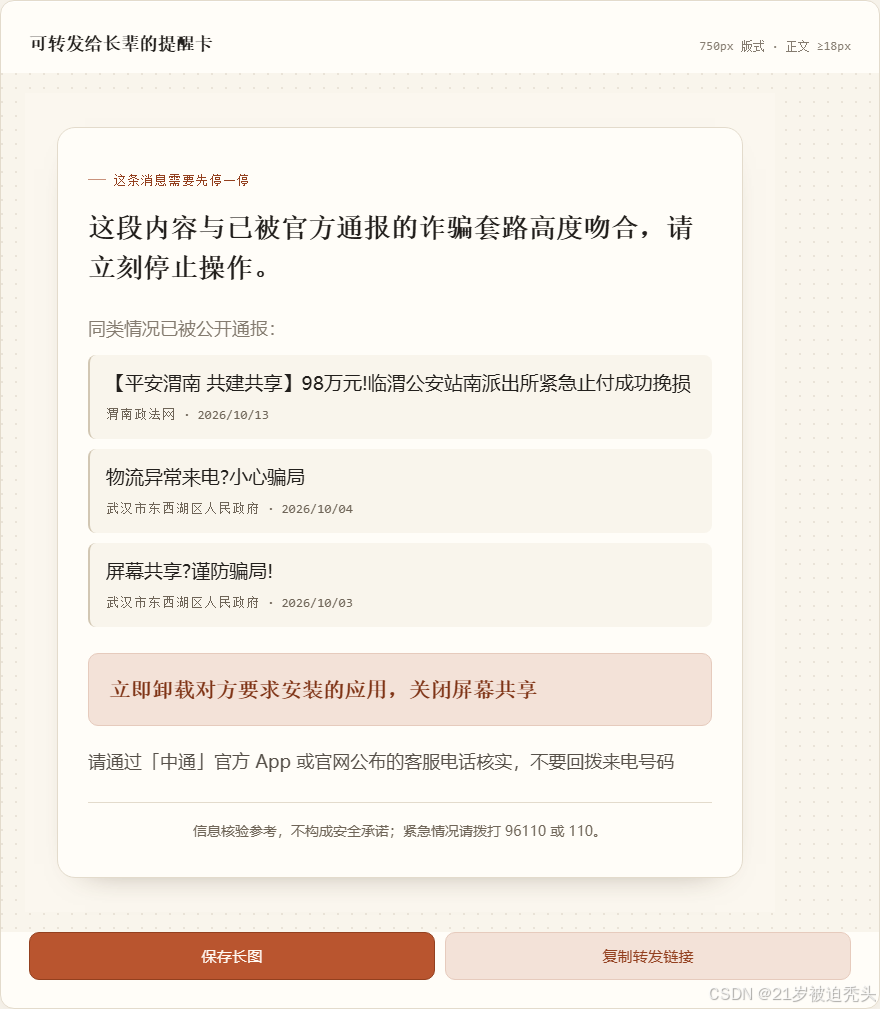
脱敏在请求之前完成。手机号、身份证、银行卡、姓名、地址在浏览器里就换成了占位符,外发的永远是脱敏版本。
手机上打开分享链接是这样。
第五章:三种做法放一起比
为了确认这不是把简单问题做复杂,我们拿同一批 7 条输入做了对比。同一台机器,同一天,同样的 Freshness 设置。你可以在自己机器上重跑一遍。
| 快递理赔加屏幕共享 | 高危 | 判可疑 | 判可疑 | 高危 |
| 冒充公检法加安全账户 | 高危 | 判可疑 | 判可疑 | 高危 |
| 刷单返利 | 高危 | 判可疑 | 判可疑 | 高危 |
| AI 换脸冒充熟人借钱 | 高危 | 漏报 | 判可疑 | 高危 |
| 养老投资加低价旅游 | 高危 | 判可疑 | 判可疑 | 高危 |
| 正常通知,快递柜取件 | 未见异常 | 无提示 | 误报 | 未见异常 |
| 查无实据,读书会逾期 | 无法判断 | 无提示 | 误报 | 无法判断 |
口径我们说一下。
A 是我自己写的静态关键词表,安全账户、验证码、屏幕共享、返利这些词命中就判可疑,零检索。
B 是一条短关键词查询,机构加场景词加诈骗,取前三条,出现诈骗措辞就判可疑,一次调用。
C 是断言级多路检索加信源分级加四态裁决,每案 3 到 7 次。
两个结果值得我们看一眼。
A 的问题不是漏报,是没证据。它靠硬词命中,AI 换脸借钱那条不含硬词,直接漏掉;即便命中,也只能说词出现了。
B 的问题更隐蔽。召回 5/5,但两条非诈骗输入全部误报。因为搜顺丰取件码诈骗,必然返回诈骗文章。
检索到诈骗内容,不等于这条消息是诈骗。这正是调一次 API 让模型总结最容易踩的坑。
顺带一句,A 只是我写的一段关键词规则,不等于任何真实产品。国家反诈中心 App 在来电拦截和号码库比对上的能力,是这套方案做不到的,两者不在同一个环节。在这里就一定要提一句了,国家反诈中心,有专业的反诈团队,有专业的反诈规则,有专业的反诈能力,我们一定要下载哦,守住你的钱袋子,嘿~
第六章:七条案例回归,还有三次翻车
| 快递理赔加屏幕共享 | 2 | 7 | 87 | 23 | 高危 | 619ms |
| 冒充公检法加安全账户 | 2 | 7 | 80 | 30 | 高危 | 250ms |
| 刷单返利 | 2 | 6 | 68 | 32 | 高危 | 215ms |
| AI 换脸冒充熟人借钱 | 1 | 3 | 13 | 5 | 高危 | 104ms |
| 养老投资加低价旅游 | 2 | 6 | 48 | 22 | 高危 | 221ms |
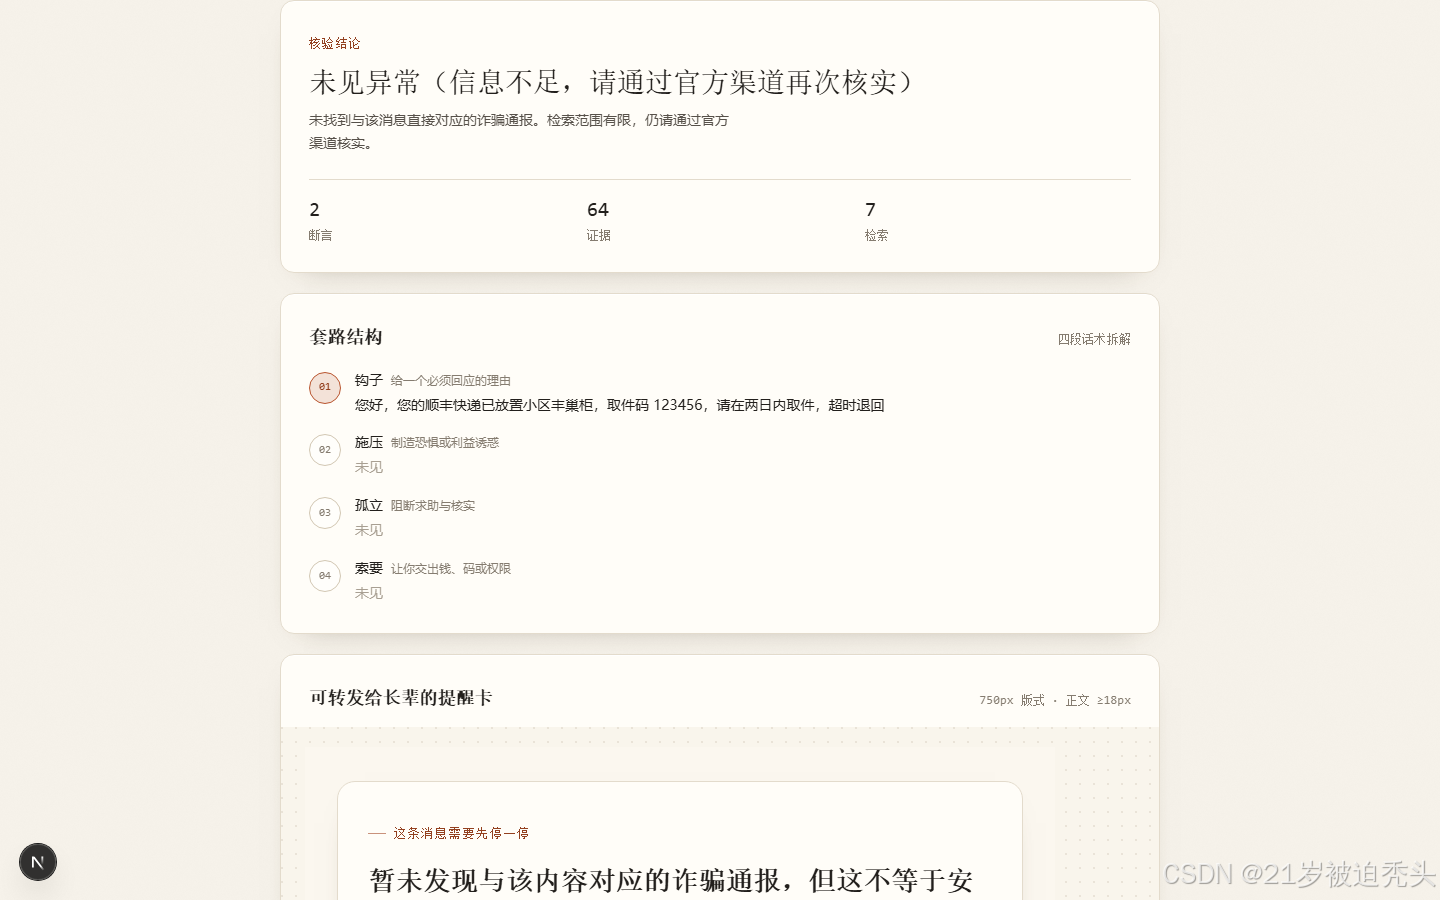
| 正常通知,快递柜取件 | 2 | 7 | 64 | 13 | 未见异常 | 222ms |
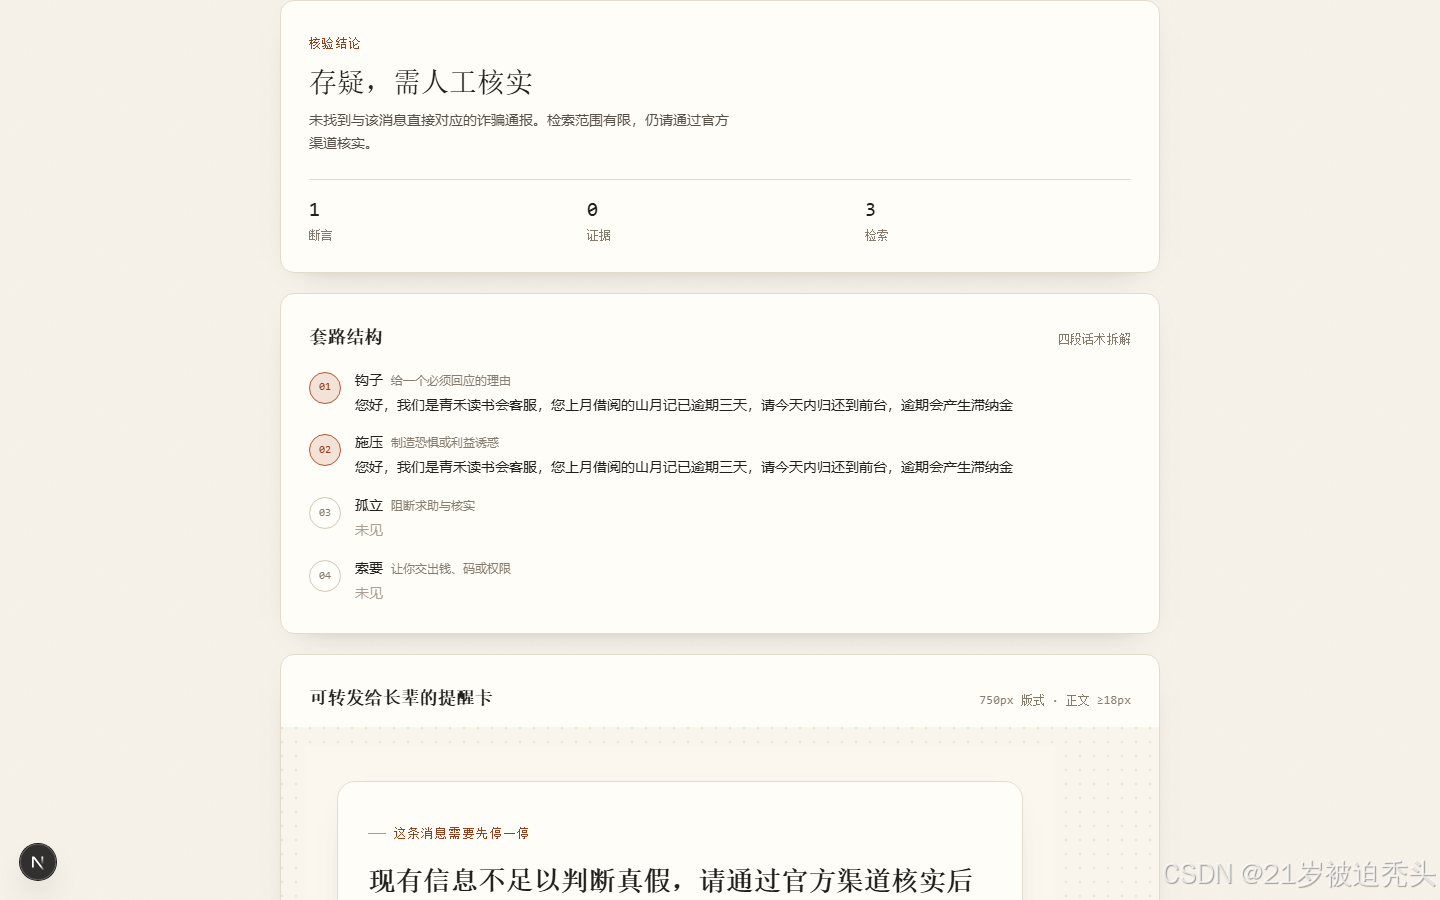
| 查无实据,读书会逾期 | 1 | 3 | 0 | 0 | 无法判断 | 97ms |
7 条全部符合预期,5 条诈骗样本平均官方信源占比 39%。这张表是规则模式的,模型模式目前只做了开篇那条的端到端验证。
这个数字不是我调得好。它反映的是元宝搜索对公安、政府、央媒这类信源的收录密度。换一个收录稀薄的搜索服务,同一套规则跑出来会立刻塌掉。
功劳在检索质量,不在我。
6.1 三次翻车
这部分比上面的表更值得写。
第一次,正常的取件通知被判成高危。
第一版规则很粗,检索到官方反诈通报,出现诈骗词,就算官方确证。结果一条快递柜取件通知,因为搜到《当心骗子用快递设局》,直接判高危。
我的修法是加双重门槛,断言必须含实质可疑行为,只有钩子不算;官方证据跟断言的相关度也要过线。改完,取件通知落到未见异常,5 条诈骗样本召回没掉。
第二次,刷单和养老两案被判成无法判断。
我查下来是反诈文章里常有不存在轻松赚钱这类否定句,触发了证据冲突。修法要求明确辟谣措辞、相关度不低于 0.5、断言含实质特征,三个条件同时满足才算冲突。
第三次最气人,是改出来的。
养老投资案在新门槛下掉出高危,因为它整段只有一个钩子特征。我翻了半天,是特征词典漏了利诱类词。把返利、高额回报、稳赚、保本并进施压类,把转到指定账户并进索要类,才恢复正常。
还有一次是接模型之后出现的,前面 3.2 说过,模型把索要动作判成主观描述,整案掉成没异常。
四次都只动规则和兜底,没动架构。这也是我坚持规则化裁决的原因,出问题能定位到具体一行,而不是模型今天状态不好。嘿嘿,翻车翻多了,反而更信这套笨办法。
6.2 测量方法和成本
环境是本机 Windows,同一网络,2026 年 10 月 23 日规则模式单次运行,模型模式为 10 月 27 日。
耗时取服务端记录的 totalDurationMs,从提交到结果渲染完成,不是估算。调用次数是 SearchPro 实际请求数,不含重试。证据条数按去重后统计,官方占比按我自己建的一级域名规则算。
样本得跟你说清楚,7 条人工构造的脱敏话术,不是随机抽样,不能外推成准确率。
成本上,规则模式每次核验 3 到 7 次检索,模型模式 12 次检索加 1 次 hy3 调用。按活动期 6000 次每月的额度算,规则模式大概能撑 850 到 2000 次,模型模式因为检索打满 12 路,只有 500 次左右。演示的时候别乱刷,额度是真会没的~
第七章:还没做好的,和给后来者的建议
再我写这篇文章时,当前项目我部署到了服务器上,但因为元宝搜索调用次数不多,这里我就先不放链接了,大家可以去仓库自己部署试试,后面我整理好会贴在评论区。而且我已经申请注册了微信小程序《先别转》并买了域名,但因为要走备案流程,到活动结束,希望已经上线,并给家人用上了,哈哈哈哈~ 这里现在先说我没做好的和我后面可能会做的优化。
首先截图输入没做。长辈最常发的就是截图,现在只能复制文字,这是最该补的一块,接下来我会补上OCR识别,看看效果,如果可以,我可能会上线微信小程序,就不只用H5了,哈哈哈。
规则拆解偏粗,按标点切句,长句拆得不够细。模型拆得细,但慢十倍,目前两条路并存,那条合适用那条。
没做过真实长辈的 A/B。卡片能不能说服人,只做了小范围口头验证,样本还很薄。
还有一个我挺在意的点,旗舰版的 authority_level 和附件子链我没用上。现在这套四级域名规则是硬编码的,能跑,但不够聪明。如果换成旗舰版返回的权威度字段,再叠加子链里的原文追溯,权重就能动态算,不用我手工维护那张域名表。这是下一步最想试的事。
如果你也在做一个需要讲证据的应用,我的建议只有一句,把搜索当成判断依据的来源,而不是答案的来源。
答案由你的应用来写,但每一句结论都要能指回一条带日期和域名的记录。这条边界划清,幻觉的问题会小很多,用户也才敢把结果转给家人。
接入上还有几条经验,都是我们自己踩出来的。
反诈、政策、医疗这类场景,优先用 Industry 定向权威垂类,别指望通用结果里碰巧有官方来源。
时效要求高的场景,用 Freshness 把老内容挡在外面,而不是取回来再过滤。
结果条数别省,Cnt 给到 20 往往比 10 更能覆盖长尾,反正后面还要去重。
元宝搜索官方给的数据是千亿级索引、10 多个垂直行业、157 家以上权威信源,已经在 WorkBuddy、ima、腾讯视频、腾讯金融科技等 15 款以上腾讯系产品里落地。
我这个小工具只是其中一个很窄的用法,但恰好是那种换掉搜索服务就做不成的用法~
信息核验仅供参考,不构成安全承诺或法律意见。紧急情况请拨打 96110 或 110。
附:运行
npm install
npm run dev # http://localhost:3000
npm run spike # 7 条案例回归,输出信源命中率
npx tsx scripts/compare.ts # 三种做法对比实验
npx tsx scripts/metrics.ts # 检索耗时、摘要长度、日期分布
npx tsx scripts/llm-probe.ts # 模型拆解单测
npx tsx scripts/llm-e2e.ts # 模型模式端到端
npx tsx scripts/hy3-compare.ts # 2.3 的实测:直接问 hy3,并核验它引用的通报
npx tsx scripts/wsa-title-check.ts # 2.3 的对照组:真实通报标题能否被检索到
node scripts/capture.mjs # 重新生成全部截图
AI 参与说明:代码编写、规则调试和本文初稿我都使用了 AI 辅助,检索结论、截图与数据来自真实运行。文中引用的官方通报保留了站点与发布日期,可以自行核对。