SD WebUI Forge 本地部署:8G 显卡跑通 FLUX 的完整操作手册
【免费下载链接】stable-diffusion-webui-forge  项目地址: https://gitcode.com/GitHub_Trending/st/stable-diffusion-webui-forge
FLUX.1 模型动辄几十 GB,12G 显卡硬塞也常常直接 OOM,很多人到这里就放弃了。Stable Diffusion WebUI Forge 构建在经典 SD WebUI 之上,靠低比特量化加载和一套自研的 GPU 内存管理系统,让 FLUX 这类大模型在 8G 上下显存的显卡上也能出图。这篇带你从克隆仓库走到第一张图,顺带讲清楚翻车时怎么自救。
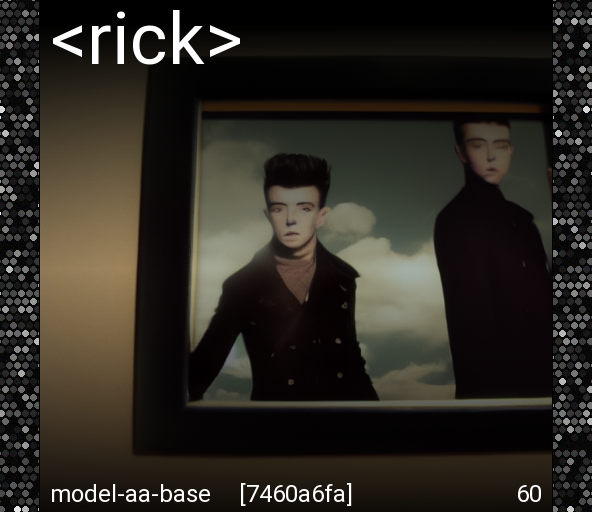
上面这张图就是 Forge 的 Textual Inversion(文本嵌入,相当于训练一个触发词绑定一种固定形象)功能的生成效果,触发词来自自训的嵌入文件。
🔍 上手前值得知道的三件事
- 技术栈:Python + PyTorch + Gradio 4 界面。官方一键安装包(7z)自带 CUDA 12.1 + PyTorch 2.3.1 环境,另有 CUDA 12.4 + PyTorch 2.4 版本(README 标注 "Fastest"),干净机器解压即用,不用自己折腾依赖。
- 和原版 WebUI 的差异:原版 A1111 的 ControlNet、LoRA、IP-Adapter 都要单独装扩展,Forge 把这些直接放进 extensions-builtin/ 目录,解压即启用;另外提供 "Diffusion in Low Bits" 低比特加载和 "Swap Method" 权重交换两个开关,原生支持 BitsandBytes NF4 与 GGUF 量化,.gguf 文件可直接丢进模型目录当检查点用。
- 适合谁:8G 显存卡在原版 WebUI 上跑图 OOM 过的人,或者想在 12G 卡上试 FLUX 又不想装一堆依赖的人。
🚀 出第一张图的最短路径
git clone https://gitcode.com/GitHub_Trending/st/stable-diffusion-webui-forge
| 系统 | Windows / Linux / macOS(仓库都带启动脚本) | Windows + NVIDIA 显卡 |
| 显存 | 8GB(SD1.5 / SDXL,配合 GPU Weights 调) | 12GB(跑 FLUX 量化模型) |
| 运行环境 | CUDA 12.1 + PyTorch 2.3.1(官方推荐一键包) | CUDA 12.4 + PyTorch 2.4(官方标注 Fastest) |
🛠 三个真正体现价值的深度玩法
GPU Weights (MB):低显存的主开关
它解决什么问题:模型权重把显存占满,生成时的矩阵运算没地方放,于是 OOM。这个滑块让你指定权重最多占多少显存,剩下留给计算。
具体操作:滑块就在页面顶部(左上角 "UI" 区选 "all" 可完整显示),设置页里也有。
设置页 → GPU Weights (MB)
默认值 = 总显存 – 1024(预留 1GB 给矩阵运算)
一句实战经验:显存不足时终端会直接打印提示 "you can set the 'GPU Weights' … to a lower value",官方排障帖的原话是 "Lower 'GPU Weight' solves 99% problems";反过来拉满 100% 等于给运算留 0% 空间,这一步不建议这么做。
"Diffusion in Low Bits":低比特加载 FLUX
它解决什么问题:FLUX.1 原始体积太大,直接加载塞不进显存。Forge 把权重压到低比特存储,配合量化模型文件使用。
具体操作:
Checkpoint 下拉: 选 FLUX.1-dev(NF4 或 GGUF 版)
Diffusion in Low Bits: bnb-nf4 / float8-e4m3fn 等
Swap Method: Queue 或 Async;Swap Location: CPU 或 Shared
一句实战经验:NF4、GGUF Q8_0/Q5_0/Q4_0 这些量化档都原生支持,且 README 明确写了它们都可以再挂 LoRA,不用在"能跑"和"能挂 LoRA"之间二选一。
内置 ControlNet:线稿控制零安装
它解决什么问题:原版 WebUI 想用 ControlNet 得先装扩展、再下模型、再配预处理器,Forge 把这些全挂在同一个面板里,预处理器列表在 README 状态表里整体验证为 "All Preprocessors: Normal"。
具体操作:
预处理器: lineart_realistic
模型: 选对应的 lineart 控制模型
一句实战经验:传上线稿、下拉选预处理器就能控制构图,完全不用装东西;但想给 FLUX 配 ControlNet 的现在先别急,README 状态表明确标着 Flux ControlNet 和 Union ControlNet "Not implemented yet"。
🧯 翻车自救对照表
| 页面卡死 / 提示连接中断 | 调低 GPU Weights (MB) 重试;仍不行就重启服务 |
| 生成时报低显存警告 | 降 GPU Weights,默认只预留 1GB 运算空间,往低调即可 |
| 画布拖不动 | Gradio 4 界面要用鼠标右键拖动画布,不是左键 |
| OFT LoRA 用不了 | 仓库状态表标注 "Broken, pending fix",换普通 LoRA |
| 想用 FLUX ControlNet | 尚未实现,等更新,别浪费时间去调参 |
原版 WebUI 的扩展包还能直接拿来用吗? 大部分能,但 Forge 的 extensions-builtin/ 里已有 ControlNet、LoRA、IP-Adapter 等内置等价物,README 里列了内置扩展清单和替换对照,装重复扩展前先看一眼,免得面板里出现两套同类控件打架。
调完 GPU Weights 要不要重启服务? 不用。这个滑块挂了实时回调,改动立刻刷新内存管理设置,保存也不影响当前会话;但注意反向操作——往模型目录丢新检查点文件后,是必须重启服务才能识别的。
Forge 想做的事其实就一件:让本地出图不再被显存绑架。从一键安装包到 GPU Weights 滑块,从内置 ControlNet 到 FLUX 低比特加载,每一步都在降部署门槛;卡住了,先看下面这几处。
- GPU 内存管理系统:backend/memory_management.py
- 推理引擎源码:backend/diffusion_engine/
- 最新进度与已知问题:NEWS.md
【免费下载链接】stable-diffusion-webui-forge 项目地址: https://gitcode.com/GitHub_Trending/st/stable-diffusion-webui-forge
创作声明:本文部分内容由AI辅助生成(AIGC),仅供参考