【免费下载链接】brpc
brpc is an Industrial-grade RPC framework using C++ Language, which is often used in high performance system such as Search, Storage, Machine learning, Advertisement, Recommendation etc. "brpc" means "better RPC".
项目地址:
https://gitcode.com/gh_mirrors/brpc3/brpc
点击查看 免费下载
brpc 服务在线上出现"卡顿""超时""QPS 上不去"时,往往很难直接判断瓶颈在 CPU 还是在 IO。本文以 brpc 官方运维文档 docs/cn/server_debugging.md 为骨架,给出从宏观指标(工作线程数、CPU 使用率)到微观手段(rpcz 时间线、bvar 计数器、profiler)的一整套排查流程:先看 /vars 面板判定线程与 CPU 是否够用,再区分 cpu-bound 与 io-bound,最后用 TRACEPRINTF、bvar::LatencyRecorder 等工具逐层缩小范围,直到定位出真正拖慢服务的函数。
1. 先看工作线程数量:bthread_worker_count 与 bthread_worker_usage
brpc 的 server 使用 bthread(M:N 协程)承载请求,工作线程(worker)的多少直接决定了服务能同时处理多少请求。排查的第一步就是打开服务的内置服务面板(默认端口 9000,或访问任意端口下的 /vars 页面),查看两个核心指标:
| /vars/bthread_worker_count | 当前工作线程(worker)的总个数,即 bthread 调度器创建的 worker 数量 |
| /vars/bthread_worker_usage | 正在被使用(正在运行任务)的工作线程个数 |
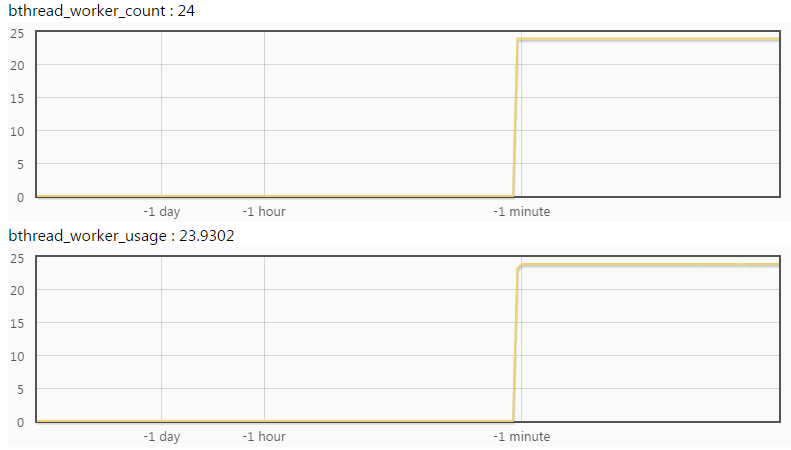
判断准则:如果 usage 和 count 接近,说明工作线程不够用了。
以官方文档给出的示例来说,某服务共有 24 个工作线程,而 usage 显示 23.93,意味着几乎所有 worker 都处于繁忙状态,请求只能排队等待空闲 worker,服务已经"打满"了:
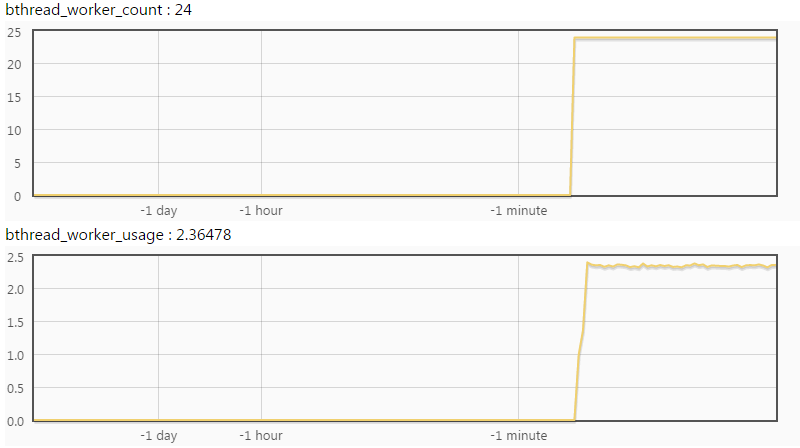
而如果 usage 只有 2.36,说明大量 worker 空闲,工作线程数量是足够的:
这两个 bvar 由 bthread 调度器在启动时注册(见 src/bthread/task_control.cpp 中 _nworkers("bthread_worker_count") 的注册逻辑),因此无需任何额外配置即可在 /vars 中看到。官方文档还给出了一种快捷查看方式:把 /vars/bthread_worker_count;bthread_worker_usage?expand 拼在服务 URL 之后,即可在同一个页面里并排看到这两幅图(expand 参数用于展示 bvar 的动态图)。
2. 再看 CPU 使用程度:system_core_count 与 process_cpu_usage
工作线程够不够只是表象,真正要判断的是计算资源是否充足。第二步查看 CPU 相关的两个指标:
| /vars/system_core_count | 机器的 CPU 核心个数 |
| /vars/process_cpu_usage | 当前进程实际占用的 CPU 核数 |
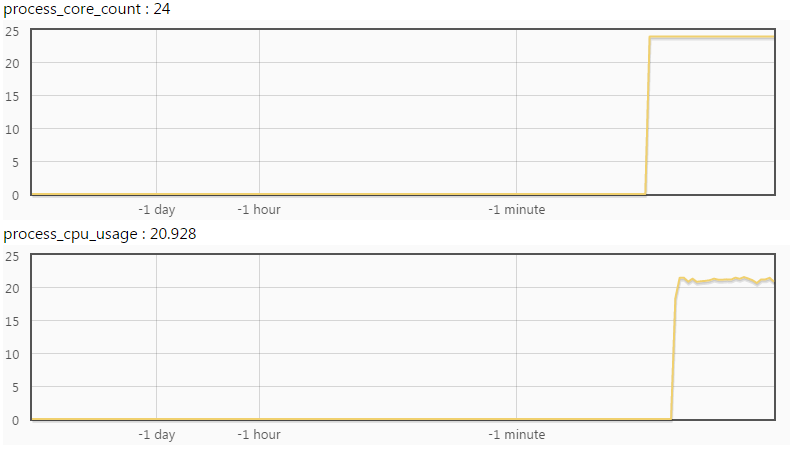
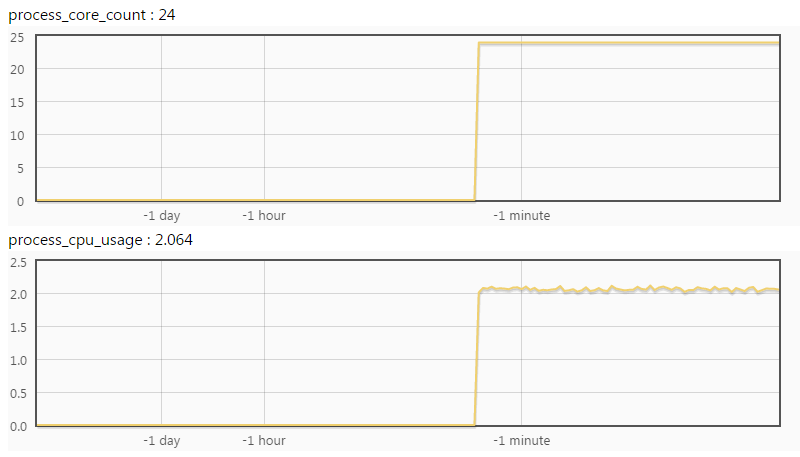
判断准则:如果 usage 和 count 接近,说明 CPU 已经不够用了。
官方文档示例中,机器有 24 个核,进程占用了 20.9 个核,说明 CPU 已经是瓶颈:
而如果只占用了 2.06 个核,说明 CPU 资源非常充裕,瓶颈另有他处:
从源码看,system_core_count 与 process_cpu_usage 由 bvar 的默认变量在进程启动时自动注册:前者通过 get_core_num 探测核数(见 src/bvar/default_variables.cpp),后者周期性采样进程 CPU 时间占比(见 src/bvar/default_variables.cpp 附近的 PassiveStatus 定义)。所以只要服务跑起来,这两个指标就一定存在,可以作为第一手判断依据。
3. 定位问题:区分 cpu-bound 与 io-bound
看完四个指标后,把工作线程使用率和进程 CPU 使用率放在一起对比,即可初步判定瓶颈类型:
- 如果 process_cpu_usage 和 bthread_worker_usage 接近:说明 worker 大部分时间在做真实计算,属于 cpu-bound(计算密集型);
- 如果 process_cpu_usage 明显小于 bthread_worker_usage:说明大量 worker 虽然"被占用"但并没有在跑 CPU 指令,而是在阻塞等待,属于 io-bound(IO/等待密集型)。
阻塞时间的占比可以用一个简单公式估算:
阻塞时间比例 ≈ 1 – process_cpu_usage / bthread_worker_usage
官方文档给出的算例:process_cpu_usage = 2.4,bthread_worker_usage = 18.5,则工作线程大约花费了 1 – 2.4/18.5 ≈ 87.1% 的时间在阻塞上。这个数字越大,越说明服务不是缺 CPU,而是"等"得太久。
3.1 定位 cpu-bound 问题
如果判定为 cpu-bound,原因通常有两个方向:单机性能不足,或上游分流不均导致流量倾斜到某台机器。
排除上游分流不均的嫌疑:在多个下游机器的 /vars 面板里输入 qps 过滤,对比各机器的 QPS 是否符合预期,例如官方文档展示的 bthread_creation_qps(bthread 创建速率)等指标:
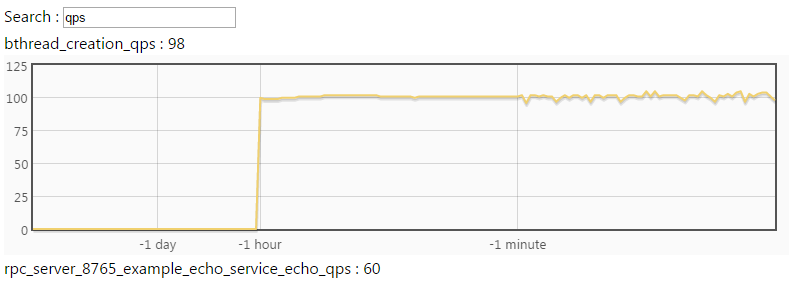
也可以在命令行中用 curl 直接抓取,例如:
$ curl brpc.baidu.com:8765/vars/*qps*
bthread_creation_qps : 95
rpc_server_8765_example_echo_service_echo_qps : 57
curl 的通配符 * 会被 brpc 的 vars 服务展开,可用于批量检索匹配某一模式的全部 bvar。
如果确认不同机器的分流确实不均、且短时间内难以靠上游调平,一个务实的兜底方案是给服务设置最大并发限制,防止单机被过量请求压垮,具体配置方法见 服务端配置。
优化单机性能:如果分流均匀但单机就是慢,请直接用 CPU profiler 分析程序热点,用数据驱动优化。一般来说,一个卡顿的 cpu-bound 程序在 profiler 输出中一定能看到显著的热点函数,把优化资源集中到这些热点上远比凭感觉"猜"高效。
3.2 定位 io-bound 问题
io-bound 的可能原因按常见程度排列:
- 工作线程确实配置少了(worker 数量不足以覆盖并发);
- 访问下游服务的 client 不支持 bthread,且下游延迟过长——此时阻塞来自同步等待下游返回,这种阻塞与计算无关;
- 阻塞来自程序内部的锁、磁盘/网络 IO 等——例如持锁时间过长、读盘、跨机房调用等。
核心原则:如果阻塞无法避免,优先考虑用异步(例如 brpc 的异步 client、回调、Future 等),让 worker 在等待期间去处理其他请求,而不是靠堆线程硬扛。
排除工作线程数不够的嫌疑
如果怀疑线程数配少了,brpc 支持运行时动态调大工作线程数,无需重启:
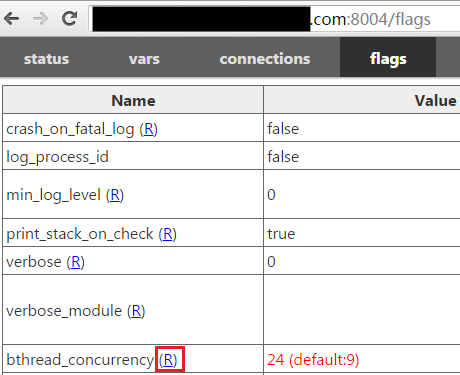


从源码看,bthread_concurrency 是 bthread 的全局配置,且注册了专门的 flag 校验器(见 src/bthread/bthread.cpp),并发数有上下限约束(BTHREAD_MIN_CONCURRENCY 与 FLAGS_bthread_concurrency 之间的合法性校验,见 src/bthread/bthread.cpp);同时 worker 池在调整后会动态增删 worker,这也是为什么 usage 与 count 会随运行实时变化。
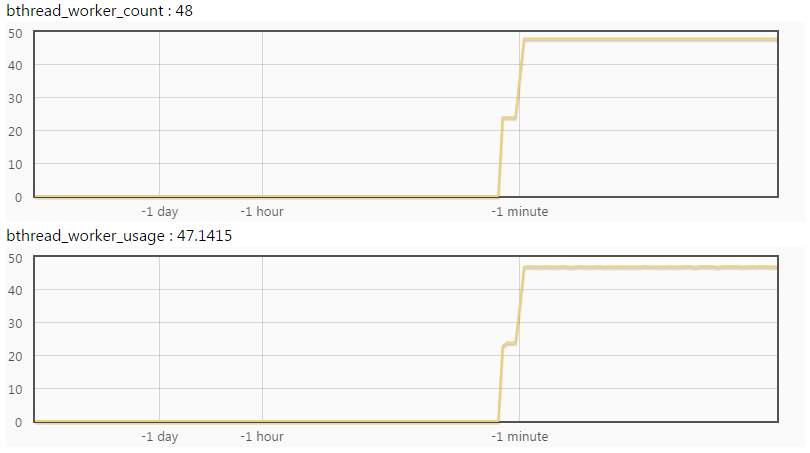
重要提醒:调大线程数未必有用。 如果 worker 是因为访问下游而大量阻塞,那么真正的瓶颈在后端,调大线程只是让每个线程的阻塞时间变长、请求整体延迟更高。官方文档给出的反例非常典型:调大线程数后,新增的工作线程依然被打满:
排除锁的嫌疑
如果程序被某把锁挡住,同样会表现出"io-bound"的特征(CPU 低、worker 占用高)。此时先用 contention profiler(锁竞争分析器) 排查锁的竞争状况,确认是否真的有一把全局锁在串行化所有请求,再决定是优化锁粒度还是改用无锁/读写锁方案。
使用 rpcz 深入单次 RPC 的时间线
当宏观判断偏向 io-bound 后,下一步就是看具体的请求内部发生了什么。rpcz(RPC 时间线追踪,内置服务 /rpcz)可以看到最近的所有请求,以及处理它们时在每个阶段花费的时间(单位:微秒):
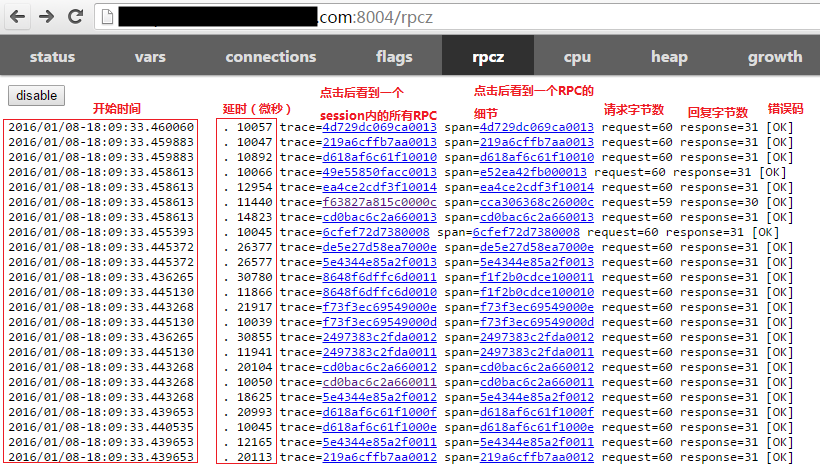
点击某个 span 链接,可以看到该次 RPC 何时开始、每个阶段花费多长时间、何时结束:
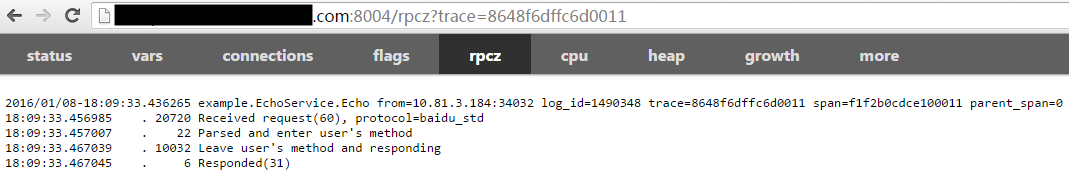
官方文档给了一个典型的 server 严重阻塞案例:从接收到请求到开始运行用户回调花了 20ms,说明服务端已经没有足够的工作线程来及时领取任务,请求在 worker 队列里排队了。
如果 span 自带的信息不够,可以往程序里加日志。brpc 提供了 TRACEPRINTF 宏(定义于 src/brpc/traceprintf.h),它会把带 文件:行号 前缀的内容打印进 rpcz 的时间流中:
#include <brpc/traceprintf.h> // TRACEPRINTF
void search() {
TRACEPRINTF("begin search, request_id=%lu", req_id); // 会被记录进 rpcz span
…
}
注意:从 src/brpc/traceprintf.h 的注释可以看到,rpcz 未启用时 TRACEPRINTF 的实参不会被求值,所以不要在它的参数里放有副作用的表达式。
重新运行并再查看该 span,打印内容会按时间顺序嵌入在 rpcz 的时间流中(如图中 [xxx.cpp:yyy] begin search …):

再次查看该 span,就能看到我们插入的 TRACEPRINTF 日志确实出现在时间轴里:
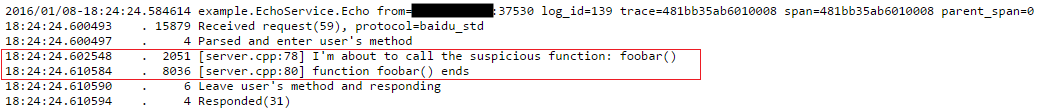
官方文档演示了如何用这个手段缩小范围:在第一条 TRACEPRINTF 之前,用户回调已运行了 2051 微秒(符合预期),而紧接着的 foobar() 却花了 8036 微秒——本以为它会很快返回,结果嫌疑集中到了 foobar() 上。重复"加 TRACEPRINTF → 看 span → 缩小范围"这个过程,直到找到那个造成问题的函数。
使用 bvar 做高频小函数的耗时监控
TRACEPRINTF 适合"低频、关键"的函数调用;但如果一个函数被调用了很多次,或者函数本身开销很小,每次都往 rpcz 打日志就不合适了(日志量太大且影响性能)。此时改用 bvar。
bvar 是一个多线程下的计数库,能以极低的开销统计用户递来的数值,相比"打日志大法"几乎不改变程序行为。排查时不需要了解 bvar 的全部用法,只要会用 bvar::LatencyRecorder 即可。仿照下面的代码对 foobar() 的运行时间做监控:
#include <butil/time.h>
#include <bvar/bvar.h>
bvar::LatencyRecorder g_foobar_latency("foobar");
…
void search() {
…
butil::Timer tm;
tm.start();
foobar();
tm.stop();
g_foobar_latency << tm.u_elapsed();
…
}
从 src/bvar/latency_recorder.h 的注释可以看到,LatencyRecorder 本身不是单个 bvar,而是内部包含多个 bvar 的组合体。以 "foobar" 为前缀 expose 之后,会自动生成如下一批指标(expose 的实现见 src/bvar/latency_recorder.cpp):
| foobar_latency | 平均耗时(可带时间窗口) |
| foobar_max_latency | 最大耗时 |
| foobar_count | 已记录次数 |
| foobar_qps | 每秒记录次数 |
| foobar_latency_p1 / p2 / p3 / latency_999 / latency_9999 | 百分位耗时(分位数由 FLAGS_bvar_latency_p1/p2/p3 控制,如 50%/80%/90%/99.9%/99.99%) |
| foobar_latency_percentiles | 分位数汇总(HTML 展示) |
| foobar_latency_cdf | CDF(累积分布曲线,HTML 动态图) |
operator<< 的实现(见 src/bvar/latency_recorder.cpp)会同时把耗时写入均值、最大值和百分位三套统计结构,所以一次 << 就能得到全部分布信息。
重新运行程序后,在 /vars 的搜索框中键入 foobar,就能看到上面这些指标:
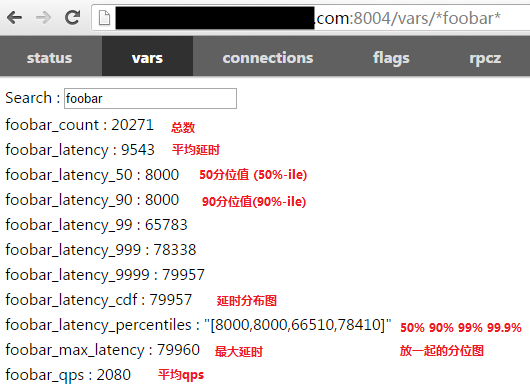
点击一个 bvar 可以看到动态图,例如点击 latency_cdf 后看到 CDF 分布:
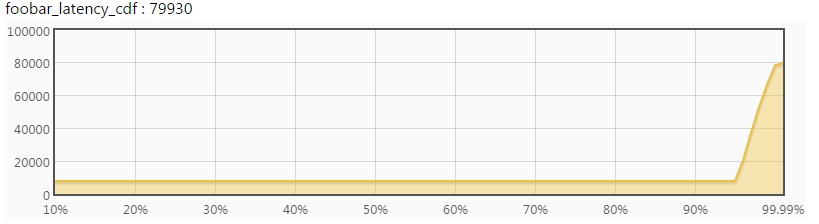
根据延时的分布,可以推测这个函数的整体行为:对大多数请求表现如何(中位数、低分位),对长尾请求表现如何(99% / 99.9% 分位是否显著拉高)。然后可以在子函数中继续这个过程——给更深层的函数再加 LatencyRecorder,并比对不同的分布,最后定位到真正拖垮延迟的来源。
只使用了 brpc client:用 dummy server 开启内置服务
如果排查程序只使用了 brpc 的 client(或根本没有用 brpc),上述所有内置服务(/vars、/flags、/rpcz 等)默认都是不可用的,因为内置服务挂在 server 上。解决方法是启动一个 dummy server,详见 dummy_server 文档:
- 使用了 brpc client:在程序运行目录创建 dummy_server.port 文件,填入一个端口号(如 8888),程序会立刻在该端口启动 dummy server,浏览器访问其内置服务即可看到同进程内的所有 bvar;
- 完全没有使用 brpc:在程序入口手动加入:
#include <brpc/server.h>
int main() {
…
brpc::StartDummyServerAt(8888/*port*/);
…
}
4. 排查流程小结
| 1 | 工作线程是否够用 | bthread_worker_usage 是否接近 bthread_worker_count | 动态调大 bthread_concurrency(/flags 页面的 (R)) |
| 2 | CPU 是否够用 | process_cpu_usage 是否接近 system_core_count | 用 CPU profiler 找热点并优化 |
| 3 | 判定 cpu-bound / io-bound | 对比 process_cpu_usage 与 bthread_worker_usage | cpu-bound 查热点与分流;io-bound 查锁、下游与异步化 |
| 4 | 单次 RPC 时间线 | rpcz span 各阶段微秒耗时 | 用 TRACEPRINTF 逐步缩小范围 |
| 5 | 高频小函数耗时 | bvar 延迟分布(均值/分位/CDF) | 用 bvar::LatencyRecorder 逐层下钻 |
| 6 | 锁竞争 | 是否大量 worker 阻塞在锁上 | 用 contention profiler |
| 7 | 纯 client 程序 | 内置服务不可用 | 按 dummy_server 文档 开启 |
总结起来,brpc 服务端排障的核心心法就是**"先看宏观指标定性,再用微观工具定量"**:bthread_worker_count/usage 与 system_core_count/process_cpu_usage 四个 bvar 三分钟就能把问题归到 cpu-bound 或 io-bound 两大方向;cpu-bound 交给 CPU profiler 与分流排查,io-bound 则用 rpcz 时间线、TRACEPRINTF、bvar::LatencyRecorder 和 contention profiler 层层下钻。整套方法论不需要重启服务、不需要改线上架构,绝大多数性能问题都能在分钟级内锁定到具体函数。
 赞
【免费下载链接】brpc
brpc is an Industrial-grade RPC framework using C++ Language, which is often used in high performance system such as Search, Storage, Machine learning, Advertisement, Recommendation etc. "brpc" means "better RPC".
项目地址:
https://gitcode.com/gh_mirrors/brpc3/brpc
点击查看 免费下载
相关推荐
CANN原子累加API文档
如何通过RVZ块大小优化获得3倍Dolphin模拟器性能提升
创作声明:本文部分内容由AI辅助生成(AIGC),仅供参考