解决什么问题:模型网关、支付回调这类「上游一抖,客户端就重试」的场景里,哪种重试策略会把局部故障放大成全局过载。本文用一段可运行的离散事件仿真,把六种策略放在同一个故障剧本下对拍,并在文末给出完整可粘贴的源码。
适合谁读:写 Spring Cloud Gateway / Resilience4j 封装、自己实现过退避与熔断的 Java 后端。
能收获什么:一张 0.94x 到 2.48x 的放大倍数对照表;一条「交付率 100% 的策略最危险」的反直觉结论;一个把中位延迟压到 205 ms、却让 p99 从 7700 ms 涨到 9146 ms 的抖动实验;以及一张熔断器七组单变量对照表——同一套熔断代码,只改一个 deadline,就从「一次都不跳闸」变成「刚好有用」。
GitHub 在 2026 年 8 月 20 日发布了 8 月 17 日那次大故障的复盘,署名是 CTO Vlad Fedorov。那次中断 7 小时 47 分钟,官方定性不是代码或配置变更,而是容量失败。复盘里最扎眼的一段写的不是故障本身,而是恢复:多数服务当天下午就回来了,Copilot 却拖到最后,因为客户端的重试循环在恢复期不断抬高流量,团队必须先把它压下去才敢放量。公开解读把整改方向归纳成两条:统一的重试预算,以及可变超时。
我把这句话当成一个可以量化的问题:如果只给 6 秒故障,退避、抖动、预算、deadline、熔断这五种机制各自会把系统带去哪里?于是写了个离散事件仿真:200 个客户端、60 秒虚拟时间、上游容量 240 req/s、第 20~26 秒整体不可用(正好 6 秒故障),六种策略跑同一个剧本、同一个随机种子。结论先放这里——指数退避把交付率做到 100%,同时把过载秒数从 6 秒拉长到 34 秒;只有重试预算能把放大倍数压回 1.03x,代价是主动放弃 9.2% 的请求;而熔断跳不跳闸,取决于你有没有别的机制先把失败攒成「连续」。这篇文章的全部数字都在我这台机器上真跑出来,代码在第八节,你可以改参数复算。
一、模型设定与实测环境口径
参数都是显式给定的,没有隐藏常量,便于你改数复算。
| 客户端数 | 200 | 每秒每客户端发 1 个业务请求,即稳态 200 req/s |
| 上游容量 | 240 req/s | 同一秒到达数超过它就过载失败 |
| 故障窗口 | 第 20~26 秒 | 期间所有请求直接失败,共 6 秒 |
| 正常上游时延 | 200 ms | 交付时延里叠加这个常数 |
| 随机种子 | 4242 | 固定,保证整张表可复算 |
| 业务请求总数 | 12000 | 200 × 60,放大倍数的分母 |
| 重试时刻归属 | 到达秒 + ceil(累计等待 / 1000) | 关键约定:零退避的 S1 会把 4 次尝试全压进同一秒 |
| 判定口径 | 交付率 = 最终拿到结果的业务请求占比 | 被 deadline 掐掉、被预算拒发、被熔断快速失败,都算未交付 |
实测环境口径。下面这一格是写这篇文章前现跑的,不是从上一篇抄的——这张草稿三天前存的时候,版本口径那一行写的是 JDK 17.0.20,今天在这台机器上重新执行 java -version 拿到的是 17.0.18。凡是只在上一个工程里出现过小版本号的东西,都不要往这一篇里搬。
| java -version | java version "17.0.18" 2026-01-20 LTS |
| javac -version | javac 17.0.18 |
| java.version | 17.0.18 |
| java.version.date | 2026-01-20 |
| java.runtime.version | 17.0.18+8-LTS-264 |
| java.vendor | Oracle Corporation |
| os.name | Windows 11 |
| os.version | 10.0 |
| os.arch | amd64 |
| file.encoding | GBK |
| availableProcessors | 16 |
两个由实测值直接导出的注意事项:① file.encoding = GBK,所以 javac 必须显式带 -encoding UTF-8,否则源码里的中文策略名和注释会编坏,表格里的对齐也会乱;② 整个仿真是单线程纯计算,没有并发、没有第三方依赖,用到的新语言特性只有 Java 17 的 record,换任何 JDK 17+ 结果都一样。
策略定义就是一条记录,六个字段解释完全部差异:
public record Cfg(String name, int maxRetry, long baseMs, String jitter,
int budgetPct, long deadlineMs, boolean breaker) { }
public static final Cfg[] CFGS = {
new Cfg("S1 固定重试3次", 3, 0, "none", 100, 30_000, false),
new Cfg("S2 指数退避无抖动", 5, 500, "none", 100, 30_000, false),
new Cfg("S3 指数退避+全抖动", 5, 500, "full", 100, 30_000, false),
new Cfg("S4 全抖动+重试预算20%", 5, 500, "full", 20, 30_000, false),
new Cfg("S5 预算+deadline", 5, 500, "full", 20, 3_000, false),
new Cfg("S6 预算+熔断", 5, 500, "full", 20, 3_000, true),
};
二、结果:交付率 100% 的两行最危险
== 上游第 20~26 秒整体不可用;容量 240 req/s;200 客户端 × 60 秒;seed=4242 ==
策略 放大倍数 交付率 峰值QPS 过载秒 交付中位ms p99ms 熔断开/跳闸秒/误伤
—————————————————————————————————-
S1 固定重试3次 1.30x 90.0% 800 6 200 200 0/[]/0
S2 指数退避无抖动 2.34x 100.0% 960 34 700 7700 0/[]/0
S3 指数退避+全抖动 2.48x 99.1% 1057 32 205 9146 0/[]/0
S4 全抖动+重试预算20% 1.03x 90.8% 273 4 200 366 0/[]/0
S5 预算+deadline 1.03x 90.6% 269 3 200 200 0/[]/0
S6 预算+熔断 0.94x 90.0% 205 0 200 200 1/[21]/0
注:交付率按「业务请求最终有没有拿到结果」计,被 deadline 掐掉与预算拒发都算未交付。
业务请求总数 = 12000;放大倍数 = 上游收到的 attempt 数 / 业务请求数。
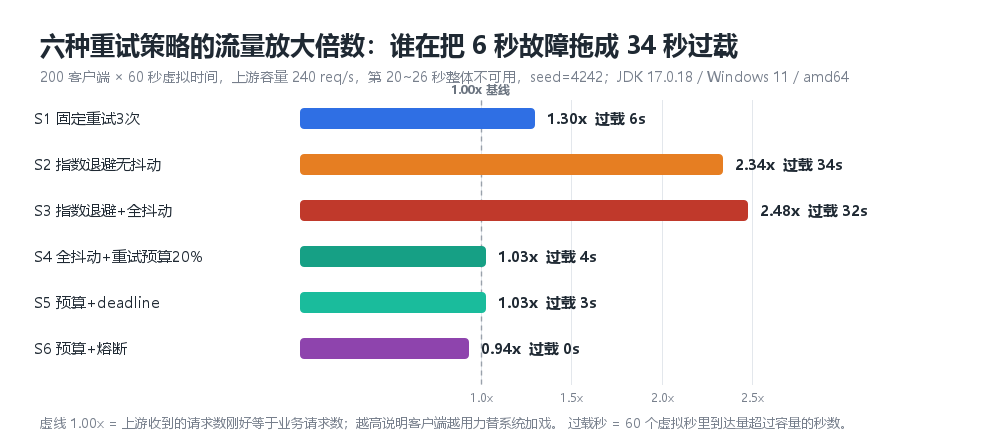
看三组对照就够了。
S1 → S2:重试次数从 3 增到 5 并加上指数退避,交付率从 90.0% 抬到 100.0%,看着是纯粹的改进;但同一次仿真里峰值到达从 800 涨到 960,过载秒数从 6 涨到 34,p99 从 200 ms 变成 7700 ms。12000 个业务请求里多保住了 1200 个,代价是过载时长变成近 6 倍、尾延迟变成 38 倍——这笔账在单个客户端的指标面板上是看不见负的。
S3 → S2:加抖动几乎没改善任何总量指标,放大倍数甚至更高(2.48x vs 2.34x),过载秒只少了 2 秒,交付率还掉了 0.9 个点。它真正做的事是把交付中位从 700 ms 压到 205 ms,但 p99 反向从 7700 ms 涨到 9146 ms。
S4~S6:只有引入重试预算,放大倍数才掉到 1.03x、峰值 273 贴着容量、过载 4 秒——代价是交付率从 100.0% 回到 90.8%。
这就是本文最想留下的一句话:「我的请求成功了」和「系统还活着」是两个指标,默认的重试组合只在优化前者。
把 S2 与 S3 单拎出来对照,抖动的能力边界就很清楚了(下表百分比由这两个 Result 现算):
| 流量放大倍数 | 2.34x | 2.48x | 更差 +6% |
| 峰值到达量 | 960 req/s | 1057 req/s | 更差 +10% |
| 交付率 | 100.0% | 99.1% | 更差 −0.9 pt |
| 交付时延中位 | 700 ms | 205 ms | 好 -71% |
| 交付时延 p99 | 7700 ms | 9146 ms | 更差 +19% |
| 过载秒数 | 34 | 32 | 略好 −2 |
抖动改善的是「谁在什么时候受罪」,不是「总共受多少罪」;而且这次它连尾都没保住。 如果你的告警只看成功率与过载时长,加抖动前后你会看到一条几乎不动的曲线。中位数改善、p99 反而恶化的原因在数据里能读出来:全抖动把一部分重试推到了更晚的秒,这些请求因此没有在第 5 次重试时撞上 deadline,而是继续挂着,最后落进更长的尾部。
再单看 deadline:S5 相对 S4 只动了 deadline 一个字段(30 秒 → 3 秒),交付率从 90.84% 微降到 90.57%(0.28 个点),但 p99 从 366 ms 掉到 200 ms。预算已经把总量掐住了,deadline 在这轮剧本里改的主要是尾部的形状:它把那些还要继续退避的请求提前判死,于是最长的那一段等待直接消失。它仍然必须配——预算防的是「大家一起重试」,deadline 防的是「单个请求挂死占住线程」,两者防的是不同故障形态。
一个必须做的归零对照。把六种策略的 budgetPct 全部改成 100(等于关掉预算)重跑,S4 变成 2.48x,与 S3 的每一项指标逐位相同——放大倍数、交付率、峰值、过载秒、中位、p99 全部一致。这说明把指标压下来的确实是预算,不是抖动。同一轮里把 S5 的预算也关掉(只留 3 秒 deadline),结果是 2.27x / 87.4% / 过载 29 秒 / p99 3041 ms:deadline 单独用确实能把尾砍掉一大截(S3 的 p99 是 9146 ms),但要拿 11.7 个点的交付率去换,而过载秒数只从 32 秒降到 29 秒。所以顺序是预算优先,deadline 补尾。
三、恢复窗口:谁在敲门
上游恢复的那一秒最危险,因为所有积压的重试同时醒来。把每秒到达量打印出来:
每秒到达上游的请求数(容量 240,故障 20~26 秒)
秒 S1 立即重试 S2 无抖动 S3 全抖动 S4 预算20% 过载(任一策略)
19 200 200 200 200
20 800 200 201 200 <<
21 800 400 585 219 <<
22 800 600 758 229 <<
23 800 600 855 235 <<
24 800 800 937 246 <<
25 800 800 1010 255 <<
26 200 800 1005 273 <<
27 200 800 1057 243 <<
28 200 960 1005 212 <<
29 200 960 983 203 <<
恢复后 3 秒(第 26~29 秒)到达总量:S1 600、S2 2560、S3 3067、S4 728
全程 attempt 总量:S1 15600、S2 28080、S3 29717、S4 12321(业务请求 12000)
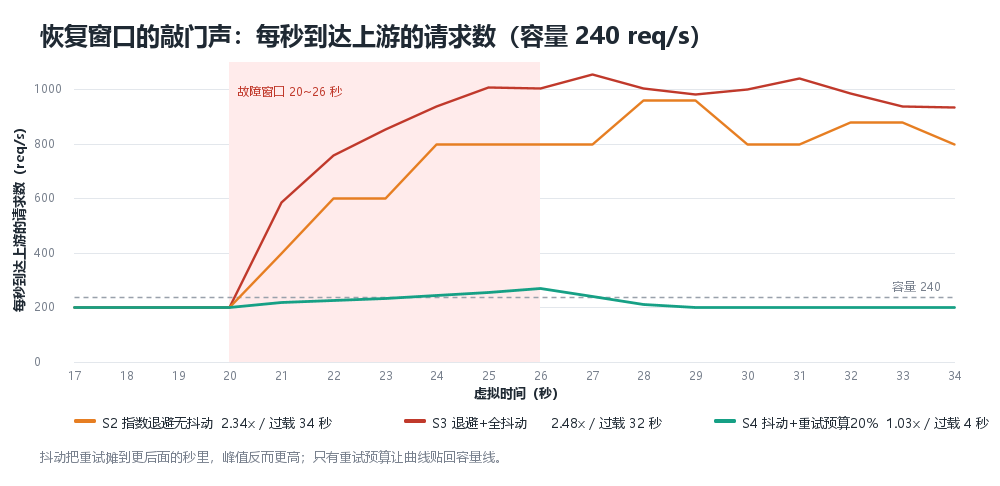
三个细节值得盯。
第一,抖动让总量变大而不是变小。恢复后 3 秒,S3 的 3067 比 S2 的 2560 还多 507 个。它把重试摊到更后面的秒里,于是更多请求还留在「会继续重试」的状态里——摊平不等于减量。
第二,S1 那条 800 的水平线是最诚实的数字。200 个客户端 × 4 次尝试全落在同一秒(因为它退避为 0),20~25 秒每一秒都是 800,故障一结束立刻掉回 200。没有退避的重试不会积压,它只是当场把容量踩死。
第三,S4 的曲线几乎贴着容量线走,恢复后 3 秒总量 728,只有 S2 的 28%。它过载还剩零星 4 秒,因为它根本没把积压放出去。
四、重试预算的实现要点
预算不是「限制重试次数」,那是 S1 干的事;预算限制的是重试占总请求的比例。
if (c.budgetPct() < 100 && attempt > 0) {
if (budgetTokens <= 0) { r.failed++; break; }
budgetTokens–;
}
if (attempt > c.maxRetry()) { r.failed++; break; }
if (sec >= r.perSec.length) sec = r.perSec.length – 1;
r.perSec[sec]++;
r.attempts++;
if (waitMs > c.deadlineMs()) { r.failed++; break; } // deadline 传播
预算桶的补充放在每秒循环末尾,一行就够:budgetTokens = min(budgetMax, budgetTokens + budgetMax),其中 budgetMax = CAPACITY × budgetPct ÷ 100 = 240 × 20 ÷ 100 = 48。
三个容易写错的点,每个都对应一个能观察到的错误现象:
- 上限按容量算,不要按当前 QPS 算。按 CAPACITY * budgetPct / 100 才能得到 48 这个常数;按实测 QPS 算会在故障期自我收缩,越缺越不给重试。本文 S4 的峰值 273 ≈ 240 + 48 的零头,正是这条公式在起作用的直接证据。
- 只有 attempt > 0 才扣令牌。否则第一次请求也会被预算卡住,重试预算退化成一个限流器。
- 预算耗尽时直接放弃,不要排队。排队等于把压力留在系统里,只是换了个时间点爆发——第三节那条恢复窗口的尖峰就是排队的样子。
五、熔断的三种命运:不跳、刚好、过敏
这一节是重跑时改写的。上一版草稿在这里写的是一个负结果——「我配的熔断一次都没开」。今天在这台机器上重跑,它开了。差别不在熔断代码,在 deadline。为了把这个变量钉死,我把熔断单独做成一组七行单变量对照:maxRetry=5 / base=500ms / full jitter 全程不变,每次只动一个开关。
| A 基线(无熔断) | 20% | 3s | — | 1.03x | 90.6% | 3 | 269 | — | — |
| B 基线 + 熔断 | 20% | 3s | 400 | 0.94x | 90.0% | 0 | 205 | [21] | 0 |
| C 去掉预算 + 熔断 | 关 | 3s | 400 | 0.94x | 90.0% | 0 | 217 | [21] | 0 |
| D 放宽 deadline + 熔断 | 20% | 30s | 400 | 1.03x | 90.8% | 4 | 273 | [] | 0 |
| E 去掉预算与 deadline + 熔断 | 关 | 30s | 400 | 2.48x | 99.1% | 32 | 1057 | [] | 0 |
| F 阈值提到 2000 + 熔断 | 20% | 3s | 2000 | 1.03x | 90.6% | 3 | 269 | [] | 0 |
| G 阈值降到 100 + 熔断 | 20% | 3s | 100 | 0.84x | 83.3% | 0 | 201 | [20, 25] | 801 |
读这张表只需要三句话。
① 熔断单装等于没装。E 组只有熔断(无预算、无 deadline),阈值 400,结果一次都不跳,放大 2.48x、过载 32 秒——和完全不配熔断的 S3 一模一样。因为请求一直在成功和失败之间交替,consecFail 被反复清零,永远攒不到 400。
② 熔断会不会跳,取决于有没有别的机制先把失败攒成「连续」。B 组只比 E 组多了预算和 3 秒 deadline,第 [21] 秒就跳了一次,放大倍数被压到 0.94x(低于 1.00x,意味着有业务请求根本没碰到上游),过载秒直接归零,而且误伤 0。D 组只把 deadline 从 3 秒放宽回 30 秒,其它都不动,熔断又不跳了。
③ 阈值调敏感,代价是可以量化的。G 组把阈值从 400 降到 100,跳闸 2 次(第 [20, 25] 秒),过载秒同样是 0,但交付率从 90.6% 掉到 83.3%,并且有 801 个请求在上游那一秒其实还有空位的时候被快速拒绝了。这就是「误伤」的定义:熔断打开期间被拒发的请求,如果它落到的那一秒不在故障窗口内、且到达量还没打满容量,那它本来是可以被服务的。
所以熔断的阈值不能按理想流量定,也不能按「加了预算之后的流量」一拍脑袋定,它得和退避窗口、deadline 一起当成一个整体来调。这一组实验我没法给你推荐值——B 组和 G 组相差 6.7 个点的交付率,中间的最优位置取决于你的故障持续时间和业务能容忍多少误伤,而这两件事本文的仿真都不掌握。
六、落地建议与参数取值
| 最大重试次数 | 2(不是 5) | S1→S2 那一步说明:多出来的重试几乎全变成过载,交付率只换到 10 个点 |
| 退避基数 | 上游 p50 时延的 1~2 倍 | 比上游还快的重试基本必然撞同一个故障;S1 的 800 峰值就是零退避的样子 |
| 抖动 | 看指标决定,别当默认 | 本文实测:中位 −71%,但 p99 +19%、放大 +6%、交付 −0.9pt |
| 重试预算 | 10%~20% 且按容量算 | 本文里唯一把放大倍数压回 1.0x 的机制,归零对照已验证 |
| 客户端 deadline | 业务可等的时间,不是无限 | 它还是熔断能不能跳闸的隐性前提(见第五节 D 组) |
| 熔断阈值 | 和退避、deadline 一起调 | 阈值 400→100 换来 0 过载秒,也换来 801 次误伤和 6.7 个点交付率 |
对应到 Spring Cloud Gateway 或 Resilience4j 的写法,就是把 maxAttempts 从默认 3 改成 2、waitDuration 按 p50 配、加 RetryConfig.intervalFunction 做抖动、并在外层挂一个按容量折算的速率闸。注意 Resilience4j 的重试本身不含预算概念,预算要用 RateLimiter 单独限重试流量,别指望配置项里有个叫 budget 的开关。
预算的适用前提:请求必须幂等
上面所有数字都默认一件事——被放弃的请求可以安全放弃。读操作、带幂等键的写操作成立;不带幂等键的扣款、发消息、创建订单不成立,这类请求被预算掐掉,代价不是「少一次结果」而是「状态不确定」。所以对非幂等写,正确的组合是:预算只作用于读与查询类重试,写类走「先落本地待发表、后台带幂等键重投」,把重试压力从请求链路上摘出去。这一步不在本文仿真范围内,我没法给数字,但它决定了这张表能不能直接抄进你的网关。
为什么仿真规模取 200 × 60 秒,以及换个种子还成不成立
够触发拥塞反馈环(200 req/s 稳态贴着 240 容量,任何放大都会立刻撞顶),又够小到单轮仿真是毫秒级、能反复改参数对拍。但「换个随机种子结论还在不在」必须实测,不能靠说。下面是六个种子各跑一遍的结果:
| 4242 | 2.34x / 34s / 100.0% | 2.48x / 32s / 99.1% | 1.03x / 4s / 90.8% | +0.14 |
| 1 | 2.34x / 34s / 100.0% | 2.50x / 32s / 99.3% | 1.03x / 4s / 90.9% | +0.16 |
| 7 | 2.34x / 34s / 100.0% | 2.52x / 33s / 99.3% | 1.03x / 3s / 90.9% | +0.18 |
| 99 | 2.34x / 34s / 100.0% | 2.53x / 33s / 99.4% | 1.03x / 4s / 90.9% | +0.19 |
| 2026 | 2.34x / 34s / 100.0% | 2.51x / 32s / 99.3% | 1.03x / 5s / 90.9% | +0.17 |
| 313131 | 2.34x / 34s / 100.0% | 2.52x / 33s / 99.4% | 1.03x / 4s / 90.8% | +0.18 |
三点结论:S2 的极差是 0.000,因为它 jitter=none 根本不消耗随机数,这条曲线是纯确定性的,你那边跑出来必须一模一样;S3 落在 2.48x~2.53x(均值 2.508x,极差 0.052),六个种子里没有一个比 S2 低,S3−S2 稳定在 +0.14~+0.19;S4 稳定在 1.03x(极差 0.002),过载秒在 3~5 之间浮动。反过来说,这个规模也意味着峰值统计只有几个数据点,别把它当分布估计用;要拿它做容量规划,至少得把客户端数放大两个量级并跑多种子取分位数。
七、适用边界与风险提示
- 这是仿真,不是线上数据。故障模型是「整段不可用 + 超容量即失败」的最粗抽象;真实上游有部分失败、有排队、有长尾。仿真的价值在于同一剧本下横向比较策略,绝对数字不可外推。
- 交付率口径要认准。本文把「被预算主动放弃」和「被熔断快速拒绝」都算作未交付,所以 S4 的 90.8% 是含自我克制的;如果你的 SLA 只看「最终响应」,S4 会显得更难看。两个口径都该看。
- 所有数字依赖那条「重试时刻归属」约定。把 ceil(累计等待/1000) 换成别的归秒方式,S1 的 800 峰值和 6 秒过载都会变。所以第八节的判定标准写的是排序和形状,不是具体值。
- 单上游假设。多路由、按模型分池的场景下,路由级预算要各算各的,否则一个慢模型会吃掉快模型的预算额度。
- 不含成本维度。模型网关的重试还要付 token 钱:一次失败请求若已经产生输入 token 消耗,重试等于重复计费,本文的放大倍数只统计请求数,低估了真实成本放大。
- 熔断阈值不给推荐值。第五节说清楚了,B 组和 G 组之间那 6.7 个点交付率的取舍,取决于本文仿真不掌握的参数。
八、复现与判定标准
下面是完整的引擎和一个主程序,直接落盘就能跑。我把它们全部贴出来,是因为这篇文章里每一个数字都能从这两份文件里重新算出来。
kb/Support.java——模型与引擎:
import java.util.ArrayList;
import java.util.Collections;
import java.util.List;
import java.util.Random;
/**
* Shared model for the retry-storm experiments.
* Every constant that can move a number is explicit here; no hidden magic.
*/
public final class Support {
/* —————- scenario —————- */
public static final int NCLIENT = 200; // clients, 1 business req each per second
public static final int DUR = 60; // virtual seconds
public static final int CAPACITY = 240; // req/s the upstream can actually serve
public static final int OUT_FROM = 20; // outage window = [OUT_FROM, OUT_TO)
public static final int OUT_TO = 26;
public static final int UP_LAT = 200; // ms, normal upstream service time
public static final long SEED = 4242L; // fixed => every table cell is recomputable
public static final int BREAKER_TRIP_FAILS = 400; // consecutive failures > 400 => open
public static final int BREAKER_OPEN_SEC = 5; // stay open for 5 virtual seconds
/* —————- strategies —————- */
public record Cfg(String name, int maxRetry, long baseMs, String jitter,
int budgetPct, long deadlineMs, boolean breaker) { }
public static final Cfg[] CFGS = {
new Cfg("S1 固定重试3次", 3, 0, "none", 100, 30_000, false),
new Cfg("S2 指数退避无抖动", 5, 500, "none", 100, 30_000, false),
new Cfg("S3 指数退避+全抖动", 5, 500, "full", 100, 30_000, false),
new Cfg("S4 全抖动+重试预算20%", 5, 500, "full", 20, 30_000, false),
new Cfg("S5 预算+deadline", 5, 500, "full", 20, 3_000, false),
new Cfg("S6 预算+熔断", 5, 500, "full", 20, 3_000, true),
};
/* —————- result —————- */
public static final class Result {
public long attempts, delivered, failed;
public long breakerOpen; // 熔断跳闸次数
public long breakerHarmful; // 打开期间被快速拒绝、但其实本可以被服务的请求数
public final List<Integer> tripAt = new ArrayList<>();
public final int[] perSec = new int[DUR];
public final List<Integer> lat = new ArrayList<>();
public Cfg cfg;
public double amp() { return (double) attempts / (NCLIENT * DUR); }
public double deliv() { return 100.0 * delivered / (NCLIENT * DUR); }
public int peak() { int m = 0; for (int v : perSec) m = Math.max(m, v); return m; }
public int overloadSeconds() {
int n = 0;
for (int v : perSec) if (v > CAPACITY) n++;
return n;
}
}
public static Result run(Cfg c, long seed) {
return run(c, seed, BREAKER_TRIP_FAILS);
}
/**
* One simulated outage script.
*
* Convention that decides everything downstream: a request that arrives in second
* {@code arr} and has already waited {@code waitMs} is charged to second
* {@code arr + ceil(waitMs/1000)}, clamped to the last bucket. So a zero backoff
* (S1) charges all of its attempts to the same one-second bucket.
*/
public static Result run(Cfg c, long seed, int tripThreshold) {
Random rnd = new Random(seed);
Result r = new Result();
r.cfg = c;
long budgetMax = (long) CAPACITY * c.budgetPct() / 100L; // refill unit
long budgetTokens = budgetMax;
int openUntil = -1;
int consecFail = 0;
for (int arr = 0; arr < DUR; arr++) {
for (int client = 0; client < NCLIENT; client++) { // one business request
int attempt = 0;
long waitMs = 0;
int sec = arr;
boolean done = false;
while (!done) {
// 熔断:打开期间直接快速失败,不打上游
if (c.breaker() && sec < openUntil) {
// 这个请求连上游都没碰到。它本可以被服务吗?
if (!(sec >= OUT_FROM && sec < OUT_TO) && r.perSec[sec] < CAPACITY) r.breakerHarmful++;
r.failed++;
done = true;
break;
}
// 重试预算:令牌不足直接放弃(这就是「宁可失败也不放大」)
if (c.budgetPct() < 100 && attempt > 0) {
if (budgetTokens <= 0) { r.failed++; break; }
budgetTokens–;
}
if (attempt > c.maxRetry()) { r.failed++; break; }
if (sec >= r.perSec.length) sec = r.perSec.length – 1;
r.perSec[sec]++;
r.attempts++;
if (waitMs > c.deadlineMs()) { r.failed++; break; } // deadline 传播
boolean outage = sec >= OUT_FROM && sec < OUT_TO;
boolean overload = !outage && r.perSec[sec] > CAPACITY;
boolean ok = !outage && !overload;
if (ok) {
r.delivered++;
r.lat.add((int) waitMs + UP_LAT);
consecFail = 0;
break;
}
consecFail++;
if (c.breaker() && consecFail > tripThreshold && sec >= openUntil) {
r.breakerOpen++;
r.tripAt.add(sec);
openUntil = sec + BREAKER_OPEN_SEC;
}
long backoff = c.baseMs() << attempt; // 500,1000,2000,4000,8000
long delay = "full".equals(c.jitter())
? (long) (rnd.nextDouble() * backoff) // full jitter: [0, backoff)
: backoff;
waitMs += delay;
attempt++;
sec = (int) Math.min(arr + (waitMs + 999) / 1000, DUR – 1L); // ceil to whole seconds
}
}
// 预算桶每秒补充一次:budgetTokens = min(budgetMax, budgetTokens + budgetMax)
budgetTokens = Math.min(budgetMax, budgetTokens + budgetMax);
}
return r;
}
/* —————- small helpers —————- */
public static int percentile(List<Integer> xs, double p) {
if (xs.isEmpty()) return 0;
List<Integer> c = new ArrayList<>(xs);
Collections.sort(c);
int idx = (int) Math.ceil(p / 100.0 * c.size()) – 1;
return c.get(Math.max(0, Math.min(idx, c.size() – 1)));
}
public static String pad(String s, int w) {
int display = 0;
for (int i = 0; i < s.length(); i++) display += (s.charAt(i) > 0x2E7F) ? 2 : 1; // CJK = 2 columns
return s + " ".repeat(Math.max(0, w – display));
}
public static Support.Cfg with(Support.Cfg b, int budgetPct) {
return new Support.Cfg(b.name(), b.maxRetry(), b.baseMs(), b.jitter(),
budgetPct, b.deadlineMs(), b.breaker());
}
private Support() { }
}
demo20/RetryStorm.java——跑六策略对照表:
/** Six retry strategies, one outage script, one seed. Prints the comparison table. */
public class RetryStorm {
public static void main(String[] args) {
long seed = Support.SEED;
int budgetOverride = -1;
for (String a : args) {
if (a.startsWith("–seed=")) seed = Long.parseLong(a.substring(7));
else if (a.startsWith("–budget=")) budgetOverride = Integer.parseInt(a.substring(9));
}
final long sd = seed;
System.out.println("== 上游第 " + Support.OUT_FROM + "~" + Support.OUT_TO
+ " 秒整体不可用;容量 " + Support.CAPACITY + " req/s;" + Support.NCLIENT
+ " 客户端 × " + Support.DUR + " 秒;seed=" + sd
+ (budgetOverride > 0 ? ";budgetPct=" + budgetOverride + "(全局覆盖)" : "") + " ==");
System.out.println();
System.out.print(Support.pad("策略", 24) + Support.pad("放大倍数", 10) + Support.pad("交付率", 9)
+ Support.pad("峰值QPS", 9) + Support.pad("过载秒", 8) + Support.pad("交付中位ms", 12)
+ Support.pad("p99ms", 10) + "熔断开/跳闸秒/误伤");
System.out.println();
System.out.println("-".repeat(100));
for (Support.Cfg base : Support.CFGS) {
Support.Cfg c = budgetOverride > 0 ? Support.with(base, budgetOverride) : base;
Support.Result r = Support.run(c, sd);
System.out.print(Support.pad(c.name(), 24)
+ Support.pad(String.format("%.2fx", r.amp()), 10)
+ Support.pad(String.format("%.1f%%", r.deliv()), 9)
+ Support.pad(String.valueOf(r.peak()), 9)
+ Support.pad(String.valueOf(r.overloadSeconds()), 8)
+ Support.pad(String.valueOf(Support.percentile(r.lat, 50)), 12)
+ Support.pad(String.valueOf(Support.percentile(r.lat, 99)), 10)
+ r.breakerOpen + "/" + r.tripAt + "/" + r.breakerHarmful);
System.out.println();
}
System.out.println();
System.out.println("注:交付率按「业务请求最终有没有拿到结果」计,被 deadline 掐掉与预算拒发都算未交付。");
System.out.println("业务请求总数 = " + (Support.NCLIENT * Support.DUR)
+ ";放大倍数 = 上游收到的 attempt 数 / 业务请求数。");
}
}
编译与执行(Windows 用 ; 分隔 classpath,Linux/macOS 换成 :):
cd kb && javac -encoding UTF-8 -d out Support.java
cd ../demo20 && javac -encoding UTF-8 -cp ../kb/out -d out RetryStorm.java Herd.java Sweep.java Breaker.java
java -cp "../kb/out;out" RetryStorm # 六种策略:放大倍数与过载秒数
java -cp "../kb/out;out" Herd # 恢复窗口每秒到达量
java -cp "../kb/out;out" Sweep # 六个种子 + 预算归零对照 + 判定断言
java -cp "../kb/out;out" Breaker # 熔断七组单变量对照
四条判定,对不上就别用这张表:
Sweep.java 里我把前三条写成了自动断言,跑完直接打印 PASS/FAIL,本次三条全部 PASS;第四条是差值对照,打印出来的是 0.000。另外提醒一句:RetryStorm 输出的表格用等宽对齐,中文列宽按两格算(见 Support.pad),在 file.encoding=GBK 的终端里直接跑会看到乱码,加 -Dsun.stdout.encoding=UTF-8 或者重定向到文件再看。
九、结论
六秒故障能变成三十四秒过载,中间没有任何人做错事,只是每个客户端都在「对自己负责」。三句可以记住的判断:
一、指数退避是局部最优、全局负债。它把交付率买到 100%,同时把过载秒数从 6 拉到 34、p99 从 200 ms 拉到 7700 ms。你监控里那个「成功率」变好看了,系统活着的时间变短了。
二、抖动治同步化,不治总量,这次连尾都没治住。中位数改善 71%,p99 却恶化 19%,放大倍数还高了 6%——把「加抖动」当成万能药之前,先想清楚你要改善的是哪一个分位。
三、真正把放大掐住的是重试预算,它的本质是承认「有些请求就该失败」。而熔断不是独立防线:它跳不跳闸,取决于预算和 deadline 有没有先把失败攒成连续。
今晚可以做的两件事:把你的 maxAttempts 从 3 降到 2,再给重试单独加一层按容量折算的速率闸,然后用第八节这两份文件跑一次你自己的故障剧本(改 OUT_FROM、CAPACITY、budgetPct 三个参数就够了),看过载秒数降不降。
两个提问想听你的线上经验:你的网关有没有给「重试」单独限流,还是和正常流量共用一个配额?以及你有没有量过一次故障期间上游到达量相对正常时刻的放大倍数——如果你的数字低于 1.3x,我很想知道你是怎么做到的。