/* MD / 富文本中的 .toc(含博客园搬家等嵌套结构);.toc-box 在侧栏,不受影响 */
#content_views .toc,
/* 编辑器常在目录前后插入空 p(:empty 仍占 20px),一并去掉避免顶空隙 */
#content_views.markdown_views > p:empty:has(+ .toc),
#content_views.markdown_views > .toc + p:empty,
/* 富文本旧版目录标记 */
#content_views.htmledit_views #main-toc,
#content_views.htmledit_views #hr-toc,
#content_views.htmledit_views p[id*=\”-toc\”] {
display: none !important;
}
/* 目录去掉后,紧跟的首个标题不再多出一块上边距 */
#content_views.markdown_views > .toc + h1,
#content_views.markdown_views > .toc + h2,
#content_views.markdown_views > .toc + h3,
#content_views.markdown_views > .toc + h4,
#content_views.markdown_views > .toc + p:empty + h1,
#content_views.markdown_views > .toc + p:empty + h2,
#content_views.markdown_views > .toc + p:empty + h3,
#content_views.markdown_views > .toc + p:empty + h4 {
margin-top: 0 !important;
}
260 条同步链路背后的运维账:数据结构变更如何从"人工救火"走向"自动流转"
数据同步链路最大的敌人,往往不是数据量,而是结构变更。本文从工程运维的视角,算一算异构环境下 DDL 变更的人工成本账,并拆解金仓 KFS 的 DDL 自动转换能力如何把这项"只增不减"的运维工作变成系统能力。
一、从一个熟悉的场景说起
每个做过数据平台运维的人,大概都对这样的工作单不陌生:
业务系统要上新功能,需要给某张核心表加几个字段。变更评审通过,源端数据库顺利执行了 ALTER TABLE。然后,数据平台的告警来了——同步链路中断,目标端写入失败,报表停更,下游的分析任务排队等待数据。
于是值班工程师开始一套标准动作:定位中断原因,发现是源端结构变了;找到那条 DDL 的原文;逐字分析它在目标端应该怎么写——类型该换成什么、语法要怎么调整;在目标端手工执行;验证结构一致;恢复链路;观察 DML 是否正常续传。
整个过程顺利的话,几十分钟到几小时。不顺利的话——比如目标端执行出错,或者转换后的结构有偏差——排查和修复可能持续到深夜。
一条链路如此。那么,如果同时运行着 260+条链路呢?
二、项目背景:一个典型的多源异构汇聚环境
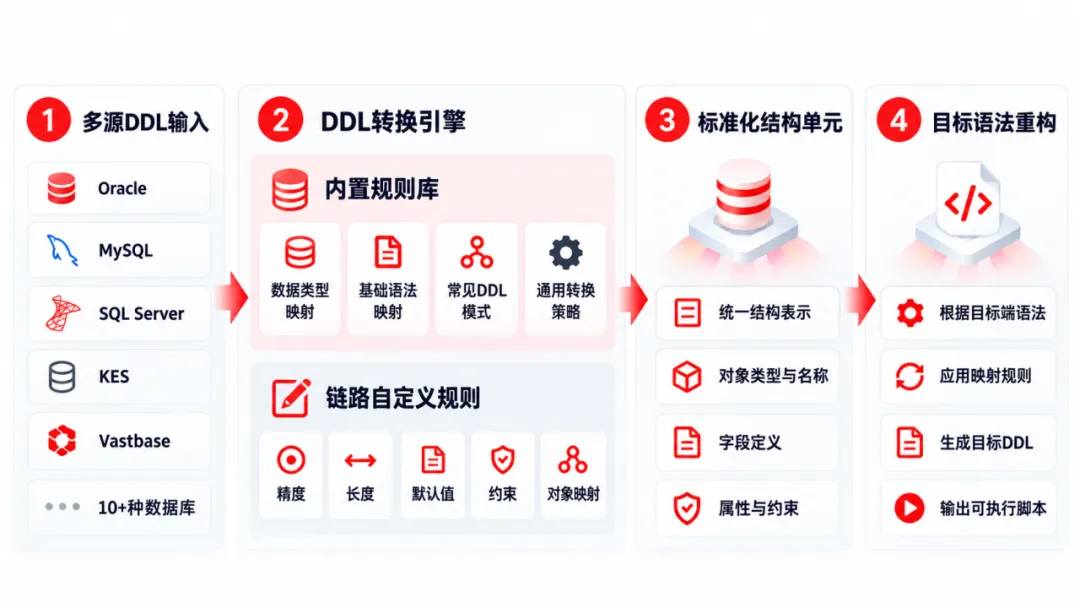
先看这个数字背后的环境。在某大型医院的数据同步项目中,260+条同步链路同时运行,源端涉及 Oracle、MySQL、SQL Server、KES V8R6、Vastbase 等 10 多种数据库,并持续向目标库汇聚数据。
这是非常典型的数据平台建设模式:医院内部几十个业务系统——挂号、HIS、检验、影像、财务、物资——各自独立建设,数据库选型五花八门,年代跨度从老牌商业库到国产新库。要形成全院统一的数据底座,就必须把这些系统的数据持续汇聚到一个目标库。
在这样的环境里,把数据同步过去并不难——DML 的捕获和回放,成熟的同步工具都能胜任。真正让链路"卡住"的,是业务系统里不断发生的结构变化:新增字段、改类型、调索引、加约束,它们都以 DDL(数据定义语言)的形式发生。
问题在于,结构变化不是一次性事件,而是常态。业务在迭代,系统在升级,字段在增减。源端结构一改,目标端还在老结构上,后续 DML 即使能捕获,也可能因为字段或类型对不上而写不进去。数据同步的水流,就这样被结构的断层截断了。
三、为什么人工处理撑不住:算一笔运维账
如果每次结构变化都要人工处理,成本由几部分构成:
第一笔:分析成本。 工程师要先看懂源端的 DDL 在做什么。这条账相对可控——SQL 大多能读懂。
第二笔:转换成本。 这是真正的大头。异构数据库的 DDL 很难一一对应:同样加一个字段,Oracle、MySQL、SQL Server 的数据类型、默认值和语法写法都可能不同。一条在源端跑得通的 ALTER TABLE,原样送到目标端很可能直接报错。工程师必须熟悉两端的方言差异,逐项对照:类型怎么映射、默认值怎么表达、约束怎么改写。每种数据库组合都是一套知识,10 多种源端数据库的组合空间相当可观。
第三笔:验证成本。 转换后的语句要在目标端执行,执行完还要确认结构真的和源端对齐了——字段个数、类型精度、约束状态,一项都不能错。
第四笔:恢复与观察成本。 链路恢复后,还要盯着 DML 是否按新结构正常续传,确认没有数据丢失。
单次成本 × 发生频率 × 链路数量 = 总成本。三 个乘数里,频率不会降(业务迭代不会停),链路数量不会减(数据底座只会越建越大),唯一能压的就是单次成本。
几条链路还能靠人扛。放到 260+条长期运行的链路里,这就是一项只增不减的运维工作——每一次业务侧的结构变化,都可能触发这套人工流程。更糟的是,这类工作高度依赖工程师的个人经验:熟悉两端方言的人处理得快,不熟悉的人处理得慢且容易出错。人力无法复制,经验无法沉淀,工作量却随链路数线性甚至超线性增长。
KFS 的 DDL 自动转换能力,就是用来解决这件事的:把这套人工流程,变成系统自动执行的流程。
四、机制拆解之一:先"拆"DDL,而不是直接改
很多 DDL 转换方案靠字符串替换或正则改 SQL。简单语句没问题,一遇到复杂 DDL,规则就会膨胀:一条 ALTER TABLE 可能同时改列 A 的类型、给列 B 加默认值、给列 C 加约束。继续按整条字符串处理,匹配条件只会越叠越多,规则之间还会打架。
从运维视角看,"规则膨胀"还有一层含义:规则库本身也成了需要人维护的资产。谁来更新规则、怎么测试新规则不影响旧语句、规则冲突了听谁的——每一条都是新增的运维负担。用一套需要人工维护的规则库,去替代原本的人工转换,只解决了一半问题。
KFS 的方案换了一个起点:先搞清楚这条 SQL 到底做了什么。
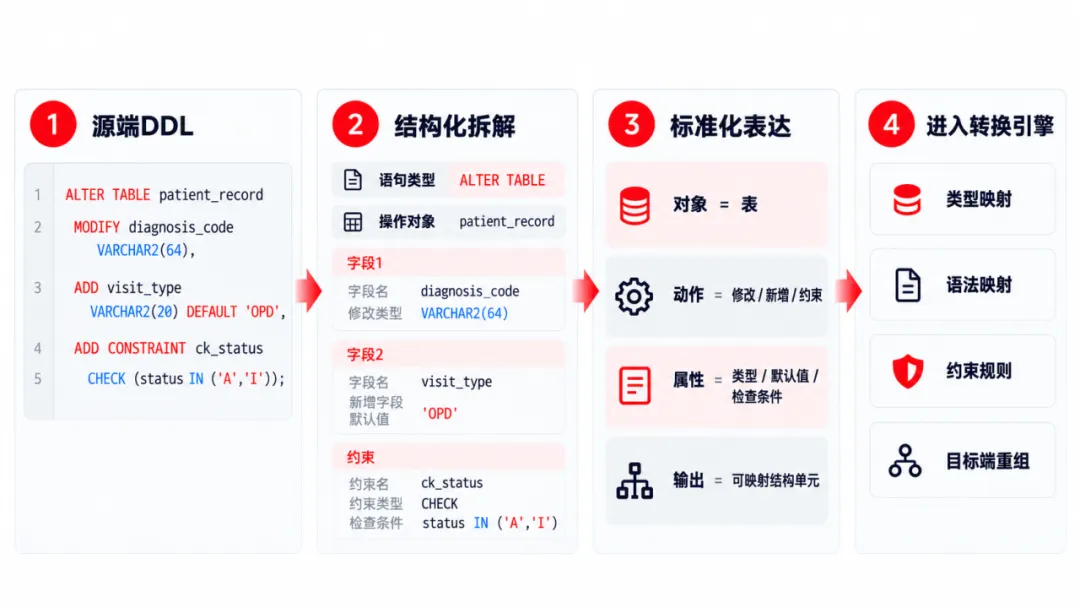
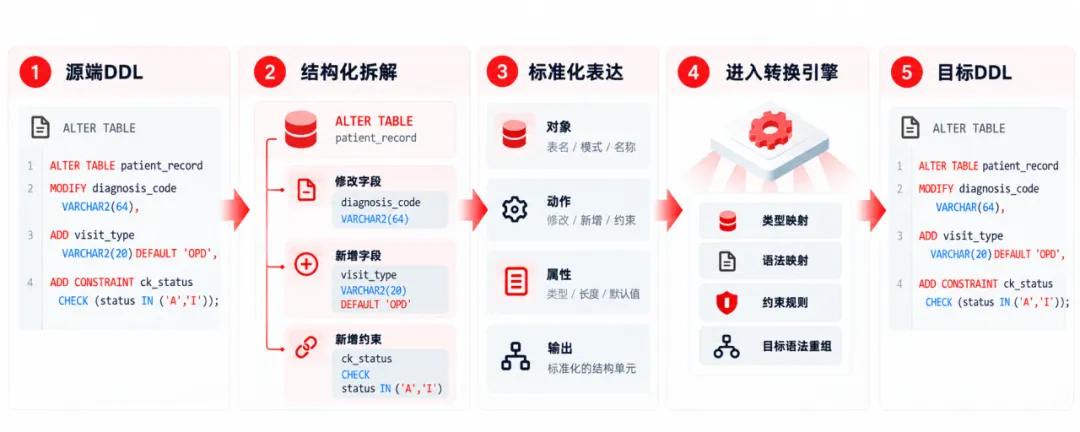
在源端增量解析过程中,KFS 会先判断这次变化属于 DML 还是 DDL。对 DDL,继续拆成更细的结构信息:DDL 类型、操作对象、涉及哪些字段、每个字段做了什么动作,以及对应的数据类型、默认值、约束。
以一条同时修改多个字段的 ALTER TABLE 为例,进入转换环节后,它被拆成"ALTER TABLE + 表对象 + 各字段操作"等多个结构化单元。
这一步的关键收益:后面所有处理,依据的都是这次结构到底变了什么,而不是这条 SQL 恰好是怎么写的。写法的多样性(子句顺序、引号习惯、注释穿插)在结构层面被归一化,处理逻辑面对的输入从"无穷的写法组合"收敛为"有限的结构单元组合"。规则不再随写法膨胀,这是可持续维护的前提。
五、机制拆解之二:差异沉淀为规则,通用与个性分层
拆解之后,转换的问题变成:源端的结构动作,在目标端如何表达?
数据库之间的差异,有一部分是稳定、反复出现的,比如数据类型如何对应、基础 DDL 语法如何表达。每个项目重配一遍就是重复劳动,所以 KFS 内置了数据类型映射和基础语法映射规则,自动适配。
但真实业务不会只有"标准写法":字段精度、长度、默认值、特殊约束、对象名称往往带着项目特征,通用规则覆盖不了。这部分是项目层面需要补充的规则。
这个分层在大规模链路下价值尤其明显:260+条链路连着不同业务系统,但其中大量 Oracle、MySQL、SQL Server 之间的类型和基础语法差异是重复的。把这些共性沉淀到产品里,就不必每条链路都从零配一遍。
落到运维账上,这一层相当于把"第二笔转换成本"里最重的公共部分抽走,摊薄到产品里由厂商维护;项目只承担真正属于自己的个性差异部分。
目前,KFS 已经覆盖建表、增删改字段、表与字段重命名、索引变更、约束增删及启停等常见结构变化。在项目典型 DDL 样本中,约 95% 的常规变化可以直接进入自动转换,只有少量带特殊默认值、复杂约束或业务定制逻辑的 DDL 需要人工补规则。
也就是说,在真实的医院项目样本里,每 20 条 DDL 里约 19 条不再需要人工介入,只剩 1 条需要补规则——工作量从"每条都过一遍"变成"偶发处理一下"。
六、机制拆解之三:按目标端语法重新生成,而非修改源语句
完成拆解和规则映射后,还有最关键的一步:把这些结构信息重新变成目标数据库真正能够执行的 DDL。
这也是 KFS 的方案与简单正则替换之间最大的区别。
正则转换始终在源 SQL 上做文章:删一段字符、换个关键词、改个类型。而 KFS 在拆解和映射之后,按目标库的语法结构,把操作对象、字段动作、数据类型和相关规则重新组织,生成目标库能直接执行的 DDL。
还是那条改三个字段的 ALTER TABLE:字段 A、B、C 的结构动作已经被识别出来,类型和规则也映射完成。这时不需要再猜"源 SQL 该改成什么样",只要按目标库支持的语法,把这些明确的操作单元重新组合成一条新的 ALTER TABLE 语句。
整个过程是一条清晰的流水线:
源端 DDL → 结构化解构 → 数据类型与语法映射 → 目标语法重构 → 生成目标 DDL
对运维团队来说,这种"生成而非改写"的路线意味着两件事:一是转换结果不依赖源语句的写法细节,可控性更强;二是当 DDL 越来越复杂、数据库类型不断增加时,扩展路径是往映射规则里加条目,而不是往正则库里叠补丁——前者是增量演进,后者是技术债累积。源端怎么写是一回事,目标端要求怎么表达是另一回事,中间靠结构信息和映射规则解耦,同一套机制才能适应更多异构场景。
七、机制拆解之四:生产环境的铁律——目标端执行成功才算完成
从运维视角看,这一节可能是整套机制里最重要的部分。
一条 SQL 看起来"翻译对了",不代表 DDL 同步就完成了。生产环境只有一个标准:目标库能不能执行。
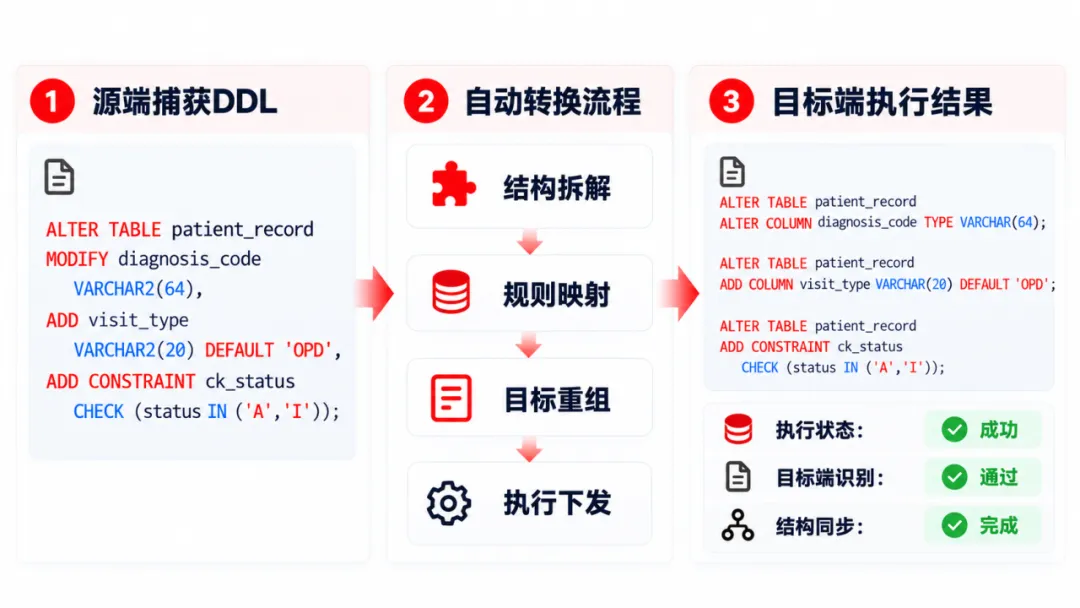
KFS 生成目标端 DDL 后会下发执行,并检测执行结果:
- 执行成功:结构变化同步完成,后续 DML 按新表结构继续写入,链路无感续传;
- 执行异常:捕获错误信息,进入处理流程。
对当前规则转不了的 DDL,KFS 不会硬凑一个不确定的结果,而是保留原始 DDL 并跳过。如果后续 DML 已经依赖这次没做完的结构变化,链路会中断并进入人工干预。
这个设计背后,是一个非常重要的生产判断:DDL 转换真正危险的,不是"转不了的语句"——那最多是链路停下来,问题立刻显性暴露;真正危险的是"转错但不自知的语句"被悄悄执行,目标端结构与源端出现偏差。结构偏差不像链路中断那样会立刻告警,它表现为后续数据的断续异常——某个字段一直写不进去、某类记录莫名缺失——排查时要把时间拨回到那条 DDL 执行的时刻,定位成本远高于一次显式中断。
所以 KFS 的处理原则非常明确:能够确定转换结果的,自动完成;无法确定的,及时暴露。
宁可让链路停下来等人,也不让一条没把握的 DDL 带着不确定性进入生产。这是自动化系统在生产行为上的自我约束——自动化不是"替人做所有事",而是"把有把握的事做完,把没把握的事交还给人,并且交还的时候说清楚原因"。
效果数据:在项目典型场景抽样验证中,经过自动转换的常规 DDL,目标端一次执行通过率可达到 98% 以上。
八、能力与效果速览
| 部署规模 | 260+条同步链路同时运行 |
| 源端数据库 | Oracle、MySQL、SQL Server、KES V8R6、Vastbase 等 10 多种 |
| 自动转换覆盖 | 建表、增删改字段、表与字段重命名、索引变更、约束增删及启停 |
| 常规 DDL 自动转换占比 | 项目典型 DDL 样本中约 95% 可直接进入自动转换 |
| 一次执行通过率 | 自动转换的常规 DDL 在目标端一次执行通过率 98% 以上 |
| 失败处理 | 保留原始 DDL 并跳过,必要时中断链路进入人工干预 |
九、规模化:一条链路是点,260 条链路是面
回到开头的运维账。KFS 做的事,是把原本依赖工程师经验的过程,拆成几个系统能够完成的步骤:
一条 DDL 自动走完这套流程,解决的是一次问题;260+条链路都具备这个能力,解决的才是规模化问题。
从账面看:自动转换覆盖约 95% 的常规变化,意味着大部分结构变更从"值班响应"降级为"日志里的一行记录";剩下约 5% 需要人工补规则的,也因为结构化拆解而把工作从"分析整条 SQL"简化为"补充具体差异项"。运维投入从随链路数线性增长,变成小常数 + 低频事件响应。
更重要的收益不在账面:经验沉淀进了产品规则,能力随链路数量自动复制,不依赖任何具体的人。数据平台的建设,也从"靠几个熟手工匠支撑"变成"有体系化能力托底"。
十、结语
数据平台运维里,最贵的从来不是机器,是人的时间和经验的不可复制性。结构变更的人工处理流程,恰好把这两样都占满了:每次都要花时间,每次都依赖经验,而链路越多、业务越活跃,这套流程被触发的频率就越高。
KFS 的 DDL 自动转换给出的答案,不是"更聪明的正则",而是换一个层次解决问题:把 DDL 从"一条待改写的字符串"变成"一组可拆解、可映射、可重构、可验证的结构信息",让系统在每一个环节都接得住。配合"能确定就自动、不能确定就暴露"的生产纪律,结构变更终于可以从人工救火走向自动流转。
对于链路以百计、数据底座要长期运营的组织来说,这大概就是"能跑"和"可运营"之间的差别。