/* MD / 富文本中的 .toc(含博客园搬家等嵌套结构);.toc-box 在侧栏,不受影响 */
#content_views .toc,
/* 编辑器常在目录前后插入空 p(:empty 仍占 20px),一并去掉避免顶空隙 */
#content_views.markdown_views > p:empty:has(+ .toc),
#content_views.markdown_views > .toc + p:empty,
/* 富文本旧版目录标记 */
#content_views.htmledit_views #main-toc,
#content_views.htmledit_views #hr-toc,
#content_views.htmledit_views p[id*=\”-toc\”] {
display: none !important;
}
/* 目录去掉后,紧跟的首个标题不再多出一块上边距 */
#content_views.markdown_views > .toc + h1,
#content_views.markdown_views > .toc + h2,
#content_views.markdown_views > .toc + h3,
#content_views.markdown_views > .toc + h4,
#content_views.markdown_views > .toc + p:empty + h1,
#content_views.markdown_views > .toc + p:empty + h2,
#content_views.markdown_views > .toc + p:empty + h3,
#content_views.markdown_views > .toc + p:empty + h4 {
margin-top: 0 !important;
}
从这份榜单,看国产大模型的真实位置
写在前面
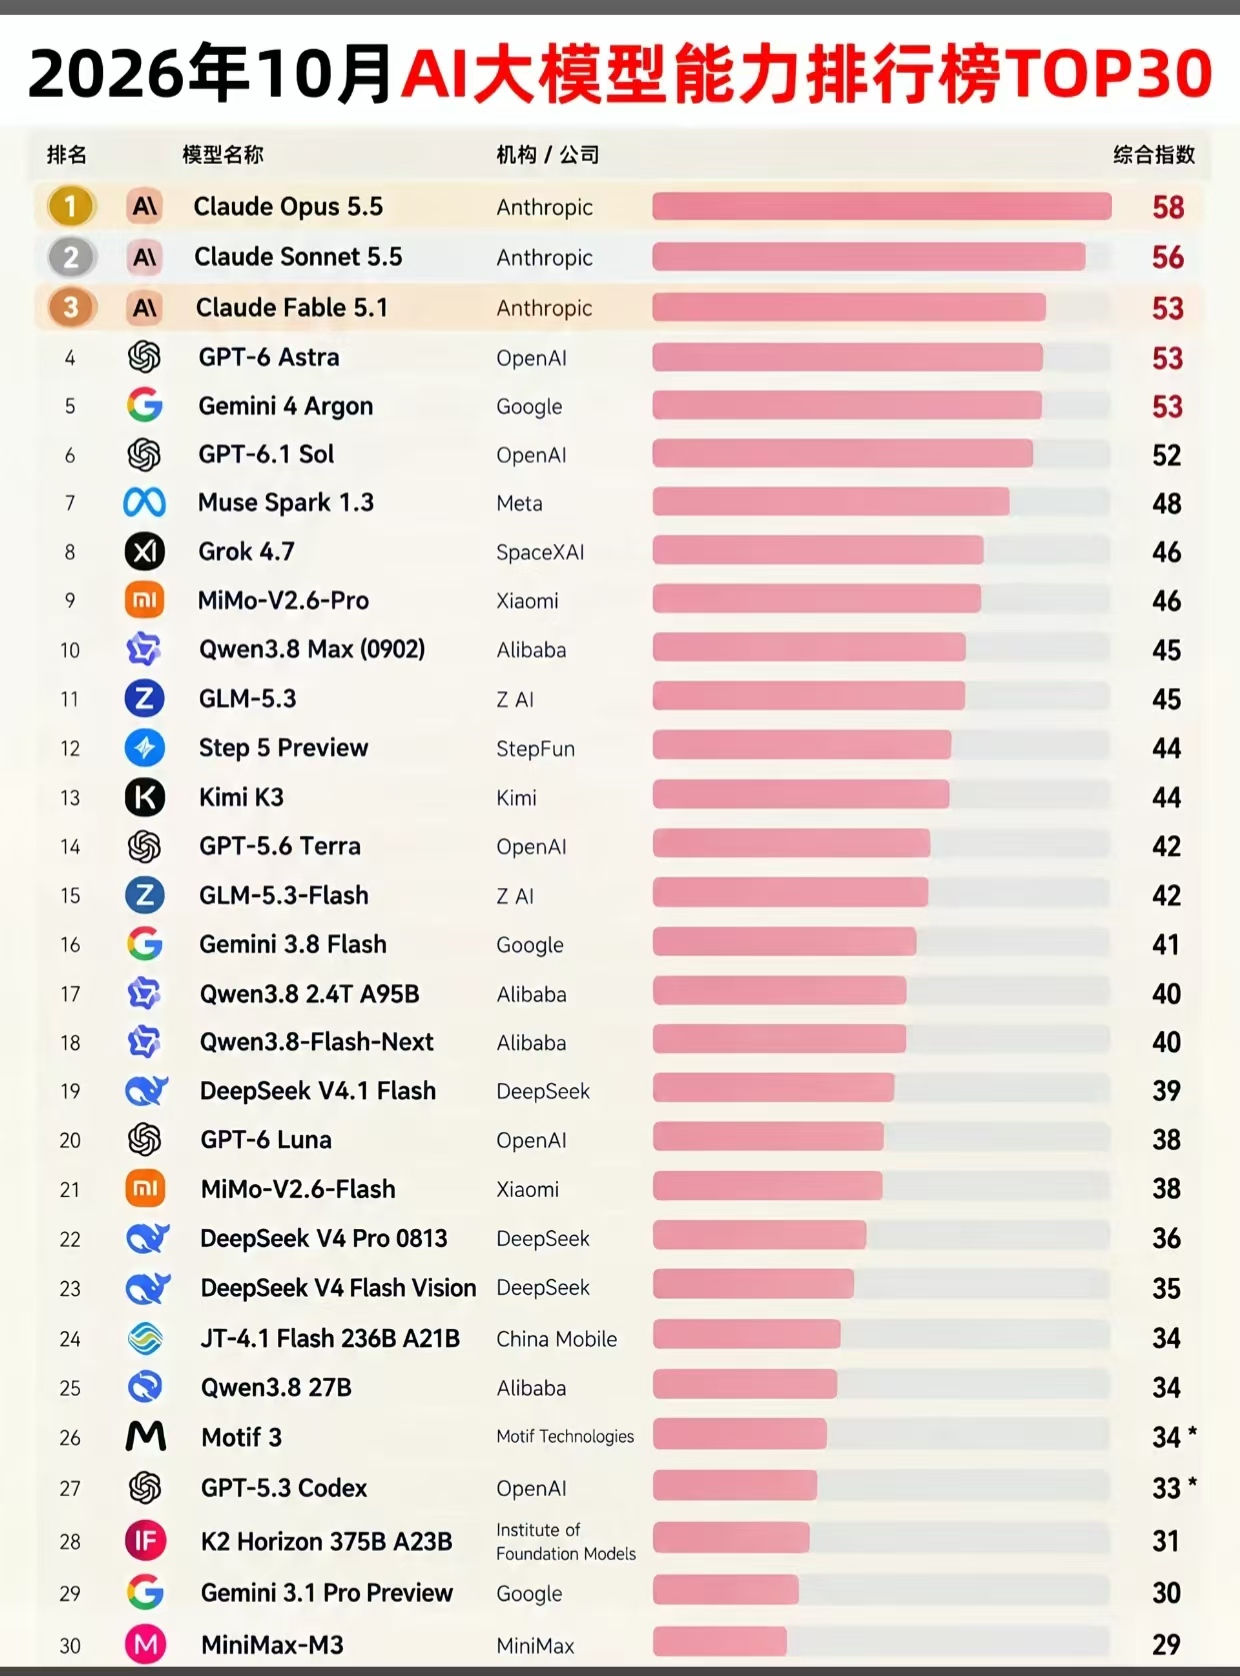
新一期的 AI 大模型能力榜出来了(2026 年 10 月 TOP30)
一、先把国产的全捞出来
榜单前 30 名里,我挑出了这些国产(或中国团队)的模型:
| 排名 | 模型 | 团队 | 综合指数 |
|:—😐——|——|:—😐
| 9 | MiMo-V2.6-Pro | 小米 | 46 |
| 10 | Qwen3.8 Max (0902) | 阿里 | 45 |
| 11 | GLM-5.3 | 智谱 | 45 |
| 12 | Step 5 Preview | 阶跃星辰 | 44 |
| 13 | Kimi K3 | 月之暗面 | 44 |
| 15 | GLM-5.3-Flash | 智谱 | 42 |
| 17 | Qwen3.8 2.4T A95B | 阿里 | 40 |
| 18 | Qwen3.8-Flash-Next | 阿里 | 40 |
| 19 | DeepSeek V4.1 Flash | DeepSeek | 39 |
| 21 | MiMo-V2.6-Flash | 小米 | 38 |
| 22 | DeepSeek V4 Pro 0813 | DeepSeek | 36 |
| 23 | DeepSeek V4 Flash Vision | DeepSeek | 35 |
| 24 | JT-4.1 Flash 236B A21B | 中国移动 | 34 |
| 25 | Qwen3.8 27B | 阿里 | 34 |
| 30 | MiniMax-M3 | MiniMax | 29 |
一共 15 个,正好占了 TOP30 的一半。
注:第 28 名的 K2 Horizon(Institute of Foundation Models)归属不明确,这里暂不计入。
二、几个值得说说的点
① 小米 MiMo 拿了国产最高分
第 9 名,46 分,是这份榜单里国产模型的最好成绩。做手机的小米,在模型榜上排到这个位置,说实话有点意外,也算是个小惊喜。
② 阿里 Qwen 是"全家桶"
Qwen 系列一口气上了 4 个(10 / 17 / 18 / 25),是上榜数量最多的国产团队。从 Max 到 Flash,再到大参数和小模型,高低配全覆盖,走的是"机海战术"。
③ DeepSeek 走"多形态"路线
上了 3 个:Flash、Pro,还有 Vision(视觉版)。看得出来,它想做的是覆盖不同场景的模型矩阵,而不是单点突破。
④ 参赛的人越来越多了
智谱 GLM 两个(11、15),Kimi K3 第 13,阶跃 Step 5 第 12,MiniMax-M3 第 30,连中国移动的 JT-4.1 都进了前 25。这个牌桌上,坐的人明显变多了。
三、但也别太乐观,差距是真实的
① 前三名,被 Claude 一家包圆
第 1、2、3 名全是 Anthropic 的 Claude(Opus 5.5 / Sonnet 5.5 / Fable 5.1)。第一梯队,没咱们什么事。
② 分差是实打实的
国产最高 46 分,榜首 58 分——差了 12 分。看着不多,但在这个榜单里,12 分已经差不多是从第 9 名掉到第 30 名的距离了。
③ 高端旗舰,还是有代差
你会注意到,国产模型大多挤在 36~46 这个"第二梯队"区间,而且不少是 Flash、小参数版本。真正能跟顶级旗舰正面掰手腕的"大杀器",目前还不多。
四、我的两点看法
把这两件事放一起看,信号其实挺清楚的:
-
好的一面:国产的"量"和"覆盖面"真的上来了,从旗舰到小模型、从文本到视觉,阵容越来越全;
-
现实的一面:最顶上那块招牌,暂时还是别人的。
我觉得既不用妄自菲薄,也别盲目乐观——半壁江山是真的,差一档也是真的。
而且对咱们普通用户来说,这反而是好事:选择更多了,价格也更有的卷了。
写在最后
榜单这东西,看看就好,不用太当真。
但有一点很清楚:国产大模型,早就不只是"陪跑"的角色了。
接下来就剩一个问题——什么时候,能把第一梯队的位置也抢过来一个?
任重而道远