📖标题:LoGRA: Scaling LLM Reinforcement Learning with Low-Rank Gradient Sketches 🌐来源:arXiv, 2610.06647v2
🛎️文章简介 🔸研究问题:大语言模型在强化学习微调时,梯度和优化器状态占用的显存远超模型权重本身,导致硬件门槛极高,如何在不牺牲性能的前提下显著降低这部分显存消耗? 🔸主要贡献:论文提出了LoGRA方法,通过低秩梯度草图压缩技术减少显存占用,并配合预测KL步长控制确保训练稳定,成功在单节点8卡上实现了27B参数模型的稳定强化学习训练。
📝重点思路 🔸低秩梯度草图机制:不存储完整的梯度矩阵,而是在反向传播过程中,利用随机投影矩阵将高维梯度直接累积为低秩的“草图”(Sketch)。更新权重时,再将低秩草图还原为近似的全量梯度进行合并,从而避免构建和存储巨大的全量梯度缓冲区。 🔸预测KL步长控制:为了防止压缩带来的更新误差或过大步长破坏已学策略,引入预测KL散度机制。在应用更新前,估算该更新对模型下一词概率分布的影响,若预估变化超过预设预算,则自动缩小更新步长,确保策略演进的平稳性。 🔸高效策略同步:由于更新被表示为紧凑的低秩矩阵,在强化学习的Rollout阶段同步策略时,只需传输极少量的数据而非全量权重或梯度,进一步降低了通信开销。
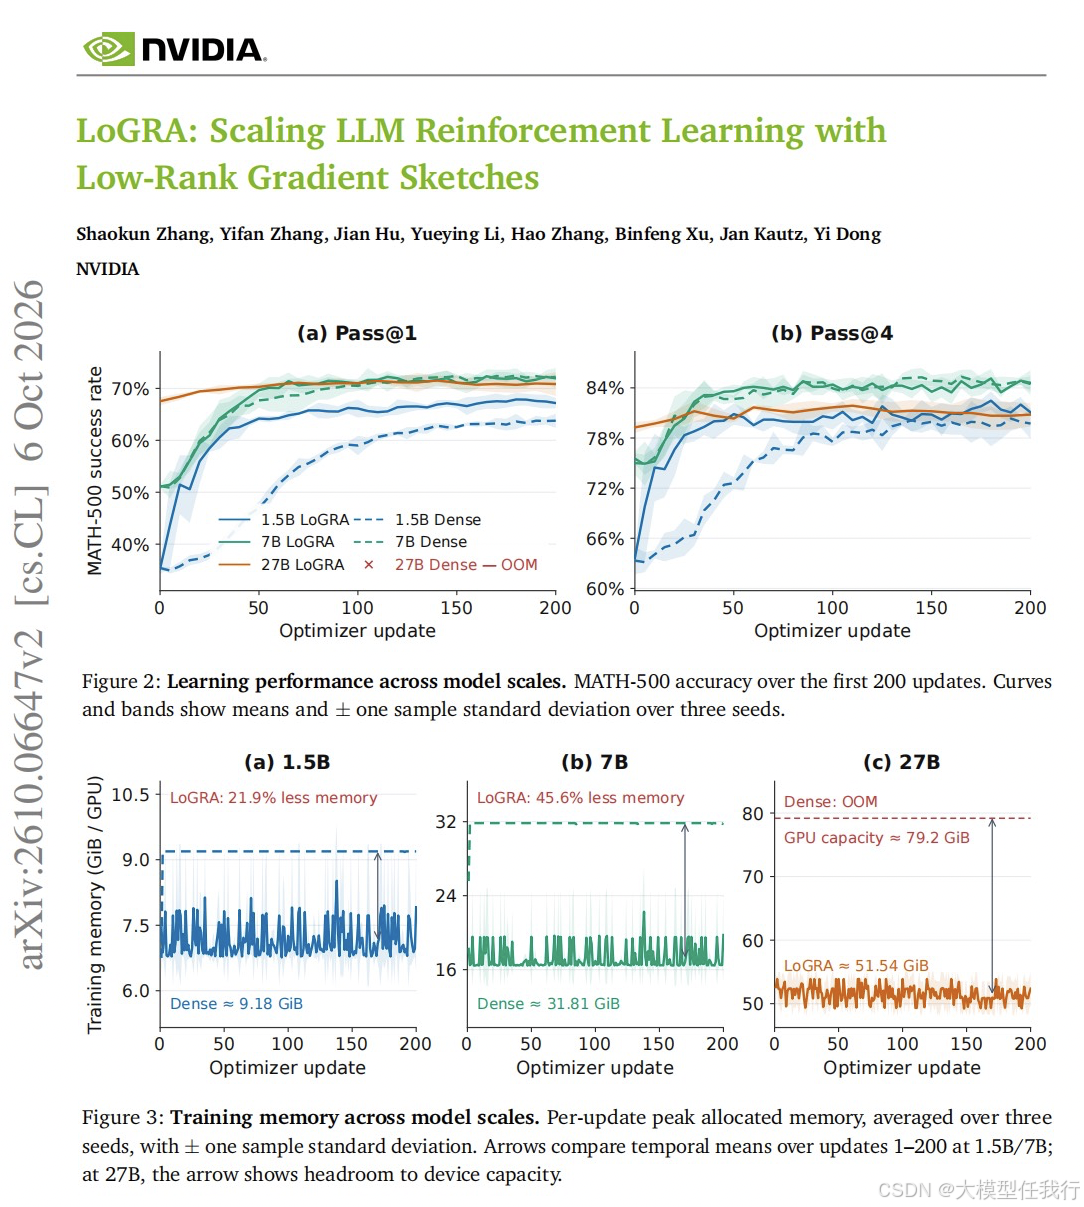
🔎分析总结 🔸显存大幅降低:在1.5B和7B模型上,LoGRA分别节省了21.8%和45.7%的平均训练显存。对于27B模型,传统Dense Adam方法因显存溢出无法运行,而LoGRA能在单节点8张H100 GPU上稳定训练超过1100步。 🔸性能无损甚至提升:在数学推理任务中,LoGRA在节省显存的同时保持了与全量梯度训练相当的准确率,甚至在1.5B模型上Pass@1指标略高于基线。 🔸长期训练稳定性:实验表明,配合保守的KL预算控制,LoGRA能支持长周期