目录
一、什么是 ReAct?
二、手撕 ReAct 核心代码
2.1 定义工具
2.2 模拟 LLM 决策
2.3 手撕 Agent Loop
2.4 运行一下
三、面试官可能会追问什么?
四、最后总结
Hello,大家好,我是 1M55!👋
今天打算开启一个新系列——「Agent 面试高频手撕代码」。
不同于传统的 LeetCode 算法题,这个系列主要分享 Agent 开发中一些值得掌握的核心实现,比如 ReAct、Function Calling、Multi-Agent、Memory 等。
每篇尽量先讲清楚原理,再用 Python 手写核心代码,不依赖 LangChain、LangGraph 等 Agent 框架。
希望能够帮助到正在准备 AI / Agent 开发面试的朋友,也欢迎大家一起交流!
第一篇,我们先从最经典的 ReAct 模式开始。
一、什么是 ReAct?
ReAct 全称 Reasoning and Acting(推理与行动),是一种让大模型交替进行推理、执行动作、观察结果,再决定下一步的模式。
举个简单的例子。
用户提问:
帮我计算 5 × 6,再把结果加上 10。
Agent 可以先决定调用乘法工具,拿到结果 30 后,再决定调用加法工具,最后给出答案 40。
整个过程可以概括为:
Thought(思考)→ Action(行动)→ Observation(观察)→ 下一轮决策。
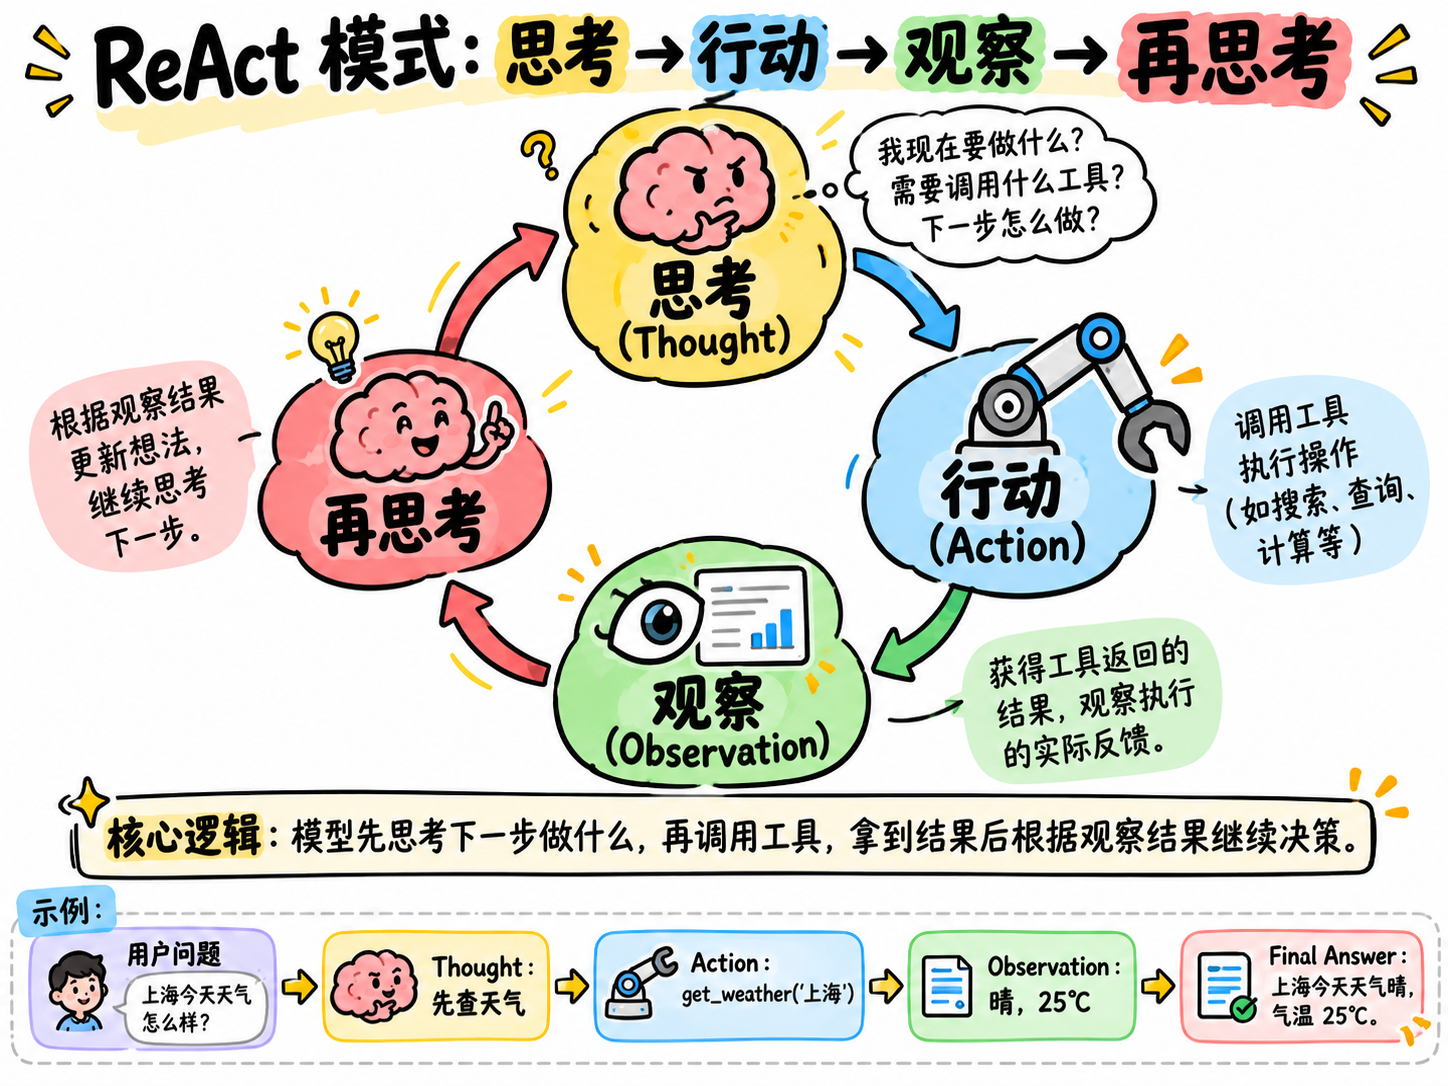
这三个阶段分别负责什么?
-
Thought(思考):模型结合用户问题和已有信息,判断下一步应该做什么。
-
Action(行动):模型决定调用哪个工具、传入什么参数,由程序真正执行。
-
Observation(观察):程序获取工具的执行结果,并反馈给模型,让模型继续决策。
如此循环,直到模型认为任务已经完成,输出 Final Answer。
这里需要注意:模型负责决策,Python 程序负责执行工具。
模型输出 add(30, 10),并不意味着它真的执行了 Python 函数。我们需要编写 Agent Runtime,根据模型的决策找到对应工具并执行。
另外,ReAct 不一定要显式输出完整的 Thought 文本。实际开发中,也可以通过结构化 Tool Calling 实现这样的决策与执行循环。
理解了这一点,我们就可以开始手撕了。
二、手撕 ReAct 核心代码
假设面试官给出题目:
不使用 LangChain 等框架,用 Python 实现一个简易 ReAct Agent,支持模型决策、工具调用、结果反馈和循环终止。
我们先约定,模型返回两种决策。
需要调用工具时:
{
"type": "tool",
"name": "multiply",
"args": {"a": 5, "b": 6}
}
任务完成时:
{
"type": "final",
"content": "最终结果是 40"
}
这样一来,Agent 只需要根据 type 判断是继续调用工具,还是返回最终答案。
2.1 定义工具
首先定义两个最简单的 Python 工具:
def add(a, b):
return a + b
def multiply(a, b):
return a * b
tools = {
"add": add,
"multiply": multiply
}
这里使用字典作为工具注册表,将工具名称映射到对应的 Python 函数。
例如:
tool_name = "multiply"
args = {"a": 5, "b": 6}
func = tools[tool_name]
result = func(**args)
print(result) # 30
其中 **args 表示把字典展开成函数的关键字参数。
这样,后续模型只需要返回工具名称和参数,Agent 就可以动态查找并执行相应函数。
2.2 模拟 LLM 决策
为了让代码不依赖真实模型 API,我们先用一个 mock_llm() 模拟模型决策。
def mock_llm(messages):
observations = [
msg["content"]
for msg in messages
if msg["role"] == "tool"
]
# 第一次:调用乘法工具
if len(observations) == 0:
return {
"type": "tool",
"name": "multiply",
"args": {"a": 5, "b": 6}
}
# 第二次:拿到乘法结果,继续加 10
if len(observations) == 1:
last_result = int(observations[-1])
return {
"type": "tool",
"name": "add",
"args": {"a": last_result, "b": 10}
}
# 第三次:返回最终答案
return {
"type": "final",
"content": f"最终结果是 {observations[-1]}"
}
这段代码模拟了模型的三次决策。
第一次调用 multiply(5, 6),第二次读取上一次的工具结果,再调用 add(30, 10),第三次输出最终答案。
注意,这里的 mock_llm() 是一个固定场景的规则模拟器,不是具有自主推理能力的真实大模型。
但它足够帮助我们理解 ReAct 的核心控制流程。
2.3 手撕 Agent Loop
接下来就是整道题最重要的部分。
def react_agent(question, max_steps=5):
messages = [
{"role": "user", "content": question}
]
for step in range(max_steps):
# 1. 模型决策
decision = mock_llm(messages)
print(f"第 {step + 1} 轮:{decision}")
# 2. 判断是否完成
if decision["type"] == "final":
return decision["content"]
if decision["type"] != "tool":
return "未知决策类型"
# 3. 获取工具及参数
tool_name = decision["name"]
tool_args = decision["args"]
# 4. 执行工具
func = tools.get(tool_name)
if func is None:
result = f"未知工具:{tool_name}"
else:
try:
result = func(**tool_args)
except Exception as e:
result = f"工具执行失败:{e}"
# 5. 记录模型的 Action
messages.append({
"role": "assistant",
"content": decision
})
# 6. 将 Observation 反馈给模型
messages.append({
"role": "tool",
"content": str(result)
})
return "超过最大执行步数"
到这里,一个简易的 ReAct Agent 就写完了。
是不是没有想象中复杂?
整个核心循环其实就做了几件事:
① 调用模型,获取下一步决策。
decision = mock_llm(messages)
每一轮都将当前 messages 传给模型,让模型根据已有上下文决定下一步。
② 判断是否需要结束。
if decision["type"] == "final":
return decision["content"]
如果模型已经能够回答用户问题,就直接返回。
③ 执行工具。
func = tools.get(tool_name)
result = func(**tool_args)
根据模型返回的工具名称,从注册表中找到真正的 Python 函数并执行。
④ 将 Observation 写回消息历史。
messages.append({
"role": "tool",
"content": str(result)
})
这是 ReAct 非常关键的一步。
因为工具返回的结果不一定是最终答案,它可能只是下一个动作的输入。
如果执行完 multiply(5, 6) 就直接 return 30,那 Agent 根本没有机会继续调用 add(30, 10)。
⑤ 限制最大执行轮数。
for step in range(max_steps):
防止模型反复调用工具却始终不返回最终答案。
2.4 运行一下
将上面三部分代码放进同一个 react_demo.py 文件,再添加:
if __name__ == "__main__":
answer = react_agent(
"先计算 5 × 6,再把结果加上 10"
)
print("最终答案:", answer)
运行:
python react_demo.py
按照当前 Mock 决策逻辑,预期输出:
第 1 轮:{'type': 'tool', 'name': 'multiply', 'args': {'a': 5, 'b': 6}}
第 2 轮:{'type': 'tool', 'name': 'add', 'args': {'a': 30, 'b': 10}}
第 3 轮:{'type': 'final', 'content': '最终结果是 40'}
最终答案: 最终结果是 40
可以看到,Agent 经历了两次工具调用和三次模型决策。
其中第二次工具调用使用了第一次返回的结果,最终由模型返回 final,结束循环。
三、面试官可能会追问什么?
Q1:为什么工具执行完不能直接 return?
因为工具结果不一定是最终答案。Agent 需要把工具结果作为 Observation 加入 messages,让模型决定是否还需要执行其他动作。
Q2:如果模型一直调用工具,不返回 Final 怎么办?
设置 max_steps 限制最大决策轮数,防止无限循环。在实际项目中还可以加入超时、预算限制等机制。
Q3:如果模型返回了不存在的工具怎么办?
通过工具注册表检查工具是否存在,不能执行模型任意指定的代码。可以把错误作为 Observation 反馈给模型,或者根据错误处理策略终止任务。
Q4:如果换成真实 LLM,需要改哪里?
主要是替换 mock_llm()。
真实模型需要接收消息历史和工具定义,并返回结构化工具调用或最终回答。Agent 再按模型 API 的协议记录工具调用、回传对应的工具结果。
这里我们自定义的 decision 和 messages 格式只是为了方便理解,不能直接当作所有模型 API 的原生格式使用。
不过,模型决策 → 工具执行 → Observation 回填 → 继续决策 这条核心控制思路是不变的。
四、最后总结
其实 ReAct 的核心没有那么神秘。
我们手写的 Agent Loop,本质就是:
while 任务未完成:
decision = llm(messages)
if 任务完成:
return 最终答案
result = 执行模型选择的工具()
messages.append(模型决策)
messages.append(工具结果)
真正要理解的,不是某个 Agent 框架的 API,而是模型如何通过工具与外部环境交互,又如何利用观察结果决定下一步行动。
当然,本文只是一个帮助理解原理的最简实现,距离生产级 Agent 还有参数校验、权限控制、上下文管理、异常恢复等工作。
但对于 ReAct 的基础手撕题,先把这个循环真正理解并独立写出来,我认为就抓住了最重要的部分。
好了,第一篇就到这里!
后面准备继续分享 Function Calling、Multi-Agent、Agent Memory 等 Agent 开发高频手撕题。
希望这个系列对你有所帮助,我们下篇见!