大家好,我是迪菲赫尔曼。
好久不见,我又回来了。
如果你之前就关注过我,欢迎回来。要是第一次看到这个名字,也很高兴在这里认识你。
这次回来,想和大家认真做一件事:重新开一个 YOLO 实战专栏,从零开始,把入门、改模型、做实验,再到论文写作这条路,一步一步走明白。
这篇先不急着讲代码。我想先聊聊,为什么要做这个专栏,以及如果你愿意跟着学,我们接下来准备一起做些什么。
平时做算法,越往后越能感受到,很多事情在熟悉的人眼里只是一个顺手的操作,在刚开始学的人那里,却可能是一整晚都跨不过去的坎。环境怎么选,代码从哪里运行,报错先看哪一行,训练出来的文件又该打开哪一个,这些问题都很具体,也都值得认真回答。
所以这次写专栏,我想多花一点时间,把中间那些容易被省略的步骤补上。让你看到一段代码以后,知道它放在哪里、怎么运行;看到一个改进思路以后,知道该怎样动手验证。
我希望你每读完一篇,都能在自己的电脑上做成一点东西,也能说清楚自己这一步学会了什么。
这个专栏想带你做到什么
最近看到不少同学在问,想用 YOLO 做点改进,最后写篇自己的论文,到底该从哪开始。
有的是刚接触深度学习,环境还没配明白,代码一报错就不知道怎么办了。有的是已经能跑训练了,但接下来改哪里、加什么模块、怎么做实验,还是一头雾水。还有的同学已经折腾了一段时间,代码下了一堆,模块也加了不少,结果指标没涨,自己都不知道问题出在哪。
其实我挺能理解这种感觉。
网上能搜到的东西确实很多,论文、代码、教程,随便一搜就是一大堆。但真轮到自己动手,会发现中间缺了好多东西。别人一句“把这个模块替换进去就行了”,你可能得找半天文件;好不容易改完能跑了,又发现维度对不上,或者训练完效果还不如原来的模型。
折腾几天,电脑一直在跑,自己也一直在忙,最后问起来这几天做了什么,好像又说不太清楚。
更让人着急的是,你可能已经给自己排了计划:这周把环境弄好,下周开始改模型,再往后做实验。结果第一个报错就卡了两天,后面的安排全乱了。再看看别人晒出的结果表和论文,难免怀疑,是不是自己基础太差,或者根本不适合做这个。
但一个人在陌生的项目里摸索,本来就容易卡住。你不知道该去哪个文件找答案,也不知道搜出来的几种说法,哪一种适合自己手里的代码。这种时候,能有人把前后几步接起来,往往就能继续往下走。
尤其是刚入门的同学,最难受的往往就是这个:想认真做,但没人告诉你第一步做什么,做完以后下一步又该干什么。
所以我想把这个专栏做得实在一点,把从入门、改模型、做实验,到整理成论文的过程,尽量给大家讲清楚。
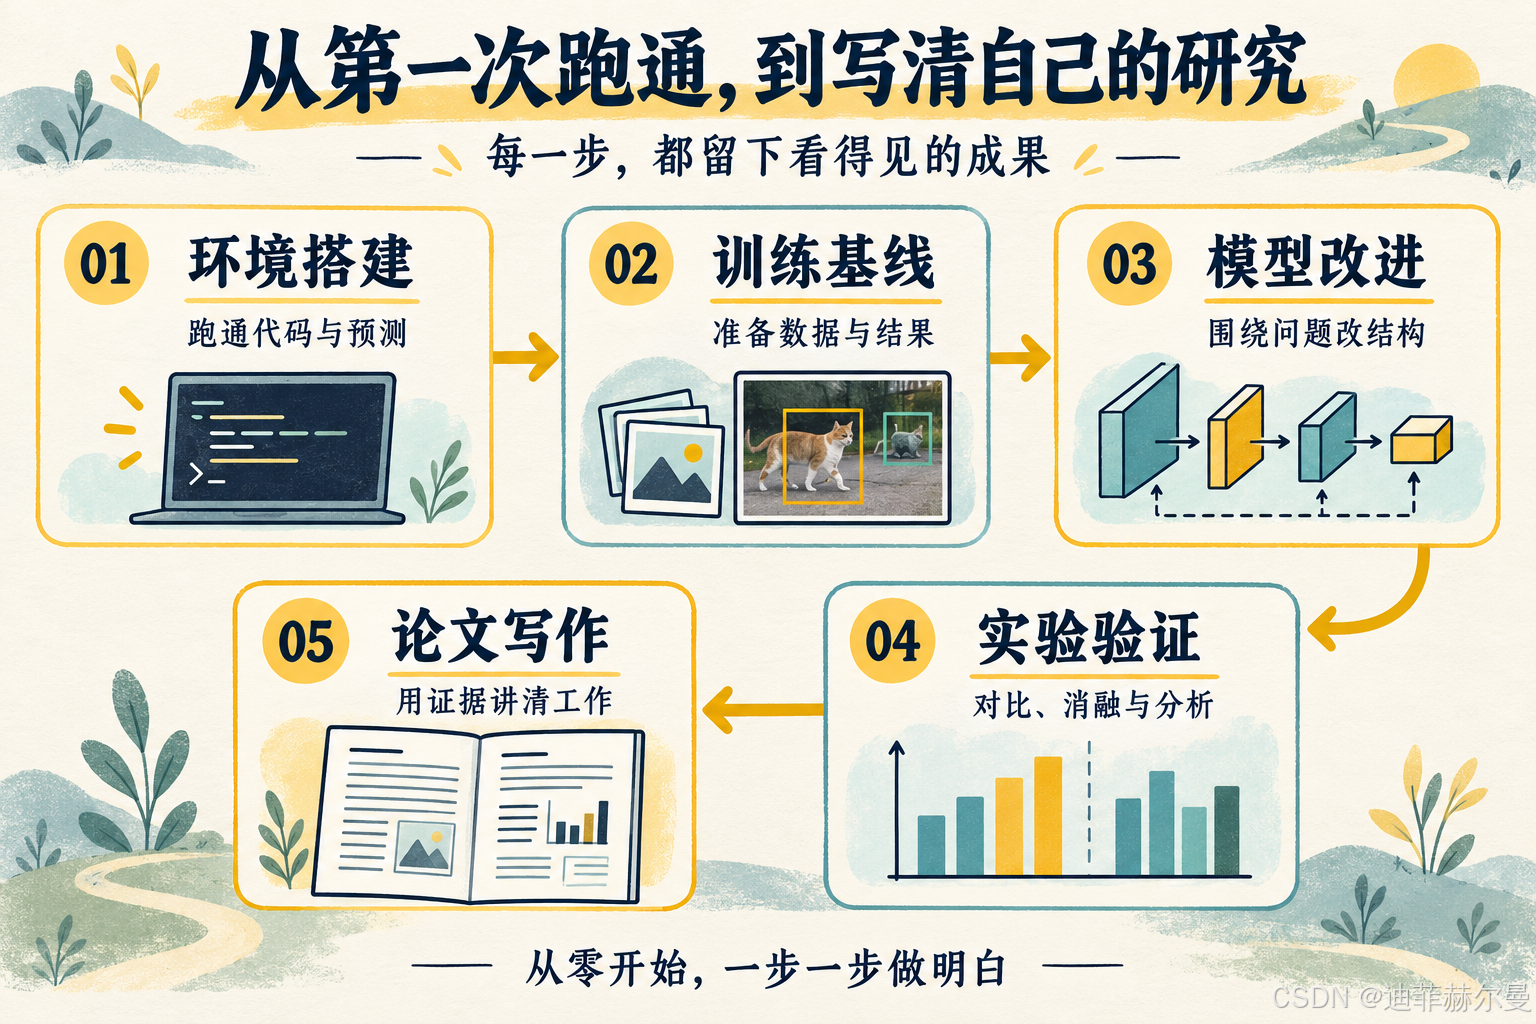
你可以先记住这条路线。刚开始把代码跑通,接着学会看数据和结果,再围绕具体问题做改进,最后用实验和记录支撑自己的结论。每一步都会用到前面学过的东西,我们就顺着这个过程往下走。
AI 都能帮你改代码了,教程该多教点什么
说到这里,也想聊两句现在一些改进教程的写法。
找来一个模块,贴上代码,告诉你往哪个文件里放,再给一份改好的配置,最后配上一张涨点表。照着做,模型可能确实能跑起来。但换一个模型版本、换一套数据,或者有人问一句“为什么这样改”,你又得重新找下一篇教程。
有些教程的“保姆级”,细到告诉你在哪一行粘贴;一问为什么加在这里、怎样证明有效,就只剩一句“你自己跑跑看”。步骤写得很满,读者的疑问也留得很完整。
这类接入步骤,对刚入门的同学当然有用。但有了 AI,生成一版模块代码、修改配置、解释报错,已经方便了很多。教程如果还停留在“这段代码放进去,能运行就算讲完”,能教给读者的东西也就很有限了。
把同一个问题交给 AI,你可能很快就能得到几种写法。接下来怎么选?它生成的连接是否合理,算力开销值不值得,提出的解释和代码能不能对应,给出的实验方案又能不能验证你的想法?这些都需要自己有判断。
所以这个专栏会继续往前讲:从错误样本里找问题,顺着模型结构分析原因,理解方法为什么可能起作用,再设计实验,看看证据是否支持这个判断。AI 可以参与这个过程,我们也会学着检查它给出的方案,提出更具体的问题。
我希望你学完以后,能带着一个具体问题去用 AI、改模型、做验证,最后对自己采用的方法和写下的结论负责。
既然 AI 能做,为什么还要自己学
讲到这里,你可能会问:既然 AI 能写代码、改模型、安排实验,那干脆都交给它做,自己等结果不就行了吗?
可以,而且这条自动化路线,我也会专门教大家做。
明确任务、准备好数据和运行环境以后,可以把论文检索、思路整理、代码修改、训练运行、结果汇总,再到论文初稿串成一套流程。你也不必为了证明自己学过,就坚持每一行代码都亲手敲、每一张表都手工整理。能交给工具的重复工作,就让工具帮你完成。
但作为学习者,自己学过、理解过这些过程,后面才能走得更稳。
比如,AI 跑出了一组很好看的结果,你得知道训练集和测试集有没有混在一起;它给你安排了两组对比,你得看得出训练条件是否公平;它把模块接进了模型,你得能核对结构和代码有没有实现你原来的想法。遇到报错、结果反常,或者导师追问方法细节时,这些基础都会用得上。
如果一直只看它最后交出来的答案,过程完全看不懂,换个任务、换套数据,甚至换一个工具,都可能重新卡住。手里多了不少代码和结果,自己的判断却没有跟着长起来,做久了还是会心虚。
你可以让 AI 帮你完成工作,也要给自己留出理解工作的时间。懂一点原理,就能多检查一步;多一点基础,就能把问题问得更准,把结果判断得更清楚。
所以,主线里我们会把环境、代码、模型和实验这些基础一步步补上。后面的附加篇,我会专门讲一条 全自动 AI 科研路线:怎样拆解任务,让 AI 串联检索、改代码、运行实验、记录结果和辅助写作,以及每个关键环节怎样检查。
等你对整个过程有了认识,再回头看这些自动化操作,就能看明白每一步在做什么,哪里可以继续交给 AI,哪里需要停下来核对。以后流程再怎么变,你也有能力把它调整到自己的课题上。
零基础,从第一步开始
零基础的同学,也可以从头跟着做。
这里说的零基础,就是你之前没改过 YOLO,没有完整做过一组实验,也不知道论文里的那些对比表、消融表是怎么来的。这些都可以一步步学,不需要等你把所有理论都看懂了才开始。
刚开始,我们先把环境和代码弄明白,知道训练怎么启动、数据集怎么准备、结果去哪里看。先亲手跑通一次,对整个流程有个印象,后面再看代码、看模型结构,就容易理解多了。
如果你对 Python、终端和文件路径也不熟悉,前面同样会留出位置来讲。为什么明明装过依赖,运行时还是提示找不到?为什么同一条命令,换一个文件夹就不能用了?这些看起来很基础的问题,恰恰会影响后面每一次操作。
我们先把这些关系弄清楚,再看模型怎样读入一张图片、输出预测、计算损失和更新参数。原理和操作放在一起学,遇到熟悉的运行结果时,也就更容易理解代码在做什么。
前面学得慢一点没关系。能独立跑通、知道结果在哪里、遇到问题能开始排查,这些都是后面改模型的底气。
改模型,先找到具体问题
接下来再带你看模型怎么改。
很多同学一提改进,就是找注意力机制,找新模块,看到别人说哪个效果好,就想加进去试一下。这个心情我理解,但模块越找越多,人反而容易乱。
我希望你跟着专栏做的时候,能慢慢弄清楚:自己的任务难在哪里,模型哪一部分值得改,这次改动到底想解决什么问题。
比如你做的是小目标检测,那就围绕小目标的问题去找思路;如果你的数据里遮挡比较多、背景比较复杂,就结合这些情况考虑改进。有了具体的问题,选模块、改结构、安排实验,才会有方向。
代码里该找哪个文件,模块该放在哪里,配置文件怎么改,改完怎么确认模型能正常跑,这些也会放到具体操作里讲。对刚入门的同学来说,这些地方能看明白、跟着做出来,才是真的有用。
同时,我们也会回到原来的模型里,看看一张图片经过了哪些层,特征图的尺寸和通道是怎样变化的。这样遇到维度不匹配时,你能沿着连接关系去检查;看到一个新模块时,也能判断它需要什么输入、适合接在哪里。
我希望你慢慢积累起这样的能力:换一个数据集,或者遇到一个没有现成教程的改法,也知道可以从哪里开始分析。
做实验,把每次改动验证明白
然后就是做实验。
这也是我想重点讲的一部分。因为很多同学能把训练跑起来,但还不太会做一组完整的实验。
原始模型要先跑出什么结果,训练配置怎么保持一致,改进后该比较哪些指标,加了两个模块以后怎么分别验证作用,这些都关系到最后的结果能不能说明问题。
你跟着做的过程中,要逐步学会自己跑基线、安排对比实验和消融实验,看懂结果,再决定下一步怎么改。
比如,同一套数据上,先跑原始模型,再分别加入两个改动,最后验证它们一起使用的效果。每组实验都留好配置和结果,比较时才能知道差别来自哪里。需要进一步确认时,再通过重复实验、错误样本和不同来源的数据检查结论。
很多时候,最容易让人走弯路的,就是看到一次指标上涨,马上认定方法有效;或者一次没涨,就把整个思路推翻。我们会结合实际结果,讨论还有哪些因素需要检查,以及这组实验目前能支持多大的结论。
涨点了,知道这组实验支持了什么结论;没涨,也能检查数据、配置和改动本身,找到下一步值得验证的地方。这样每跑一次实验,自己都能积累一点判断,后面做自己的数据集才有底气。
写论文,从实验记录里积累材料
大家最关心的写论文,也会结合前面的工作一起讲。
我知道,很多同学学 YOLO,就是希望最后能做出一份属于自己的成果,顺利推进课题,把论文写出来。这个需求很实际,没什么不好意思说的。
但这里也得把话说清楚:涨点本身,撑不起一篇论文。论文需要拿得出手的方法,也需要讲得通、经得起验证的研究故事。
多换几个模块、多试几组配置,找到一次比原来高一点的结果,往往没有想象中那么难。单看一张表,数字也可以很好看。真正需要花心思的,是解释这个改进解决了什么问题、为什么有效,以及这种效果能在什么条件下成立。
这里说的“故事”,要从真实的问题出发:观察到了什么现象,由此提出什么判断,为什么设计这个方法,又用哪些实验来验证。动机、方法和证据得接得上,读者才看得懂你到底做出了什么贡献。
表里多了几个加粗数字,和完成一项讲得清楚的研究,中间还有不少功课要做。这部分,恰恰是我想带大家认真补上的。
但真正开始写的时候,又会发现:模型改了,实验跑了,打开文档还是不知道从哪写。自己的工作该怎么介绍,改进理由怎么讲,实验表格怎么安排,结果又该怎么分析,处处都能卡住。
所以在做实验的时候,就要开始留意这些事情。为什么做这个改进,做了哪些验证,结果说明了什么,有哪些局限,都一点点记录下来。等到整理文章的时候,你手里有代码、有实验、有记录,也有自己对这项工作的理解,写起来才不会一直对着空白文档发愁。
我们会顺着实际做过的工作去整理:任务中发现了什么问题,已有方法有哪些不足,自己的改动和这些问题有什么关系,又拿什么实验来验证。结构图、对比表、消融表和可视化,都要能帮你把这些事情说清楚。
这样从实验走到写作时,每一部分都有材料可用。方法部分能对应到实际代码,实验分析能找到原始记录,讨论局限时也有观察过的失败样本。论文里的判断,就有了可以回头核对的依据。
我希望这个专栏能带你走完这样一条路:刚开始可能连代码都不太敢动,后面能自己尝试改模型,能安排实验,再把做过的工作梳理清楚,逐步写成论文。
接下来,一起动手
当然,这中间需要你亲自动手。看完一篇教程,自己跑一次;学到一个改法,自己试一次。遇到问题再回头看,很多原来觉得特别难的东西,做着做着就明白了。
你现在基础差一点、进度慢一点,都没关系。刚入门的时候,能把一次训练跑通、能看懂一张结果表、能完成一次模型修改,都是在往前走。
如果你之前也收藏过很多教程,却一直没能完整做完一个项目,这次可以先给自己定一个小目标:跟着第一篇开始,把眼前这一步做完。今天把路径弄清楚,明天跑通一次预测,再往后完成一组自己的训练。这样积累下来,你会慢慢有一套自己能用起来的方法。
已经有一些基础的同学,也可以带着自己的数据和问题来读。把教程里的步骤放到自己的任务上试一试,看看哪些结论成立,哪些地方需要重新验证。你能提出的问题越具体,后面的实验就越容易安排。
如果你现在也想用 YOLO 做实验、做改进、写论文,但一直不知道怎么开始,那这个专栏就是为你这样的同学准备的。
从第一步开始跟着做,把之前零零散散看过的东西接起来,也给自己的课题找一条能实际走下去的路。
很高兴又能在这里和大家见面。
这次,我们一起把第一步迈出去,再把后面的路一步一步走下去。