/* MD / 富文本中的 .toc(含博客园搬家等嵌套结构);.toc-box 在侧栏,不受影响 */
#content_views .toc,
/* 编辑器常在目录前后插入空 p(:empty 仍占 20px),一并去掉避免顶空隙 */
#content_views.markdown_views > p:empty:has(+ .toc),
#content_views.markdown_views > .toc + p:empty,
/* 富文本旧版目录标记 */
#content_views.htmledit_views #main-toc,
#content_views.htmledit_views #hr-toc,
#content_views.htmledit_views p[id*=\”-toc\”] {
display: none !important;
}
/* 目录去掉后,紧跟的首个标题不再多出一块上边距 */
#content_views.markdown_views > .toc + h1,
#content_views.markdown_views > .toc + h2,
#content_views.markdown_views > .toc + h3,
#content_views.markdown_views > .toc + h4,
#content_views.markdown_views > .toc + p:empty + h1,
#content_views.markdown_views > .toc + p:empty + h2,
#content_views.markdown_views > .toc + p:empty + h3,
#content_views.markdown_views > .toc + p:empty + h4 {
margin-top: 0 !important;
}
一、Spark 简介与环境准备
1.1 什么是 Apache Spark?
Apache Spark 是一个开源的统一分析引擎,用于大规模数据处理。它最初由加州大学伯克利分校的 AMPLab 开发,于 2014 年成为 Apache 顶级项目。Spark 以其内存计算能力著称,相比传统的 MapReduce 框架,性能提升可达 10-100 倍。
Spark 的核心特性:
| ⚡ 速度快 | 内存计算,DAG 优化执行引擎 |
| 🔄 易用性 | 支持 Java、Scala、Python、R 语言 |
| 🔗 通用性 | 集成 SQL、流处理、机器学习、图计算 |
| 🏃 随处运行 | 支持 Standalone、YARN、Mesos、Kubernetes |
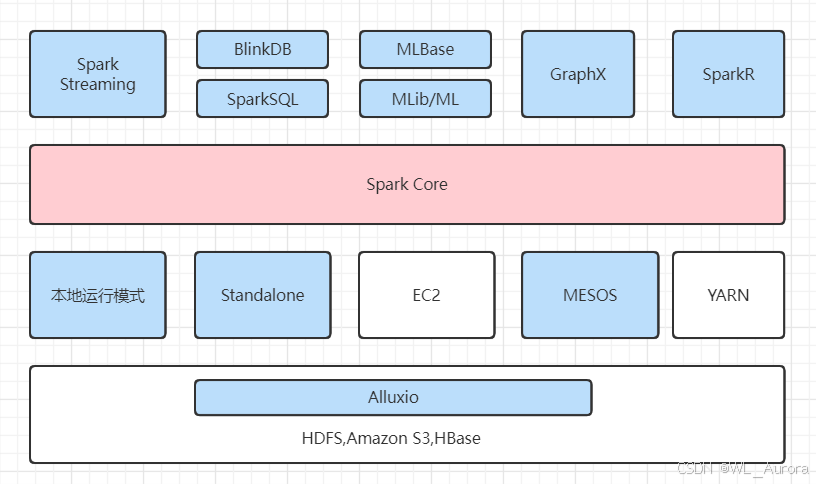
Spark 核心组件架构图:
1.2 环境准备清单
在开始安装之前,请确保你的系统满足以下要求:
硬件要求:
- CPU:2 核及以上
- 内存:4GB 及以上(推荐 8GB)
- 磁盘空间:至少 10GB 可用空间
软件要求:
- 操作系统:Linux(推荐 Ubuntu 22.04)、macOS、Windows
- JDK:1.8 或 11(推荐 OpenJDK 11)
- Python:3.8 及以上(如果使用 PySpark)
- 网络:能够访问 Apache 官网下载资源
二、JDK 安装与配置
Spark 基于 Java 开发,因此必须先安装 JDK。
2.1 Ubuntu/Debian 系统安装 OpenJDK
# 更新软件包索引
sudo apt update
# 安装 OpenJDK 11
sudo apt install -y openjdk-11-jdk
# 验证安装
java -version
预期输出:
openjdk version "11.0.21" 2023-10-17
OpenJDK Runtime Environment (build 11.0.21+9-post-Ubuntu-0ubuntu122.04)
OpenJDK 64-Bit Server VM (build 11.0.21+9-post-Ubuntu-0ubuntu122.04, mixed mode, sharing)
2.2 CentOS/RHEL 系统安装 OpenJDK
# 安装 OpenJDK 11
sudo yum install -y java-11-openjdk-devel
# 验证安装
java -version
2.3 Windows 系统安装 JDK
- JAVA_HOME = C:\\Program Files\\Java\\jdk-11
- Path 添加 %JAVA_HOME%\\bin
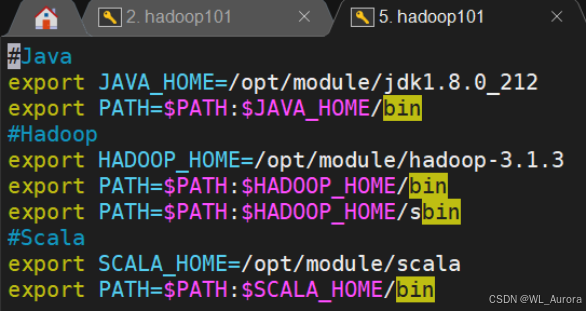
2.4 配置 JAVA_HOME 环境变量(Linux)
# 编辑 ~/.bashrc 或 ~/.zshrc
vim ~/.bashrc
# 添加以下内容
export JAVA_HOME=/usr/lib/jvm/java-11-openjdk-amd64
export PATH=$JAVA_HOME/bin:$PATH
# 使配置生效
source ~/.bashrc
# 验证
echo $JAVA_HOME
三、Scala 安装与配置
Spark 使用 Scala 编写,虽然 Spark 3.x 已经内置了 Scala 运行时,但安装 Scala 编译器有助于后续开发和调试。
3.1 使用 SDKMAN 安装 Scala(推荐)
SDKMAN 是管理多个 SDK 版本的利器:
# 安装 SDKMAN
curl -s "https://get.sdkman.io" | bash
# 使 SDKMAN 生效
source "$HOME/.sdkman/bin/sdkman-init.sh"
# 安装 Scala 2.11.8
sdk install scala 2.11.8
# 验证安装
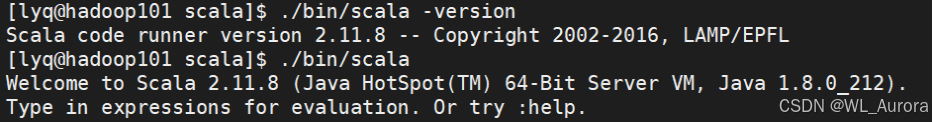
scala -version
预期输出:
Scala code runner version 2.11.8 — Copyright 2002-2023, LAMP/EPFL and Lightbend, Inc.
3.2 Ubuntu 直接安装 Scala
# 下载 Scala 2.11.8
wget https://downloads.lightbend.com/scala/2.11.8/scala-2.12.18.deb
# 安装
sudo dpkg -i scala-2.11.8.deb
# 验证
scala -version
3.3 手动安装 Scala
# 下载并解压
cd ~/Downloads
wget https://downloads.lightbend.com/scala/2.11.8/scala-2.12.18.tgz
tar -xzf scala-2.11.8.tgz
sudo mv scala-2.11.8 /usr/local/scala
# 配置环境变量
echo 'export SCALA_HOME=/usr/local/scala' >> ~/.bashrc
echo 'export PATH=$SCALA_HOME/bin:$PATH' >> ~/.bashrc
source ~/.bashrc
# 验证
scala -version
四、Spark 下载与安装
4.1 下载 Spark 3.5.0
访问 Apache Spark 官方下载页面:
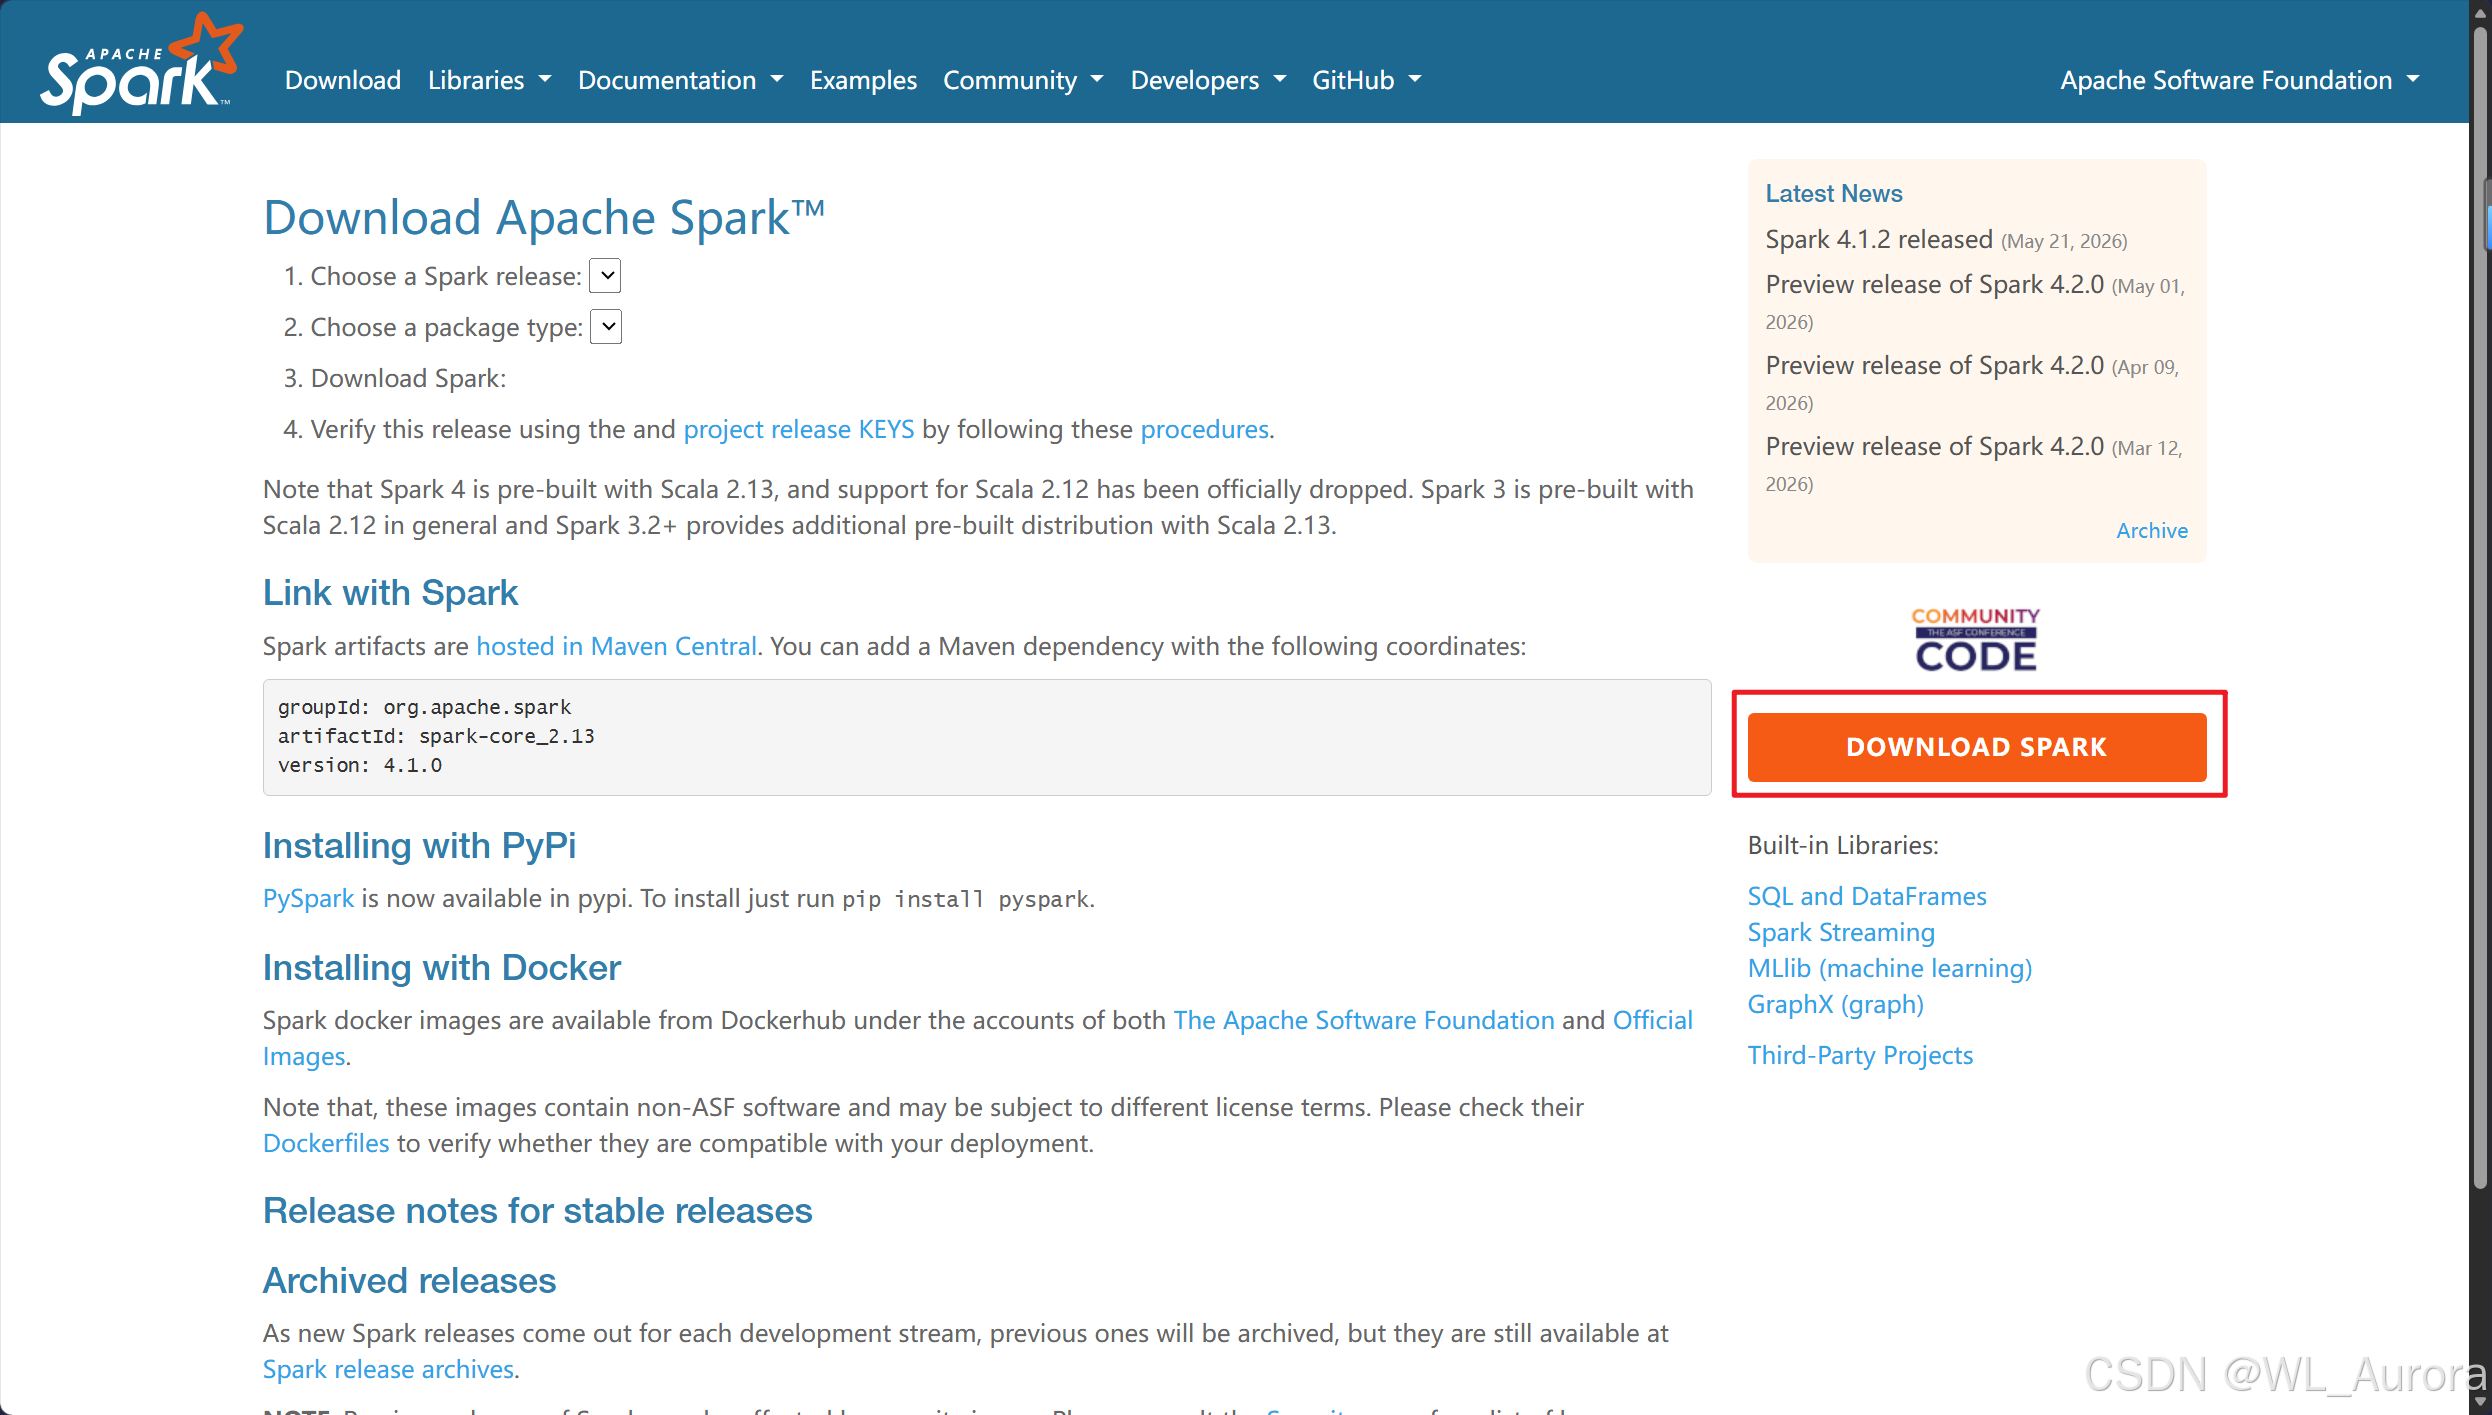
选择预编译版本:
- Spark 版本:3.5.0
- 包类型:Pre-built for Apache Hadoop 3.3 and later
- 下载链接:https://archive.apache.org/dist/spark/spark-3.5.0/spark-3.5.0-bin-hadoop3.tgz
# 使用 wget 下载(推荐,速度较快)
cd ~/Downloads
wget https://archive.apache.org/dist/spark/spark-3.5.0/spark-3.5.0-bin-hadoop3.tgz
# 或者使用国内镜像加速
wget https://mirrors.tuna.tsinghua.edu.cn/apache/spark/spark-3.5.0/spark-3.5.0-bin-hadoop3.tgz
4.2 解压与安装
# 解压到 /usr/local 目录
sudo tar -xzf ~/Downloads/spark-3.5.0-bin-hadoop3.tgz -C /usr/local/
# 重命名为 spark(方便后续使用)
cd /usr/local/
sudo mv spark-3.5.0-bin-hadoop3 spark
# 修改目录权限(将 hadoop 替换为你的用户名)
sudo chown -R $(whoami):$(whoami) /usr/local/spark
# 查看安装目录结构
ls -la /usr/local/spark/
目录结构说明:
/usr/local/spark/
├── bin/ # 可执行脚本(spark-shell, pyspark, spark-submit 等)
├── conf/ # 配置文件
├── data/ # 示例数据
├── examples/ # 示例程序
├── jars/ # Spark 核心 JAR 包
├── python/ # PySpark 相关文件
├── sbin/ # 集群管理脚本
└── yarn/ # YARN 集成文件
4.3 配置 Spark 环境文件
cd /usr/local/spark/conf
# 复制模板文件
cp spark-env.sh.template spark-env.sh
cp spark-defaults.conf.template spark-defaults.conf
# 编辑 spark-env.sh
vim spark-env.sh
在 spark-env.sh 末尾添加:
# Java 环境
export JAVA_HOME=/usr/lib/jvm/java-11-openjdk-amd64
# Spark 主目录
export SPARK_HOME=/usr/local/spark
# Python 环境(如果使用 PySpark)
export PYSPARK_PYTHON=python3
export PYSPARK_DRIVER_PYTHON=python3
# 可选:配置 Spark 日志级别
export SPARK_LOG_LEVEL=WARN
五、环境变量配置
5.1 配置系统环境变量
# 编辑 ~/.bashrc
vim ~/.bashrc
添加以下内容:
# ========== Spark 环境变量 ==========
export SPARK_HOME=/usr/local/spark
export PATH=$SPARK_HOME/bin:$SPARK_HOME/sbin:$PATH
# Python 路径(PySpark 需要)
export PYTHONPATH=$SPARK_HOME/python:$SPARK_HOME/python/lib/py4j-0.10.9.7-src.zip:$PYTHONPATH
# 可选:配置 Spark 本地 IP(避免绑定错误)
export SPARK_LOCAL_IP=127.0.0.1
# 使配置生效
source ~/.bashrc
# 验证环境变量
echo $SPARK_HOME
which spark-shell
which pyspark
5.2 配置 Spark 日志级别(可选)
cd /usr/local/spark/conf
cp log4j2.properties.template log4j2.properties
# 修改日志级别为 WARN,减少控制台输出
sed -i 's/rootLogger.level = info/rootLogger.level = warn/' log4j2.properties
六、Spark 本地模式验证
6.1 运行 Spark 示例程序
Spark 内置了计算 Pi 的示例程序,用于验证安装是否成功:
cd /usr/local/spark
# 运行 SparkPi 示例(计算 Pi 值)
./bin/run-example SparkPi 10
预期输出(部分):
Pi is roughly 3.14159…
6.2 启动 Spark Shell(Scala)
# 直接输入 spark-shell
spark-shell
成功启动后,你会看到: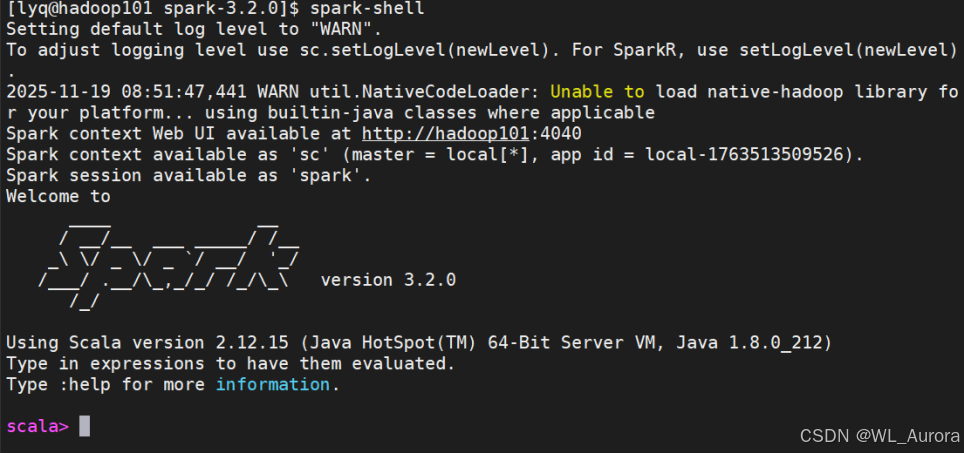
在 Spark Shell 中执行简单计算:
// 创建一个 RDD
val data = Array(1, 2, 3, 4, 5)
val distData = sc.parallelize(data)
// 计算总和
distData.reduce((a, b) => a + b)
// 输出: res0: Int = 15
// 退出
:quit
6.3 访问 Spark Web UI
启动 Spark Shell 后,打开浏览器访问:
http://localhost:4040
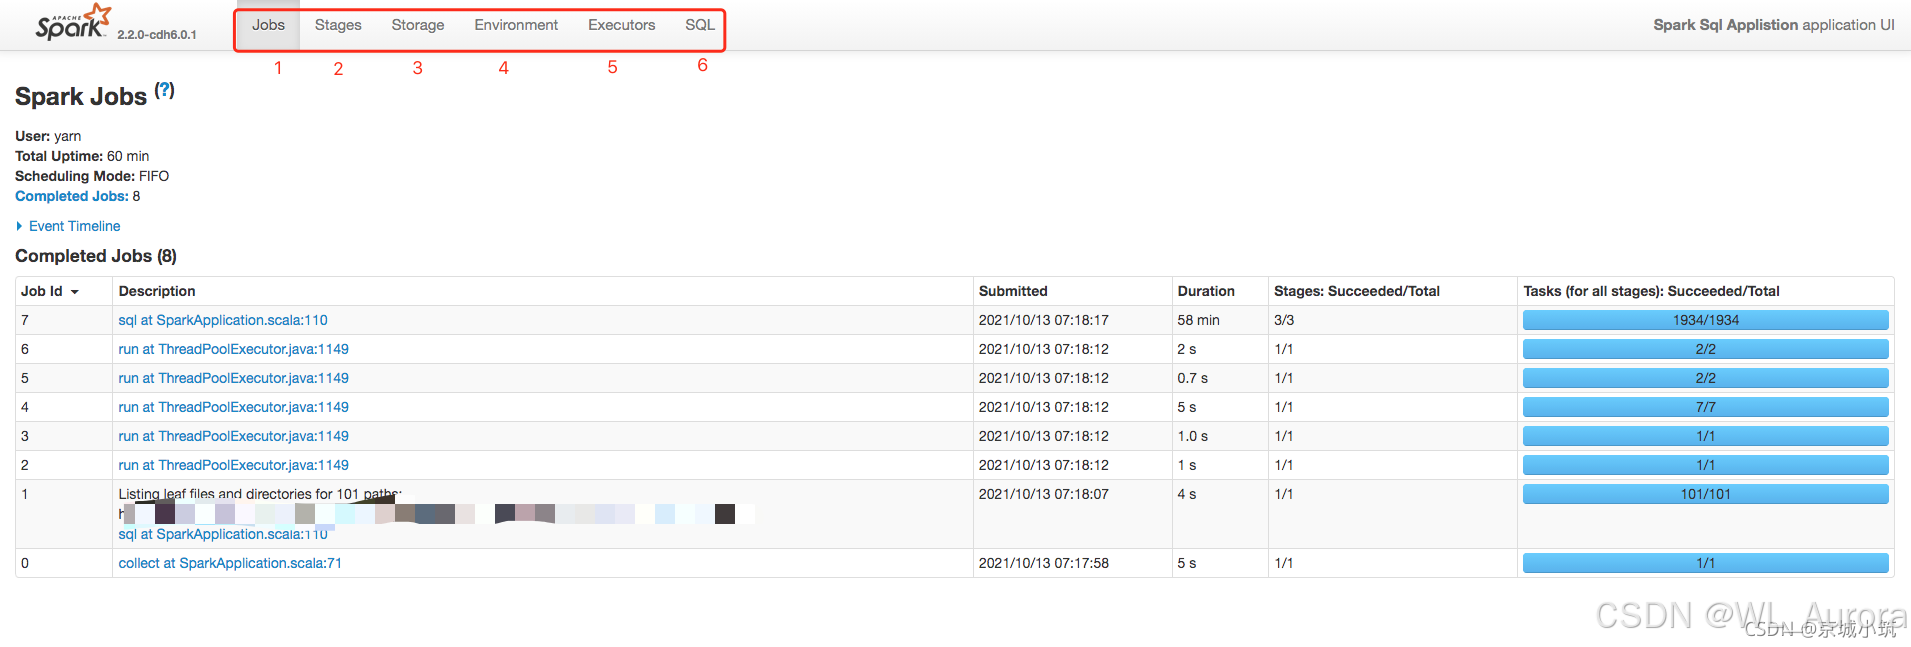
Web UI 主要功能:
- Jobs:查看任务执行情况
- Stages:查看 Stage 划分
- Storage:查看缓存数据
- Environment:查看运行环境配置
- Executors:查看执行器状态
- SQL:查看 SQL 查询执行计划
七、PySpark 安装与配置
7.1 安装 Python 依赖
# 确保已安装 Python 3 和 pip
python3 –version
pip3 –version
# 安装 PySpark(包含 py4j)
pip3 install pyspark==3.5.0
# 或者安装完整版(包含 pandas、numpy 等依赖)
pip3 install pyspark[sql,pandas_on_spark]==3.5.0
7.2 验证 PySpark 安装
# 启动 PySpark Shell
pyspark
成功启动后:
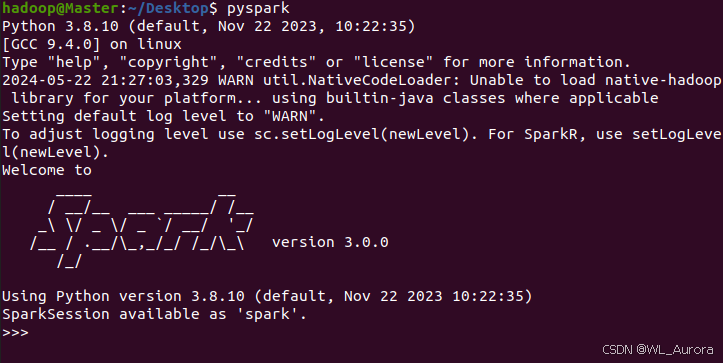
执行简单测试:
# 创建一个 DataFrame
df = spark.createDataFrame([(1, "Alice"), (2, "Bob"), (3, "Charlie")], ["id", "name"])
# 显示数据
df.show()
# 输出:
# +—+——-+
# | id| name|
# +—+——-+
# | 1| Alice|
# | 2| Bob|
# | 3|Charlie|
# +—+——-+
# 退出
exit()
7.3 在 Python 脚本中使用 PySpark
创建测试文件 test_pyspark.py:
from pyspark.sql import SparkSession
# 创建 SparkSession
spark = SparkSession.builder \\
.appName("MyFirstSparkApp") \\
.master("local[*]") \\
.getOrCreate()
# 读取示例数据
data = [("Java", 20000), ("Python", 100000), ("Scala", 3000)]
columns = ["Language", "Users"]
df = spark.createDataFrame(data, columns)
# 显示数据
print("=== 编程语言流行度 ===")
df.show()
# 简单统计
df.select("Users").summary("count", "min", "max").show()
# 停止 SparkSession
spark.stop()
运行脚本:
python3 test_pyspark.py
八、Spark Shell 交互式编程
8.1 Scala Spark Shell 常用操作
// ===== 1. 创建 RDD =====
val lines = sc.textFile("/usr/local/spark/README.md")
// ===== 2. 转换操作(Transformations)=====
val lineLengths = lines.map(s => s.length)
val words = lines.flatMap(line => line.split(" "))
val filtered = words.filter(word => word.contains("Spark"))
// ===== 3. 行动操作(Actions)=====
lineLengths.reduce((a, b) => a + b)
filtered.count()
filtered.take(10).foreach(println)
// ===== 4. 使用 DataFrame(Spark SQL)=====
import spark.implicits._
case class Person(name: String, age: Int)
val people = Seq(
Person("Alice", 25),
Person("Bob", 30),
Person("Charlie", 35)
).toDF()
people.show()
people.filter($"age" > 28).show()
people.groupBy("age").count().show()
// ===== 5. 读取 JSON 数据 =====
val df = spark.read.json("/usr/local/spark/examples/src/main/resources/people.json")
df.show()
df.printSchema()
8.2 PySpark 常用操作
from pyspark.sql import SparkSession
from pyspark.sql.functions import col, count, avg
spark = SparkSession.builder.appName("Demo").getOrCreate()
# 创建 DataFrame
df = spark.createDataFrame([
("Alice", "Sales", 3000),
("Bob", "Engineering", 5000),
("Charlie", "Sales", 4000),
("David", "Engineering", 6000)
], ["name", "dept", "salary"])
# 基本查询
df.show()
df.select("name", "salary").show()
df.filter(col("salary") > 3500).show()
# 聚合操作
df.groupBy("dept").agg(
count("*").alias("count"),
avg("salary").alias("avg_salary")
).show()
# SQL 查询
df.createOrReplaceTempView("employees")
spark.sql("SELECT dept, AVG(salary) as avg_salary FROM employees GROUP BY dept").show()
九、常见问题与解决方案
9.1 问题一:Java 版本不兼容
错误信息:
Unsupported class file major version 61
原因: Spark 3.5 需要 Java 11 或更高版本,但你可能使用了 Java 17+ 或 Java 8。
解决方案:
# 检查 Java 版本
java -version
# 如果版本不对,切换 Java 版本
sudo update-alternatives –config java
# 或者重新安装 OpenJDK 11
sudo apt install openjdk-11-jdk
9.2 问题二:端口 4040 被占用
错误信息:
Failed to bind to: /0.0.0.0:4040
解决方案:
# 查找占用 4040 端口的进程
lsof -i :4040
# 终止进程(将 <PID> 替换为实际进程号)
kill -9 <PID>
# 或者启动 Spark 时指定其他端口
spark-shell –conf spark.ui.port=4041
9.3 问题三:Python 版本不匹配
错误信息:
Py4JJavaError: An error occurred while calling o45.showString
解决方案:
# 确保 Python 版本为 3.8+
python3 –version
# 安装匹配的 PySpark 版本
pip3 install pyspark==3.5.0
# 设置 Python 环境变量
export PYSPARK_PYTHON=python3
export PYSPARK_DRIVER_PYTHON=python3
9.4 问题四:内存不足(OOM)
错误信息:
java.lang.OutOfMemoryError: Java heap space
解决方案:
# 启动时增加内存配置
spark-shell –driver-memory 4g –executor-memory 4g
# 或者在 spark-defaults.conf 中配置
echo "spark.driver.memory 4g" >> /usr/local/spark/conf/spark-defaults.conf
echo "spark.executor.memory 4g" >> /usr/local/spark/conf/spark-defaults.conf
9.5 问题五:权限不足
错误信息:
Permission denied: /usr/local/spark/logs
解决方案:
# 修改 Spark 目录权限
sudo chown -R $(whoami):$(whoami) /usr/local/spark
# 或者创建日志目录并授权
sudo mkdir -p /usr/local/spark/logs
sudo chmod 777 /usr/local/spark/logs
十、总结
10.1 安装流程回顾
┌─────────────────────────────────────────────────────────────┐
│ Spark 安装流程图 │
├─────────────────────────────────────────────────────────────┤
│ 1. 安装 JDK 11+ → 配置 JAVA_HOME │
│ ↓ │
│ 2. 安装 Scala 2.12 → 配置 SCALA_HOME │
│ ↓ │
│ 3. 下载 Spark 3.5.0 → 解压到 /usr/local/spark │
│ ↓ │
│ 4. 配置 spark-env.sh → 设置环境变量 │
│ ↓ │
│ 5. 配置 ~/.bashrc → source ~/.bashrc │
│ ↓ │
│ 6. 运行 SparkPi 验证 → spark-shell / pyspark │
└─────────────────────────────────────────────────────────────┘
10.2 关键配置文件汇总
| ~/.bashrc | 用户环境变量配置 |
| /usr/local/spark/conf/spark-env.sh | Spark 环境配置 |
| /usr/local/spark/conf/spark-defaults.conf | Spark 默认参数 |
| /usr/local/spark/conf/log4j2.properties | 日志级别配置 |
10.3 常用命令速查表
| spark-shell | 启动 Scala 交互式 Shell |
| pyspark | 启动 Python 交互式 Shell |
| spark-submit | 提交 Spark 应用程序 |
| spark-sql | 启动 Spark SQL CLI |
| ./sbin/start-all.sh | 启动 Standalone 集群(所有服务) |
| ./sbin/stop-all.sh | 停止 Standalone 集群 |
创作不易,如果觉得有帮助,请点赞、收藏、关注支持一下!