看到一篇好文章,先收藏;学到一个知识点,随手记下来。时间久了,文章在浏览器里,笔记散落在手机和电脑上,遇到问题时,还得重新搜索。
这篇教程尝试把这些动作连起来:随时记录,跨设备继续阅读,让 AI 协助整理来源、补充概念、建立关联,再在使用中不断修订。
搭建完成后,你可以在手机上写一条笔记,把它同步到电脑;在电脑上让 AI Agent 整理为有出处的知识页;再回到手机继续阅读。随着资料增加,同一概念会连接到不同来源,你提出的问题和形成的分析也能留在库里。
一、先明确工具各自负责什么
| Obsidian | 编写、阅读 Markdown,浏览笔记之间的链接 |
| Obsidian Web Clipper | 在浏览器中剪藏网页,保存到指定知识库目录 |
| 坚果云 + Remotely Save | 通过 WebDAV 在设备之间传输知识库文件 |
| AI Agent | 读取资料,按规则整理摘要、维护知识页、回答问题并保存分析 |
Agent 可以选择 Codex、WorkBuddy,或其他具有本地文件读写能力的工具。本文不依赖某个产品专属命令,示例都是交给 Agent 的自然语言任务。
选择工具时,确认它能打开知识库目录、读取多份文件、创建和修改 Markdown,并允许你检查实际文件变更。普通聊天工具如果只能回答问题、不能保存文件,就需要你手动完成写回。
二、创建一个目录,作为自己的知识库
先安装 Obsidian,在电脑上创建一个名为 my-knowledge 的本地库。入门阶段,让 Obsidian 打开的目录、同步的目录和 Agent 的工作目录保持一致。
接着准备你习惯的 Agent。若使用 Codex,可按官方安装说明完成安装,进入知识库目录运行 codex 并按提示登录;若使用 WorkBuddy 或其他工具,则按该工具的方式打开本地目录并确认文件访问权限。
说一下这个搭建思路是源于该领域的大神 OpenAI的创始成员卡帕西的一篇文章,你有兴趣可以到Github上去找到他的原文
我实际搭建时,是把下面这个中文版的文件交给 Agent,让它按规格建立仓库。本文也提供同一份文件:
下载配套文件:第二大脑知识库 中文版.md
这是一份给 Agent 阅读的建库说明,包含目录规格、AGENTS.md 必写条款、摄入与查询流程以及体检要求。
让 Agent 打开空的 my-knowledge 目录,简单的一句话:
请完整读取我提供的《第二大脑知识库 中文版.md》,建立知识库
初始化完成后,应得到下面的结构。它用于核对 Agent 的输出,不需要再手动创建一套:
my-knowledge/
├── AGENTS.md
├── 原始资料 raw/
│ ├── 已摄入/
│ └── 附件 assets/
├── 知识库 wiki/
│ ├── 目录 index.md
│ ├── 日志 log.md
│ ├── 综述 overview.md
│ ├── 资料摘要 sources/
│ ├── 实体 entities/
│ ├── 概念 concepts/
│ └── 分析 analyses/
└── 报告 reports/
原始资料 raw 保存学习笔记和收集的文章;知识库 wiki 保存整理后的内容;报告 reports 保存每次整理与检查的结果。尚未处理的材料直接放在 raw 下,完成整理后才移入“已摄入”。
三个全局页面分别承担不同任务:目录告诉你有哪些知识;综述记录当前主要领域、综合判断和资料差异;日志按时间追加每次操作,帮助追溯变化。
首次搭建还没有资料,三个页面保留清晰的空库状态即可。不要让 Agent 预设你的研究领域,或填入尚未发生的摄入记录。检查目录是否完整、页面是否有 tags 和 aliases,再打开 AGENTS.md,核对写入位置、规则批准、建页标准、事实纪律、标签清单和收尾自检六项是否齐全。
三、初始化之后,让 Agent 持续遵守维护规则
到这里,建库说明文件已经完成初始搭建的作用。后续让电脑上的 Agent 打开 my-knowledge,读取库中已经生成的 AGENTS.md。
关键是让 Agent 实际读到维护规则。本文把规则写入根目录的 AGENTS.md,但不假设所有工具都会自动识别这个文件。每次开始新会话,可以明确要求:
请先读取当前目录的 AGENTS.md,概括你将遵守的写入范围与整理流程,再处理知识库。不要修改规则文件或 Obsidian 设置。
这里要分清两个文件:配套的《第二大脑知识库 中文版.md》负责说明“如何搭建”;生成的 AGENTS.md 负责约束“之后如何维护”。不要每次整理资料都重新初始化,也不要把教程中的例句当作替换现有规则的理由。
建库说明要求规则由用户批准后修改。实际使用中发现新需求,可以让 Agent 提出改动理由和具体条款,确认后再更新,而不是让它边整理边改变约定。
规则把任务落到文件和验收标准上。比如“整理一下”没有明确终点;“生成摘要、更新概念、登记目录、自检后归档”则可以逐项查看。
四、从随手记录和收藏文章开始
1. 用 Web Clipper 把网页保存到待摄入目录
从 Obsidian Web Clipper 官方帮助进入对应浏览器的扩展商店,安装并将图标固定到工具栏。它是浏览器扩展,负责收集网页;后文的 Obsidian 社区插件 Remotely Save 负责同步文件,两者分工不同。
打开扩展设置,在常规设置中登记目标保管库 my-knowledge,提交后确认它已成为可选项。进入默认模板,找到保管库与笔记位置相关设置,选择该库,将笔记位置设为 原始资料 raw。具体界面以安装版本为准;保存前还可在扩展底部核对目标库和文件夹。
接下来打开一篇文章,点击扩展图标,先检查标题、来源链接与正文预览,再点“添加到 Obsidian”。回到文件列表,确认它确实出现在 raw,而不是默认的 Clippings。第一次先用一篇短文章验证路径,再开始批量收藏。
官方文档说明,插件会尝试提取主要正文;页面结构、选区和模板会影响结果。保存后仍要检查是否只抓到摘要、登录提示,或漏掉需要研究的段落。剪藏原文的属性原样保留即可,后续 AI 生成的页面再按维护规则使用标签,不为统一格式改写来源文件。
2. 图片和视频要分别检查
Web Clipper 官方文档明确说明:图片默认保留远程链接,不会自动下载。 如果需要离线阅读,可以在 Obsidian 中手动将新附件默认位置设为 原始资料 raw/附件 assets,再对刚保存的文件运行“下载当前文件的附件”命令(英文为 Download attachments for current file),检查图片是否已下载、链接是否改为本地文件。嵌套结构下附件位置同样需要加 notes/ 前缀。这是使用者在界面中配置,不要求 Agent 修改 Obsidian 设置。
这些操作应在资料正式摄入前完成;原文归档后按规则保持不动。下载完成也不等于跨设备图片验证通过,还需在另一台设备打开确认。
视频资料则要看实际抓取结果。作为这次文章的补充素材,我用插件获得的视频笔记包含标题、作者、原始链接、在线播放嵌入,以及带时间戳的逐字稿。Agent 读取的是其中的文字,不是因此就已经观看了视频。
嵌入播放器仍依赖网络,视频本体没有被下载;字幕是否存在、是否完整,也要逐条资料检查。自动转写会把产品名称识别错,引用关键操作或原话时,应按时间戳回看原视频。只有一个播放器或网址、没有正文与字幕时,先补齐文字材料,再让 Agent 整理,不让它根据标题补写内容。
3. 随手记录自己的疑问
在手机上想到问题,可以直接在 原始资料 raw 下新建 Markdown。先记下来,不要求当场写成完整文章:
# 关于异步编程的一个疑问
记录日期:2026-10-28
我的问题:为什么用了 await,页面上的其他交互还可以继续?
我现在的理解:待整理。
下一步想查:事件循环与 Promise 的关系。
看到好文章,也可以先用最朴素的方式:在同一目录新建 Markdown,记下标题、作者、原始链接和阅读日期,再保存自己有权使用的正文或必要摘录。网页图片如需离线阅读,另存到 附件 assets 并改成本地引用。
# 文章标题
作者:按原页面填写
原始链接:填写文章地址
阅读日期:2026-10-28
## 原文摘录
在这里保存需要研究的内容。
## 我的阅读问题
这篇文章是否能解释我上次记录的那个疑问?
把原文与个人评论分开,后续才容易核对来源。只记录一个 URL 时,Agent 未必能打开网页,也未必拿得到完整正文;资料已收藏和资料可读取,需要分别检查。
剪藏适合保存网页,手动记录适合捕捉自己的问题与理解,两者都可以进入待摄入区。暂时不想安装扩展,也可以先用上述手动方式跑通。
4. 本地 Word、PDF 和数据资料怎么处理
可以将文件交给能读取该格式的 Agent,转换成markdown文档。
五、把收集的材料变成有出处的知识页
一句话:
摄入素材
这条指令会处理全部待摄入资料。 整理完成后,至少检查以下结果:
| 摘要 | 是否忠于原文,能否打开来源文件 |
| 概念与实体 | 是否复用了已有页,是否无依据地大量建页 |
| 引用 | 点击内部链接,确认指向正确页面 |
| 目录 | 是否能找到新增页及一句话摘要 |
| 归档与报告 | 原文是否在自检完成后才归档,报告是否说明遗留问题 |
文章里出现的术语不必全部变成独立文件。如果正文重点解释 Promise,就适合建立概念页;一个只是顺带举例的产品,通常留在摘要里就够了。
先在电脑上确认结果;按后文接入多设备同步后,再将更新同步出去,此后手机端看到的就包括原文、摘要、相关概念和报告。
六、知识网络怎样在第二篇资料加入后长出来
知识网络可以从一条很具体的关系开始:一个概念,由哪些资料支持,又能帮助解释哪个问题?
下面是组织方式示例,并非新增的技术结论:
第一篇文章:重点讨论 Promise
↓
Promise 概念页 ── 关联 ── async 与 await 概念页
↑ ↑
第二篇文章:从另一个角度讨论它们的关系
↓
分析页:回应最初记录的问题
第二篇资料进入时,可以给 Agent 增加一个明确任务:
先查已有相关概念,尽量补充原页;列出新资料新增了什么、与旧资料有何不同。每个保留的结论都能返回来源。你自己的联系和解释标为非原文。
这样,同一个概念页可以累积不同来源。遇到不同说法时,先检查适用条件、版本和原文;无法确定的保留出处与疑点,不为了让文章读起来顺畅就强行统一。
在 Obsidian 中可以用内部链接连接页面,再借助反向链接回看哪些页面引用了当前概念。教程代码框中的示意名称不是已建好的真实页面,实际链接应由 Agent 对照现有文件创建。
七、通过提问,把学习成果继续写回知识库
资料多起来以后,让问题带动阅读:
根据现有知识库解释 Promise 与 async/await 的关系。引用实际页面,区分来源结论和你的归纳,将回答保存为分析页,并更新目录和日志。
阅读分析时,发现缺少依据就补资料;发现旧页解释过于简单就更新;发现版本不同就把适用范围写清楚。回答本身也成为下一次探索的入口。
知识库由此形成循环:记录问题,收集资料,整理关联,提出新问题,再补充和修订。每一次整理都留下来源和变化记录,方便以后重新判断。
八、用 Remotely Save 连接坚果云
1. 先留一份独立备份
如果目录里已经有笔记,在首次配置前,先把整个库复制到另一个不参与本次同步的位置。Remotely Save 的官方说明也要求使用前备份。
同步会传播文件变化。“已摄入”是资料归档位置,仍在同步目录里,不等于备份。
第一次尝试也可以先用空库验证,确认文件来回传输正常后再迁入已有内容。
2. 在坚果云生成应用密码
登录坚果云网页端,进入“账户信息 → 安全选项 → 第三方应用管理”,添加应用密码,名称可以填写 Obsidian。界面名称可能随版本变化,以当前页面为准。
这里生成的是第三方应用密码,填写到插件中使用;不要拿坚果云网站登录密码代替。
保留 WebDAV 账号和生成的应用密码,下一步配置时使用。
3. 安装并启用插件
打开 Obsidian 设置,在社区插件中按提示允许使用社区插件,搜索 Remotely Save,安装并启用。进入它的设置页,选择远程服务 Webdav。
| 远程服务 | Webdav |
| 服务器地址 | https://dav.jianguoyun.com/dav |
| 用户名 | 坚果云提供的 WebDAV 账号 |
| 密码 | 刚生成的应用密码 |
| 发送到服务器的 Depth Header | 只支持 depth='1' |
Depth 这一项不要遗漏。 Remotely Save 的坚果云专用指南明确要求使用只支持 depth='1' 的设置。如果当前界面不在首屏,继续向下查找。
下面是我使用的手机端配置界面,账号与密码已隐藏:
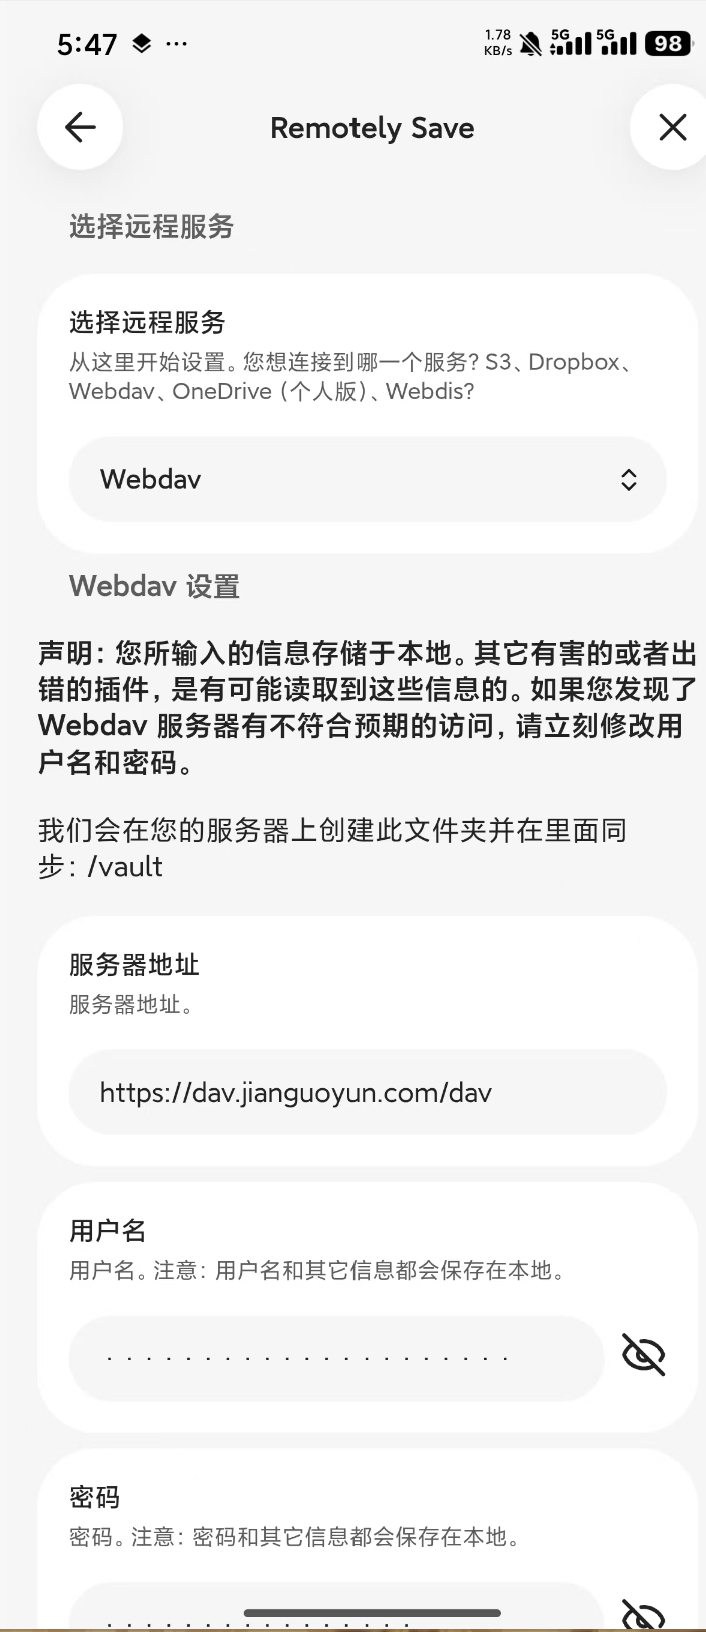
截图中的 /vault 是我的远端目录,不是所有人都必须填写的固定值。
4. 核对远端目录,再测试连接
按插件官方说明,默认会使用库名对应的远端子目录。例如本地库叫 my-knowledge,默认远端子目录就是这个名字。使用默认配置时,不同设备的库名应相同。
服务器地址和存放笔记的远端目录是两件事。先沿用基础服务器地址,核对插件界面提示将在哪个文件夹同步,不要为了匹配库名,在地址后随意再拼一层同名目录。
填写后运行“检查连接”。连接成功后,还要实际同步文件;仅连接成功不能证明笔记已经传过去。
第一次先保持手动同步,暂不引入端到端加密等额外配置,以便直接核对远端内容。后续要启用加密,应按插件文档单独配置全部设备。
5. 在第二台设备接入同一个库
在手机或另一台电脑上:
插件默认不传输 .obsidian 等配置目录,所以“笔记同步过来了”不等于“另一台设备已经装好插件”。初次搭建时,每台设备独立配置更容易排查问题。
本文统一使用 Remotely Save 演示,不再让桌面坚果云客户端同时管理同一设备的同一批文件。已有客户端同步方案可以保留,但必须先弄清本地与远端目录映射。
九、用一条笔记验证双向同步
配置完成后,先做一个最小实验:
这次搭建讨论中,我与 Agent 做了同样的测试:Agent 在电脑创建笔记,写入 daa2c492ce12;我在手机完成操作,将回传码改成 1225,没有在聊天中告诉 Agent 数字;随后 Agent 从电脑文件中读到了 1225,原电脑测试码也完整保留。
这个结果验证了当前环境中的基础 Markdown 双向同步。测试记录保存在知识库的“多设备同步实测”页。它并不等于已验证图片、删除、重命名和冲突恢复,也不能代替新设备首次配置检查。
十、给这套工作流安排维护时间
日常先做好两个动作:记录后确认同步,整理后检查来源。积累一批内容或发现链接异常时,再运行体检:
按 AGENTS.md 体检知识库,检查断链、孤立页、缺失属性、来源不符、未标注的推断与过时内容。修复可确认问题,输出体检报告,列出无法解决的事项。
让 Agent 将修改落实到文件,而不是只回复“检查完成”。抽查一两处修复,确认报告与实际文件一致。
另外,保留独立备份,尤其在批量整理、迁移目录和改变同步配置之前。冲突处理也不要想当然:Remotely Save 免费版提供基础策略,官方 README 并未承诺自动理解和合并全部文本;高级智能冲突处理属于单独的 PRO 功能。
十一、可选进阶:让摄入和体检按计划执行
手动流程稳定以后,如果所用 Agent 支持定时任务,可以减少重复发指令的操作。
先确认工具的定时功能是否能访问这个本地目录、执行时需要机器和应用处于什么状态,以及账号、权限和时区是否正确。按当前工具的界面创建任务时,至少填清以下要素:
| 摄入新资料 | 指定知识库工作目录;先读 AGENTS.md,处理待摄入资料,输出报告 | 资料已同步完整,没有其他任务在写库 |
| 知识库体检 | 指定同一工作目录;检查页面与来源,修复并输出报告,原文不动 | 本轮摄入确实完成后 |
| 主题资料收集 | 限定主题、时间范围、优先来源,保存出处与可读取正文,标清外部收集 | 工具可联网,且人工抽查过收集结果 |
十二、把日常使用收敛成几个固定动作
| 看到好文章 | 剪藏到 raw,核对正文、来源和附件 |
| 突然有想法 | 记下问题与自己的理解,保留与引文的区别 |
| 积累了资料 | 先完成同步,再摄入并抽查报告与实际页面 |
| 需要解决问题 | 要求基于库内资料回答、给出处,并保存值得保留的分析 |
| 新资料补充旧认识 | 更新已有概念和来源,记录真正的分歧 |
| 切换设备 | 当前设备同步完成,另一设备先同步再编辑 |
| 准备批量改动 | 保留独立备份,完成后检查链接与事实来源 |
简单来说,就是RAG+知识图谱。总之,对于个人学习者,我们可以将这些文档丢进知识库,从“摄入素材”到“体检”,每次询问都会记录,你的第二大脑会不断迭代完善,形成自己的知识体系。不过,每个领域要有自己的知识库。