孤立森林返回一个异常分数,不会同时附赠一份可信根因。SQL变慢可能来自锁、I/O、计划、数据量或上游流量变化;无监督模型看到的只是特征分布变化。
先问数据能否采到。若唯一数据源是阈值1秒的慢日志,原本2毫秒、现在200毫秒的查询可能根本不在训练输入里。换算法不能补回从未采集的事件。MySQL的摘要统计可以提供另一类聚合视角,但聚合也会丢失时序和单次细节。
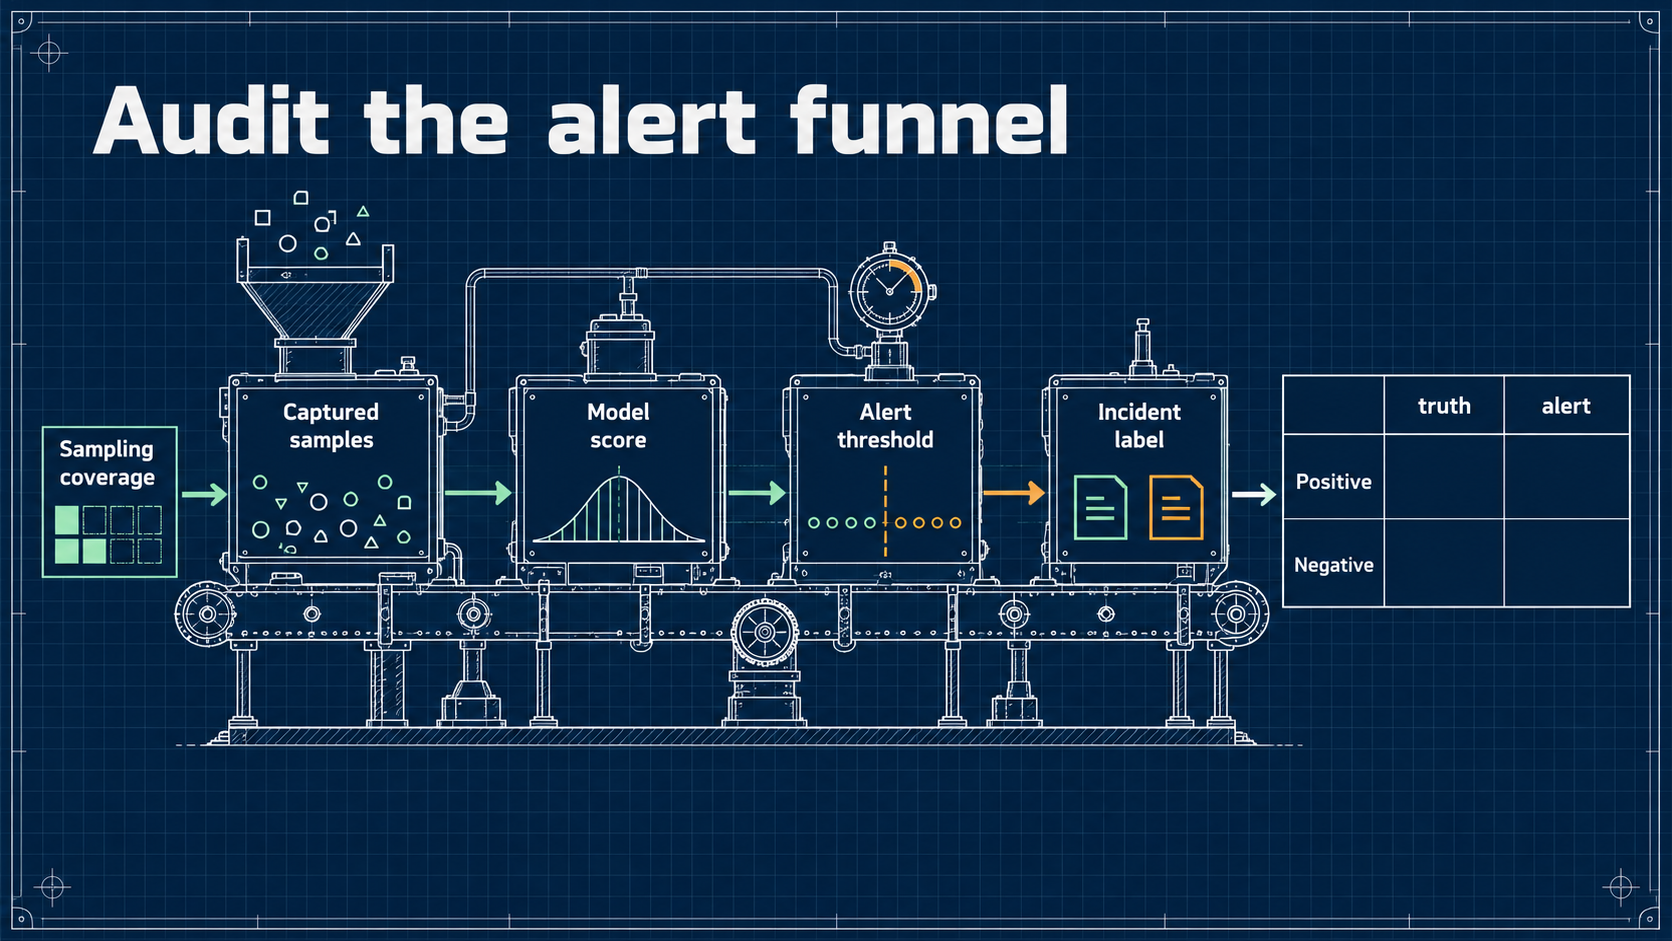
原理示意,非真实系统截图或性能测量。
验收的是告警代价,不只是分数
scikit-learn的IsolationForest文档说明contamination参与阈值定义,decision_function的方向也有明确约定。它没有要求每个使用者必须先用RobustScaler,更没有提供“增量微调即可自动跟上业务”的通用承诺。
下面只核对告警评价器。flags和truth都是人为设定的合成序列,不是孤立森林跑出的输出:
def audit(flags,truth):
if len(flags)!=len(truth):
raise ValueError("unaligned timestamps")
tp=sum(p and y for p,y in zip(flags,truth))
fp=sum(p and not y for p,y in zip(flags,truth))
fn=sum(not p and y for p,y in zip(flags,truth))
return {"tp":tp,"fp":fp,"fn":fn}
r=audit([False,True,True,False],[False,False,True,True])
assert r=={"tp":1,"fp":1,"fn":1}
assert audit([False],[False])=={"tp":0,"fp":0,"fn":0}
print("PASS metric bookkeeping; no model was fitted")
本地Python运行通过。当前环境未安装scikit-learn,本篇没有训练IsolationForest,没有把这三个计数说成模型性能。
一次值得做的对照
按时间切分训练、调参与独立验收数据。同一指纹的相邻样本若随机散到两边,容易让评估过于乐观。先比较静态阈值、MAD与孤立森林,统一记录每小时误报、已知异常漏报、发现延迟和检测开销。
按指纹、时段和业务基数分层也很重要。正常晚高峰与异常扫描都可能把耗时拉高;特征中应保留执行频次、扫描量、返回量以及可获得的锁等待信息。采不到的字段标missing,不用零伪装。
10月15日ClickStack的统计异常更新采用z-score,并写出渐变、持续异常和季节性处理的限制。它是不同方法,不能当孤立森林的产品背书;值得借鉴的是对盲区的公开说明。
异常分数适合排查排序。要自动Kill、限流或调参,还需要另一套授权和执行证据。检测器先把“值得看一眼”的线索找出来,就已经有用,不必急着自封根因专家。