/* MD / 富文本中的 .toc(含博客园搬家等嵌套结构);.toc-box 在侧栏,不受影响 */
#content_views .toc,
/* 编辑器常在目录前后插入空 p(:empty 仍占 20px),一并去掉避免顶空隙 */
#content_views.markdown_views > p:empty:has(+ .toc),
#content_views.markdown_views > .toc + p:empty,
/* 富文本旧版目录标记 */
#content_views.htmledit_views #main-toc,
#content_views.htmledit_views #hr-toc,
#content_views.htmledit_views p[id*=\”-toc\”] {
display: none !important;
}
/* 目录去掉后,紧跟的首个标题不再多出一块上边距 */
#content_views.markdown_views > .toc + h1,
#content_views.markdown_views > .toc + h2,
#content_views.markdown_views > .toc + h3,
#content_views.markdown_views > .toc + h4,
#content_views.markdown_views > .toc + p:empty + h1,
#content_views.markdown_views > .toc + p:empty + h2,
#content_views.markdown_views > .toc + p:empty + h3,
#content_views.markdown_views > .toc + p:empty + h4 {
margin-top: 0 !important;
}
字节跳动
AI校招岗位
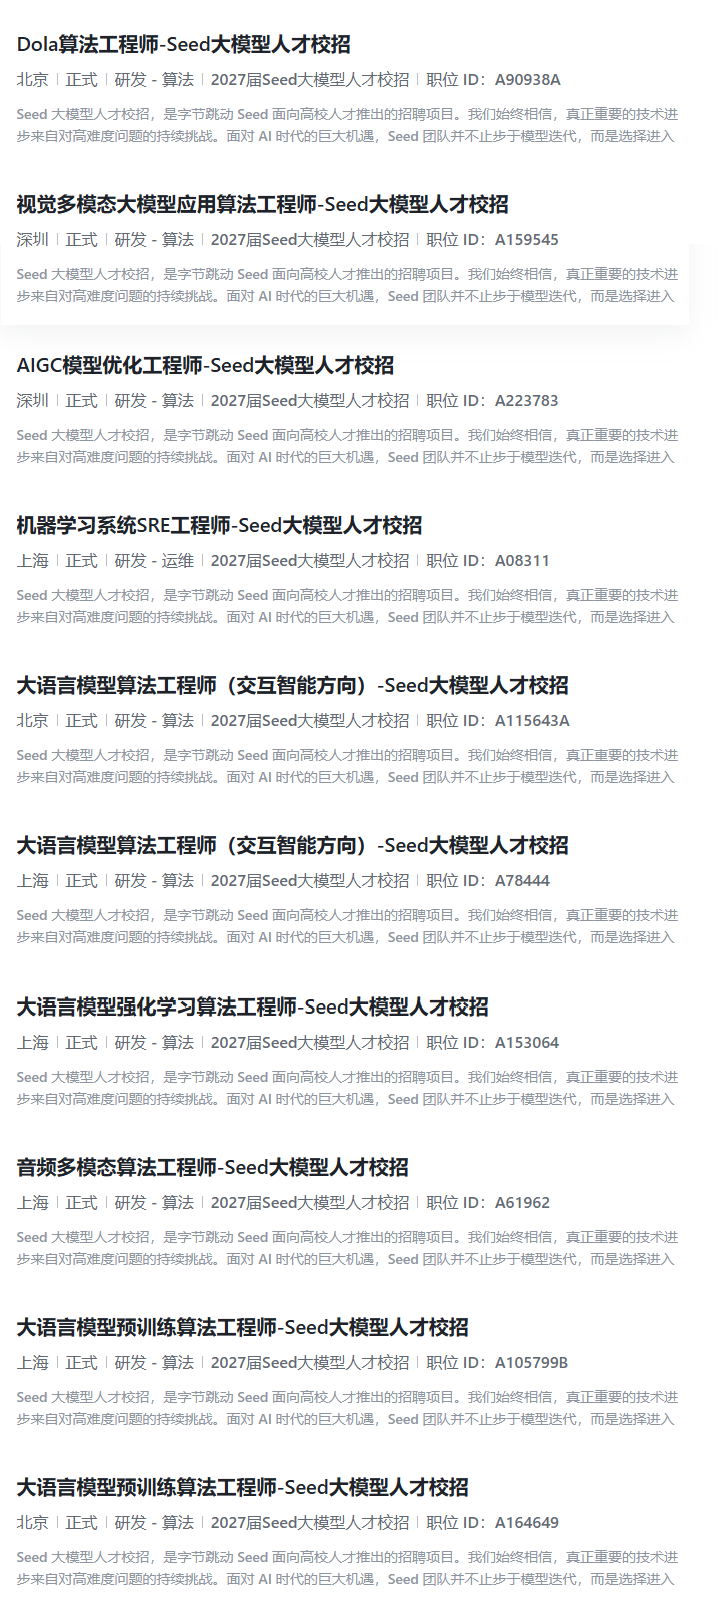
△可上下滑动,点击查看大图
部分岗位详情
Dola算法工程师
【工作内容】
1.通用能力对齐(Alignment Science):设计并优化SFT与RLHF流程,利用PPO、GRPO、Step-wise RL等算法提升模型在复杂问答与逻辑推理上的表现,平衡模型的Helpfulness与Harmlessness;
2.知识与搜索增强(Knowledge & Search):攻克模型幻觉问题,研究RAG(检索增强生成)与长文本处理技术,让Dola能够实时、准确地获取并加工全球知识;
3.创意与多模态进化(Creativity & VLM):提升模型的长文本创作、角色扮演与多风格写作能力;同时负责VLM(视觉语言模型)的后训练,实现深度图文理解与多模态交互;
4.Scaling in Post-training:探索指令微调数据量与模型性能的Scaling Law,研究如何通过高质量合成数据(Synthetic Data)突破数据瓶颈。
【职位要求】
1.2027届获得本科及以上学历,计算机、数学、统计等相关专业;
2.极客基因:计算机基础扎实,具备顶尖的工程实现能力(精通Python/C++);有ACM-ICPC、NOI/IOI等竞赛金牌背景者优先;拥有扎实的数学功底和机器学习理论基础;
3.硬核技术背景:1)深入理解大模型训练全流程;2)在RL、NLP或CV领域有深厚积累,理解算法的本质原理;
4.实战经验:深度参与过大模型Post-training相关的项目,对数据清洗、指令构建、奖励模型(Reward Model)训练有实际心得;
5.科研实践:在NeurIPS,ICLR,ICML,CVPR,ACL等顶级会议发表过高水平论文者优先;
6.产品心与自驱力:面对User-facing的产品逻辑,有较强的自驱力去解决模型在真实场景下的表现问题,不满足于指标的提升,更在意用户体感的跨越。
AIGC模型优化工程师
【工作内容】
1.负责AIGC大模型(图片/视频生成、理解与生成统一模型)算法加速,优化模型推理效率、吞吐能力及资源利用率;
2.研究扩散模型、自回归模型及多模态大模型的计算特征与性能瓶颈,围绕采样、解码、注意力计算等环节开展系统性优化;
3.探索实践知识蒸馏、结构剪枝、Token压缩等前沿优化算法,在保证效果的前提下提升推理性能;
4.主导生成与理解类模型创新算法研究,提升前沿视觉范式的推理效率与服务性能;
5.联动算法、工程及业务团队,推动优化技术落地,建立从模型设计到线上部署的完整优化闭环。
【职位要求】
1.2027届获得本科及以上学历,计算机、人工智能、数学、自动化等相关专业优先;
2.具备扎实的机器学习、深度学习与算法基础,精通扩散模型和/或自回归模型的核心原理、实现细节及推理优化方法;
3.至少具备以下任一领域实践经验:AIGC模型算法加速与推理优化、模型压缩加速(知识蒸馏、剪枝等)、高效模型结构设计、生成/多模态模型性能优化与落地;
4.熟悉PyTorch等深度学习框架,工程实现能力强,可独立完成算法设计、实验验证及优化落地;
5.具备优秀的问题分析与系统优化能力,能从多层面定位性能瓶颈并提出系统性解决方案;
6.有文生图/视频、多模态或大模型推理优化相关项目/落地成果,或在高水平会议/期刊发表相关论文、有开源社区贡献、算法竞赛优异成绩者优先。
AI搜索算法工程师
【工作内容】
1.基于AI建设下一代搜索引擎,并服务于AI Agents,包括全网搜索、视频搜索、商品搜索、本地搜索、图片搜索、视觉搜索、结构化检索等;
2.基于LLM/VLM大幅突破搜索排序、召回、内容理解、个性化等任务,解决多语言、难语义、长文本等核心挑战。
【职位要求】
1.2027届获得本科及以上学历,计算机、人工智能等相关专业优先;
2.优秀的代码能力、数据结构和基础算法功底,熟练掌握C++或Python;
3.熟悉深度学习算法,有一定的算法应用经验和出色的技术判断能力;
4.出色的数据和问题分析能力,对新问题能够独立探索解决方案;
5.加分项:有ACM/ICPC等比赛获奖、在顶会发表相关论文、有顶级开源项目经验等。
工作地点
北京、上海、广州、成都、深圳、杭州等多地
百度
AI校招岗位
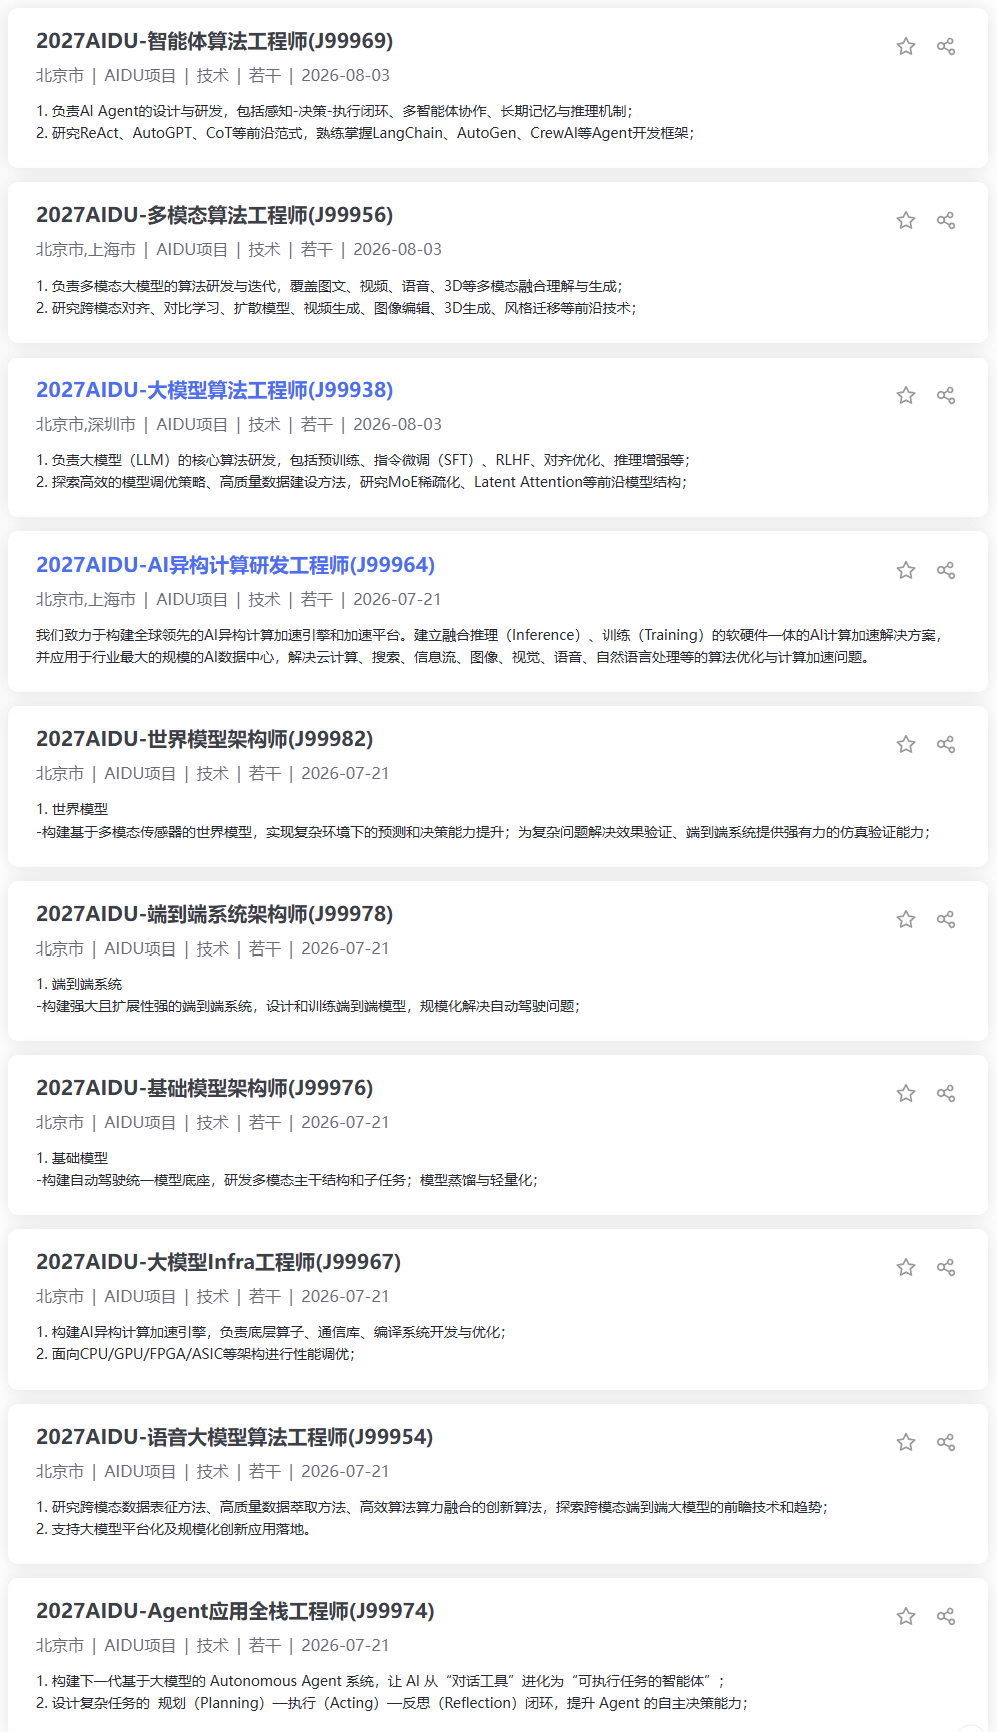
△可上下滑动,点击查看大图
部分岗位详情
2027AIDU-Agent应用全栈工程师
【工作内容】
【职位要求】
2027AIDU-智能体算法研究员
【工作内容】
【职位要求】
2027AIDU-世界模型架构师
【工作内容】
世界模型
-构建基于多模态传感器的世界模型,实现复杂环境下的预测和决策能力提升;为复杂问题解决效果验证、端到端系统提供强有力的仿真验证能力;
-跟踪世界模型前沿技术,探索新技术在实际场景中的应用,保持行业技术领先;
数据与模型迭代
-构建为实现世界模型需要的数据闭环与数据飞轮。
【职位要求】
工作地点
北京、南京、上海、苏州、深圳、郑州、广州、大连、杭州、成都等
腾讯
AI校招岗位
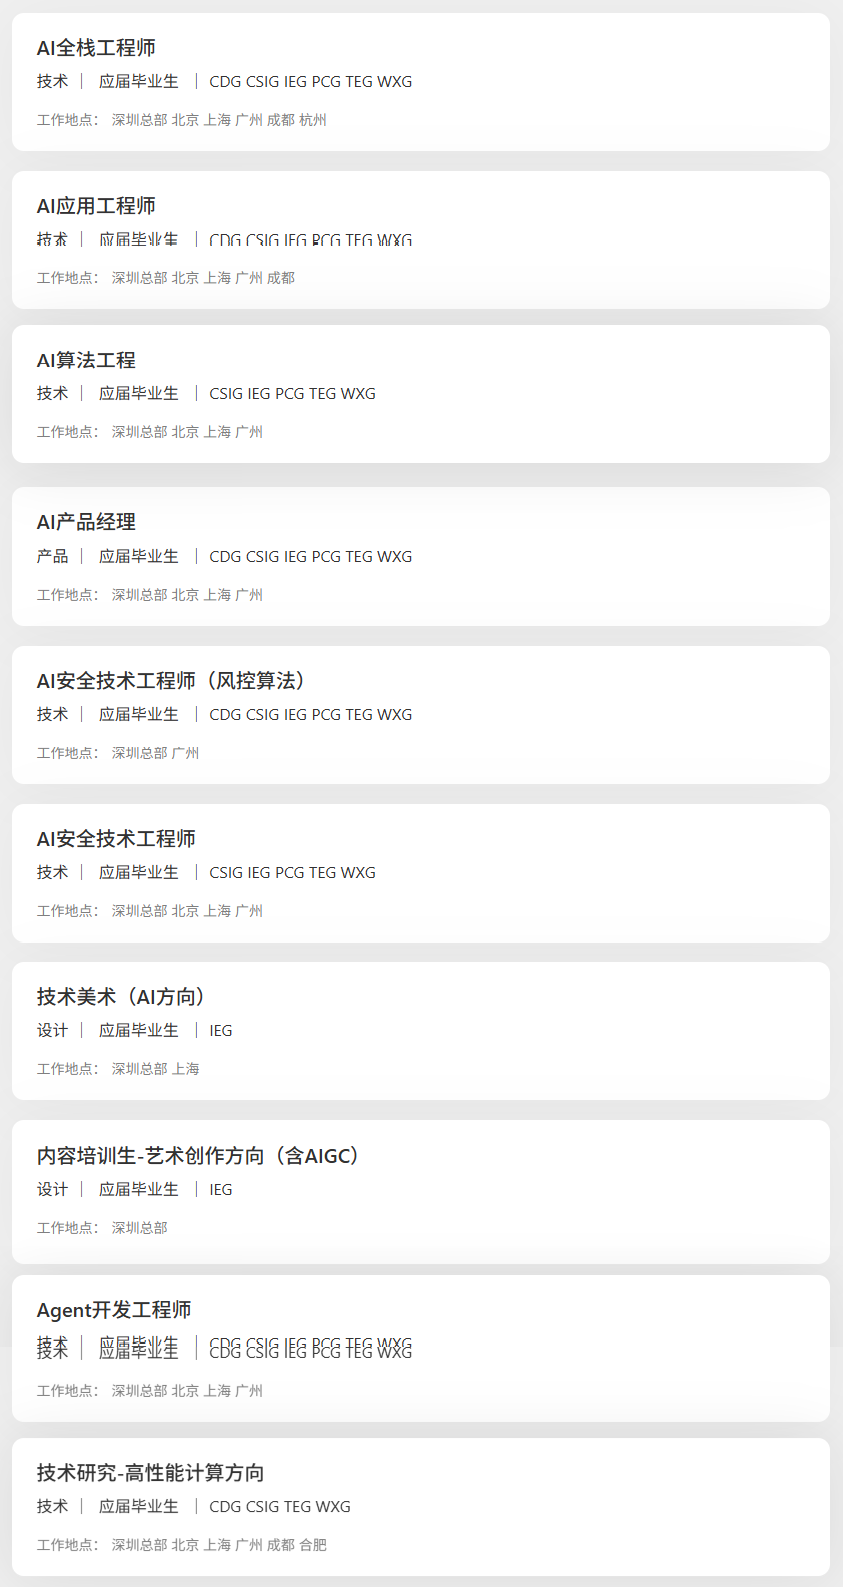
△可上下滑动,点击查看大图
部分岗位详情
Agent开发工程师
【工作内容】
1.负责智能Agent系统的架构设计与开发,包括多Agent协作框架、任务规划与调度、工具调用与执行引擎等核心模块建设;
2.设计并实现Agent的记忆系统、推理链路和决策机制,提升Agent在复杂业务场景下的自主性与可靠性;
3.搭建Agent应用的评测与质量保障体系,建立系统性的效果评估、持续优化与性能、成本管控机制;
4.跟踪Agent技术前沿发展,结合业务需求进行技术预研与落地实践。
【职位要求】
1.熟练掌握至少一门主流编程语言(Python/TypeScript/Go 等),具备扎实的数据结构与算法基础,代码质量意识强;
2.深入理解Agent原理与架构,包括 Planning、Memory、Tool Use、Reflection等核心机制;
3.熟悉主流Agent开发框架(如 LangGraph、AutoGen、CrewAI、MetaGPT 等),有实际搭建经验;
4.了解大模型基本原理,熟悉Prompt Engineering技巧,能设计高质量的系统提示词与工具描述;
5.对AI Agent技术有强烈兴趣,关注行业动态,具备独立调研与技术选型能力;
6.具备良好的系统思维和问题解决能力,能在复杂场景中设计可靠的Agent方案。
AI安全技术工程师
【工作内容】
1.负责跟进研究业界顶尖安全攻防技术,特别关注AI安全前沿领域,结合业务需求落地,保持关键安全技术竞争力优势;
2.负责为通信与社交、数字内容、金融科技、工具软件等产品及服务定制安全方案,包括AI系统的专项安全防护,进行反入侵、反攻击、反劫持和审计等系统工具开发运营和优化;
3.负责安全风险评估与安全方案规划设计及落地,关注AI引入的新型安全风险,负责安全事件应急响应,进行数据生命周期安全建设;
4.探索AI在安全攻防中的赋能应用,持续提升安全防护的智能化水平。
【职位要求】
1.专业不限,有技术洞察力,对安全技术有狂热的追求,对AI安全等新技术有热忱,有意愿在安全领域长期保持专注和投入;
2.熟悉漏洞挖掘、网络安全攻防技术,了解常见黑客攻击手法;对AI安全攻防(如Prompt注入、对抗攻击、模型安全评估等)有兴趣和探索意愿;
3.熟练使用C/C++/Rust等至少一门语言,熟悉Python/Java/PHP/Go等至少一种程序开发语言;
4.对数据库、操作系统、网络原理等计算机学科基础知识有较好储备;
5.了解AI/大模型的基本原理者优先,对AI+安全交叉领域有持续关注。
AI产品经理
【工作内容】
1.定义AI产品方向:洞察用户场景中"“AI能创造增量价值”"的关键节点,完成AI产品的需求定义、方案设计和效果验证,推动从概念到上线的完整闭环;
2.驾驭AI技术边界:深入理解大模型(LLM/MLLM)、Agent架构、RAG、多模态等核心AI技术的能力与局限,能准确判断“什么该用AI做、什么不该用“,与技术团队高效对话;
3.设计AI交互体验:探索AI驱动的新型交互范式——对话式界面、生成式UI、主动式智能推荐、Agent多步推理等,持续打磨AI产品的用户体验,建立独特的AI产品体验指标(如准确率、幻觉率、用户信任度等);
4.驱动AI产品增长:通过数据实验(A/B测试、用户行为分析、AI使用漏斗等)持续优化产品策略,追踪AI产品的留存、付费转化和用户满意度,用数据验证直觉;
5.追踪AI前沿:保持对AI行业动态的敏锐关注,及时将前沿进展转化为产品机会。
【职位要求】
1.具备敏捷的洞察和思维能力,并且能把思考变为现实以不断满足用户和客户需求;
2.拥有优秀的逻辑思维与系统分析能力、技术敏感度及商业敏感度;
3.具备优秀的产品Sense和用户同理心,能独立完成从用户洞察到产品方案的全流程思考。
工作地点
中国、海外
阿里巴巴
AI校招岗位
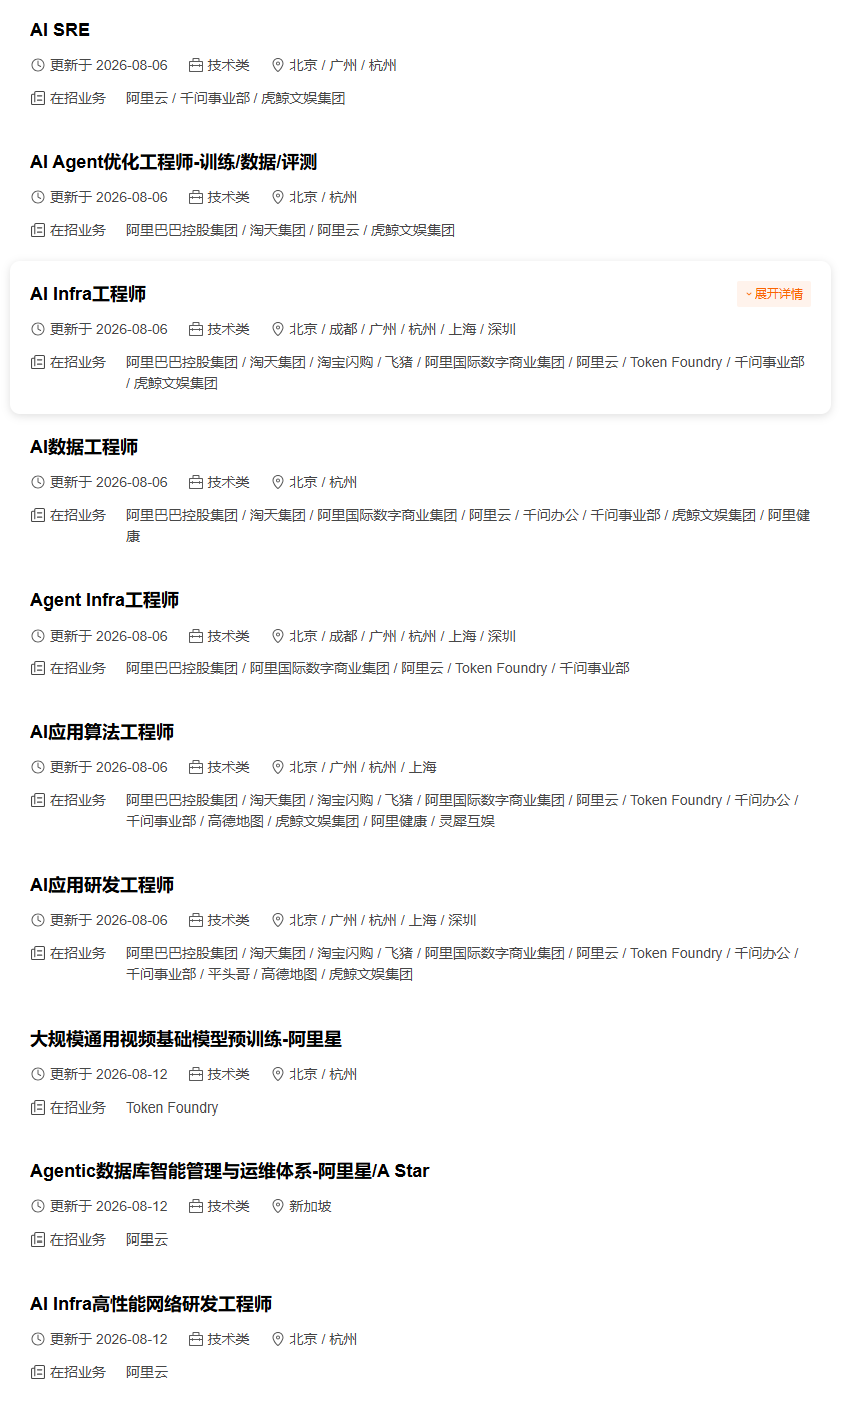
△可上下滑动,点击查看大图
部分岗位详情
AI应用研发工程师
【工作内容】
1.需求理解与归因:
● 深入业务场景,利用数据挖掘与特征分析完成现象归因;精准识别高价值问题,将模糊的业务痛点转化为明确的 AI 解决目标。
2.架构设计:
● 面向具体业务需求,设计 AI 原生系统架构;参与 Agent 系统核心模块的规划,包括记忆管理、推理策略与工具编排,兼顾架构的灵活性、可扩展性与工程可落地性。
3.知识与环境构建:
● 搭建AI与现有业务系统的交互环境,涵盖 API 接入、RAG 知识库构建、记忆方案设计;持续优化召回质量与上下文注入策略,为模型提供准确、及时的执行环境与知识支撑。
4.核心能力实现:
● 负责Agent关键模块的工程落地,实现意图识别、任务拆解与反思纠错闭环;封装标准化SDK/API服务,构建Agent观测体系,实现全链路追踪与多维归因分析。
5.系统迭代与演进:
● 建立搭建自动化评测与回测机制,通过调优与Case分析不断收敛效果与性能提升的最优路径;沉淀方法论与可复用组件,推动 AI 能力从单点验证走向规模化落地。
6.性能优化:
● 优化高并发场景下的系统性能,通过异步处理与降级策略保障稳定性,通过低侵入性观测手段保障系统的长期稳定运行。
【职位要求】
1.基础条件
● 计算机、软件工程、人工智能等相关专业优先。
2.专业能力
● AI编程工具重度玩家:Cursor、Claude code等AI编程工具重度或顶级玩家,具备极强的Prompt编写与调优能力,有过完整的项目级开发经验,理解如何让AI写出生产级代码。
● 大模型能力理解与掌握:理解主流LLM的能力与局限,能够清晰拆解任务并通过LLM或确定性逻辑兜底实现;熟悉主流大模型的应用范式(Context Engineering、Prompt Engineering、Agent、工具/函数调用等等)及主流Agent框架(如LangChain等),具备大模型幻觉、Prompt注入等风险的工程化应对思路。
● 扎实的代码和工程能力:具备扎实的计算机基础知识,深入理解数据结构、算法、网络和操作系统等相关知识,能至少在一种主流编程语言(如 Java / Python / JS 等)上有深度的实践经验,掌握常见工程实践并具备优秀的Coding 能力,能够根据场景灵活选型并快速上手。
3.能力特质
● 学习能力: 具备快速啃透前沿论文(Paper)的能力,并能将理论知识转化为工程代码。
● 开放性与动手能力: 拒绝纸上谈兵,有自己独立完成的小项目(开源项目或个人 Demo),展现极客精神。
● 好奇心与想象力: 面对未知事物有独特的想法,具备敏锐的问题定义能力和坚韧的解决问题能力。
● 审美追求: 技术亦有审美,鼓励你提出能提出打动人心、简洁优雅的好想法。
● 高能动性: 具备强烈的自驱力,能够主动探索边界,而不是等待被分配任务。
AI数据工程师
【工作内容】
1.全模态数据处理:
● 参与研发万亿级数据规模的全模态数据处理引擎。
● 通过设计高性能、可复用的数据处理算子,构建覆盖全生命周期的自动化数据生产pipeline。
● 解决海量数据在清洗、脱敏及增强过程中的计算瓶颈,利用智能筛选与精准对齐算法交付极具竞争力的高质量训练集。
● 持续优化全链路交付效能,确保数据质量与处理规模世界领先。
2.大模型数据理解与资产体系建设:
● 参与全模态AI数据基础设施建设。 负责设计支撑AGI 演进的多模态语义标签标准与特征映射体系,通过构建先进的质量度量模型与内容理解框架,实现对海量 3D、视频、音频等复杂数据的自动化精炼,精细化的数据理解体系加速AGI发展的科学性与高效性。
● 构建核心AI数据战略资产体系。 结合业务垂直场景与最前沿算法,深度参与海量数据的解析、挖掘与性能优化,驱动EB级全模态数据的深度解析与价值发现;通过全链路的智能处理与挖掘优化,将海量数据转化为高稀缺性和行业竞争壁垒的AI数据资产。
3.领域全链路数据策略建设:
● 设计实现面向大模型细分领域的模型性能优化的全链路数据体系,涵盖评测体系设计、数据加工与数据合成链路、数据标注策略设计。
● 深度理解大模型细分领域的技术点,实践“评测驱动”(Evaluation-Driven Development,EDD)的大模型迭代方法,确保千问、万相等基础模型能力持续处于世界领先水平。
【职位要求】
1.基础条件
● 计算机、软件工程、数学、统计、人工智能、大数据、机器人等相关专业硕士/博士优先(非此类专业,有相关经验亦可)。
● 有顶会论文/高影响项目/开源贡献者加分。
2.专业能力
● 大数据处理技术:深入理解大规模分布式数据处理系统原理,熟悉Spark/Flink/Ray等开源技术栈;深入理解流批处理原理(计算模型、调度和资源管理、容错与一致性等);可独立完成面向全模态数据(结构化/文本/图像/音频/视频)的批流一体数据处理开发与优化。
● 大模型技术的理解与掌握:深入理解大模型核心原理,包括Transformer架构、上下文学习(ICL)、指令微调(Instruction Tuning)、检索增强生成(RAG)及推理机制(如思维链CoT)等关键技术;熟悉大模型在预训练、监督微调(SFT)和强化学习对齐(RLHF/RLAIF)等阶段的数据需求与优化逻辑。能够基于领域场景设计高质量数据处理与合成算法,通过系统化的数据迭代、评估反馈与模型微调闭环,持续驱动大模型在特定领域的能力提升与性能优化 。
● AI编程意识与工程思维:能持续快速学习AI研发新范式,熟练运用主流AI工具,独立完成从需求分析、架构设计到高质量代码实现的系统级开发任务,并确保代码的可维护性、可扩展性与工程规范性。
● 跨学科、跨领域的理解: 通过评测及数据驱动的方式提升模型的效果,结合对大模型及垂直领域的深度融合理解,能够设计面向领域的高质量评测集和数据集,针对基础模型短板设计相应的模型训练策略,不断突破基础模型的能力上限。
● 工程与系统素养:能至少在一种主流编程语言(如 Java / Python / C++ 等)上有深度的实践经验,掌握常见工程实践并具备优秀的Coding能力,能够根据场景灵活选型并快速上手。
3.能力特质
● 好奇心:对AI有热情、对前沿技术与产品好奇。
● 持续学习:能快速地学习、掌握新的知识与技术。
● 沟通交流:能与其他人进行良好的沟通、交流,拓宽自身的视野与知识面。
● 认真负责:有责任感,能确保工作完整的闭环、高质量的交付,为团队、合作方提供可信赖的支撑。
AI Agent优化工程师-训练/数据/评测
【工作内容】
1.AI应用全生命周期演进:深度参与业务问题建模、应用架构设计、上下文工程、训练数据构建、自动化评估体系、模型后训练优化等;
2.数据飞轮构建:打造高质量数据生产链路,探索合成数据(Synthetic Data)与高效蒸馏技术方案,跑通“业务-模型-反馈”迭代闭环;
3.评测体系构建:面向业务目标,设计完备的AI应用效果评估体系,构建自动化评估框架,建立离线评估与在线业务指标联动的量化评估能力;
4.强化学习与奖励机制设计:构建可工程化的Reward体系与RL训练环境,提升模型在垂直业务场景中的可控性与泛化能力;
5.AI外部能力体系搭建:实现AI应用所需的知识库(RAG)、长短期记忆系统(Memory)、工具调用、多Agent协作框架等
6.多模态AI应用开发:构建AI应用的多模态感知与推理能力,解决在UI自动化、视觉理解与审核、多模态会话等场景的落地应用问题。
【职位要求】
1.专业要求:计算机、数学、统计学等相关专业硕士/博士优先,优秀本科生不受限制;
2.模型理解与优化:深入理解Transformer和主流LLM模型架构演进原理,对后训练算法有实操经验和深刻认知,拥有Agentic RL训练实操经验者优先;
3.AI应用构建能力:掌握主流AI协议(MCP、Skills等)、记忆系统(Memory)、知识库(RAG),独立开发过具备一定影响力AI应用者优先;
4.代码与工程能力:较强Python编程能力,熟练掌握Pytorch,了解大模型训练与推理框架(Megatron-LM、vLLM、DeepSpeed等),能高效处理分布式环境下的工程问题;
5.数据构建能力:有很强的Data-centric AI的意识,精通后训练所需高质量数据挖掘与构造,具备合成数据(Synthetic Data)与动作轨迹(Trajectory)构建实操经验者优先;
6.评测能力:拒绝盲目调参,能针对Agent任务设计科学的评测体系(LLM-as-a-Judge),能基于评测结果精准分析和定位问题,具备复杂多步任务的量化评估能力者优先。
7.对新技术有近乎本能的渴望,能够独立阅读论文/技术报告等并快速复现,快速主动尝试落地先进开源项目,对主流AI开源项目有贡献者优先。
工作地点
杭州、北京、上海、广州、深圳
科大讯飞
AI校招岗位
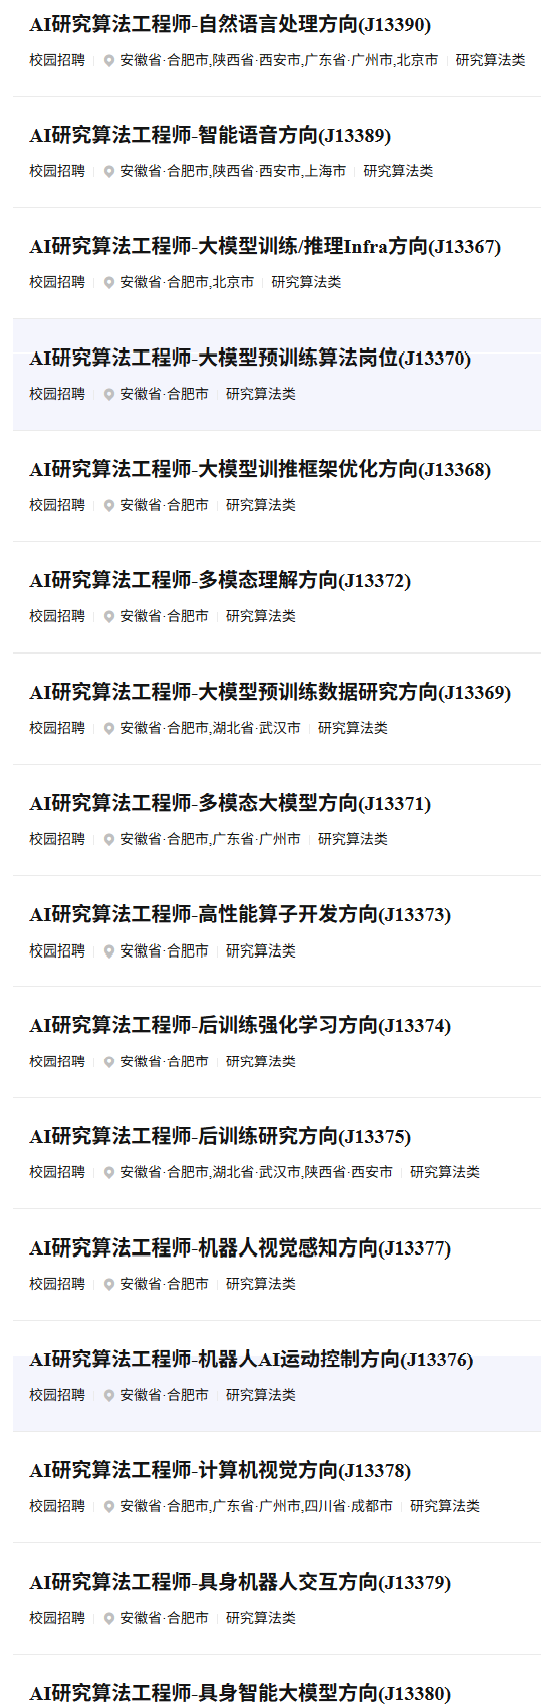
△可上下滑动,点击查看大图
工作地点
合肥、北京、上海、武汉、深圳、广州、杭州、南京、苏州、西安、成都、南昌、济南、郑州、石家庄、长春、昆明、福州、乌鲁木齐等
小米
AI校招岗位
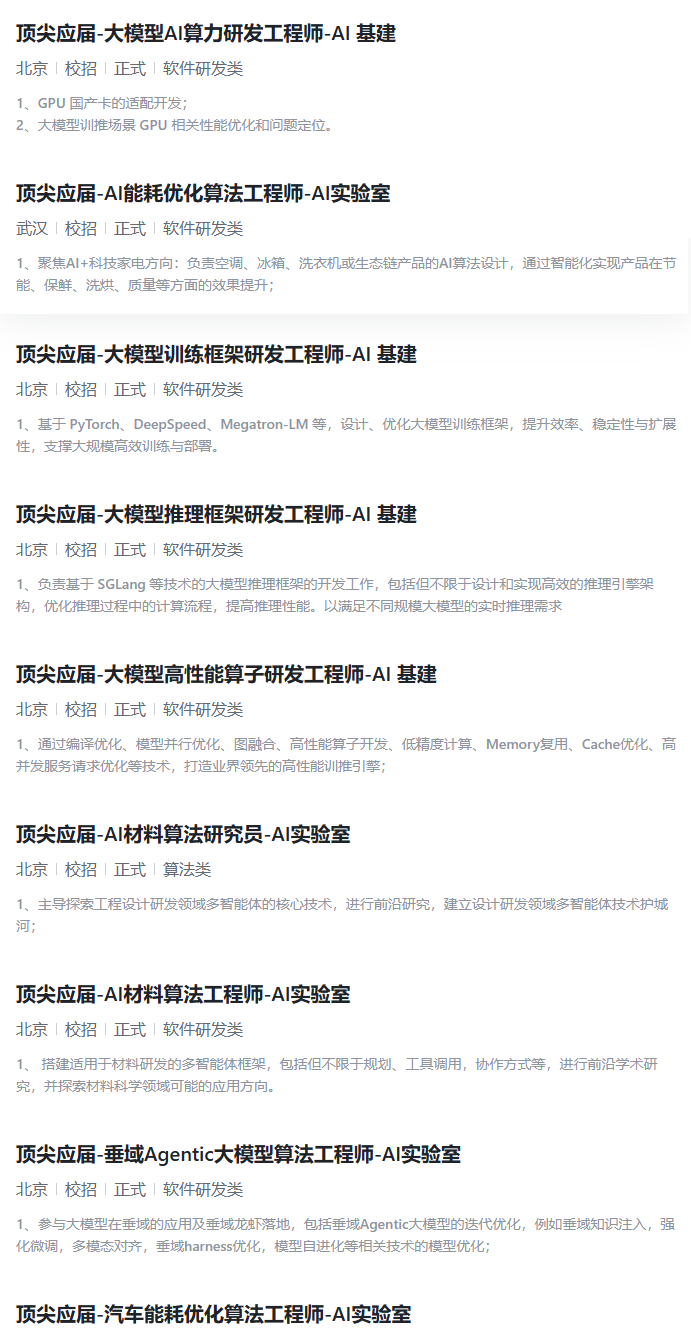
△可上下滑动,点击查看大图
工作地点
北京、上海、南京、深圳、武汉
美团
AI校招岗位
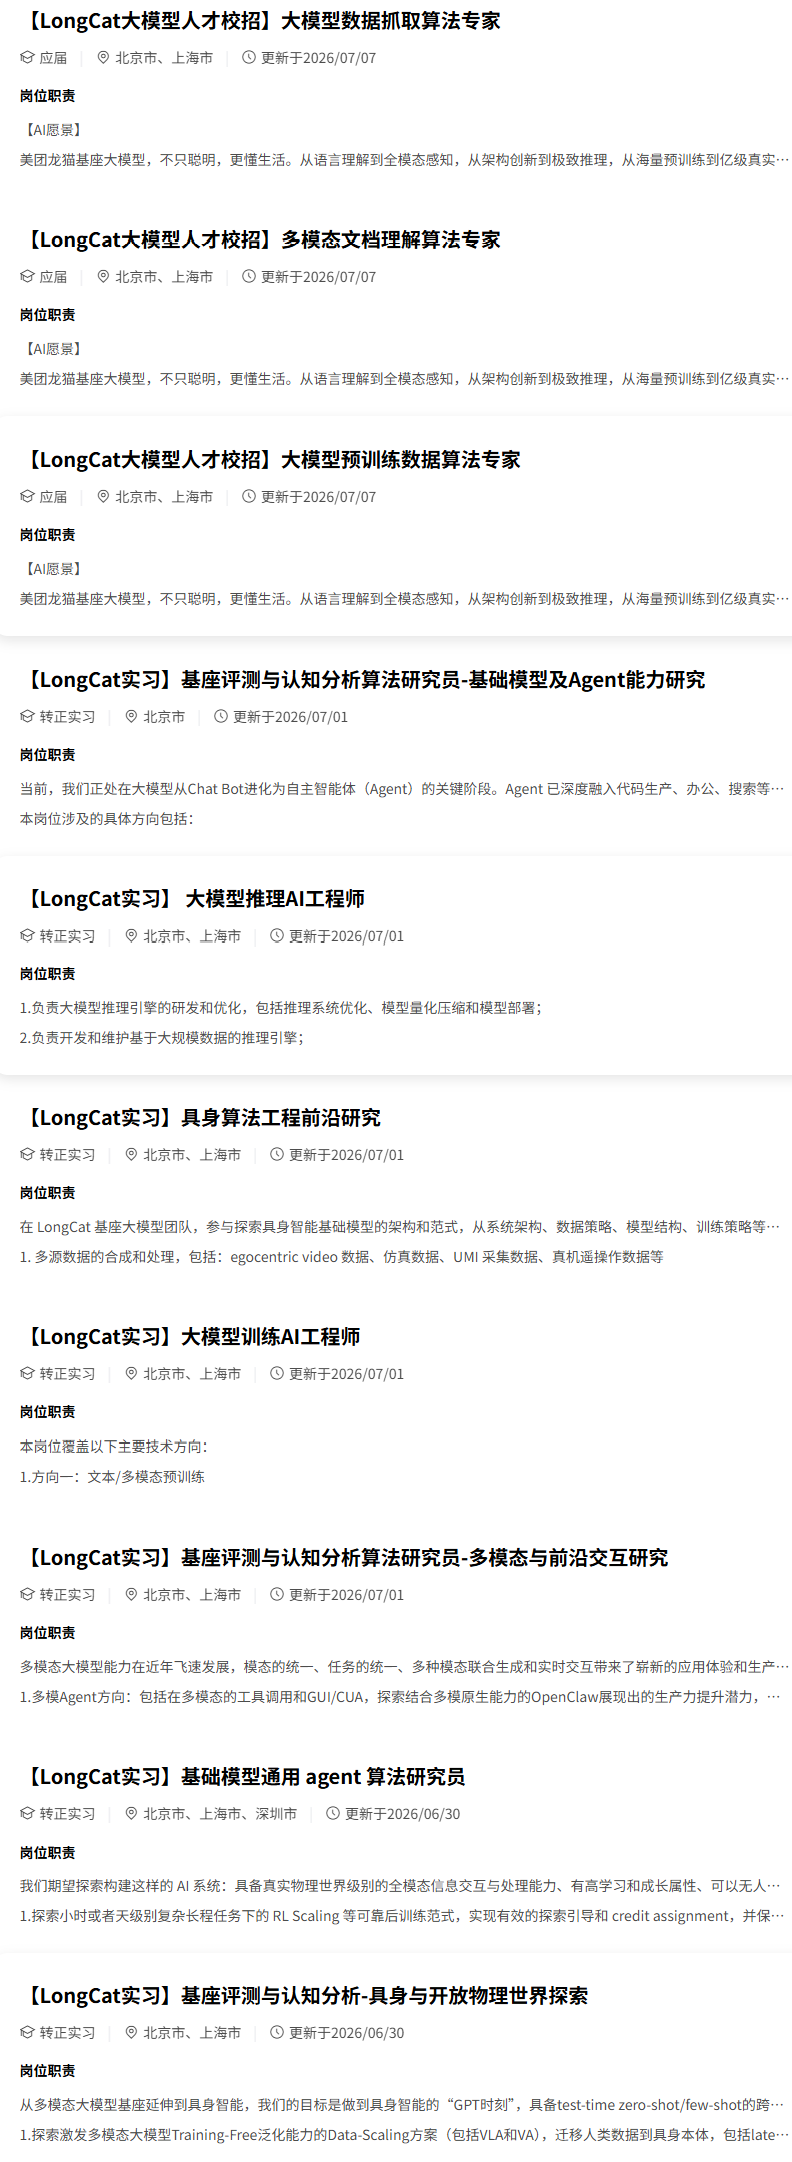
结语:抓住大模型时代的职业机遇
AI大模型的发展不是“替代人类”,而是“重塑职业价值”——它淘汰的是重复性、低附加值的工作,却催生了更多需要“技术+业务”交叉能力的高端岗位。对于求职者而言,想要在这波浪潮中立足,不仅需要掌握Python、TensorFlow/PyTorch等技术工具,更要深入理解目标行业的业务逻辑(如金融的风险控制、医疗的临床需求),成为“懂技术、懂业务”的复合型人才。
无论是技术研发岗(如算法工程师、研究员),还是业务落地岗(如产品经理、应用工程师),大模型都为不同背景的职场人提供了广阔的发展空间。只要保持学习热情,紧跟技术趋势,就能在AI大模型时代找到属于自己的职业新蓝海。
最近两年大模型发展很迅速,在理论研究方面得到很大的拓展,基础模型的能力也取得重大突破,大模型现在正在积极探索落地的方向,如果与各行各业结合起来是未来落地的一个重大研究方向
大模型应用工程师年包50w+属于中等水平,如果想要入门大模型,那现在正是最佳时机
2025年Agent的元年,2026年将会百花齐放,相应的应用将覆盖文本,视频,语音,图像等全模态
如果你对AI大模型入门感兴趣,那么你需要的话可以点击这里大模型重磅福利:入门进阶全套104G学习资源包免费分享!
扫描下方csdn官方合作二维码获取哦!
给大家推荐一个大模型应用学习路线
这个学习路线的具体内容如下:
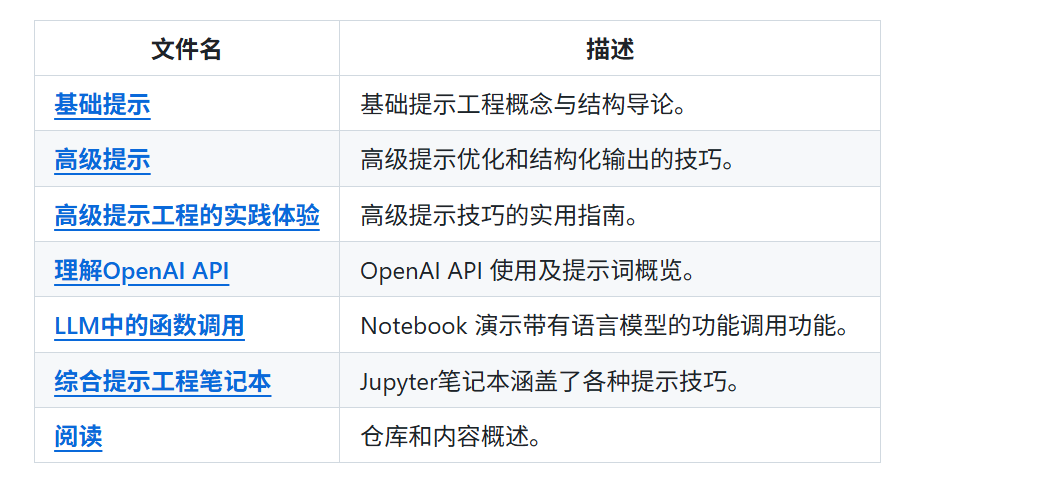
第一节:提示词工程
提示词是用于与AI模型沟通交流的,这一部分主要介绍基本概念和相应的实践,高级的提示词工程来实现模型最佳效果,以现实案例为基础进行案例讲解,在企业中除了微调之外,最喜欢的就是用提示词工程技术来实现模型性能的提升
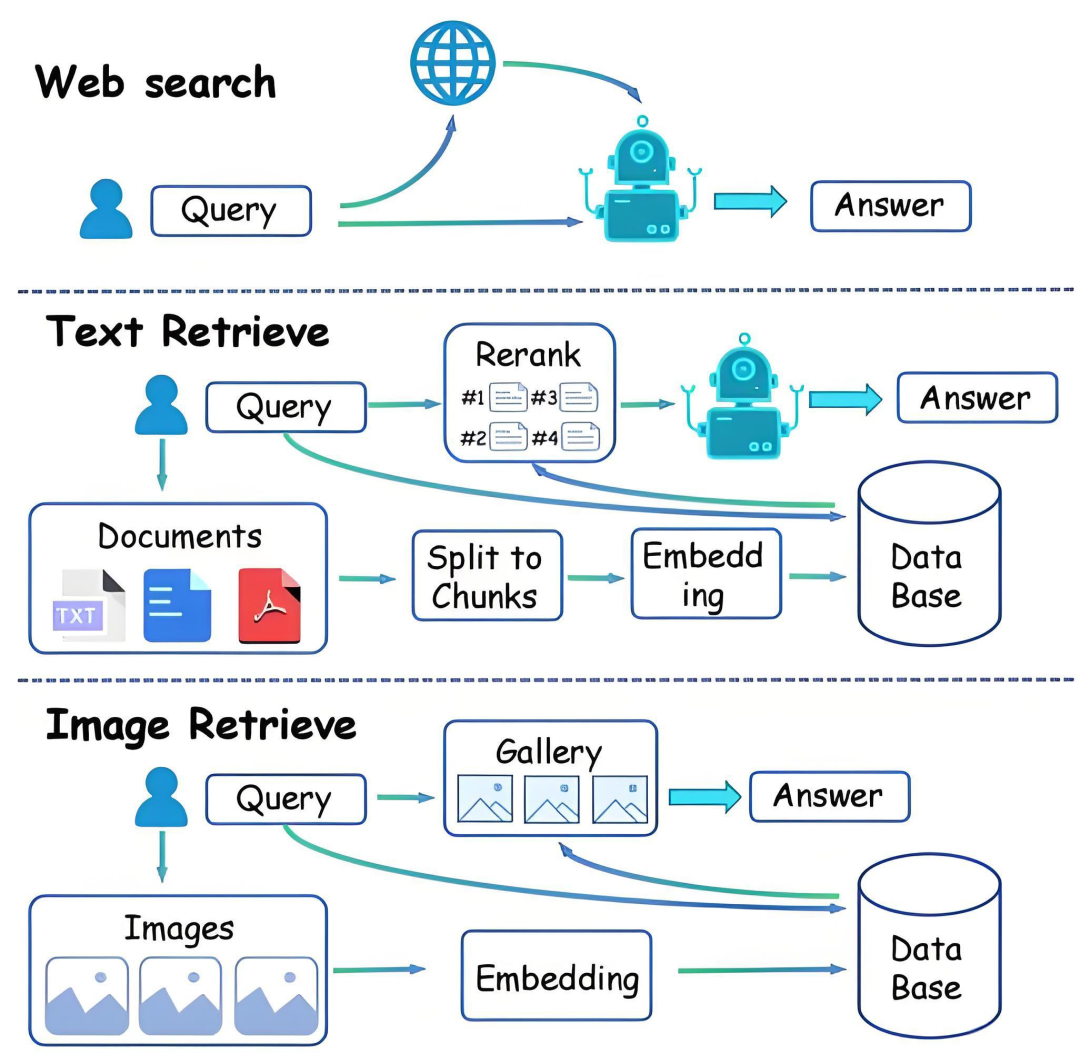
第二节:检索增强生成(RAG)
可能大家经常会看见RAG这个名词,这个就是将向量数据库与大模型结合的技术,通过外部知识来增强改进提升大模型的回答结果,这一部分主要介绍RAG架构与组件,从零开始搭建RAG系统,生成部署RAG,性能优化等
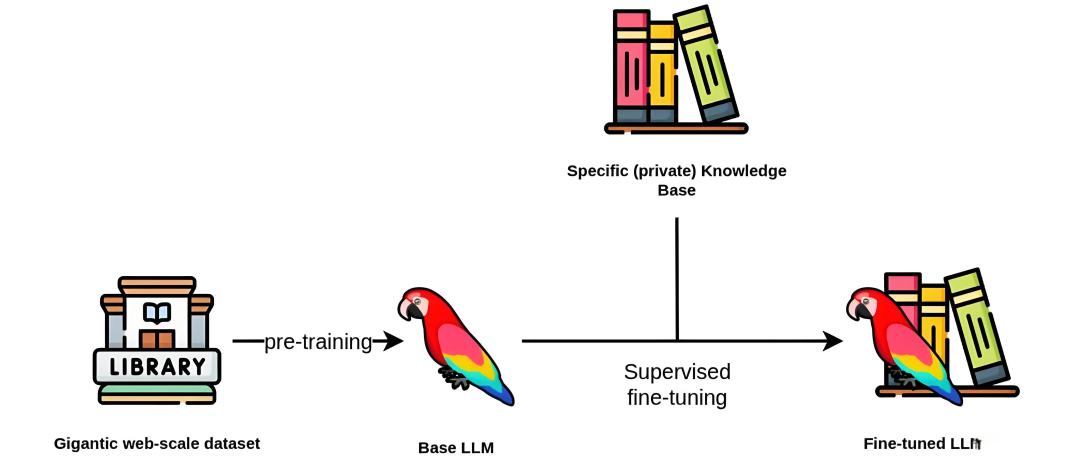
第三节:微调
预训练之后的模型想要在具体任务上进行适配,那就需要通过微调来提升模型的性能,能满足定制化的需求,这一部分主要介绍微调的基础,模型适配技术,最佳实践的案例,以及资源优化等内容
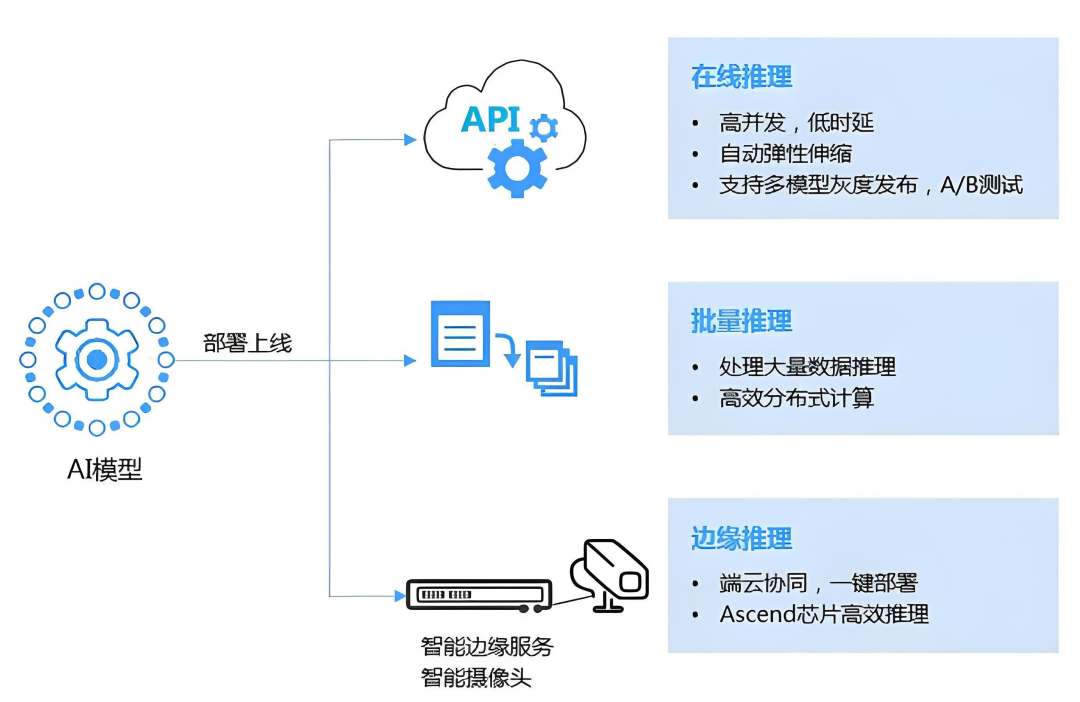
第四节:模型部署
想要把预训练或者微调之后的模型应用于生产实践,那就需要部署,模型部署分为云端部署和本地部署,部署的过程中需要考虑硬件支持,服务器性能,以及对性能进行优化,使用过程中的监控维护等
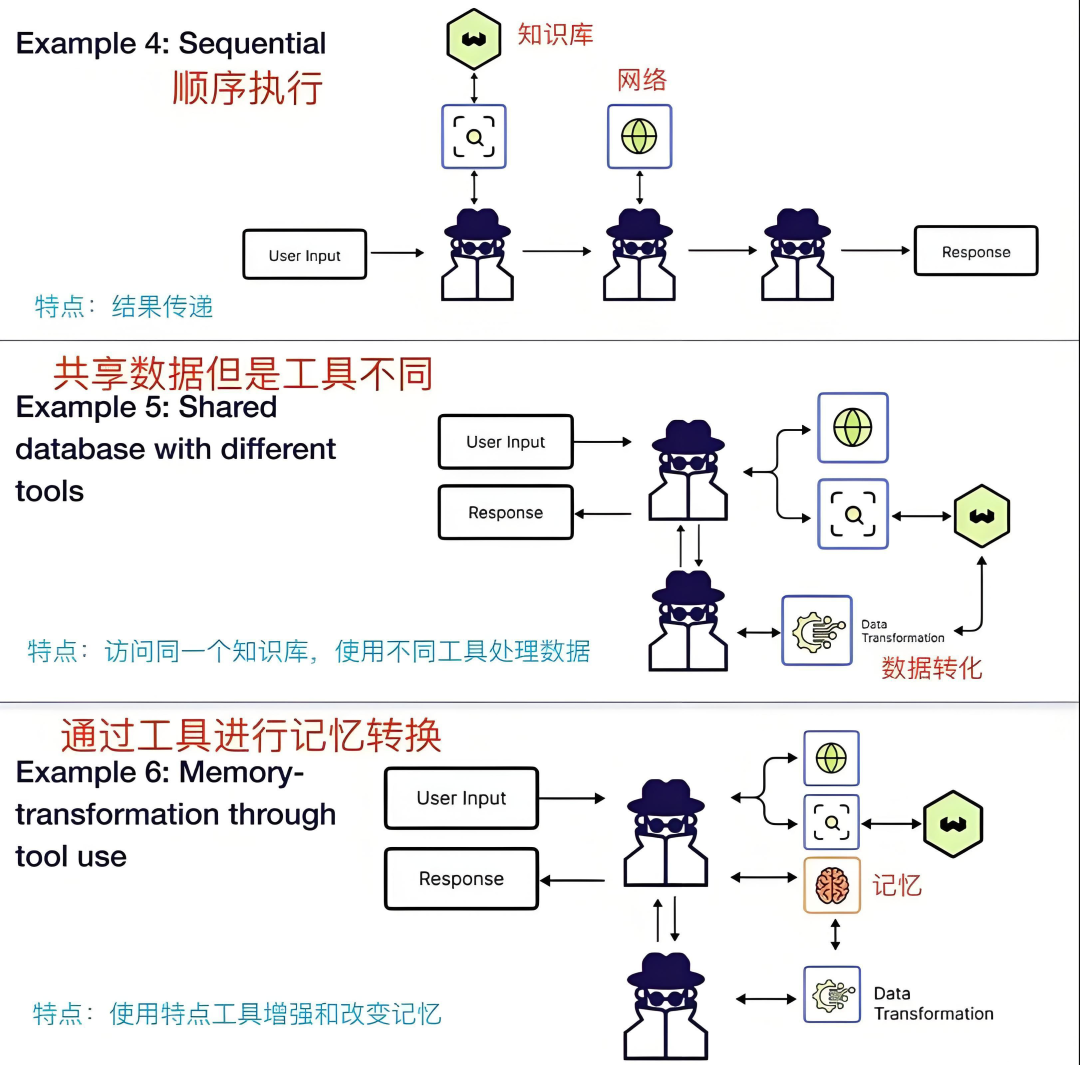
第五节:人工智能系统和项目
这一部分主要介绍自主人工智能系统,包括代理框架,决策框架,多智能体系统,以及实际应用,然后通过实践项目应用前面学习到的知识,包括端到端的实现,行业相关情景等
学完上面的大模型应用技术,就可以去做一些开源的项目,大模型领域现在非常注重项目的落地,后续可以学习一些Agent框架等内容
上面的资料做了一些整理,有需要的同学可以下方添加二维码获取(仅供学习使用)