我是个 AI 重度用户,写作、整理资料、做周报,几乎都让 Obsidian 里的 AI 助手搭把手。2026 年 10 月之前,最让我烦躁的一件事是:AI 记不住我。
具体点说,我有一套自己的标题习惯——正文标题不带句号、小标题控制在十五个字以内、技术文少用感叹号。这套偏好我在台式机上跟 AI 说过不止一遍,它当时改得好好的。可等我换了笔记本继续写,AI 又开始输出一堆带感叹号的标题,仿佛我们从未认识。不是 AI 不聪明,是它的"记忆"没跟着我走。
后来我复盘了一下,问题的根子在于记忆存放的位置。这篇就聊聊 Nutstore Sync 最新版在这件事上带来的变化:AI 长期记忆改为基于库内 Markdown 笔记的方式,偏好、规则、工作流更容易沉淀。以及我是怎么把这套机制用起来的。
插件通过坚果云账号登录,想尝试的先去坚果云官网创建一个坚果云账号:坚果云官网:坚果云官网|网盘|云盘|云服务|团队协作软件|同步盘
1.6.0 的变化:长期记忆改成基于库内 Markdown 笔记
1.6.0 里我最在意的一条更新,就是 AI 长期记忆的升级:记忆不再锁在某次会话或某个账号的角落里,而是落在笔记库内的 Markdown 笔记上。你的偏好、规则、常用工作流,都以普通笔记的形式存在库里。
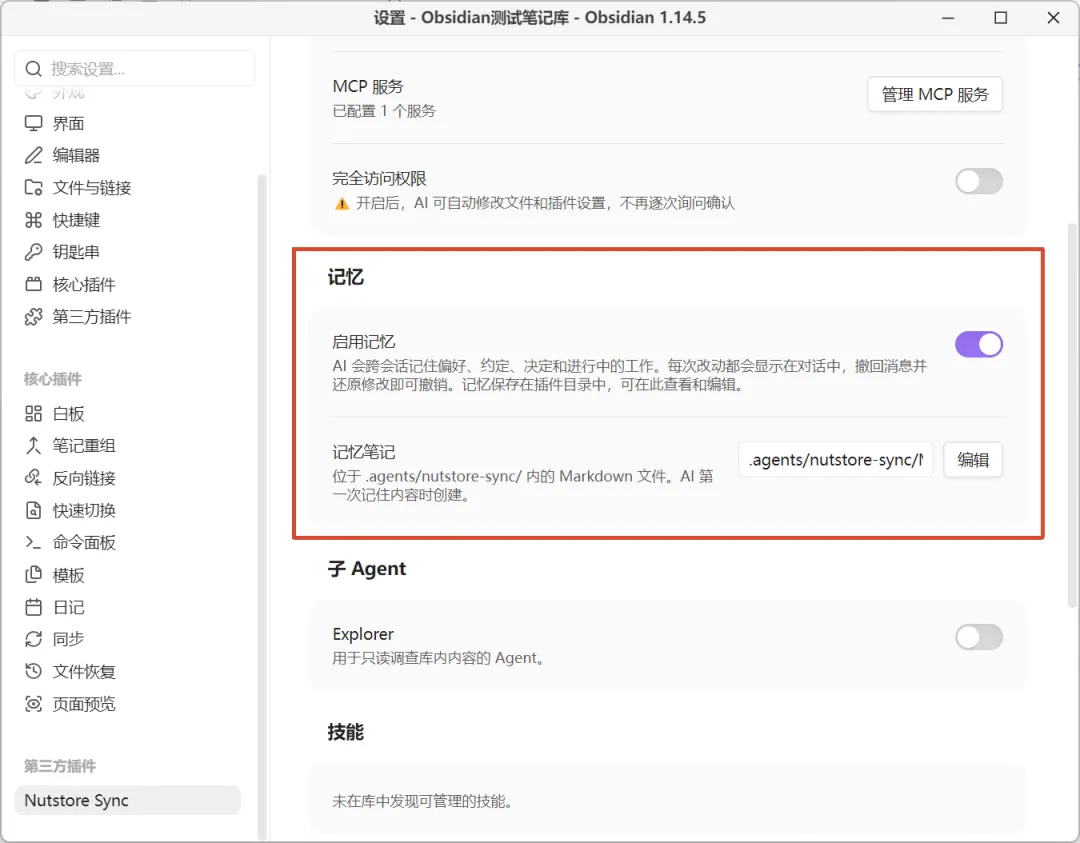
这句话信息量不小,拆开看:
- 偏好可以沉淀:标题风格、语言习惯、格式要求,写进记忆笔记,不用每次会话重新交代;
- 规则可以沉淀:命名规则、目录结构约定、标签体系,AI 每次调用时自动带上这些约定;
- 工作流可以沉淀:你惯用的处理步骤,比如"先摘要、再润色、最后排版",也可以固化下来。
对 AI 重度用户来说,这相当于把"每次都要重新调教的临时工"变成了"带着岗位手册的长期同事"。
为什么这个设计好:记忆是普通笔记,普通笔记有的它都有
我觉得这个设计的聪明之处,在于它没有发明一种新的存储形态,而是复用了笔记库本身最成熟的特性。记忆是普通笔记,所以:
第一,可查看。 AI 到底记住了我什么,打开那篇笔记就能看,不存在黑盒。我不用猜它"以为"我的标题风格是什么,白纸黑字写着。
第二,可编辑。 发现 AI 某条"记忆"不对劲,直接改笔记就行。改偏好不用跟 AI 对话几轮去"纠正"它,改完下次调用就是新的。
第三,随库同步到所有设备。 这是和同步插件组合后最关键的收益:记忆笔记跟着库走智能增量同步,台式机上沉淀的偏好,笔记本、手机、平板打开就是同一份。换设备不丢记忆,这是我过去一年最想要的能力。
第四,配合 .obsidian 配置目录同步,环境和记忆一起到位。最新版之前我就把 .obsidian 目录纳入同步,主题、插件、快捷键、模板跨设备一致(建议把工作区布局和缓存类目录排除在外)。现在再加上库内记忆笔记,等于换一台设备,不仅环境一致,连"AI 对我的了解"也一起搬过去了。
一句话总结这个设计的价值:记忆存在聊天记录里会随会话丢失,存在库内 Markdown 里会随库同步。
我的沉淀实践:三类记忆笔记,一次写好长期受益
升级后我花了一个晚上整理自己的记忆笔记,分成三类:
1. 写作偏好类。 我把标题风格、段落长度习惯、常用句式边界、个人禁用词列表写成一条条规则。以前这些散在我脑子里和几篇旧对话里,现在是一篇可维护的清单。AI 润色和排版时自动带上,输出风格稳定多了。
2. 命名与结构规则类。 我的库有自己的一套约定:日记文件怎么命名、项目目录怎么分层、标签用中文还是英文。以前 AI 新建笔记经常不守规矩,我得每次手动改。现在这些规则进了记忆笔记,新建笔记直接落在正确的位置。
3. 常用工作流类。 比如我处理一篇长资料的固定动作:先摘要、再提取待办、最后按项目给归档建议。写成记忆后,AI 每次调用自动带上这套流程,我只需要说"按老规矩处理这篇"。
实践下来最大的感受是沟通成本的下降:以前每次会话都要花前几句"对齐口径",现在开场就能直接干活。而且这些笔记本身也在库里,我随时能补充和修订——偏好变了,改一行字就行。
与同步能力的组合:记忆笔记走智能增量同步
有人可能会担心:记忆笔记频繁更新,会不会拖慢同步?我的实际体验是不会,原因在于 Nutstore Sync 的智能增量同步——修改笔记只上传变化的数据块,不是整篇重传。
我给记忆笔记加一条规则,可能就改动几十个字,实际传输量就是这几十个字对应的数据块。手机流量下改记忆也不心疼;咖啡馆、高铁的弱网环境里照样能完成更新。而且改动越小,多端同时编辑记忆笔记产生冲突的概率和代价也越低——真冲突了,还有 4 种冲突解决策略兜底:无冲突合并会保留两份修改并标记,不静默丢数据;Diff3 合并生成 Git 风格冲突标记,还能选中标记区域让 AI 理解两边意图帮你取舍。
记忆的沉淀频率越高、颗粒度越细,增量同步的价值就越大。 这两件事是互相成就的。
三种记忆存放方式的对比
聊到这里,可以把常见的三种 AI 记忆存放方式摆在一起看:
| 可迁移性 | 锁在单次会话或单个应用内,换设备基本清零 | 跟随账号,但迁出依赖服务商的导出能力 | 就是库内文件,库搬到哪里记忆跟到哪里 |
| 可查看性 | 要翻聊天记录才能拼凑,难维护 | 多数只能看不能改,或干脆不透明 | 打开笔记即可查看,随时编辑 |
| 随库同步 | 不随库走,多端各记各的 | 在云端但不在库里,Obsidian 内无法直接编辑 | 走智能增量同步,改一个字只传一个字,全设备一致 |
我的结论很直白:对 Obsidian 用户来说,库内 Markdown 是记忆最合理的归宿——因为你的知识本来就在库里,记忆没理由住在库外。
FAQ:关于 AI 长期记忆,我被问得最多的 7 个问题
Q1:升级 1.6.0 后,我原来跟 AI 说过的偏好会丢吗? 升级本身不动你的笔记库。建议升级后先在库里查看记忆笔记的实际内容,把过去散落在对话里的偏好手动整理进去——这本来就是一次难得的偏好盘点机会。
Q2:记忆笔记放在哪里?我能自己建吗? 记忆以库内 Markdown 笔记的形式存在,具体文件位置以插件实际实现为准。动手前先在库里找到对应笔记确认位置,再往里补充内容,不要凭猜测另建文件。
Q3:怎么验证 AI 真的带上了我的记忆? 做个小实验:在记忆笔记里写一条明确规则(比如"所有小标题不超过十五个字"),然后让 AI 润色一段带长标题的草稿,看它是否遵守。遵守了,说明记忆在生效。
Q4:记忆笔记会不会被同步冲突搞乱? 低频编辑基本不会。真出现冲突,无冲突合并会保留两份修改并标记;用 Diff3 合并还能选中冲突标记区域让 AI 帮你取舍。建议记忆笔记固定在一台主力设备上维护,进一步降低冲突概率。
Q5:换了新电脑,AI 的"记忆"怎么迁移? 新电脑装 Obsidian 和插件,OAuth 登录同一坚果云账号,等首次同步完成即可——记忆笔记随库同步到位,配合 .obsidian 配置目录同步,环境和记忆一起恢复,不需要手动搬任何文件。
Q6:把工作规则写进记忆,会不会泄露给坚果云或模型服务商? 分两层看:同步环节由坚果云的加密体系保护(AES-256 加密、分布式存储);AI 处理环节走你自己配置的 API Key 和模型服务,Key 只存本地不上传坚果云。敏感内容是否写入记忆笔记,按你自己公司的数据规范判断。
Q7:记忆笔记写多细合适? 我的经验是写"规则"不堆"例子"。每条规则一句话说清边界,十条以内能覆盖的,不要写成五十条——规则越多,AI 执行的优先级越模糊,维护成本也越高。