GPU 内存管理与命令调度的许多设计都受硬件结构约束。本节从硬件角度介绍 GPU 在系统中的位置、各部件的作用、CPU 与 GPU 跨越 PCIe 互相访问对方内存的流程、GPU 的地址翻译与缓存一致性,以及命令从提交到完成的执行模型。内容不针对特定厂商,各厂商的寄存器与命令包格式不在讨论范围内。
1. 系统拓扑
GPU 在系统中的位置决定了它使用哪种内存,以及 CPU 如何访问这些内存。图 1.4.1 以独立 GPU 为主体,同时画出了集成 GPU 的位置。
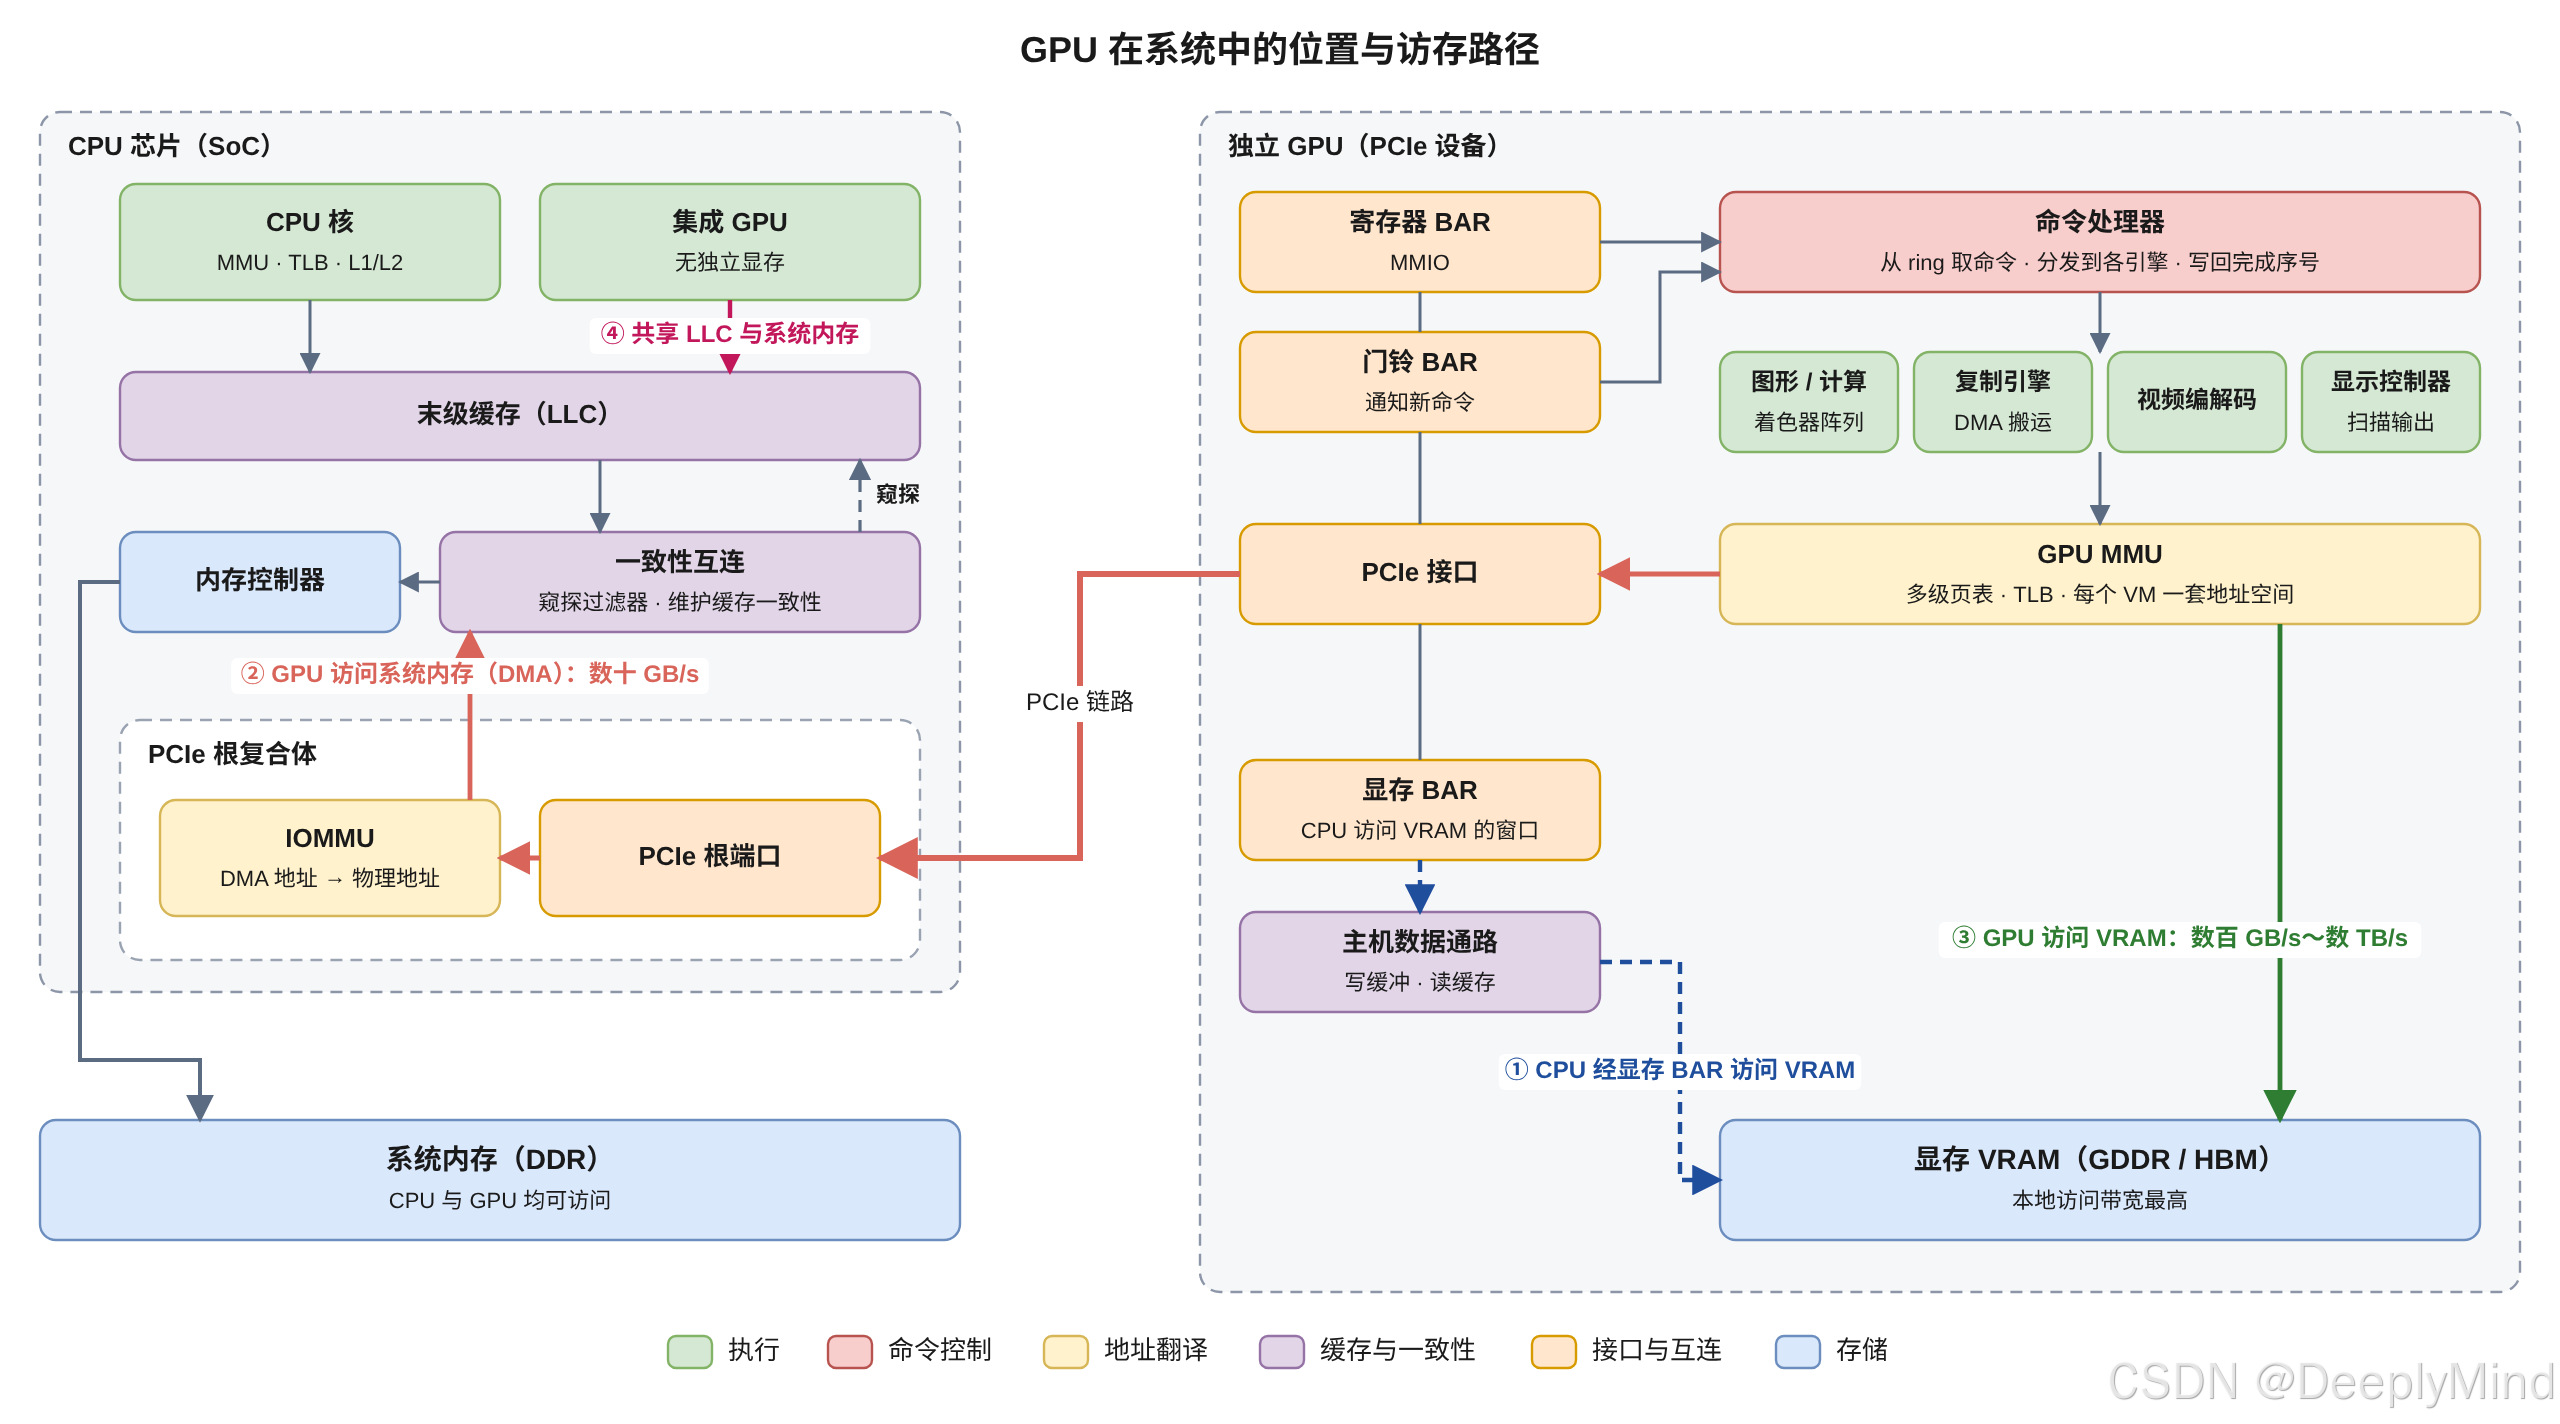
图 1.4.1 GPU 在系统中的位置与访存路径
常见的 GPU 形态有三种。
| 独立 GPU | PCIe 设备 | 自带显存(VRAM),也可访问系统内存 | 本地显存带宽高;CPU 与 GPU 访问对方内存都要穿越 PCIe |
| 集成 GPU | 与 CPU 同一芯片 | 与 CPU 共享系统内存,部分平台共享末级缓存 | 统一内存架构(UMA);固件可在启动时预留一段内存(stolen memory)供 GPU 使用 |
| 嵌入式 SoC | 片上总线 | 共享系统内存 | 显示控制器与 GPU 常为不同 IP 模块;部分模块前端没有 IOMMU,只能访问物理连续的内存 |
图 1.4.1 中标出的四条访存路径的特性如下表所示。
| ① | CPU 访问 VRAM | 写入尚可,读取极慢 | 经显存 BAR 窗口,详见第 3 节 |
| ② | GPU 访问系统内存 | 数十 GB/s | 经 PCIe 与 IOMMU,详见第 4 节 |
| ③ | GPU 访问 VRAM | 数百 GB/s 至数 TB/s | 不出 GPU,带宽最高、延迟最低 |
| ④ | 集成 GPU 访问系统内存 | 与 CPU 访存相当 | 经片上互连,可共享末级缓存 |
路径 ③ 与路径 ② 的带宽相差一个数量级以上,因此对独立 GPU 而言,数据存放在 VRAM 还是系统内存,对性能有决定性影响。
2. 主要部件及其作用
2.1 CPU 芯片一侧
| CPU 核 | 执行指令,发出以虚拟地址表示的访存请求 |
| CPU MMU 与 TLB | 按页表将虚拟地址翻译为物理地址,同时确定该页的内存类型(回写、写合并、非缓存);TLB 缓存最近使用的翻译结果 |
| L1/L2 缓存、末级缓存(LLC) | 缓存最近访问的数据;LLC 通常由所有 CPU 核共享,部分平台与集成 GPU 共享 |
| 一致性互连 | 连接 CPU 核、缓存、内存控制器与 IO 部件;按物理地址将请求路由到内存控制器或 PCIe;借助窥探过滤器或目录记录各缓存行的副本位置,维护缓存一致性 |
| 内存控制器 | 访问 DDR 系统内存 |
| PCIe 根复合体 | CPU 与 PCIe 设备之间的桥梁,包含根端口与 IOMMU |
| PCIe 根端口 | 将 CPU 发往设备的访问封装为 PCIe 事务层报文(TLP),并接收设备发来的 TLP |
| IOMMU | 将设备发出的 DMA 地址翻译为物理地址,并检查访问权限;设备只能访问被显式映射的页面,从而实现设备间及设备与系统之间的隔离 |
2.2 独立 GPU 一侧
| PCIe 接口 | 收发 TLP;按 BAR 地址范围认领 CPU 发来的请求,并将 GPU 发往系统内存的访问封装为 TLP |
| 寄存器 BAR | 将 GPU 的控制寄存器映射到 CPU 地址空间(MMIO),用于初始化、中断控制与引擎管理 |
| 门铃 BAR | 每个命令队列对应一个门铃地址,CPU 写入即通知 GPU 该队列有新命令 |
| 显存 BAR | CPU 访问 VRAM 的地址窗口 |
| 主机数据通路 | 位于 PCIe 接口与显存控制器之间,承载 CPU 经显存 BAR 对 VRAM 的读写,部分厂商称为 HDP(Host Data Path);通常带有写缓冲与读缓存,且不经过引擎侧的 GPU 缓存,需要通过寄存器或命令显式刷新与失效 |
| 命令处理器(CP) | 从命令队列中读取命令,解析后分发给各执行引擎,并在命令完成后写回完成序号 |
| 执行引擎 | 图形与计算引擎执行着色器程序;复制引擎在内存之间搬运数据;视频引擎负责编解码;显示控制器将帧缓冲区扫描输出到显示器 |
| GPU 缓存 | 引擎内部的 L1 与全局共享的 L2 等多级缓存,与 CPU 缓存之间没有硬件维护的一致性 |
| GPU MMU 与 TLB | 将 GPU 虚拟地址翻译为 VRAM 地址或 DMA 地址;每个地址空间一套页表 |
| 显存控制器与 VRAM | 访问本地显存(GDDR 或 HBM) |
| 中断控制器 | 将命令完成、缺页、错误等事件以中断形式通知 CPU |
3. CPU 访问 VRAM 的流程
CPU 无法直接寻址 GPU 的显存,只能通过显存 BAR 这一地址窗口间接访问。一次访问经过的部件如图 1.4.2 所示。
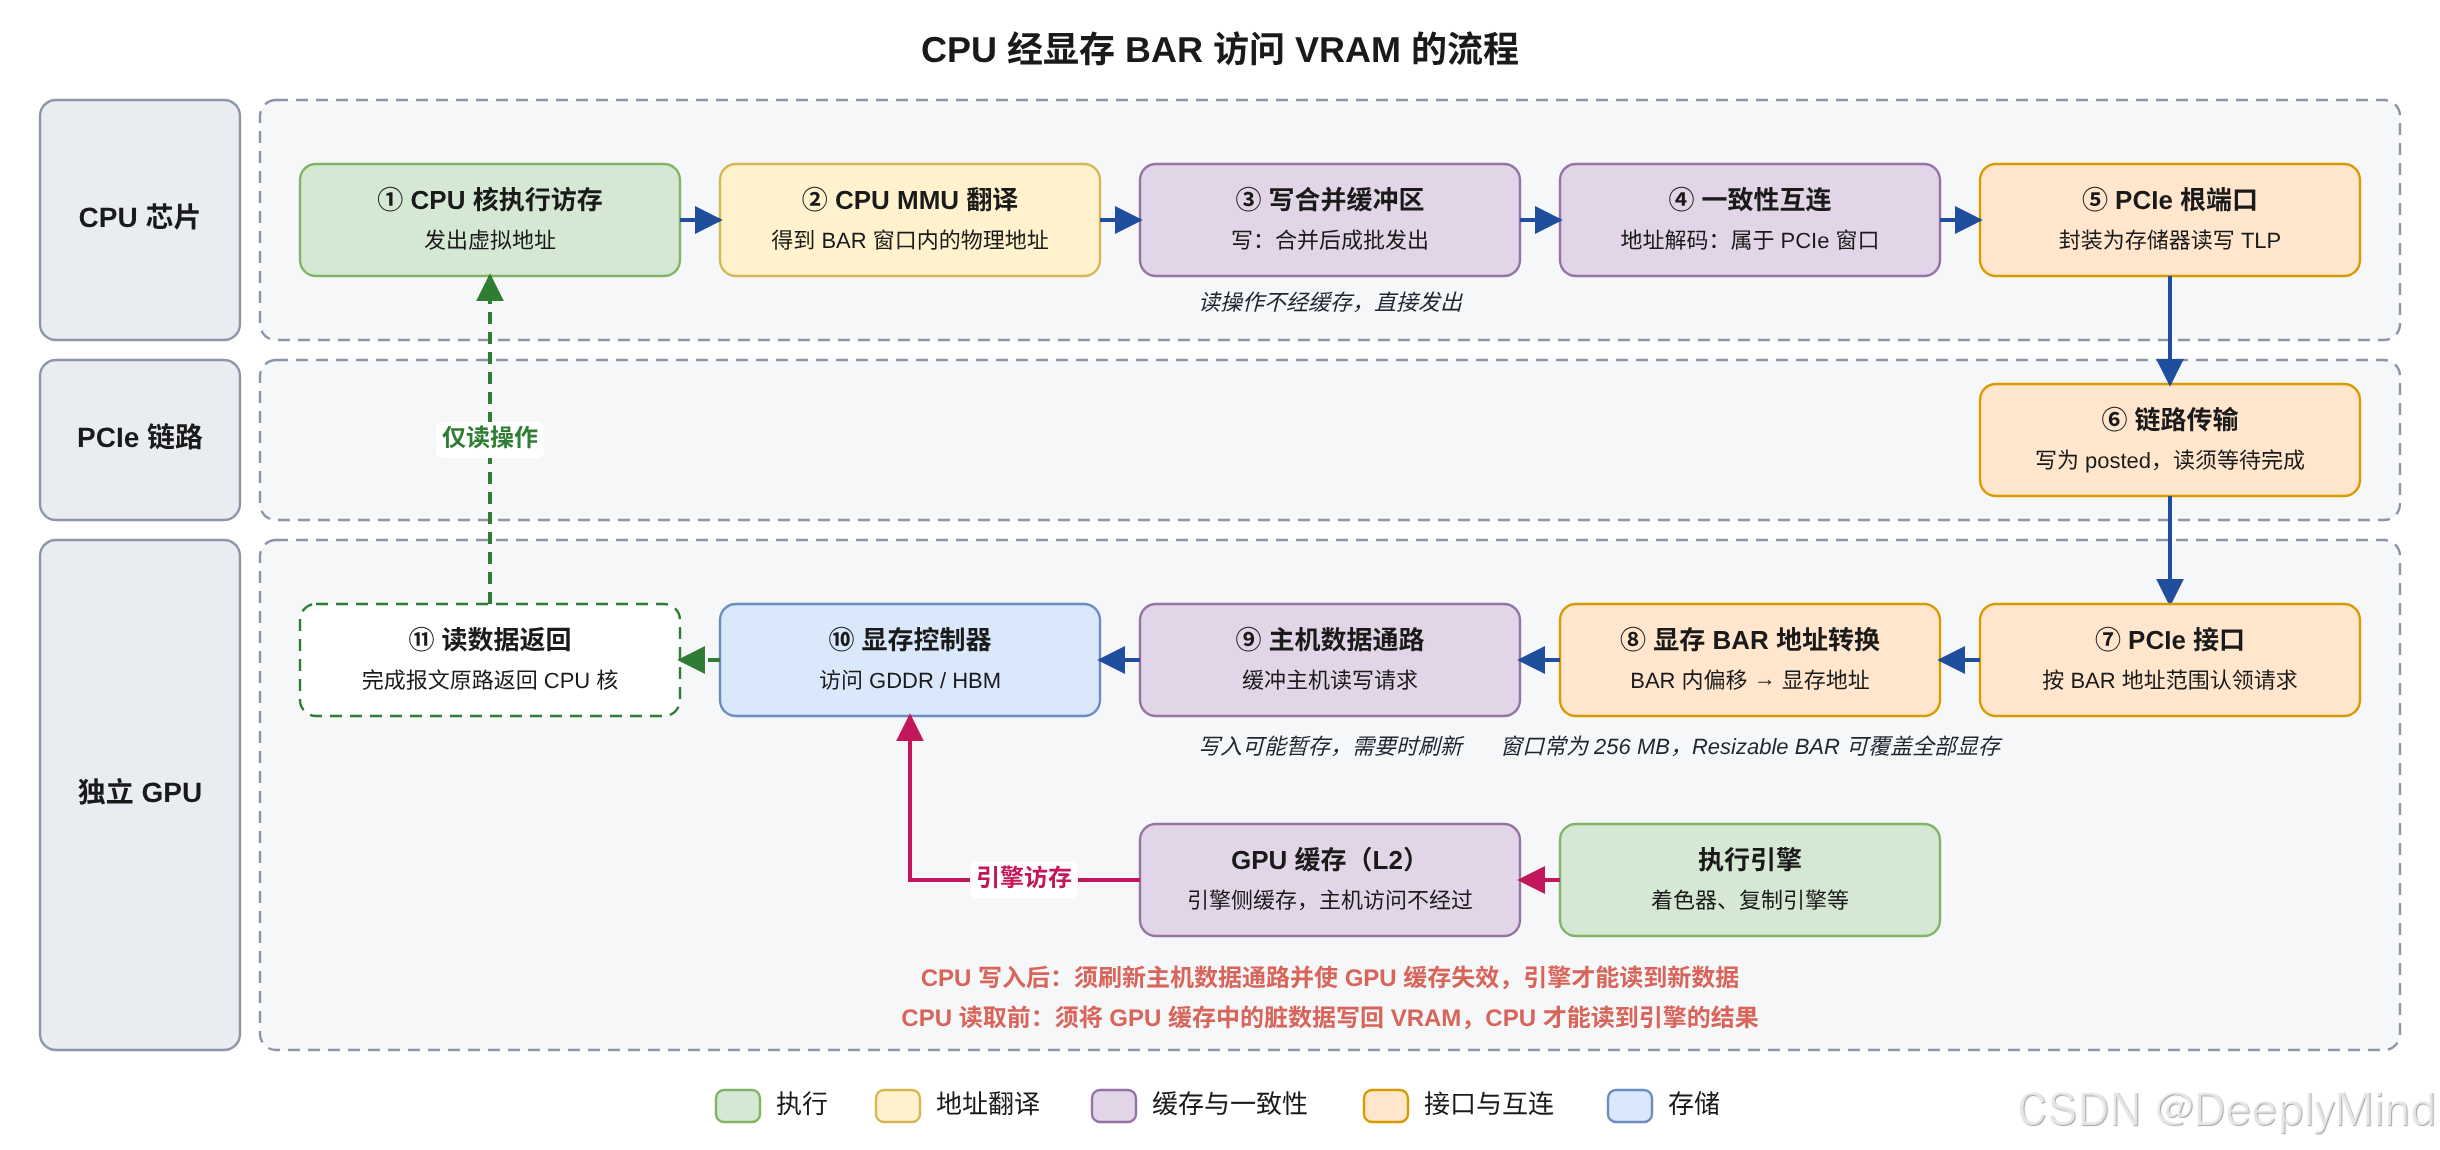
图 1.4.2 CPU 经显存 BAR 访问 VRAM 的流程
这一流程带来四项硬件约束。
读取远慢于写入。写合并使写操作可以连续发出而不必等待;读操作每次都要往返 PCIe,并等待完成报文,延迟以微秒计,且无法利用 CPU 缓存。因此 CPU 应避免从 VRAM 读回数据,需要读取时宜由 GPU 将数据复制到系统内存。
窗口大小有限。为兼容 32 位地址空间,许多平台默认只为显存 BAR 分配 256 MB 的窗口,远小于显存容量,CPU 只能访问其中一部分 VRAM。PCIe 的 Resizable BAR 特性允许将窗口扩大到覆盖全部显存,但需要平台固件与操作系统共同支持。窗口无法覆盖全部显存时,VRAM 就分为 CPU 可见与 CPU 不可见两部分。
写入可能被暂存。部分 GPU 在主机数据通路上设有缓冲,CPU 写入的数据可能暂存其中而尚未到达 VRAM。若要求 GPU 引擎立即观察到这些数据,需要先刷新该缓冲。
主机访问不经过引擎侧缓存。执行引擎经 GPU 缓存(如 L2)访问 VRAM,而主机请求经主机数据通路直达显存控制器,两条路径之间没有硬件维护的一致性。CPU 写入后,GPU 缓存中可能仍保留该地址的旧数据,需要使其失效,引擎才能读到新数据;引擎写入的结果可能仍停留在 GPU 缓存中,需要先写回 VRAM,CPU 才能读到。若 GPU 缓存设计为显存侧缓存(位于显存控制器之前、所有请求共同经过),主机访问同样经过它,这一问题随之消失;具体取决于 GPU 架构。
4. GPU 访问系统内存的流程
GPU 访问系统内存时,地址要经过两级翻译:GPU MMU 将 GPU 虚拟地址翻译为 DMA 地址,IOMMU 再将 DMA 地址翻译为物理地址。完整流程如图 1.4.3 所示。
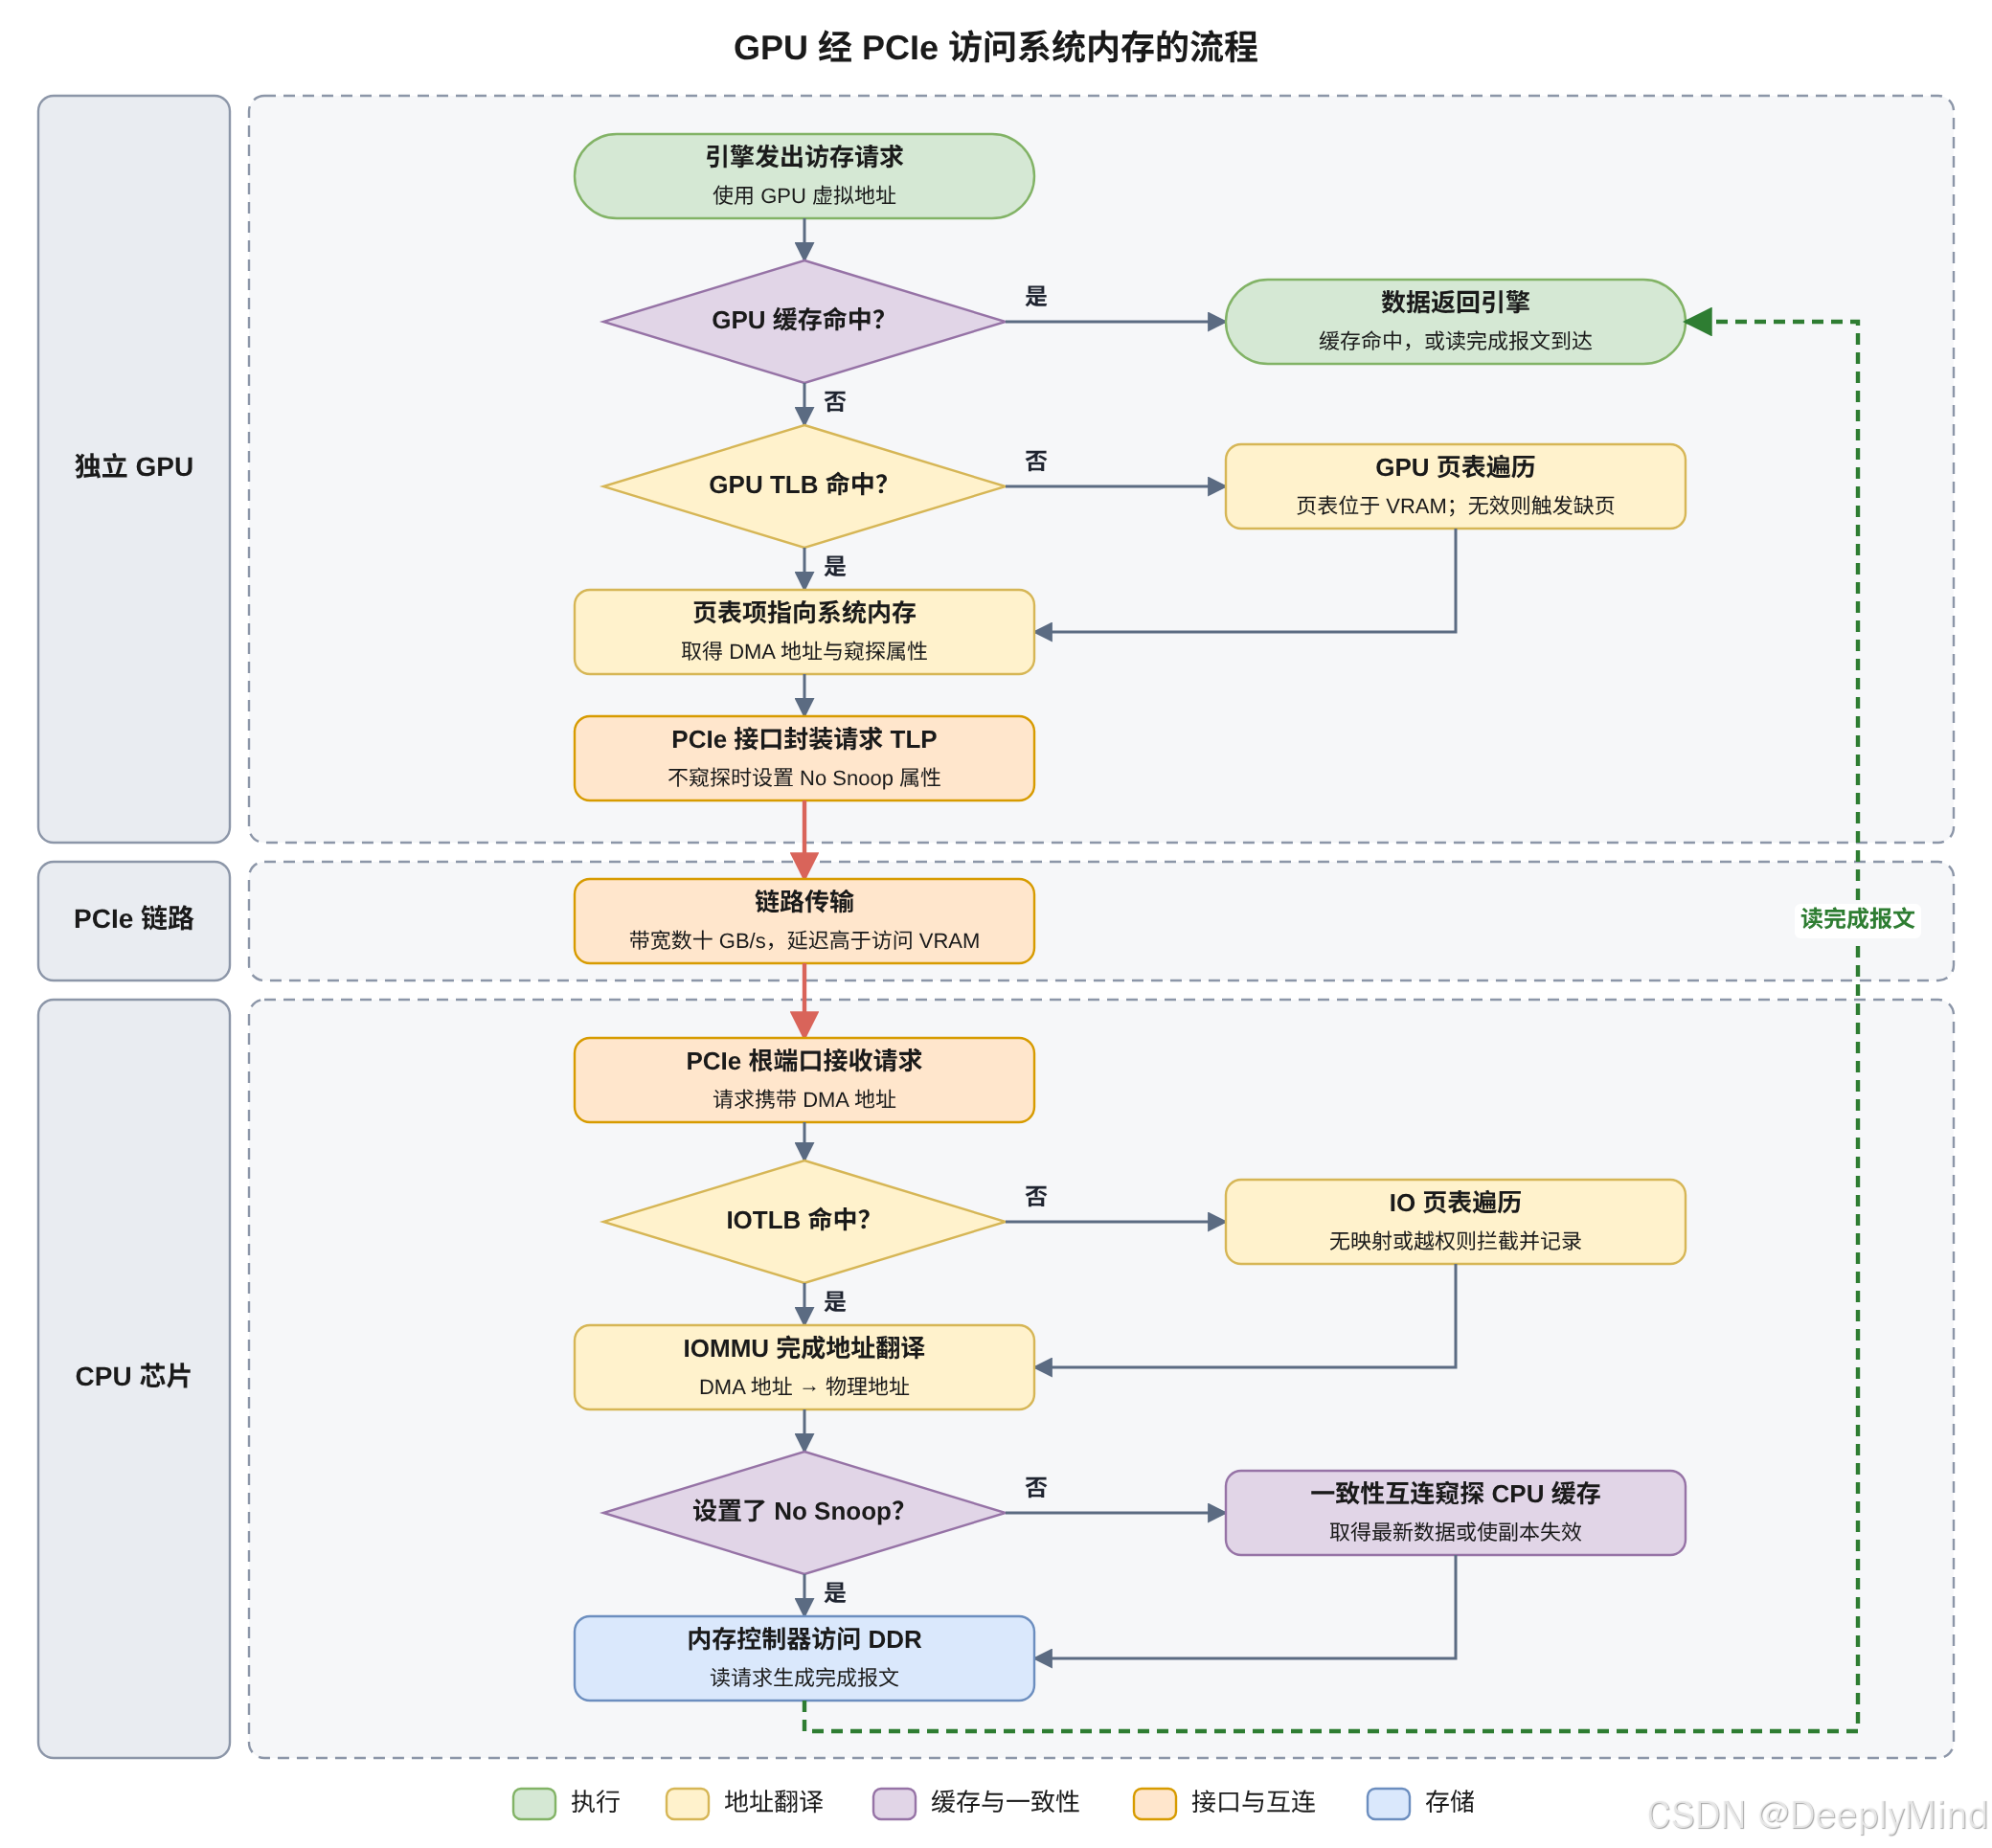
图 1.4.3 GPU 经 PCIe 访问系统内存的流程
关于这一流程,有以下几点需要说明。
DMA 地址不等于物理地址。GPU 发出的是 DMA 地址(又称总线地址)。存在 IOMMU 时,DMA 地址由 IOMMU 翻译;不存在或旁路 IOMMU 时,DMA 地址通常与物理地址相同。因此,写入 GPU 页表的必须是 DMA 地址,而不能是 CPU 看到的物理地址。
物理页通常不连续。一块缓冲区在 GPU 虚拟地址空间中是连续的,对应的系统内存物理页往往是离散的。GPU 页表与 IOMMU 页表都以页为单位建立映射,将离散的页拼接为连续的地址范围。
两级翻译的开销。每级翻译都可能因 TLB 未命中而遍历页表,IO 页表遍历本身还需要访问系统内存,进一步增加延迟。PCIe 的地址翻译服务(Address Translation Services,ATS)允许设备在本地缓存 IOMMU 的翻译结果,以减少这部分开销。
窥探的取舍。窥探访问由一致性互连保证与 CPU 缓存一致,但会增加延迟并占用互连带宽;非窥探访问更快,但 CPU 缓存中可能存有尚未写回内存的数据,GPU 会读到旧值。使用非窥探访问时,CPU 一侧需要以非缓存或写合并方式访问这些页,或在 GPU 访问前显式刷新 CPU 缓存。
5. GPU 地址翻译
5.1 从 GART 到多级页表
GPU 的地址翻译经历了两个阶段。
| GART | 单级页表,将一段连续的 GPU 地址窗口映射到离散的系统内存页 | 全局一张,所有使用者共享 | 使 GPU 能访问不连续的系统内存;源于 AGP 时代的图形地址重映射表(Graphics Address Remapping Table) |
| 多级页表 | 与 CPU 页表类似的多级结构 | 每个地址空间一套,以地址空间标识(如 VMID)区分 | 不同进程的 GPU 地址空间相互隔离 |
现代 GPU 的页表项除物理地址或 DMA 地址外,通常还包含以下属性:有效位、读写与执行权限、目标位置(VRAM 或系统内存)、是否窥探 CPU 缓存、缓存策略,以及用于大页映射的页大小。
5.2 TLB 失效
GPU MMU 同样以 TLB 缓存翻译结果,且 GPU 内部可能存在多级、多处 TLB。修改或撤销页表项后,必须使相关 TLB 项失效,并确认失效已经完成,对应的物理页才能被回收或另作他用,否则 GPU 可能经由陈旧的 TLB 项访问已经不属于它的内存。TLB 失效通常需要通过寄存器或命令触发,并等待硬件确认,具有一定开销。
5.3 缺页处理
早期 GPU 遇到无效地址时,只能报告错误并终止相关上下文,因此命令访问的所有内存必须在执行前完成映射,并在执行期间保持驻留。较新的 GPU 支持可恢复缺页(recoverable page fault):访问无效地址时,硬件暂停相关的执行单元,经中断向 CPU 报告缺页地址;软件建立映射后,硬件重试该访问。这一能力使 GPU 能够像 CPU 一样按需建立映射。可恢复缺页的处理延迟远高于 CPU 缺页,因为报告与重试都要经过中断和 PCIe。
6. 命令执行模型
6.1 命令缓冲区与 ring
GPU 以异步方式执行命令:CPU 将命令写入内存后通知 GPU,随即返回继续其他工作,GPU 稍后执行并报告完成。CPU 与命令处理器之间的接口有两层。
6.2 提交与完成
一次命令提交与完成的过程如图 1.4.4 所示。
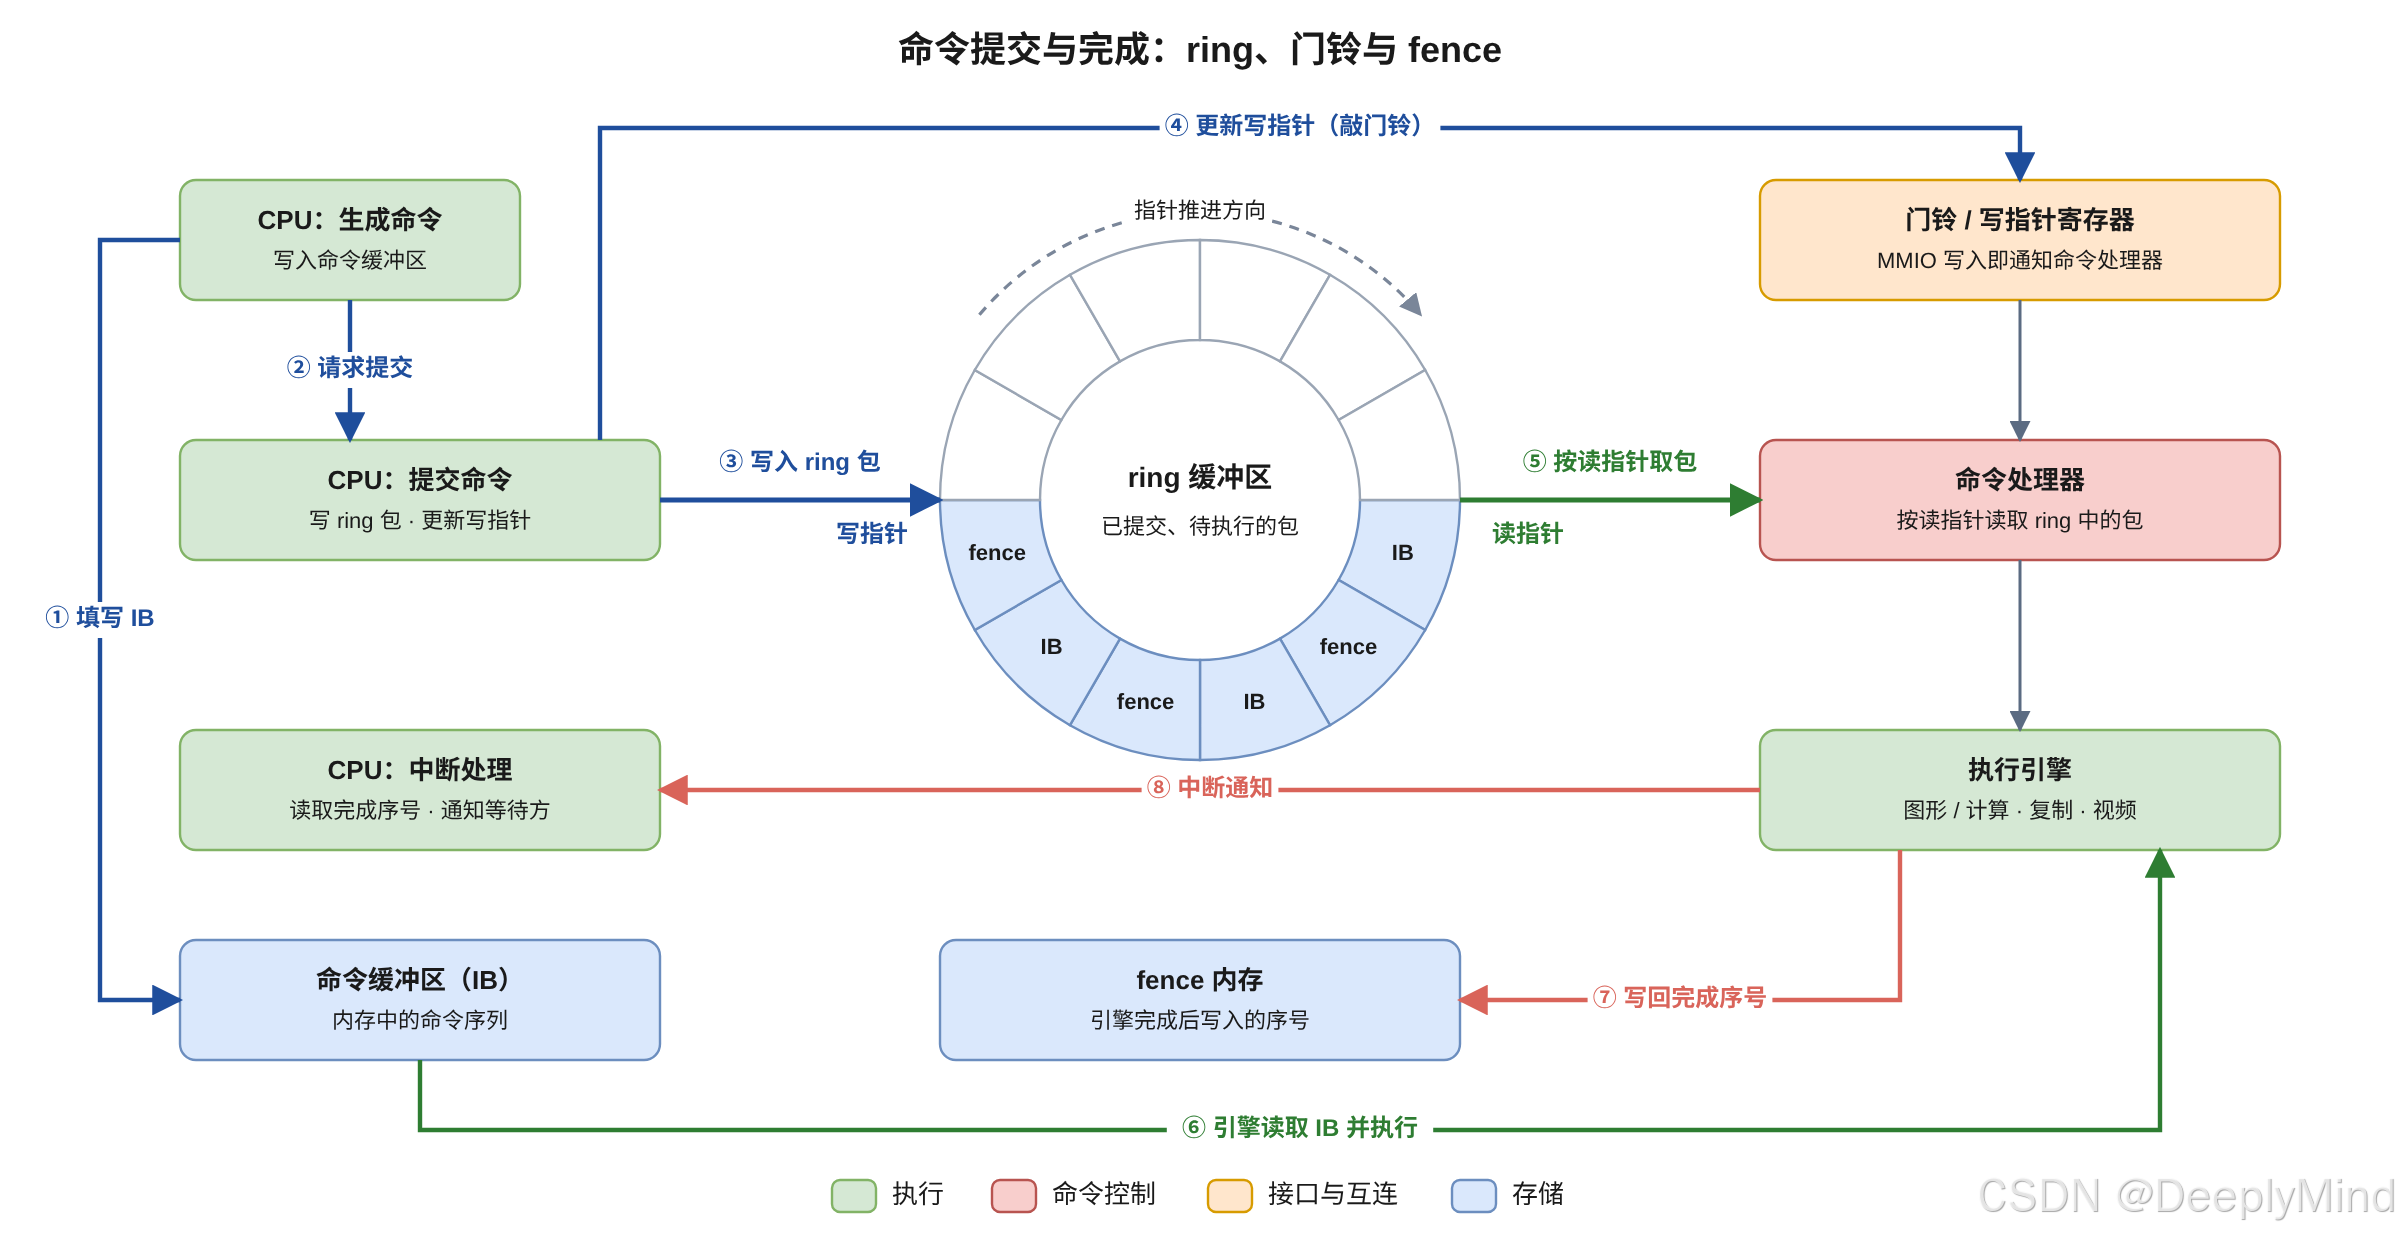
图 1.4.4 命令提交与完成:ring、门铃与 fence
由于同一 ring 上的包按顺序处理,fence 序号单调递增,比较序号即可判断任意一项作业是否完成,无需逐项查询。
6.3 容量、挂起与固件调度
ring 容量有限。写指针追上读指针时 ring 已满,新的提交必须等待命令处理器处理完一部分包。
作业可能挂起。着色器陷入死循环、访问非法地址或硬件异常都可能使作业无法完成,而硬件通常不会主动报告挂起,只能由软件在等待超时后判定,再复位相应的引擎或整个 GPU。复位会丢失正在执行的作业及其上下文状态。
固件调度。较新的 GPU 内置固件调度器,由固件将大量软件队列复用到有限的硬件队列上,并负责队列之间的抢占与切换。部分平台进一步允许应用直接写入自己的队列与门铃,提交无需经过操作系统内核。但 ring、门铃、fence 序号这一基本模型仍然适用。
7. 缓存一致性与内存类型
7.1 CPU 的内存类型
CPU 页表为每个页规定内存类型,决定 CPU 缓存如何对待该页。
| 回写(Write-Back,WB) | 经缓存 | 写入缓存,延后写回 | 普通系统内存 |
| 写合并(Write-Combining,WC) | 不经缓存 | 在写合并缓冲区中合并后发出 | 显存 BAR、供 GPU 非窥探访问的系统内存 |
| 非缓存(Uncached,UC) | 不经缓存 | 逐个直接发出 | 设备寄存器 |
同一物理页若同时以不同内存类型映射,可能导致数据不一致,因此改变一个页的内存类型时,需要先刷新该页在 CPU 缓存中的数据,并使所有 CPU 上相关的 TLB 项失效,开销较大,不宜频繁进行。
7.2 CPU 与 GPU 之间的一致性
如图 1.4.1 所示,一致性互连只负责 CPU 一侧的缓存。CPU 与 GPU 之间的一致性取决于访问方向。
| GPU 窥探访问系统内存 | 一致性互连自动处理 CPU 缓存中的副本 |
| GPU 非窥探访问系统内存 | CPU 一侧以写合并或非缓存方式访问,或在 GPU 访问前刷新 CPU 缓存 |
| CPU 经显存 BAR 访问 VRAM | 以写合并或非缓存方式映射,数据不进入 CPU 缓存;必要时刷新主机数据通路缓冲,并使 GPU 缓存失效或写回 |
| GPU 写入后供 CPU 或其他设备读取 | GPU 缓存不受一致性互连管理,必须将 GPU 缓存中的数据写回内存 |
后两种情况都依赖显式的缓存同步:GPU 的 L2 等缓存中的数据不会自动写回,CPU 也无法窥探 GPU 缓存。
7.3 GPU 缓存同步的触发与时序
在缓存位于引擎一侧的架构中,GPU 并不感知 CPU 对内存的访问:主机经显存 BAR 的读写不会窥探 GPU 缓存,也不会通知命令处理器;CPU 对系统内存的写入同样不会使 GPU 缓存中的副本失效。硬件中也没有持续追踪这些访问的部件。因此,CPU 与 GPU 之间的缓存同步只能在已知的时间点由软件显式触发,通常选在作业的边界,即作业开始前与作业结束时。
同步动作本身由硬件执行,触发方式有以下几种。
| 命令流中的缓存控制包 | 命令处理器执行到该包时,向各级缓存发出写回或失效请求,待全部完成后再处理后续的包 | 作业开始前使 GPU 缓存失效 |
| fence 包附带的缓存操作 | 引擎完成此前的全部命令后,先写回缓存,再写入完成序号 | 保证完成序号可见时,结果已到达内存 |
| MMIO 寄存器 | CPU 写入特定寄存器,直接触发刷新或失效 | 刷新主机数据通路的写缓冲,使其读缓存失效 |
GPU 内的缓存实例数量众多,每个计算单元都有各自的 L1。部分架构为此设有集中的缓存请求控制器,将一次写回或失效请求分发到所有实例,并在全部完成后统一应答。
一项作业从 CPU 准备输入到 CPU 读取结果,缓存同步的完整时序如图 1.4.5 所示。
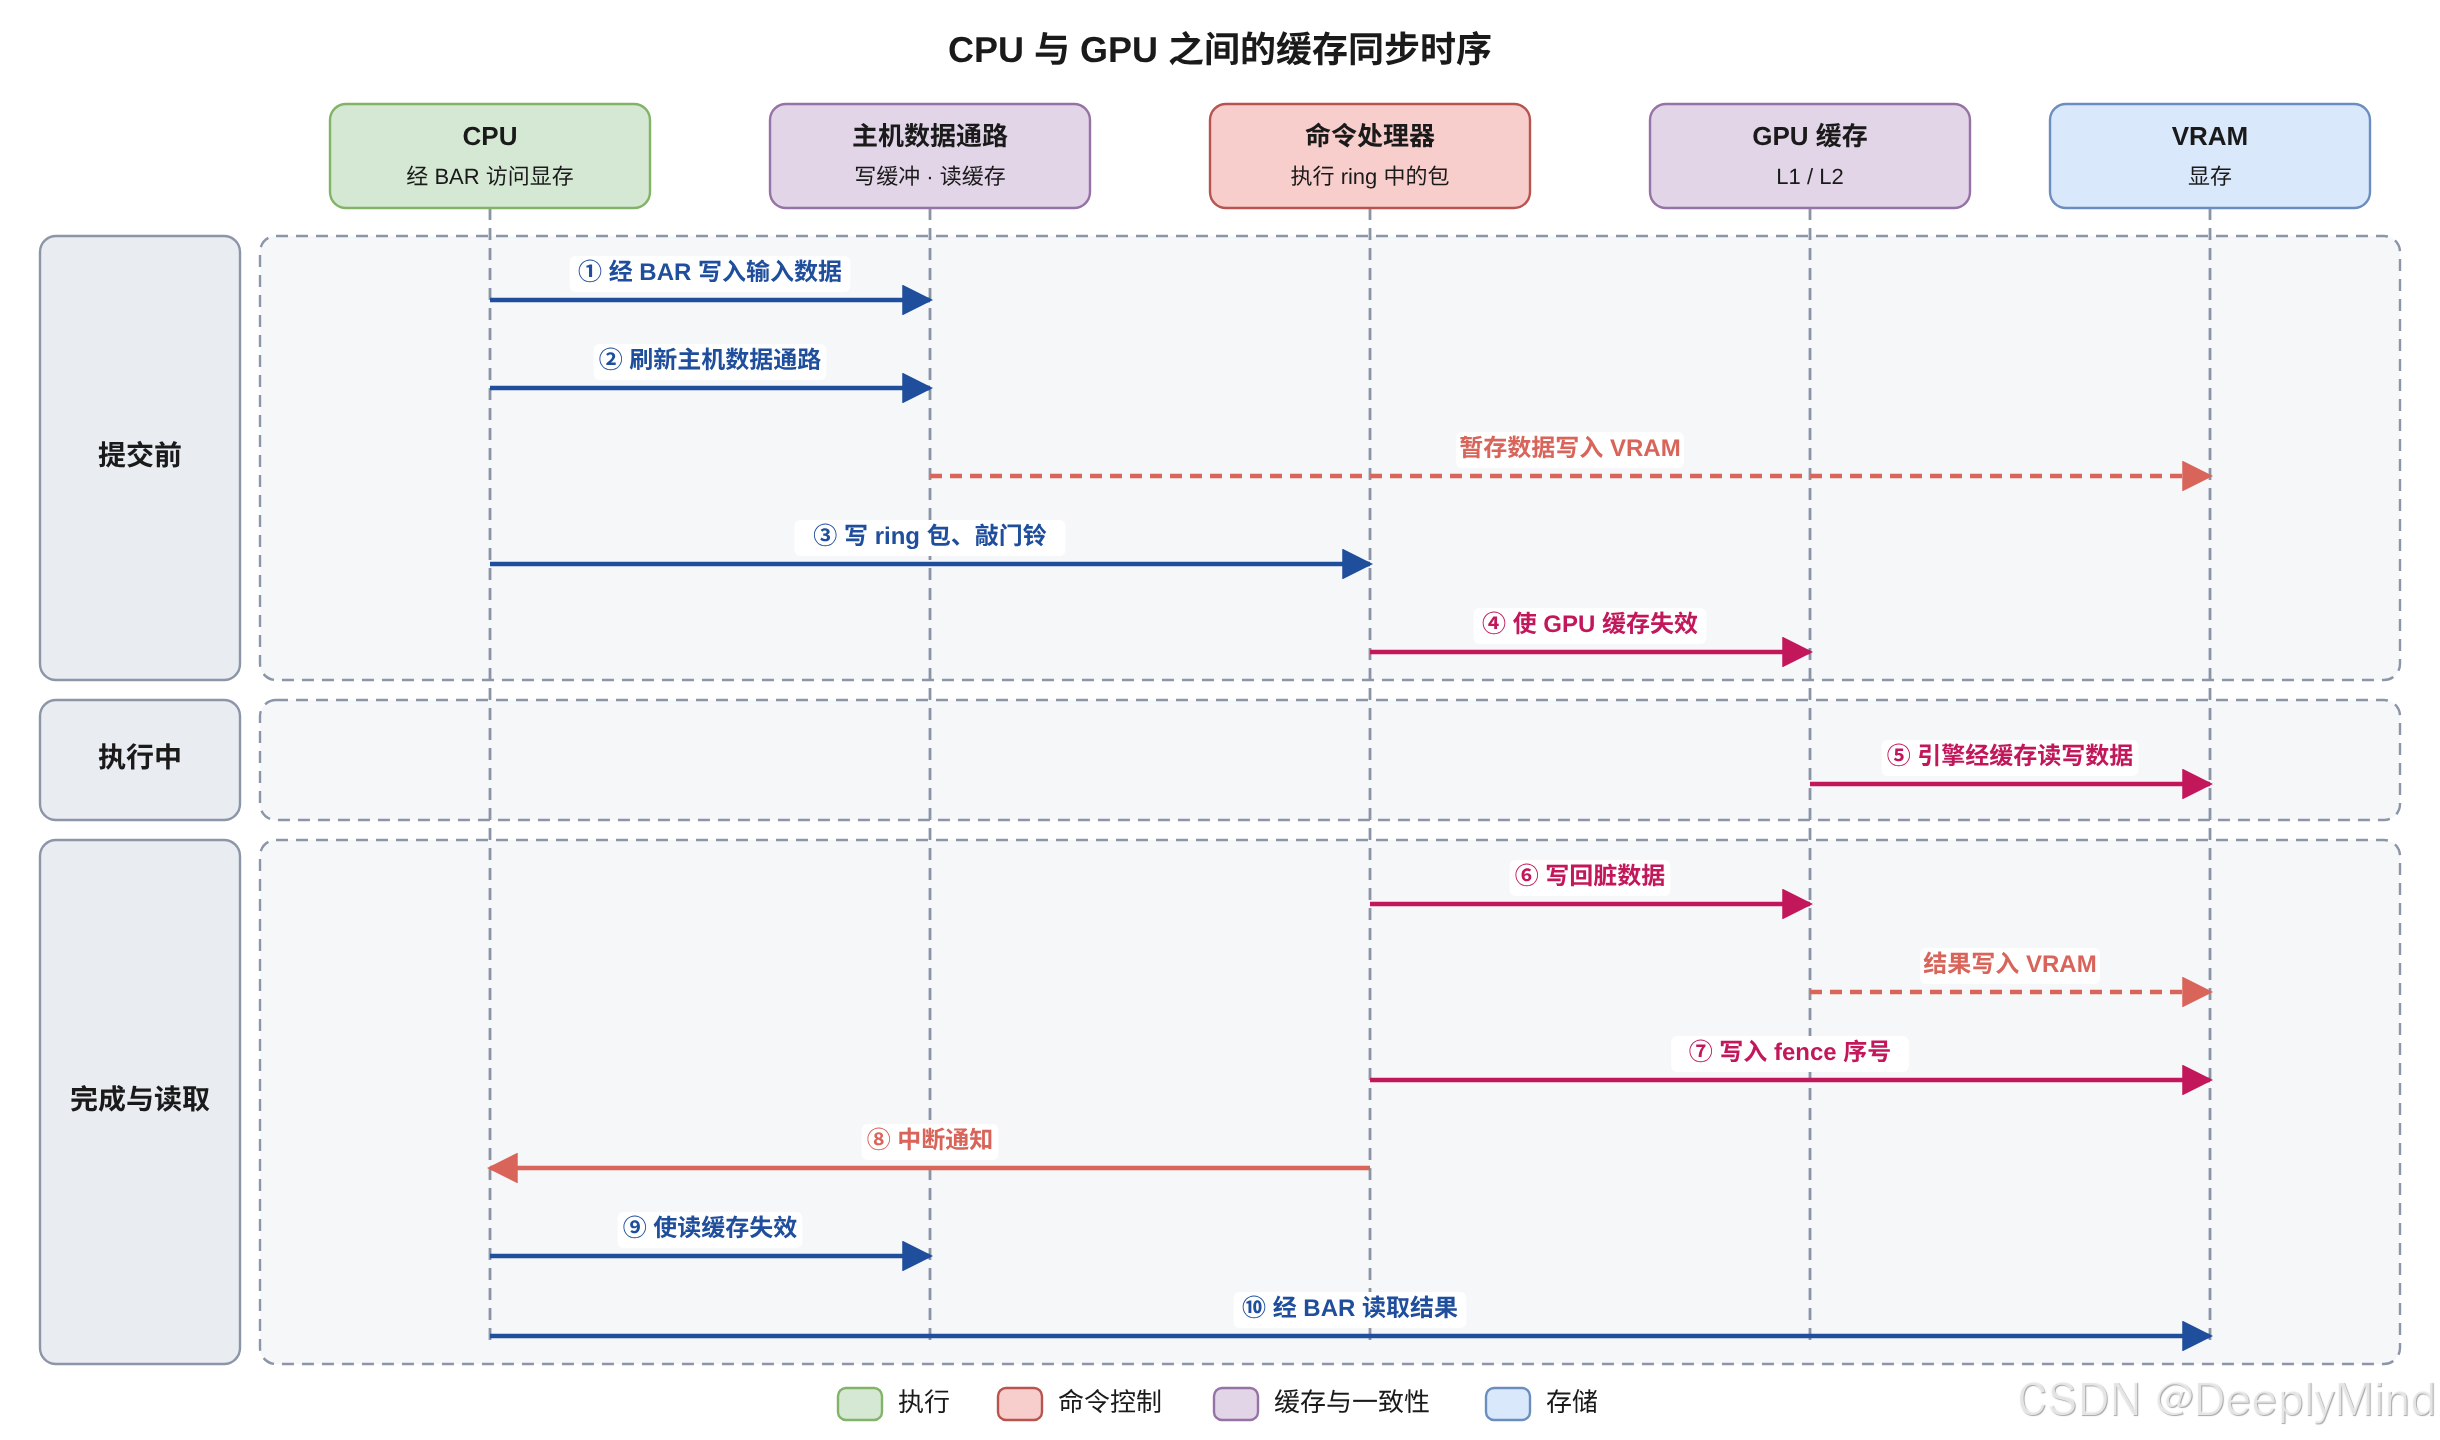
图 1.4.5 CPU 与 GPU 之间的缓存同步时序
PCIe 的排序规则是这一时序成立的前提。posted 写按发出顺序到达,因此输入数据的写入不会落后于门铃写入;读请求的完成报文不能越过此前的 posted 写,因此 CPU 读回 GPU 的任一寄存器,即可确认此前的写入均已到达 GPU。数据是否已经写入 VRAM,则仍取决于主机数据通路的刷新。
上述显式同步只在两种情况下可以省略:一是 GPU 缓存设计为显存侧缓存,主机访问与引擎访问共同经过它;二是 CPU 与 GPU 之间采用硬件一致性互连,双方可以互相窥探缓存。
8. 小结
GPU 硬件模型可以从四个层面概括:在系统拓扑上,独立 GPU 拥有高带宽的本地显存,CPU 只能经有限的 BAR 窗口访问它,GPU 访问系统内存则受 PCIe 带宽与 IOMMU 约束;在地址翻译上,GPU 为每个地址空间维护多级页表,访问系统内存时还要经过 IOMMU 的第二级翻译,较新的硬件支持可恢复缺页;在执行模型上,命令经 ring 与门铃异步提交,以递增的 fence 序号报告完成;在缓存一致性上,CPU 一侧由一致性互连维护,GPU 并不感知 CPU 的访问,主机数据通路与 GPU 缓存需要在作业边界以命令或寄存器显式刷新、写回与失效。