/* MD / 富文本中的 .toc(含博客园搬家等嵌套结构);.toc-box 在侧栏,不受影响 */
#content_views .toc,
/* 编辑器常在目录前后插入空 p(:empty 仍占 20px),一并去掉避免顶空隙 */
#content_views.markdown_views > p:empty:has(+ .toc),
#content_views.markdown_views > .toc + p:empty,
/* 富文本旧版目录标记 */
#content_views.htmledit_views #main-toc,
#content_views.htmledit_views #hr-toc,
#content_views.htmledit_views p[id*=\”-toc\”] {
display: none !important;
}
/* 目录去掉后,紧跟的首个标题不再多出一块上边距 */
#content_views.markdown_views > .toc + h1,
#content_views.markdown_views > .toc + h2,
#content_views.markdown_views > .toc + h3,
#content_views.markdown_views > .toc + h4,
#content_views.markdown_views > .toc + p:empty + h1,
#content_views.markdown_views > .toc + p:empty + h2,
#content_views.markdown_views > .toc + p:empty + h3,
#content_views.markdown_views > .toc + p:empty + h4 {
margin-top: 0 !important;
}
文章目录
-
- 1. 先把问题讲清楚:数据干净了,还不能直接混
- 2. 按数据量采样为什么不够
- 3. 先按能力目标给数据分层
- 4. 温度采样:让小数据源有更多机会
- 5. 上采样和过拟合:小数据源不是无限矿
- 6. 合成数据应该怎么配
- 7. 配比实验怎么设计
- 8. 写一个最小采样器
- 9. 配比监控:训练中要按数据源看指标
- 10. 一个中文企业技术助手的配比例子
- 11. 常见误区
- 12. 小结
- 大模型视角
- 下一篇
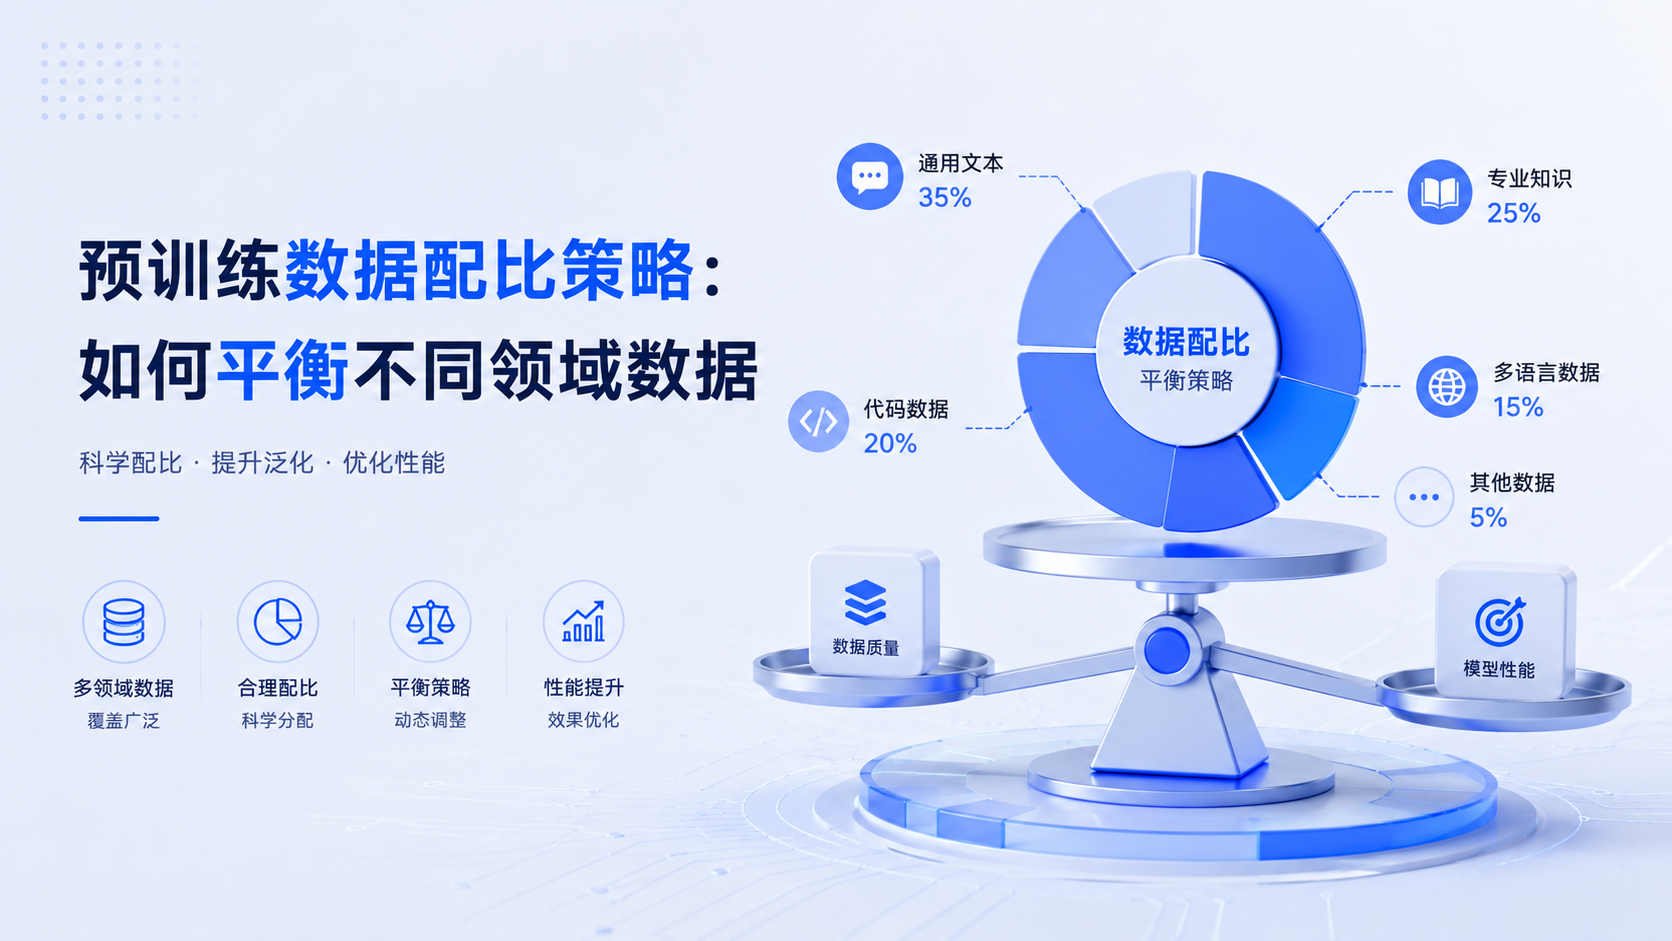
摘要:预训练数据配比决定模型最终更像“通用写作者”“代码助手”“数学解题器”还是“垂直领域专家”。它不是把所有数据按体量混在一起,也不是拍脑袋设几个百分比,而是在模型目标、数据质量、训练预算和评估结果之间做实验迭代。本文会用开发者能理解的方式讲清楚为什么不能只按数据量采样,温度采样如何提升小数据源权重,领域上采样为什么会带来过拟合风险,并给出一个可运行的小实验帮助你观察配比变化。
- 前置知识:专栏一概率基础、模型评估;专栏二预训练流程、数据处理
- 阅读时间:45-55 分钟
- 代码环境:Python 3.10+,示例只依赖标准库
- 读完目标:能解释数据配比如何影响能力结构,能看懂温度采样公式,能设计一个小规模配比实验和评估面板
1. 先把问题讲清楚:数据干净了,还不能直接混
假设你已经把数据清洗、去重、脱敏都做好了。现在手里有:
通用网页:10TB
英文技术文档:2TB
代码仓库:1TB
中文高质量长文:500GB
数学题和解答:200GB
企业内部制度:80GB
安全拒答样本:20GB
能不能全部合并后随机训练?可以,但通常不是好选择。因为按数据量随机采样时,通用网页会占绝对多数。模型会获得大量通用语言能力,但代码、中文、数学和企业制度可能被稀释。反过来,如果你把企业制度强行采样到 30%,又可能让模型过拟合少量内部文档,通用能力下降,回答风格变窄。
数据配比要解决的核心问题是:在有限训练 token 预算下,让模型把学习机会分配到最符合目标能力的数据上。
这件事很像培养一个工程师。你不能只让他看百科,也不能只让他背公司制度。如果目标是“中文企业技术助手”,他需要通用常识、中文表达、代码能力、企业文档、安全边界和真实问答习惯。不同材料的比例,会塑造不同能力结构。
2. 按数据量采样为什么不够
最简单的采样方式是按数据量采样。某个数据源 token 越多,被抽到的概率越高。假设每个数据源大小是
n
i
n_i
ni,采样概率是:
p
i
=
n
i
∑
j
n
j
p_i = \\frac{n_i}{\\sum_j n_j}
pi=∑jnjni
逐项解释:
-
n
i
n_i
ni:第i
i
i 个数据源的 token 数; -
∑
j
n
j
\\sum_j n_j
∑jnj:所有数据源 token 总数; -
p
i
p_i
pi:训练时从第i
i
i 个数据源抽样的概率。
这个公式很自然,但它隐含一个假设:数据源的重要性与体量成正比。现实里这个假设经常不成立。
按体量采样会带来几类问题:
| 大源压制小源 | 网页远大于代码和数学 | 专项能力弱 |
| 噪声被放大 | 低质网页量很大 | 模型输出变水、重复 |
| 稀缺能力不足 | 高质量中文、专业文档较少 | 目标场景表现差 |
| 数据价值不等 | 1GB 教材可能比 10GB 灌水更有价值 | token 预算浪费 |
当然,按体量采样也不是完全错误。它适合作为 baseline,因为简单、可解释、不会过度放大小数据源。但如果目标能力明确,通常需要在 baseline 上做调整。
3. 先按能力目标给数据分层
数据配比不要一开始就分成几十个细类,否则很难解释和调参。建议先按能力目标分层:
| 通用高质量文本 | 常识、表达、知识覆盖 | 通用问答、阅读理解、写作 |
| 中文文本 | 中文语感、本土表达、多轮问题 | 中文问答、中文写作、口语输入 |
| 英文技术文本 | 技术术语、论文和文档理解 | 技术解释、英文理解 |
| 代码数据 | 语法、API、项目结构、调试模式 | 代码补全、修复、解释、单测 |
| 数学推理 | 多步推理、符号表达、题解结构 | 数学题、推理链稳定性 |
| 领域数据 | 行业术语、业务结构、文档风格 | 领域 QA、术语解释、业务流程 |
| 安全数据 | 拒答边界、风险识别 | 安全测试、越权请求、隐私 |
分层的意义是让配比与目标能力对应。否则你只会得到一张看似科学的比例表,却不知道每个比例在换取什么能力。
例如,如果目标是通用聊天模型,领域数据不能过高;如果目标是代码模型,代码和技术文档必须占更高比例;如果目标是企业内部助手,领域数据和 RAG/SFT 的组合要一起考虑,而不是单靠预训练硬塞知识。
4. 温度采样:让小数据源有更多机会
温度采样是一种常用的配比平滑方法。它不是手工给每类数据写死比例,而是对数据源大小做指数变换。
按数据量采样是:
p
i
=
n
i
∑
j
n
j
p_i = \\frac{n_i}{\\sum_j n_j}
pi=∑jnjni
温度采样可以写成:
p
i
=
n
i
α
∑
j
n
j
α
p_i = \\frac{n_i^\\alpha}{\\sum_j n_j^\\alpha}
pi=∑jnjαniα
其中
0
<
α
≤
1
0 < \\alpha \\le 1
0<α≤1。
这行公式的直觉是:当
α
=
1
\\alpha=1
α=1 时,就是按数据量采样;当
α
<
1
\\alpha<1
α<1 时,大数据源会被压低,小数据源会被提升。
α
\\alpha
α 越小,采样越均衡。
下面用代码看差异:
# Python 3.10+
def temperature_sampling(sizes, alpha):
weights = {name: size ** alpha for name, size in sizes.items()}
total = sum(weights.values())
return {name: weight / total for name, weight in weights.items()}
sizes = {
"web": 10_000,
"tech_docs": 2_000,
"code": 1_000,
"chinese": 500,
"math": 200,
"domain": 80,
"safety": 20,
}
for alpha in [1.0, 0.7, 0.5, 0.3]:
probs = temperature_sampling(sizes, alpha)
print("alpha =", alpha)
for k, v in sorted(probs.items(), key=lambda x: –x[1]):
print(f" {k:10s} {v:.3f}")
print()
运行后你会看到:alpha=1.0 时,web 占比很高;alpha 降低后,domain 和 safety 这种小数据源被明显提升。
这并不意味着 alpha 越低越好。小数据源被提升后,会在训练中被反复看到,过拟合和记忆风险会上升。温度采样是把“完全按体量”往“更重视小源”方向移动,具体移动多少要靠评估。
5. 上采样和过拟合:小数据源不是无限矿
假设企业内部制度只有 80GB,但你希望模型很懂公司业务,于是把它采样到 30%。这相当于让模型在训练中反复看到同一批文档。短期看,领域 loss 会下降;长期看,可能出现几个问题:
- 模型记住具体段落,泛化到新问题反而差;
- 输出风格过度模仿制度文档,回答僵硬;
- 通用能力和代码能力下降;
- 隐私或内部敏感信息被记忆;
- 下游评估被训练数据污染。
可以用一个简单计算观察“重复轮数”。如果某类数据有
D
D
D 个 token,训练中实际采样了
S
S
S 个 token,那么平均每个 token 被看到的次数约为:
e
p
o
c
h
s
=
S
D
epochs = \\frac{S}{D}
epochs=DS
示例代码:
# Python 3.10+
def expected_epochs(total_train_tokens, source_tokens, sampling_prob):
sampled = total_train_tokens * sampling_prob
return sampled / source_tokens
# 训练总预算 100B tokens,领域数据只有 2B tokens
for p in [0.02, 0.10, 0.30]:
e = expected_epochs(100_000_000_000, 2_000_000_000, p)
print(f"sampling_prob={p:.0%}, expected epochs={e:.1f}")
如果某个小数据源被反复训练很多轮,就要警惕过拟合。解决办法不一定是降低比例,也可以是:
| 提高数据质量 | 减少重复和模板化 |
| 增加同类数据 | 降低重复轮数 |
| 做数据增强 | 但要防止合成风格单一 |
| 改用 RAG | 频繁更新或精确事实更适合检索 |
| 改用 SFT | 如果目标是回答格式和行为 |
| 混入通用回放 | 减少灾难性遗忘 |
领域数据不是越多比例越好。配比必须和数据量、数据质量、目标能力一起看。
6. 合成数据应该怎么配
合成数据可以补充稀缺能力,比如数学推理、工具调用、结构化输出、拒答边界和多轮对话。但合成数据也有典型风险:
| 风格单一 | 模型回答像模板,缺少真实用户噪声 |
| 错误继承 | 教师模型的幻觉和错误被学生模型学到 |
| 评测污染 | 合成题过度贴近公开 benchmark |
| 过度解释 | 模型总是输出冗长推理,不适合产品 |
| 安全偏差 | 只学会拒答模板,不会判断边界 |
合成数据更适合作为能力补丁,而不是替代真实数据。使用时建议:
1. 合成前先定义目标能力,不要无目的扩充;
2. 保留生成 prompt、教师模型版本和过滤规则;
3. 对合成样本做去重和质量评分;
4. 抽样人工复核事实和格式;
5. 与真实数据混合,不要让合成风格主导;
6. 用独立评估集检查是否只是刷题。
如果合成数据占比升高后,模型 benchmark 上升但真实用户样例下降,就说明配比可能在训练“考试技巧”,不是能力本身。
7. 配比实验怎么设计
大规模预训练不能随便试错。通常要先做小模型、短训练或中间 checkpoint 实验。一个可执行的配比实验流程是: 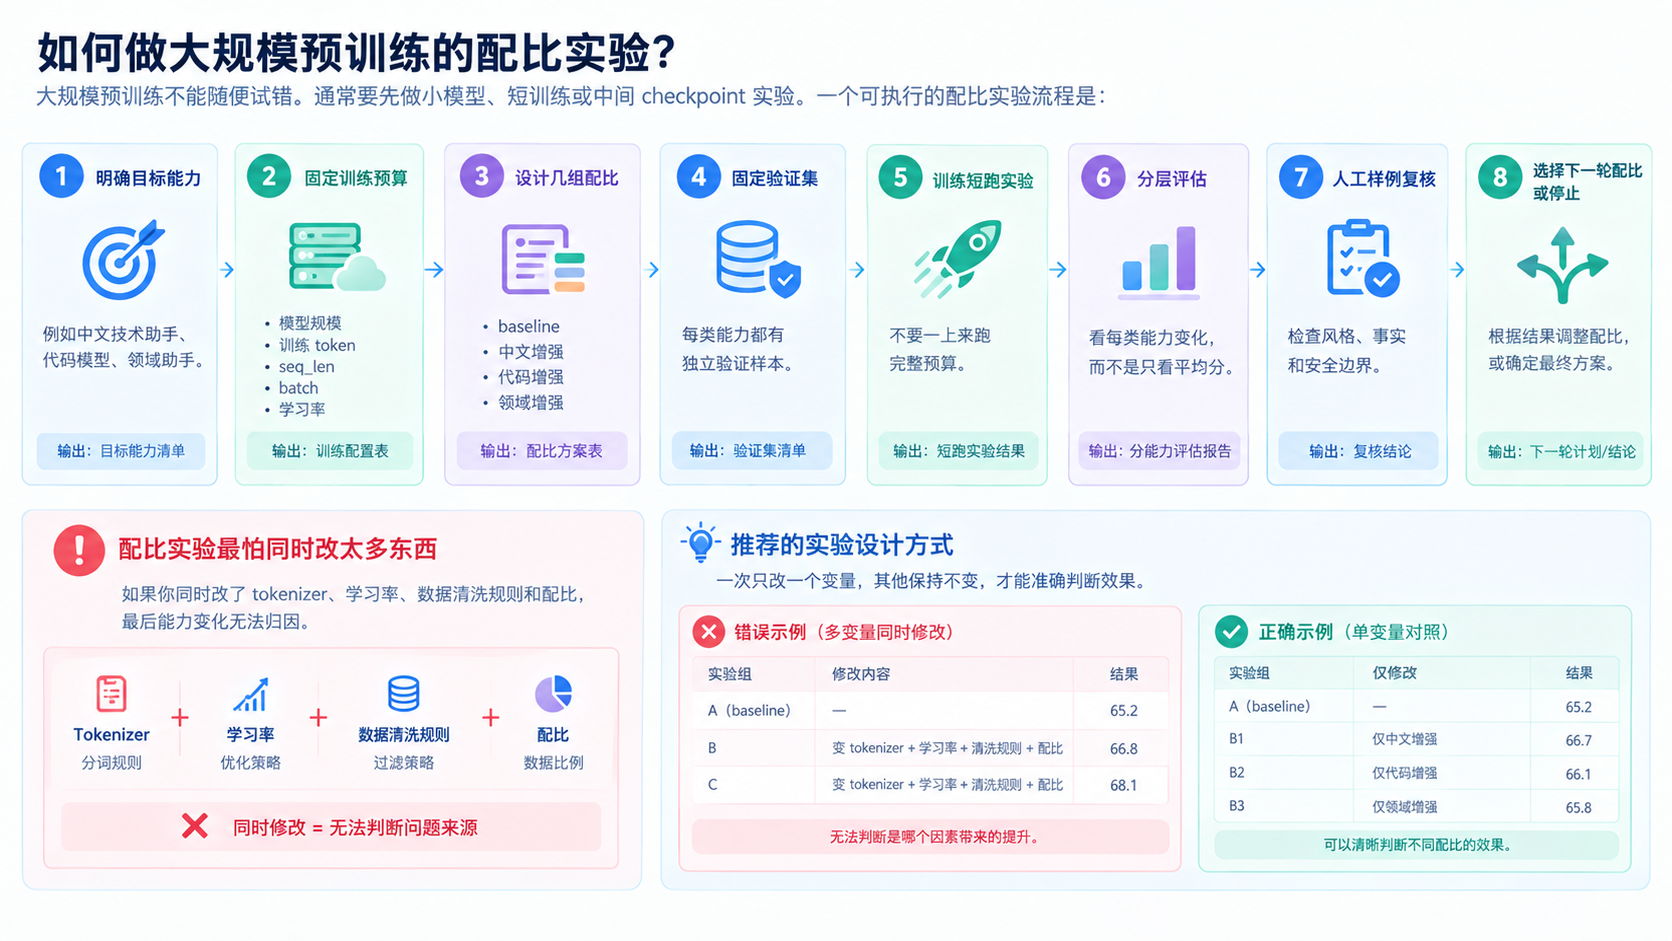 配比实验最怕同时改太多东西。如果你同时改了 tokenizer、学习率、数据清洗规则和配比,最后能力变化无法归因。
建议实验表这样记录:
| baseline | 55% | 15% | 15% | 5% | 5% | 5% | 平衡通用能力 |
| code+ | 45% | 25% | 12% | 8% | 5% | 5% | 提升代码和推理 |
| zh-domain+ | 40% | 12% | 23% | 5% | 15% | 5% | 提升中文领域助手 |
| safety+ | 50% | 14% | 14% | 5% | 5% | 12% | 提升拒答和边界 |
这些数字只是示例。真正重要的是:每组配比都有清晰假设,并且评估能验证假设。
8. 写一个最小采样器
下面用代码模拟“按配比采样”。我们不训练模型,只观察不同配比下,训练过程会抽到哪些数据源。
# Python 3.10+
import random
from collections import Counter
def build_sampler(probs):
names = list(probs.keys())
weights = [probs[n] for n in names]
def sample_one():
return random.choices(names, weights=weights, k=1)[0]
return sample_one
sizes = {
"web": 10_000,
"code": 1_000,
"zh": 500,
"math": 200,
"domain": 80,
}
def temperature_probs(sizes, alpha):
weights = {k: v ** alpha for k, v in sizes.items()}
total = sum(weights.values())
return {k: v / total for k, v in weights.items()}
random.seed(0)
for alpha in [1.0, 0.5]:
sampler = build_sampler(temperature_probs(sizes, alpha))
counts = Counter(sampler() for _ in range(10_000))
print("alpha", alpha)
for name, count in counts.most_common():
print(f" {name:8s} {count / 10_000:.3f}")
这个实验能直观看到采样概率如何影响训练数据流。实际训练中,还要考虑每个样本 token 长度不同、数据源耗尽、packing 策略、分布式 worker 随机种子等问题。但采样器的核心思想就是:训练每一步看到什么,最终会改变模型学到什么。
9. 配比监控:训练中要按数据源看指标
如果只看整体 train loss,你很难知道某类数据是否被学好。更合理的做法是按数据源或能力层记录指标:
1. 每类数据已消费 token 数;
2. 每类数据训练 loss;
3. 每类数据 validation loss;
4. 每类数据重复采样轮数;
5. 每类能力评估分数;
6. 不同语言和领域的输出样例;
7. 安全拒答和误拒答比例;
8. 通用能力回归结果。
比如,领域数据 validation loss 下降,但领域 QA 没提升,可能说明模型学会了续写文档风格,却没有学会回答问题。这时更应该做 SFT 或 RAG,而不是继续提高领域预训练比例。
再比如,代码评估上升但中文写作明显变差,说明配比出现取舍。它未必是坏事,关键看模型目标。如果目标是代码模型,这是可接受的;如果目标是中文通用助手,就需要调整。
10. 一个中文企业技术助手的配比例子
假设目标不是训练通用基础模型,而是训练一个更适合中文企业技术场景的基座或持续预训练模型。一个初始方案可以是:
| 通用中文高质量文本 | 30% | 保持中文表达和常识 | 质量参差会影响风格 |
| 英文技术文档 | 15% | 保留技术术语和国际资料理解 | 英文过多会稀释中文体验 |
| 代码、配置、日志 | 18% | 支持开发者任务 | 许可证和过时 API 风险 |
| 企业制度和知识文档 | 15% | 注入业务术语和文档风格 | 重复、隐私、过拟合 |
| 技术问答和工单 | 12% | 学真实问题表达 | 噪声和敏感信息 |
| 数学和推理数据 | 5% | 保持推理结构 | 模板化风险 |
| 安全和拒答样本 | 5% | 建立边界 | 过度拒答 |
这个表不是标准答案。它只是展示配比如何围绕目标能力设计。发布前要问:
1. 企业知识是否频繁更新?如果是,RAG 是否更合适?
2. 企业文档是否包含隐私或权限信息?
3. 提高领域比例后,通用中文能力是否下降?
4. 技术问答是否真实,还是人工构造得过于理想?
5. 安全样本是否覆盖越权、隐私、金融、法律等边界?
很多企业场景里,最佳方案不是“领域预训练比例拉满”,而是“适度持续预训练 + 高质量 SFT + RAG + 安全评估”。
11. 常见误区
误区一:存在一套通用最佳配比。 配比依赖模型目标、数据质量、训练预算、tokenizer、评估集和上线场景,不存在永远正确的比例。
误区二:领域数据比例越高,模型越专业。 领域比例过高可能导致过拟合、灾难性遗忘、风格变窄和隐私记忆。
误区三:只按 token 数统计就够了。 同样 token 数,信息密度、噪声、重复度和许可证风险完全不同。
误区四:合成数据可以无限扩充。 合成数据会继承教师模型偏差,还可能造成模板化和评测污染。
误区五:整体 loss 下降就说明配比正确。 配比要看分层能力,不同能力之间可能互相取舍。
12. 小结
数据配比决定模型能力结构。按数据量采样简单可解释,但容易让大型数据源压倒小而重要的数据;温度采样通过指数平滑提升小数据源权重,但也会带来重复和过拟合风险;合成数据可以补能力短板,但要防止风格单一和污染;真正可靠的配比来自小规模实验、分层评估和人工样例复核。
对开发者来说,最重要的不是背某个比例,而是建立预算思维:每个 token 都是在花训练成本,配给哪类数据,就在塑造哪类能力。
大模型视角
从大模型技术主线看,配比是塑造模型能力结构最直接的杠杆:代码、数学、多语言、长上下文和安全边界的强弱,很多都能在数据配比的历史里找到原因。理解配比思维,也能解释为什么后训练阶段同样强调数据混合。
下一篇
下一篇会进入分布式训练框架。数据和配比决定模型学什么,DeepSpeed ZeRO 这类训练系统决定我们能不能在有限显存下把训练真正跑起来。