摘要:上一篇讲了响应的准备工作——NetworkSend 注册了 OP_WRITE。这篇讲最后一公里:poll 返回可写事件后怎么写字节、一次写不完的半包怎么续传、写完之后怎么处理回调和解除背压。
关键词:Kafka OP_WRITE、writeToSocket、半包写、completedSends、unmute、背压
前情:万事俱备,只欠可写
上一篇讲到 Processor 把序列化好的 NetworkSend 交给 Selector,注册了 OP_WRITE。此时字节还在内存里,一个都没发出去。
什么时候发?等 Socket 发送缓冲区有空间。Selector 的 poll() 返回可写事件,才是真正发送的时机。
01 发送全景
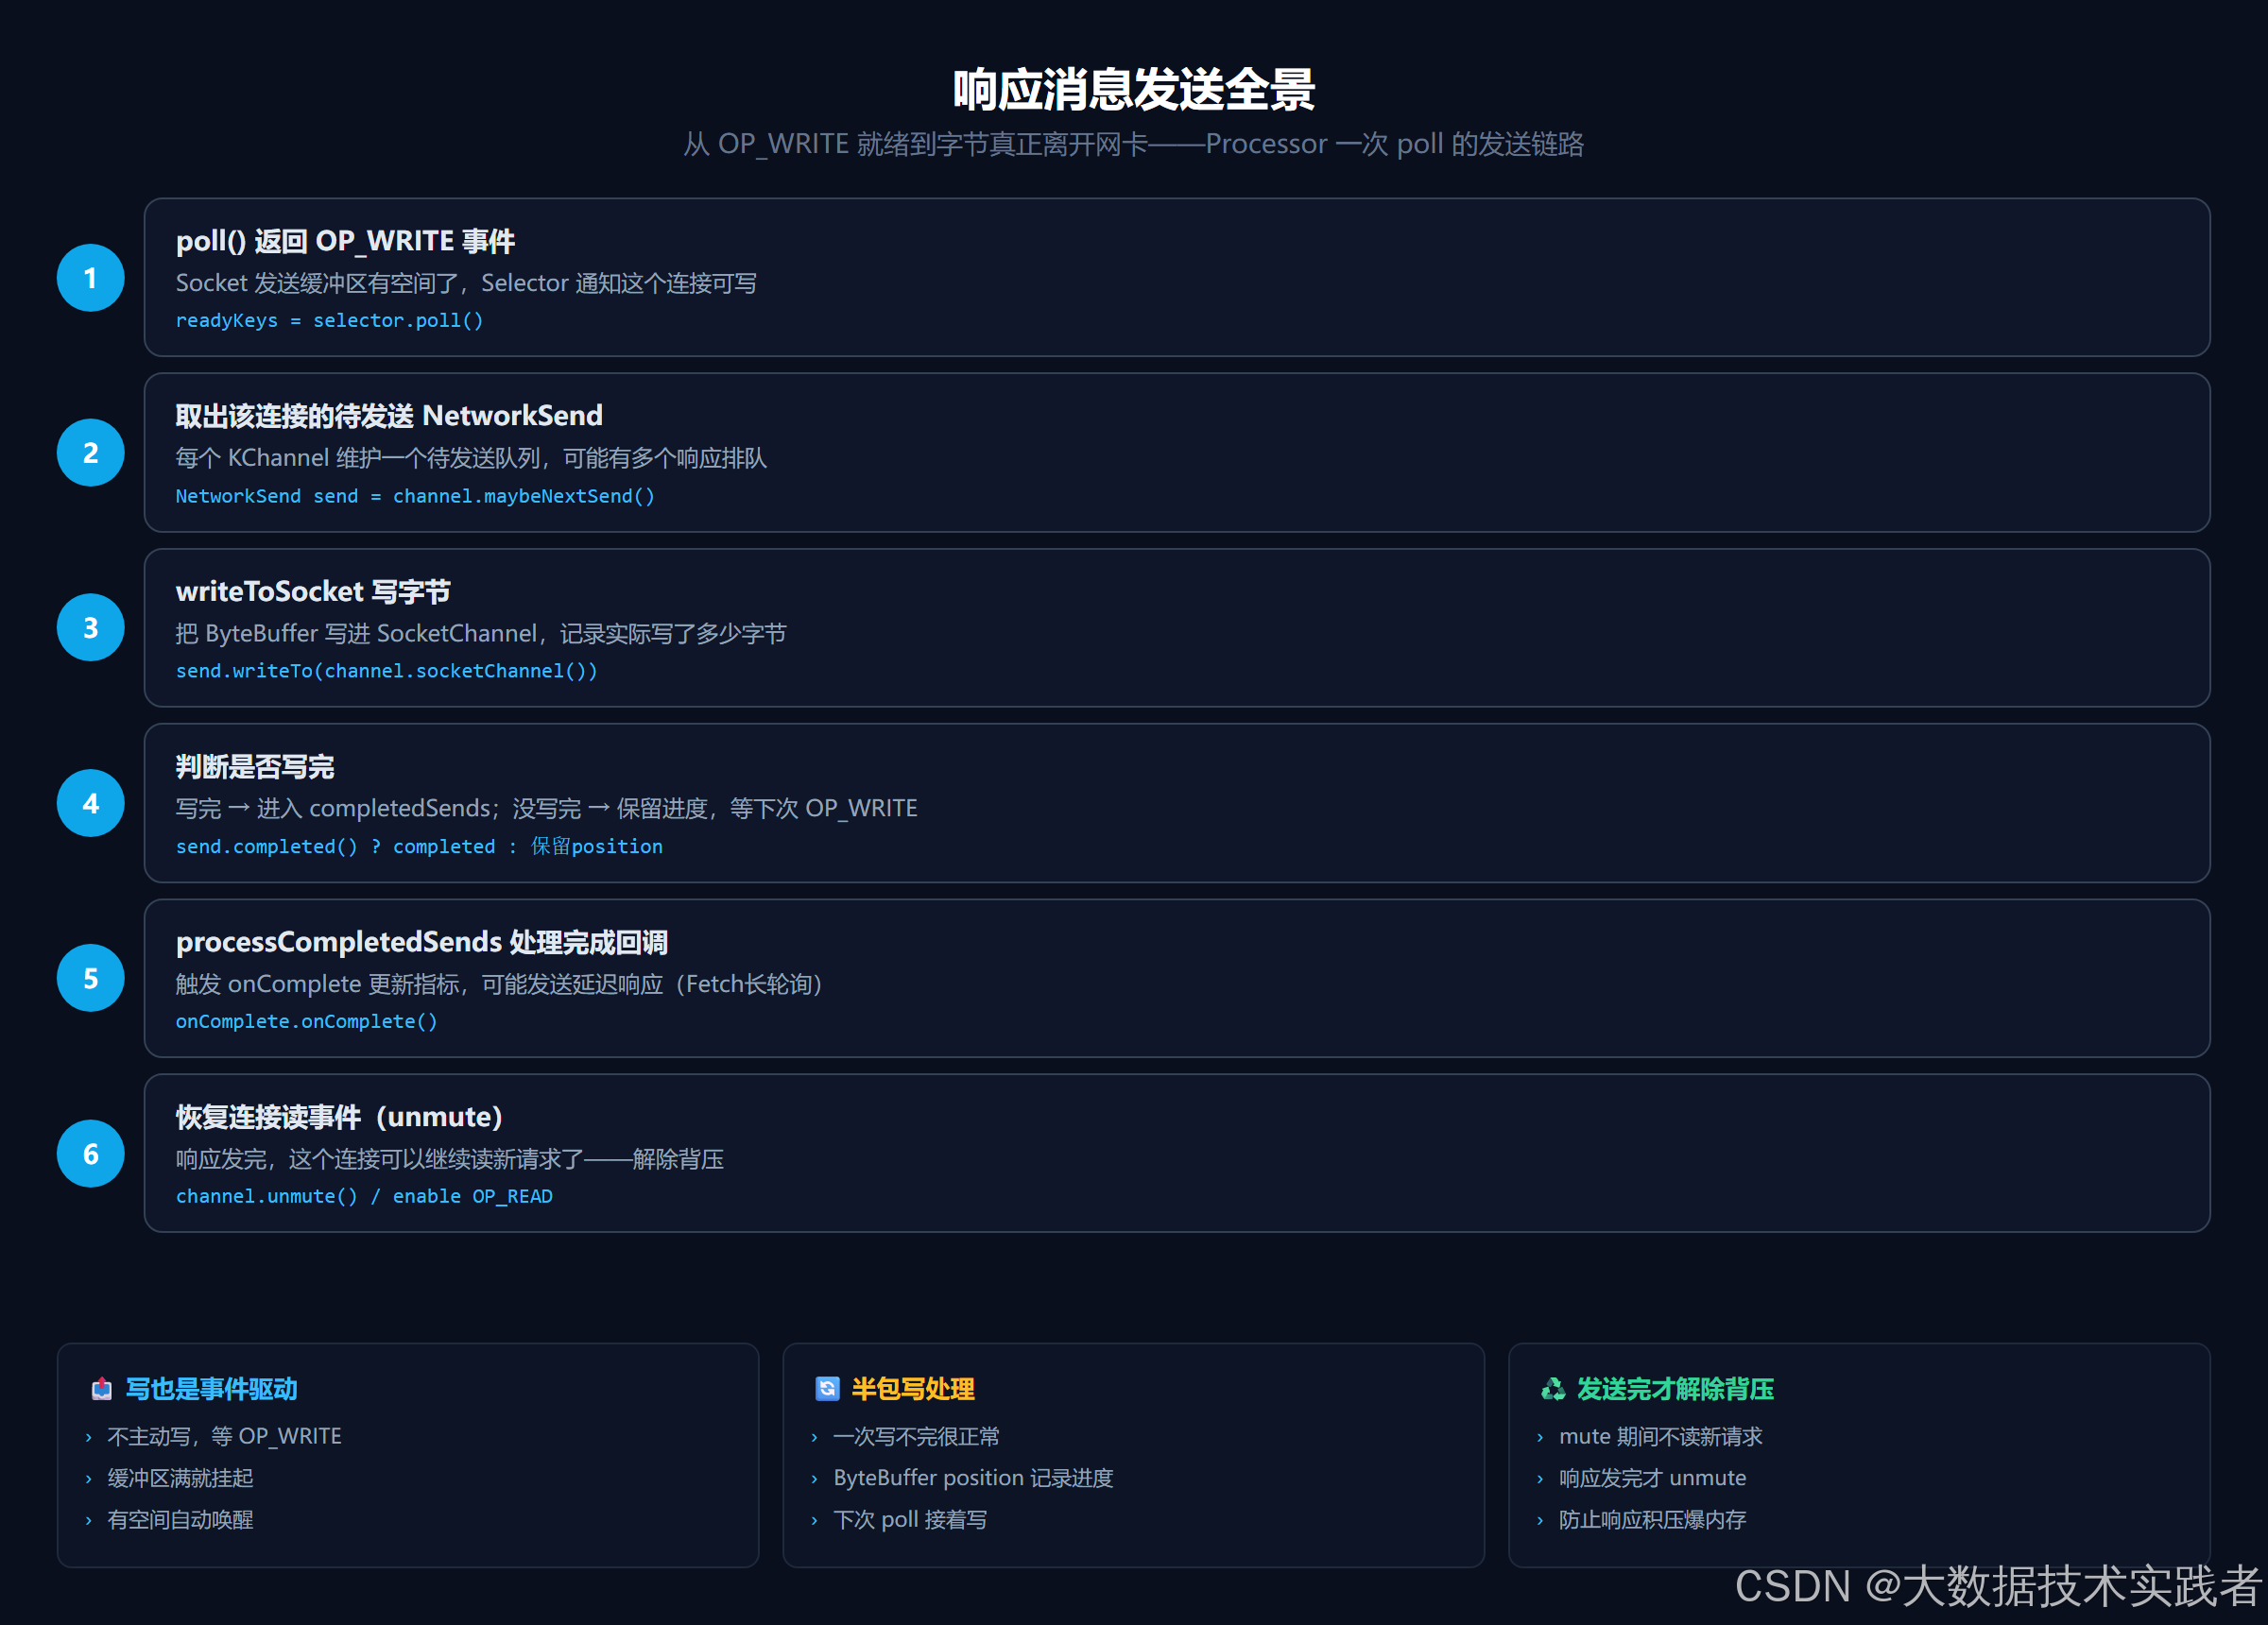
Processor 每次 poll() 之后,发送链路六步:
整个过程和接收链路是镜像的:接收端等 OP_READ 处理粘包拆包,发送端等 OP_WRITE 处理半包续传。
02 writeToSocket:半包写处理
核心代码逻辑:
// Selector.write() 对每个可写连接
NetworkSend send = channel.maybeNextSend();
if (send != null) {
send.writeTo(socketChannel); // 内部调 socketChannel.write(buffer)
if (send.completed()) {
completedSends.add(send); // 写完了
channel.removeCurrentSend();
}
// 没写完什么都不做,position 已经前移,下次继续
}
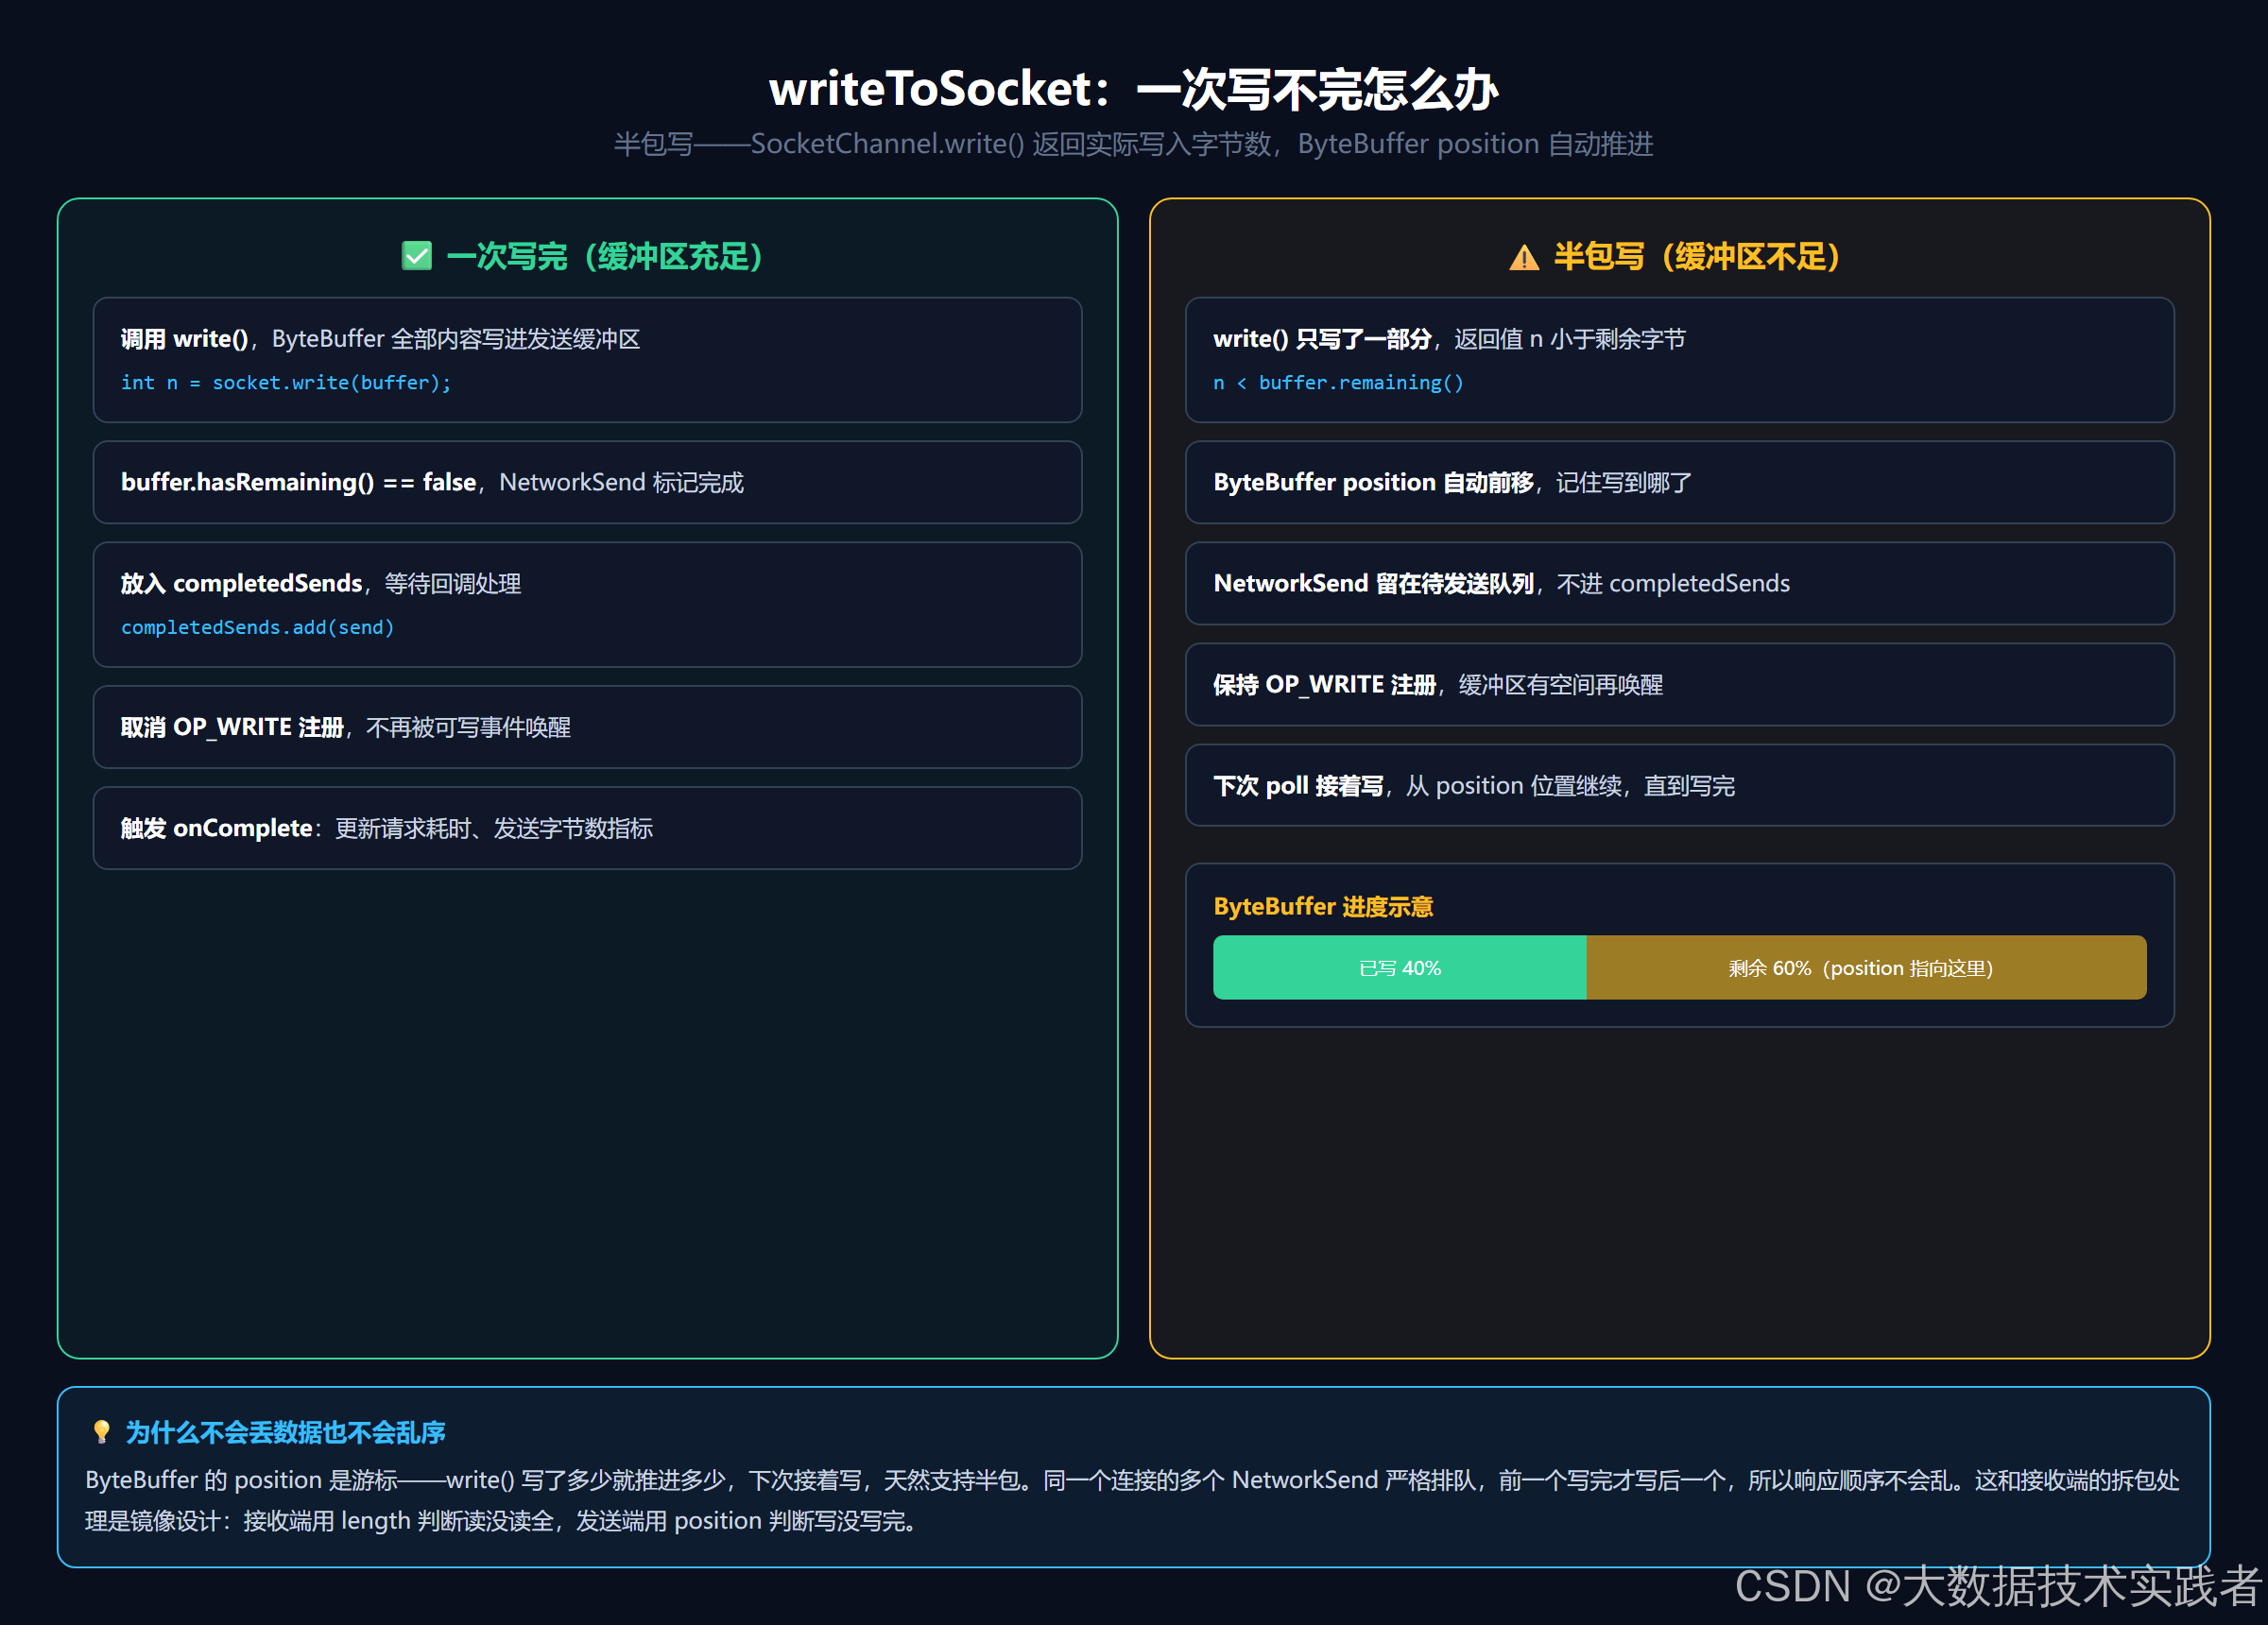
关键在 SocketChannel.write(ByteBuffer) 的行为:它尽力写,写多少算多少,返回实际写入的字节数,同时 ByteBuffer 的 position 自动前移。
- 发送缓冲区够大:一次写完,hasRemaining() 为 false,进 completedSends,取消 OP_WRITE
- 发送缓冲区不够:只写了一部分,NetworkSend 留在队列里,保持 OP_WRITE,下次 poll 从 position 接着写
为什么不会丢数据? 因为 position 是游标,写了多少就推进多少,下次接着写,应用层不用自己记进度。
为什么不会乱序? 同一个连接的 NetworkSend 严格排队,前一个 completed() 之后才 maybeNextSend() 取下一个。
这和接收端是镜像设计:接收端靠 length 判断读没读全,发送端靠 position 判断写没写完。
03 processCompletedSends:写完之后
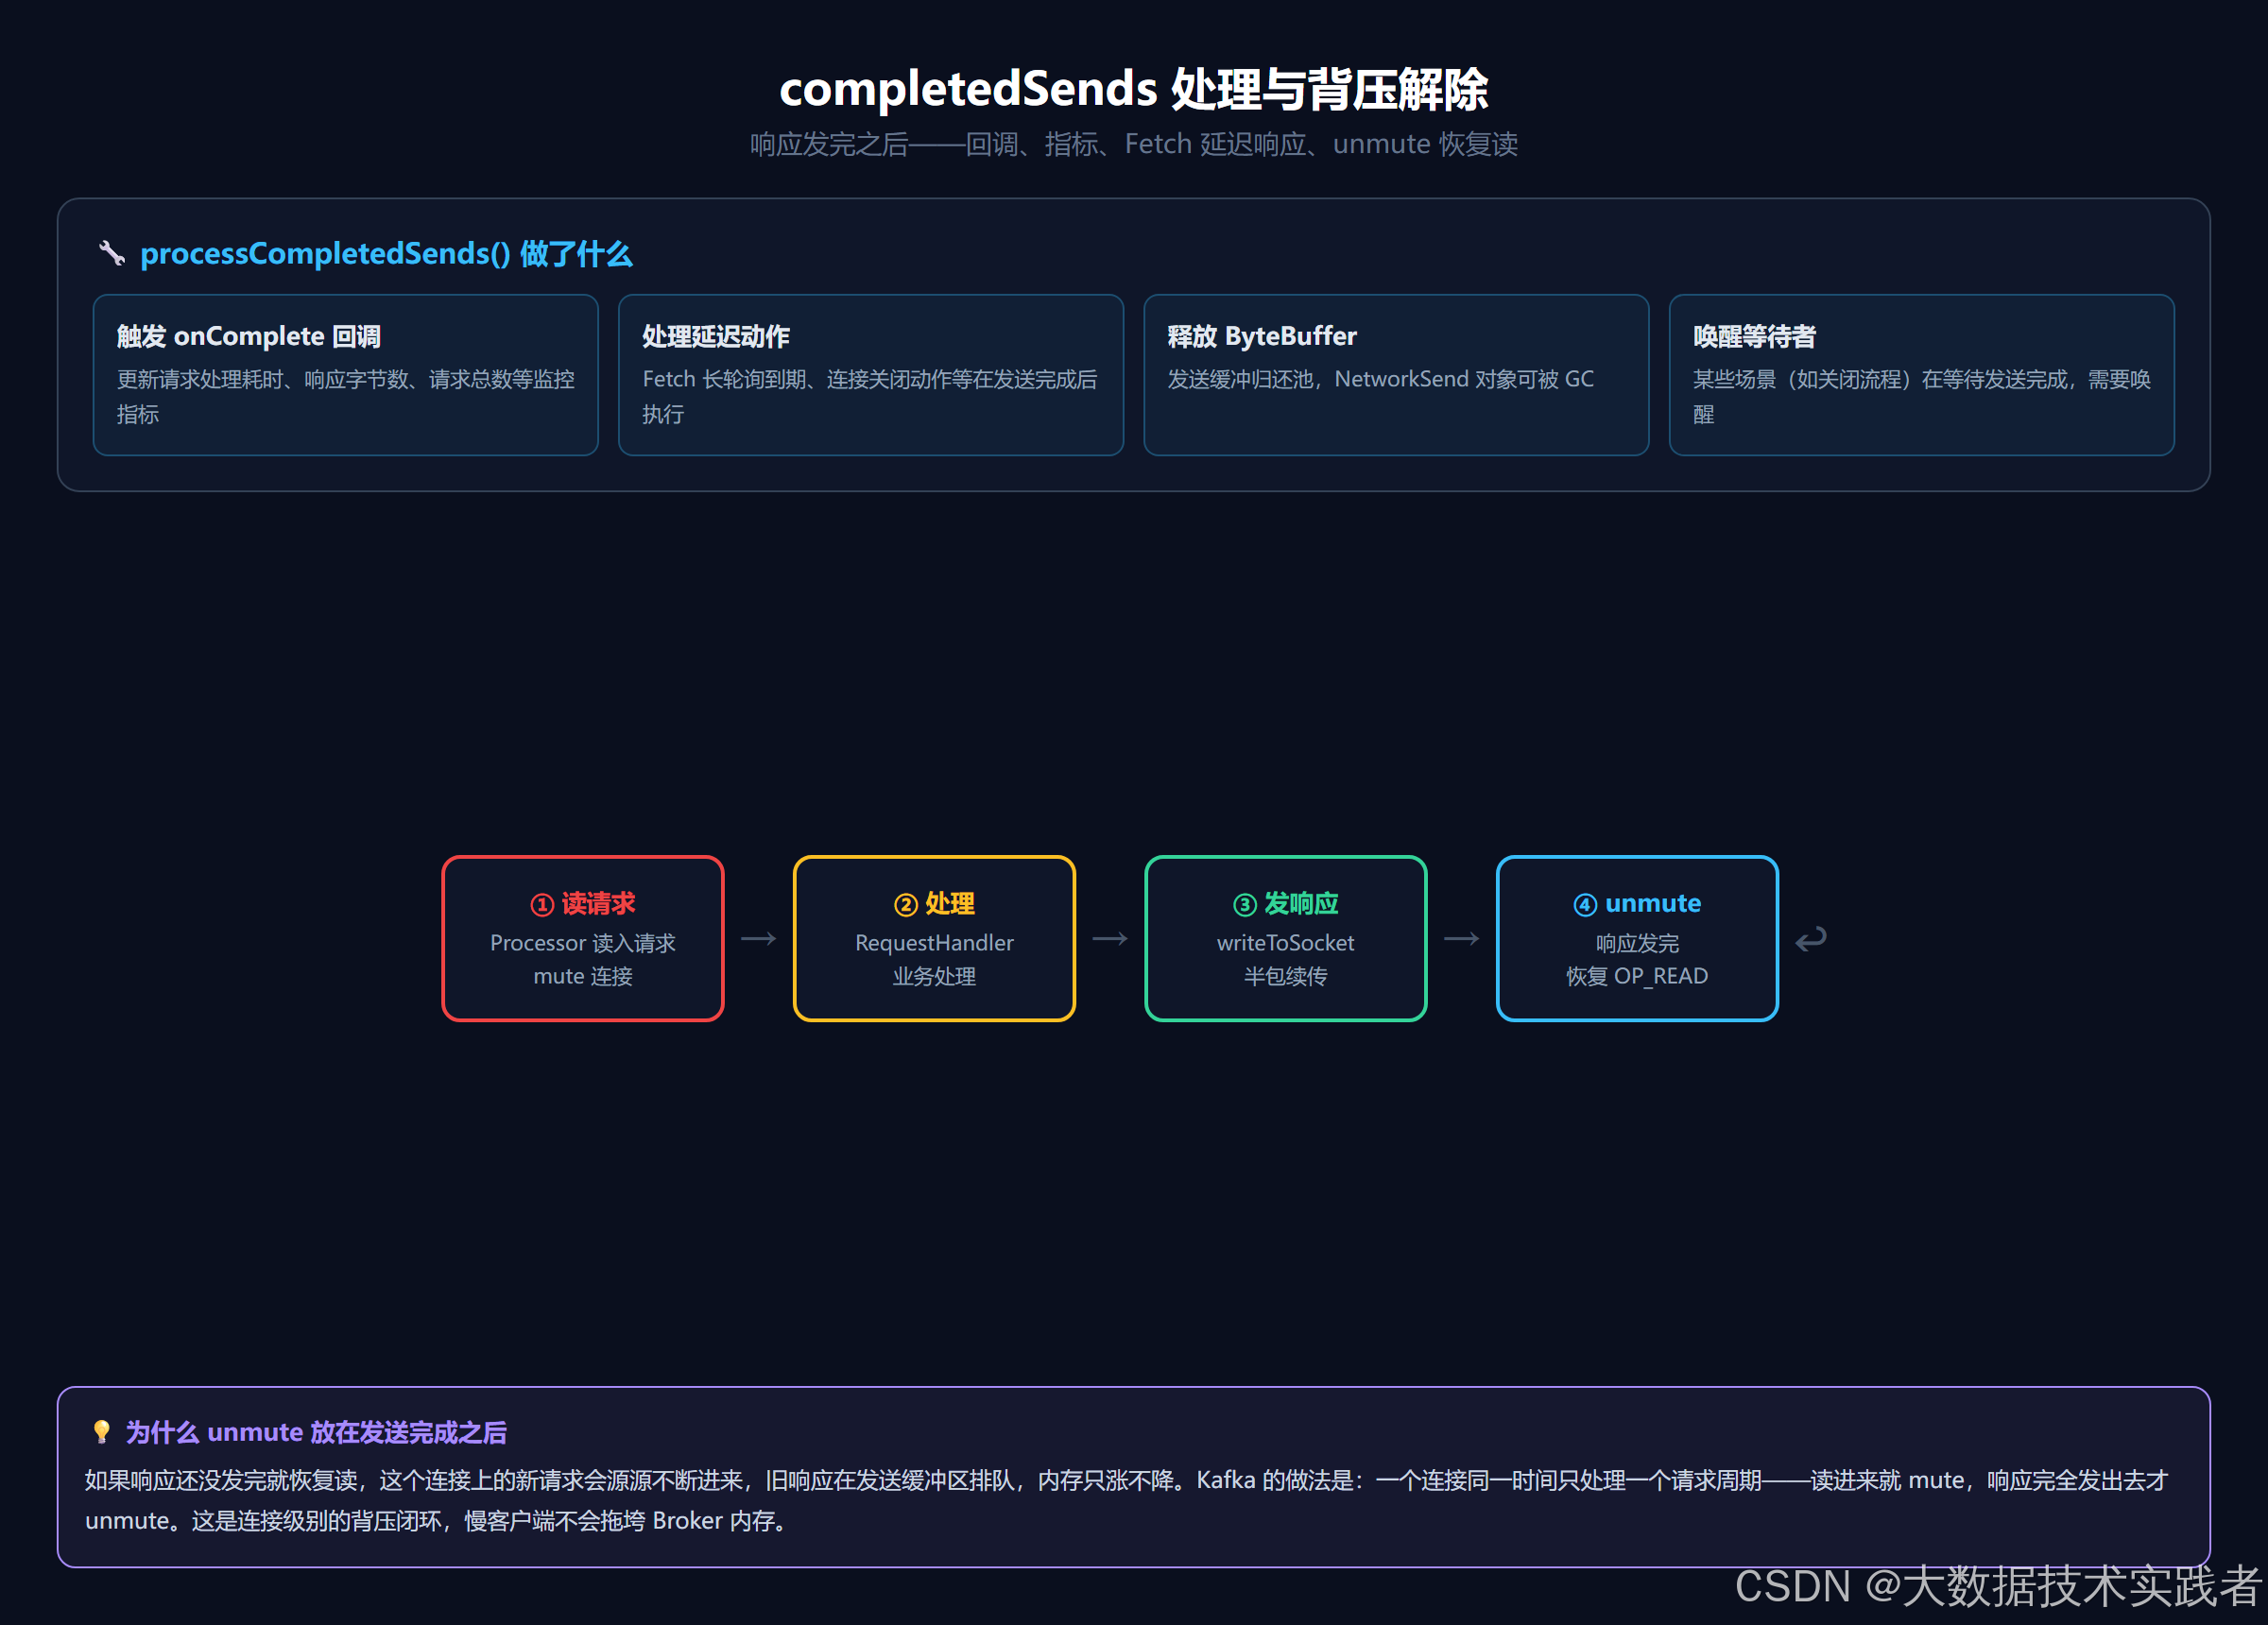
一个响应完全发出去之后,还有四件事要做:
触发 onComplete 回调:更新请求处理耗时、响应字节数、请求总数等监控指标。这些指标是 Kafka 监控面板(request-latency-avg、response-send-rate)的数据来源。
处理延迟动作:Fetch 长轮询到期、连接关闭等动作挂在发送完成后执行。
释放资源:ByteBuffer 归还缓冲池,NetworkSend 对象可被 GC。
唤醒等待者:Broker 优雅关闭时会等待在途响应全部发完,completedSends 负责唤醒关闭流程。
04 unmute:背压闭环的最后一环
最重要的一步:响应完全发完之后才 unmute 这个连接。
回顾前面讲过的背压机制:
① Processor 读入请求 → mute 连接(不再读新请求)
② RequestHandler 处理
③ 响应序列化、发送(可能半包续传多次)
④ 响应完全发完 → unmute,恢复 OP_READ
为什么 unmute 要放在发送完成之后?假设响应还没发完就恢复读,慢客户端场景下会出问题:客户端收得慢,发送缓冲区一直满,新请求不断进来,每个请求都产生新响应堆在内存里,最终 OOM。
Kafka 的做法是连接级别的请求-响应闭环:一个连接同一时间只走一个请求周期,读进来就 mute,响应完全发出去才 unmute。慢客户端只会让自己的连接排队,不会拖垮 Broker 内存。这就是 Kafka 能扛住上万连接、各种消费速度客户端的关键设计之一。
写在最后
发送链路的设计哲学和接收链路完全对称:事件驱动(OP_WRITE)、半包续传(position 游标)、严格有序(队列串行)、背压闭环(发完才 unmute)。理解了这四点,就理解了 Kafka 网络层为什么在高并发下既不阻塞也不爆内存。