ReAct是一种将推理与行动结合的大模型方法,通过交替进行推理文本、动作和环境观察,提升任务解决能力。实验证明,在知识问答和交互任务中,ReAct均能有效提高成功率。本文将带你读懂ReAct的核心原理和实践方法,适合大模型初学者学习和收藏。
先看三个要点
-
研究问题:
大模型只做推理时,可能依赖错误事实;只调用工具时,又可能缺少规划和信息整合。怎样让推理指导行动,让外部反馈继续修正推理?
-
解决方案:
ReAct 将推理文本、动作和环境观察组织成交替进行的任务轨迹。模型选择下一步动作,程序执行工具,并将返回结果交给模型继续处理。
-
效果与结论:
论文的 WebShop 实验中,ReAct 成功率为 40.0%,Act-only 为 30.1%,提高 9.9 个百分点;但在 HotpotQA 上,ReAct 仍低于 CoT。结果支持推理与行动结合的价值,也表明收益依赖任务和配置,并非所有场景都会提升。
ReAct 由 Shunyu Yao 等人提出,发表于 ICLR 2023。读懂这篇论文,可以从一次搜索失败后,模型如何调整行动说起。
01 先看一个需要“边查边想”的问题
论文图 1 给出了一道多跳问答:除了 Apple Remote,还有什么设备能控制它最初配套使用的那个程序?
要回答它,需要先确定那个程序是什么,再查这个程序还支持什么控制方式。把问题拆成两步并不难,困难在于:第一步的事实是否可靠,搜索结果是否指向了正确对象。
论文展示的 ReAct 轨迹是这样的:
- 先搜索 Apple Remote,得到与 Front Row 程序有关的信息。
- 接着搜索 Front Row,却没有直接找到目标页面,环境返回相似条目。
- 根据反馈,把搜索词改成 Front Row (software)。
- 在新结果中找到键盘功能键也能控制它的依据,再提交答案。
关键在第三步:下一次搜索由上一次搜索的反馈推动。 模型根据新信息调整查询,逐步找到答案。
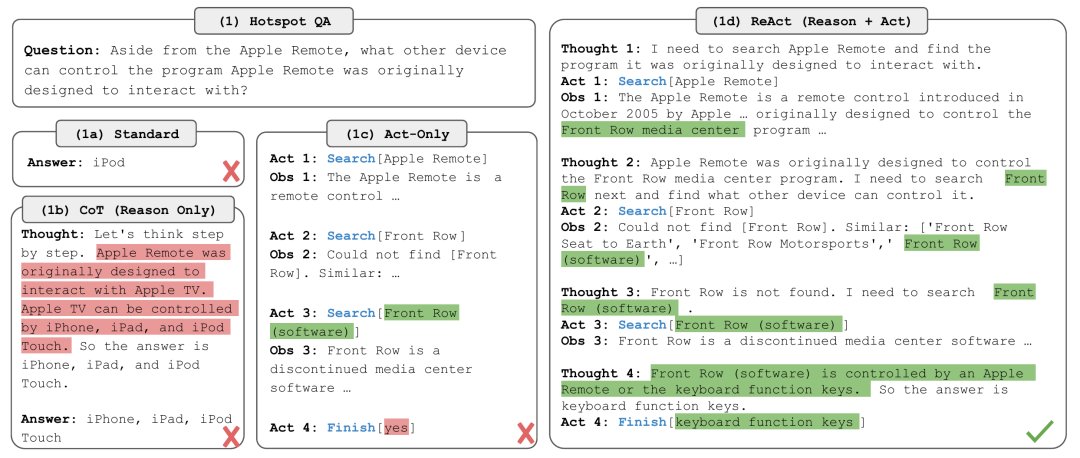
原论文图 1 上半部分:同一问题的四种处理方式。绿色标出支持正确答案的内容,红色标出错误。来源:Yao 等,ReAct,原图,CC BY 4.0。摘取问答面板。
在这里的实验设置中,普通提示直接回答;思维链 CoT 增加中间推理;Act-only 保留动作和环境反馈;ReAct 则让三者交替参与求解。
02 三种信息,来自不同的地方
ReAct 的典型问答循环包含三个部分:
| Thought:推理文本 | 模型生成,用于拆解问题、整理已知信息、规划或调整下一步 |
| Action:动作 | 模型提出动作及参数,程序解析并调用相应工具 |
| Observation:观察 | 工具或环境实际返回,成为下一轮模型输入的一部分 |
最关键的边界是:Thought 和 Action 是模型的输出,Observation 应由执行环境提供。
模型写出“我查到了某条事实”,不代表它真的搜索过。只有程序执行对应动作,并把结果接回来,才产生了这次外部交互的证据。
Thought 只更新上下文;搜索、移动物体等动作才与环境交互。推理也不必出现在每一步:操作较多时,可以只在规划、判断状态或调整目标时生成。论文第 2 节
什么时候查、查什么,由谁决定?
模型根据任务、示例和当前历史生成动作,开发者定义可用工具及执行规则。例如,Search[Front Row (software)] 的搜索词由模型选择;结果返回后,模型再决定继续查找、换词还是提交答案。
基础 ReAct 主要通过少量示范轨迹引导这种行为,没有独立的“事实不足检测器”替它判断。因此,它仍可能选错词、误读结果或过早结束。
03 打开源码,循环其实很小
作者公开的 HotpotQA 示例 使用 GPT-3。下面用伪代码概括核心循环:
context = instruction + demonstrations + question
for step in range(1, 8):
output = model(context, stop=f"/nObservation {step}:")
thought, action = parse(output)
observation, done = environment.step(action)
context += format_step(thought, action, observation)
if done:
break
else:
environment.step("finish[]")
第一,程序在 Observation 标记处停止模型生成。
程序让模型生成 Thought 和 Action,在 Observation 标记处截停,再执行工具、填入返回结果。输出格式仍需解析;示例也设置了解析失败后重新请求动作的补救分支。
第二,历史直接追加在提示词中。
每轮推理、动作和观察都会追加到上下文,下一轮完整交给模型。这份实现没有向量记忆库或历史检索器;跨任务记忆、历史压缩、按需回看,需要另行设计。
第三,工具非常克制。
WikiEnv 主要支持三个问答动作:
- search[entity]
:搜索维基百科;找到页面时,代码抽取并返回前五句,未直接找到时返回相似条目。
- lookup[keyword]
:在当前页面的文本中,依次返回包含关键词的句子。
- finish[answer]
:提交答案并结束任务。
其中 lookup 使用不区分大小写的字符串匹配。
第四,主动结束与强制结束是两回事。
模型可以生成 finish[answer]。但 HotpotQA 示例最多允许七轮;超过限制仍未结束,程序就提交空答案结束任务。这是开发者设置的上限,不代表模型已经确认信息充分。
04 实验结果,需要拆开来看
知识问答:ReAct 并非全面胜出
主文表 1 使用 PaLM-540B。HotpotQA 评价多跳问答,指标是答案精确匹配率 EM;FEVER 评价事实核验,指标是分类准确率。两列均以百分比表示,越高越好。
| 直接回答 | 28.7 | 57.1 |
| CoT | 29.4 | 56.3 |
| CoT-SC | 33.4 | 60.4 |
| Act-only | 25.7 | 58.9 |
| ReAct | 27.4 | 60.9 |
| CoT-SC → ReAct | 34.2 | 64.6 |
| ReAct → CoT-SC | 35.1 | 62.0 |
数据:论文表 1,第 5 页,摘录提示方法结果。
ReAct 在两个任务中都超过 Act-only,但在 HotpotQA 上低于 CoT。外部检索能提供事实依据,也可能因搜索失败、推理失误而拖累答案。
组合方法取得了更高分数,但有额外的采样与检索成本。CoT-SC 使用 21 条推理轨迹投票;CoT-SC → ReAct 在最高票答案不足半数时转向检索;反向组合则在 ReAct 达到步数上限仍未回答时退回 CoT-SC。这些切换由程序规则控制。论文第 3.2 节

原论文图 2:横轴为 CoT-SC 采样次数,左右分别为 HotpotQA EM 与 FEVER 准确率。来源:Yao 等,ReAct,原图,CC BY 4.0。仅裁去周边正文。
选择方案时,还需在相同预算约束下比较准确率、耗时和成本。
交互任务:规划和状态跟踪的作用更明显
论文表 3、表 4 还报告了两个模拟环境的结果:
-
ALFWorld:
通过文本动作完成找物品、清洗、放置等任务。在 134 个评估任务、六种提示配置中,ReAct 平均成功率为 57%,最佳配置为 71%;Act-only 最佳配置为 45%。
-
WebShop:
根据多个条件查找并选择商品。在 500 条测试指令上,ReAct 成功率为 40.0%,Act-only 为 30.1%,提高 9.9 个百分点。
这些结果体现了规划与状态跟踪的作用:拆分目标、记住已完成的步骤,再根据反馈继续行动。它们衡量的是模拟任务表现,并非真实机器人操作或实际购物效果。
05 有轨迹,依然会犯错
作者从 HotpotQA 中为 ReAct、CoT 各抽取 50 条成功与 50 条失败轨迹,共 200 条进行人工分析。ReAct 失败样本中,推理错误占 47%,搜索结果错误占 23%;重复动作、陷入循环也属于推理错误。论文表 2
表中的 ReAct“幻觉”类别为 0%,仅代表这组抽样与分类结果。其他任务依然出现了编造信息的问题。
论文图 5 的任务是把两串钥匙放进保险箱。模型找到第一串后,错误地认为另一个位置还有第二串钥匙,随后沿着这个错误判断继续行动。作者展示了人工编辑两处推理文本、让任务转向成功的一条轨迹。
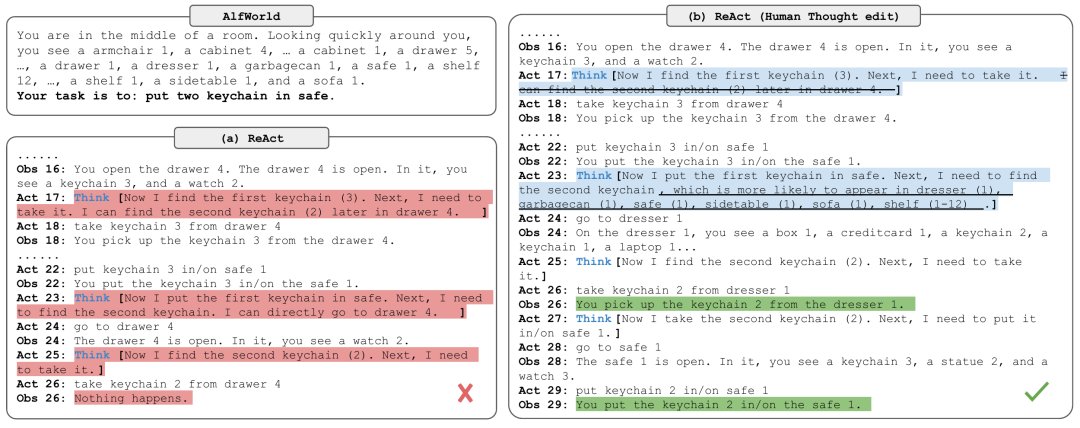
原论文图 5:左侧轨迹包含错误判断,右侧展示人工编辑两处推理文本后的行为变化。这是人工干预示例,不是规模化可靠性的证明。来源:Yao 等,ReAct,原图,CC BY 4.0。仅裁去周边正文。
执行轨迹便于定位错误,也提供了人工介入的位置。但 Thought 仍是模型生成的文本,可能包含错误解释。可读的轨迹,不等于经过验证的内部因果解释。
06 它与 RAG、信息来源追踪是什么关系?
简单的 RAG(检索增强生成)通常先检索材料,再生成答案。把知识库检索接入 ReAct 后,模型可以根据已有结果继续改写查询、补充检索,直到提交答案。是否值得增加交互轮次,需要结合收益与成本判断。
进一步,如果我们关心“最终这句话究竟来自哪里”,ReAct 提供了可记录的交互节点,但还没有完成逐句归因。
调用过某篇文档,只能说明系统接触过它;不能自动证明答案里的每句话都来自它。
要做一个可核查的系统,我会在此基础上增加三类记录:
- 每次工具调用的参数、返回原文、来源地址、时间与版本,保存模型当时实际看到的内容。
- 最终答案中的关键事实,与支持它的具体段落建立对应关系;没有足够依据时明确标记。
- 将“检索没找到”“证据被误读”“引用不支持结论”“程序执行失败”分别统计。
这属于基于论文提出的工程扩展,不是 ReAct 已经实现的完整能力。对于模型依靠参数知识生成的内容,更不能只看输出就精确还原其训练来源。
07 把论文变成一个可比较的实验
可以从文档问答入手:在同一模型、文档和检索工具下,比较“一次检索”“允许多轮检索”“多轮检索并关联具体证据”三种设置。除了答案正确率,还记录证据支持程度、无效检索和实际耗时、成本。
这是一项基于论文的实验建议。如果多轮检索没有提升,就沿轨迹检查:查询选错了、资料缺失、证据被误读,还是已经找到答案却没有停止?
ReAct 的启发,是把推理放进能接受外部反馈的过程,再用任务结果检验这个过程。 能解释一次 Agent 为什么多查了一步、为何错误地停止,才开始把论文变成自己的工程判断。
大模型的知识又多又杂,到底怎么学?
做这行久了,被问最多的问题就一个:大模型的知识又多又杂,我到底先学啥?翻了一堆资料,看啥都像重点,结果啥都没学进去。今天把我自己一路摸出来的顺序捋一遍,零基础、应届生、转行的都适用。跟着走,至少方向不乱、不瞎忙,学完拿得出手。
第一阶段(10天):初阶应用
这一阶段就一个目标:把大模型真正"玩明白",不是只会聊天那种,而是能调教它、能用代码把大模型和业务接起来。
- 大模型 AI 能干什么?
- 大模型是怎样获得「智能」的?
- 用好 AI 的核心心法
- 大模型应用业务架构
- 大模型应用技术架构
- 代码示例:向 GPT-3.5 灌入新知识
- 提示工程的意义和核心思想
- Prompt 典型构成
- 指令调优方法论
- 思维链和思维树
- Prompt 攻击和防范
- …
第二阶段(30天):高阶应用
这阶段正式进实战,目标很实在:做出两个能拿出手的东西——一个私有知识库,一个 agent 对话机器人。
-
为什么要做 RAG
-
搭建一个简单的 ChatPDF
-
检索的基础概念
-
什么是向量表示(Embeddings)
-
向量数据库与向量检索
-
基于向量检索的 RAG
-
搭建 RAG 系统的扩展知识
-
混合检索与 RAG-Fusion 简介
-
向量模型本地部署
-
…
走完这 30 天,Python 或 JavaScript 背景的基本能独立做一套 RAG 应用,简历上也敢写"大模型应用开发"了。
第三阶段(约20天):动手微调
学到这,你已经开始 “造” 模型了 —— 通过微调,搞出垂直领域的专用小模型。
- 为什么要做 RAG
- 什么是模型
- 什么是模型训练
- 求解器 & 损失函数简介
- 小实验2:手写一个简单的神经网络并训练它
- 什么是训练/预训练/微调/轻量化微调
- Transformer结构简介
- 轻量化微调
- 实验数据集的构建
- …
恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。
到此为止,大概2个月的时间。你从 “只会用” 变成 “能造” 的 AI 小子。那么你还想往下探索吗?
想要入局AI大模型赛道、抢占行业红利的朋友,微信扫描下方CSDN官方认证二维码,即可100%免费领取全套学习资料!
第四阶段(20天):商业闭环,部署落地
技术学完,落地才算数。这阶段带你搞明白大模型怎么真正跑起来、用起来。
- 硬件选型
- 带你了解全球大模型
- 使用国产大模型服务
- 搭建 OpenAI 代理
- 热身:基于阿里云 PAI 部署 Stable Diffusion
- 在本地计算机运行大模型
- 大模型的私有化部署
- 基于 vLLM 部署大模型
- 案例:如何优雅地在阿里云私有部署开源大模型
- 部署一套开源 LLM 项目
- 内容安全
- 互联网信息服务算法备案
- …
想要入坑大模型的朋友,给大家准备了一份2026 年最新 AI 大模型全套学习资料:
1、大模型系统化学习路线
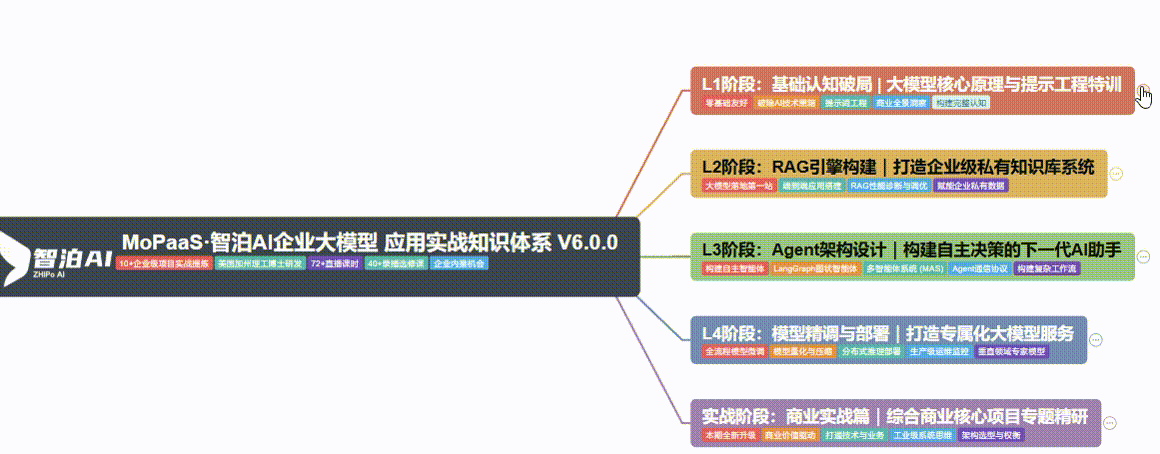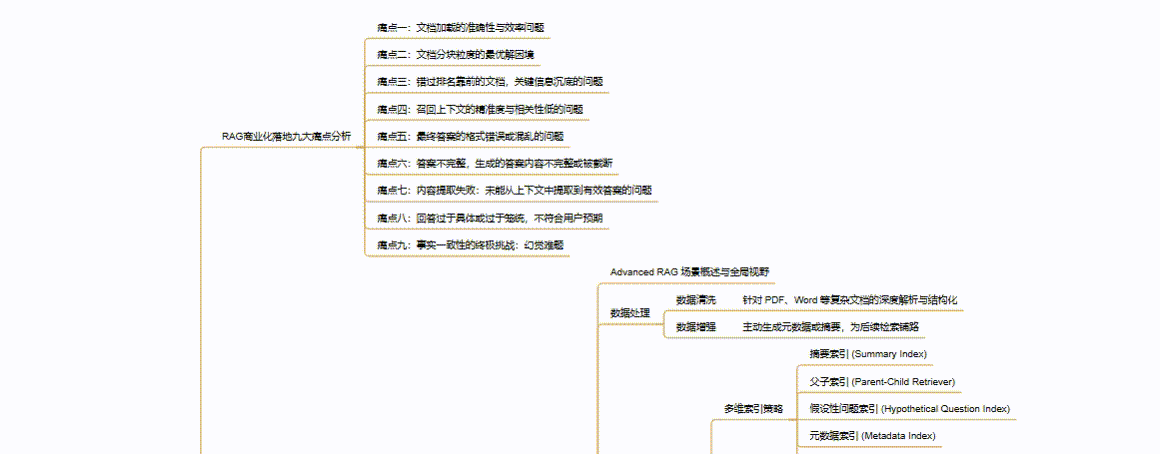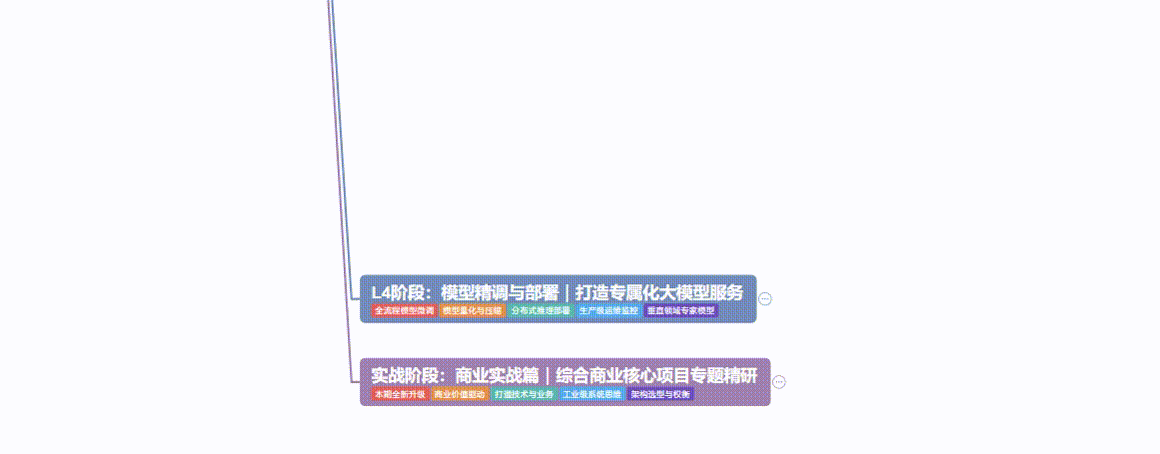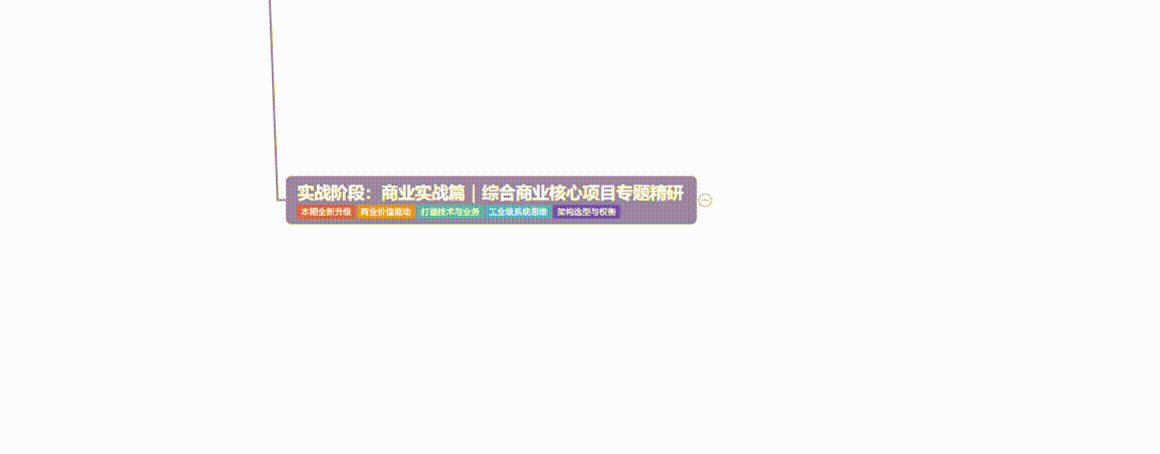
2、大模型学习视频教程
3、大模型学习书籍&电子文档
4、AI大模型最新行业报告
5、大模型项目实战&配套源码
6、2026大模型大厂面试真题
7、为什么要学习大模型?
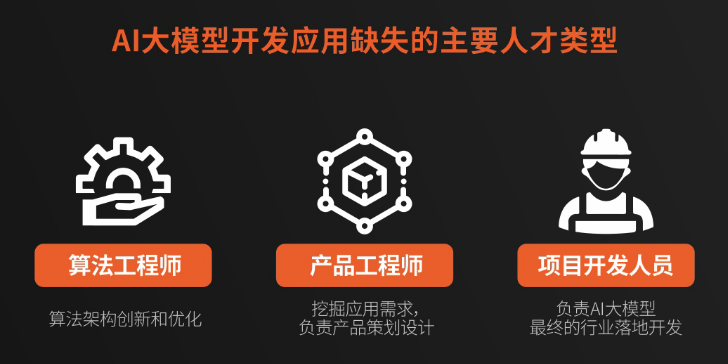
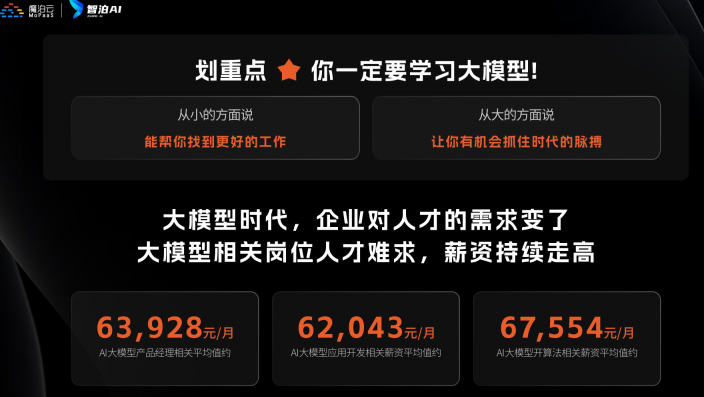
我国在A大模型领域面临人才短缺,数量与质量均落后于发达国家。2023年,人才缺口已超百万,凸显培养不足。随着AI技术飞速发展,预计到2025年,这一缺口将急剧扩大至400万,严重制约我国AI产业的创新步伐。加强人才培养,优化教育体系,国际合作并进是破解困局、推动AI发展的关键。
8、适合谁学?
- 传统后端 / Java / 前端开发,想转型 AI 应用
- 大学生、应届生,想拿更好的 offer
- 产品经理、运营,想武装职业竞争力
- 技术负责人,想给团队落地提效
学习是反人性的,但回报是真金白银。技术会更新,赛道会切换,但只要你先动手,机会就永远站在你这边。
9、这些资料真的有用吗?
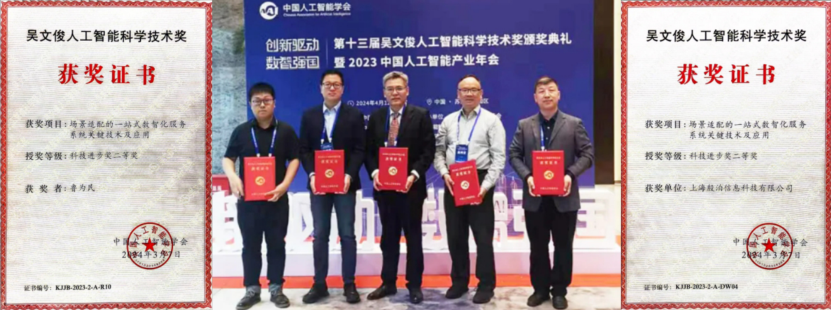
这份资料由我和鲁为民博士(北京清华大学学士和美国加州理工学院博士)共同整理,现任上海殷泊信息科技CEO,其创立的MoPaaS云平台获Forrester全球’强劲表现者’认证,服务航天科工、国家电网等1000+企业,以第一作者在IEEE Transactions发表论文50+篇,获NASA JPL火星探测系统强化学习专利等35项中美专利。本套AI大模型课程由清华大学-加州理工双料博士、吴文俊人工智能奖得主鲁为民教授领衔研发。
资料内容涵盖了从入门到进阶的各类视频教程和实战项目,无论你是小白还是有些技术基础的技术人员,这份资料都绝对能帮助你提升薪资待遇,转行大模型岗位。
想要入局AI大模型赛道、抢占行业红利的朋友,微信扫描下方CSDN官方认证二维码,即可100%免费领取全套学习资料!
好了,就写到这。路线是死的,人是活的,卡住了随时来问我。觉得有用就点个收藏,别让它进收藏夹吃灰——动起来比啥都强。