📚 本文收录于「流浪」的系列专栏
| 🐧 Linux系统 | ⚙️ C++ |
| 📊 数据结构与算法 | 🐍 Python |
| 🔗 LangChain & LangGraph | 🗄️ MySQL 数据库 |
| 🌿 Git 工具 | 🌐 计算机网络 |
| 🤖 LLM | 💯 大厂面试、八股 |
| 📚 学习筑基专栏 |
🏠 博客主页:流浪 | 📝 原创首发于 CSDN
前言:计算机网络篇8把 TCP 的报文边界交给了应用层自己切。UDP 反过来,用 8 个字节定长报头把边界在协议内部定死。本篇拆这 8 个字节:四个字段各管什么、定长怎么让报头与载荷天然分开、端口号怎么把载荷交到进程,再往下讲面向数据报、缓冲区,以及内核里一条报文是怎么被描述和处理的。
一、传输层把数据送到进程,五元组锁定一次通信
1.1 传输层交付的对象是进程而不是主机
1. 传输层负责端到端,逐跳转发不归它管
2. UDP 与 TCP 在传输层给出不同的交付承诺
IP 负责把数据送到哪台主机,传输层负责把它送进哪个进程。只有到了进程手里,一次网络传输才算真正完成。
1.2 五元组把一次通信从所有通信里挑出来
1. 四元组先锁定通信两端
2. 协议号补上第五个元
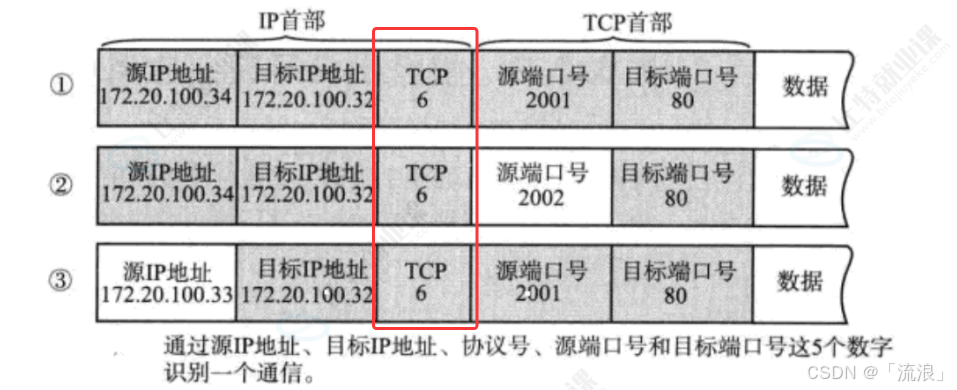
四元组锁定两端,协议号锁定协议栈。少掉任何一个,同一台主机上并存的 TCP 和 UDP 就没法各走各的路。
1.3 端口号分段使用,知名端口固定给公开服务
1. 0 到 1023 留给公开服务
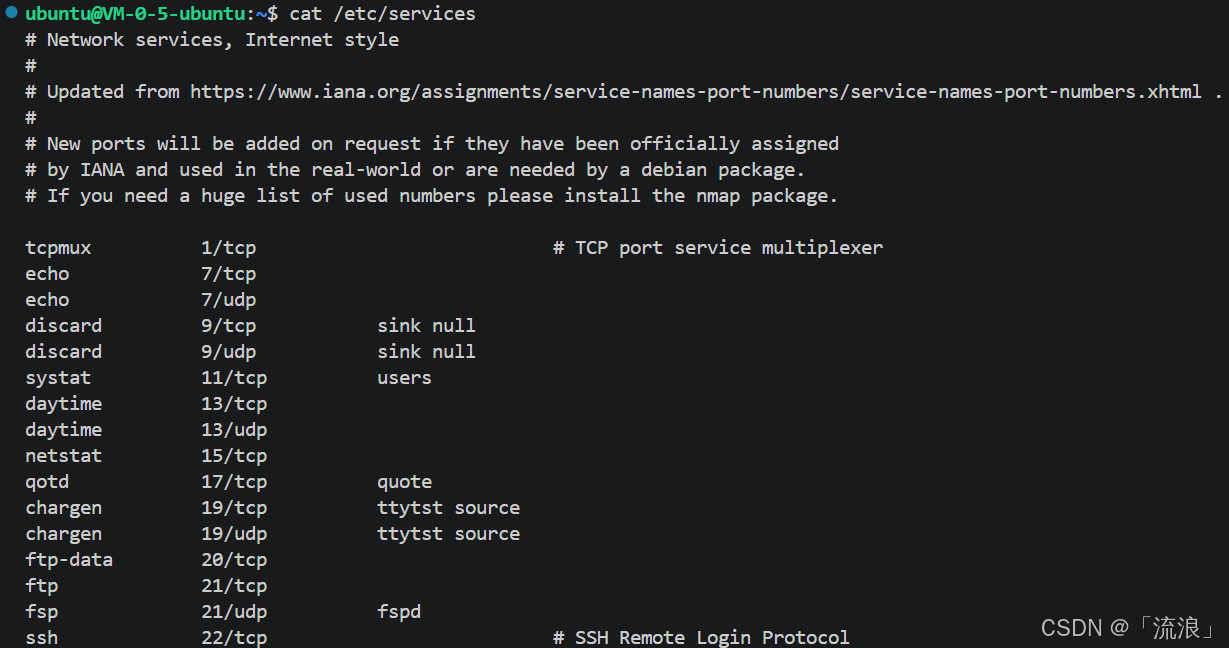
2. 1024 到 65535 交给操作系统动态分配
3. 自己写程序时要避开知名端口
4. 一个进程可以绑多个端口,一个端口默认只归一个进程
端口号是给服务挂的固定门牌,门牌不变、租客可以换;想让两个租客共用一个门牌,得先显式声明复用,否则后来的只能被挡在门外。
二、UDP 报头是 8 字节定长结构,四个字段各管一件事
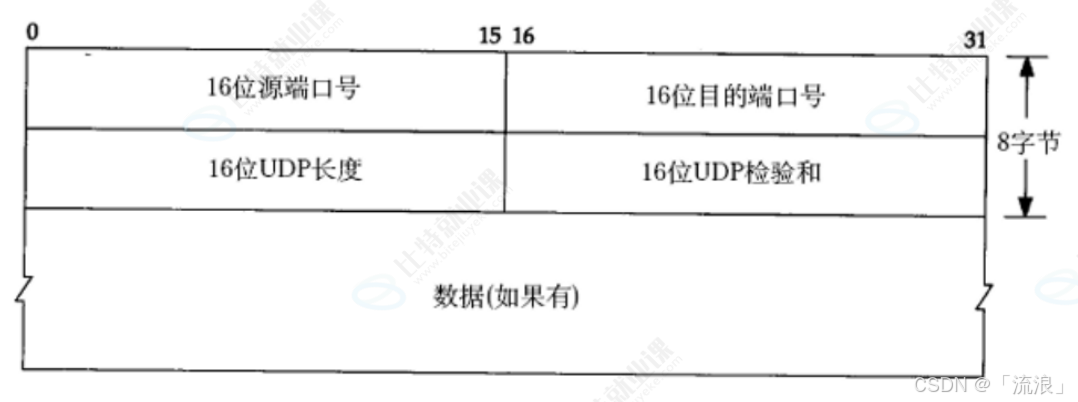
2.1 四字段各占 16 位,总共 8 字节
1. 两个 16 位端口号指定收发双方
2. 16 位长度字段覆盖首部加数据
3. 16 位校验和出错就整条丢弃
四个 16 位字段凑够 8 字节,把收发双方、整条长度、数据完整性三件事装进同一个固定的壳里。
2.2 报头在内核里就是一个 8 字节结构体
1. 协议的实际形态是用结构体描述固定字段
struct udphdr {
__be16 source; /* 源端口号 */
__be16 dest; /* 目的端口号 */
__be16 len; /* UDP 长度:首部 + 数据 */
__sum16 check; /* 校验和 */
};
2. 同为 C 语言实现,结构体可以直接挪到数据头部
3. 端口字段上网络之前要过字节序转换
报头在报文里是一段字节,在内核里就是一个 8 字节结构体。布局由协议定死,实现就不用再做解析。
2.3 定长报头让分离不需要任何分隔符
1. 前 8 字节固定是报头,其后全是有效载荷
2. 封装反向同理,按 8 字节填头即可
定长报头把「哪里是头」这件事从报文内容里拎出来、写进了协议规定,分离因此不需要任何额外标记。
三、端口号完成分用,sendto 必须带目的端口
3.1 目的端口号决定报文最终交给哪个进程
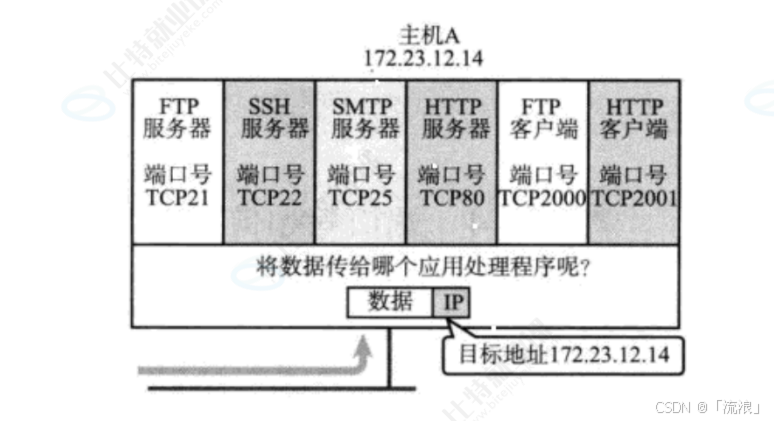
1. 内核按目的端口查表找到对应 socket
2. sendto 必须带目的地址,因为报头里的目的端口只能由调用方给出
目的端口号是唯一能把报文指到具体进程的字段,而它只能由调用方通过 sendto 递进来,内核自己变不出来。
3.2 分用分两级完成
1. 协议号先决定交给 TCP 还是 UDP
2. 端口号再决定交给哪个应用进程
两级查表走完,数据从「某个 IP 上的一段字节」变成了「某个进程收到的一份数据」。
3. 端口号是 16 位,因为报头里这个字段就是 16 位
分用是两次查表:协议号决定谁来拆这个包,目的端口决定拆完交给谁。UDP 只负责后一半,前一半在 IP 层就做完了。
四、面向数据报:UDP 不碰应用层交下来的报文边界
4.1 应用层交多长,UDP 就发多长
1. 既不拆分也不合并
2. 一次 sendto 必须对应一次 recvfrom
3. 读写次数和数量无法灵活控制
发几次就得收几次,发多大就得收多大。UDP 用「不灵活」换来了边界的完整。
4.2 报文边界来自 8 字节报头之后那段数据
1. 去掉定长报头,剩下的字节数就是这条报文的数据长度
2. 每个数据报交给上层时长度是确定的
3. 边界的代价是长度上限和缓冲区要求
UDP 的边界是算出来的,不是标出来的:定长报头一扣,剩下的长度就是这条报文的全部。
4.3 UDP 的三个特点都指向同一件事
1. 无连接:知道对端 IP 和端口就直接发
2. 不可靠:没有确认与重传
3. 面向数据报:读写次数和数量不由应用层灵活控制
4. 用寄信理解这三个特点
UDP 的不可靠不是缺陷,是省下来的成本——它把「保证送到」整个推给了应用层,自己只保留把整块数据甩出去这一个动作。
五、缓冲区、64K 上限与应用层协议
5.1 没有真正意义上的发送缓冲区
1. sendto 直接交给内核,由内核继续往下推
2. 无连接与不可靠决定了不需要留副本
不留副本的前提是永远不会重发;UDP 既没有确认也没有重传,发送方向自然不需要缓冲区。
5.2 接收缓冲区带来乱序与丢弃两件事
1. 缓冲区是报文排队等应用层来取的地方
2. 不保证顺序,缓冲区满了就丢弃
3. 同一个 socket 既能读也能写
接收缓冲区是应用层处理速度和网络到达速度之间的垫子,代价是乱序和满则丢弃。
5.3 16 位长度字段把单个数据报锁在 64K 以内
1. 64K 包含 8 字节首部
2. 超过 64K 只能在应用层自己分包
64K 不是随手定的数,是 16 位字段能表示的最大值。字段宽度定在哪里,能力天花板就压在哪里。
5.4 基于 UDP 的应用层协议
1. 常见的几个
2. 它们选 UDP 的共同理由
用 UDP 写程序时自定义的那套报文格式,本身就是一份应用层协议,它和上面那几个有名有姓的协议在层次上没有任何区别。
会选 UDP 的协议都有同一个特征:报文小、一问一答、重试比等待便宜。
六、OS 怎么管住同机并存的成千上万个报文:先描述再组织
6.1 服务端单机内一定同时存在大量待处理报文
1. 应用层解析快慢不影响内核收报文
2. 管理方式先描述再组织
报文的到达节奏由网络决定、不由应用层决定,所以内核必须先把它们收下来,再慢慢处理。
6.2 struct sk_buff 用四个指针描述一块报文缓冲区
struct sk_buff {
// 双向链表,skb可以串成队列
struct sk_buff *next;
struct sk_buff *prev;
// 四个核心指针,描述一块报文缓冲区
unsigned char *head; // 整块buffer内存起始,固定
unsigned char *data; // 当前有效数据起始,可变
unsigned char *tail; // 当前有效数据末尾,可变
unsigned char *end; // 整块buffer内存末尾,固定
unsigned int len; // 当前有效数据长度: tail – data
unsigned int truesize;// sk_buff结构体 + 数据buffer总大小
// 协议头偏移(不是指针,是偏移量)
__u16 mac_header; // mac头偏移
__u16 network_header; // 网络层头偏移
__u16 transport_header;//传输层头偏移
struct net_device *dev; // 绑定的网卡设备
};
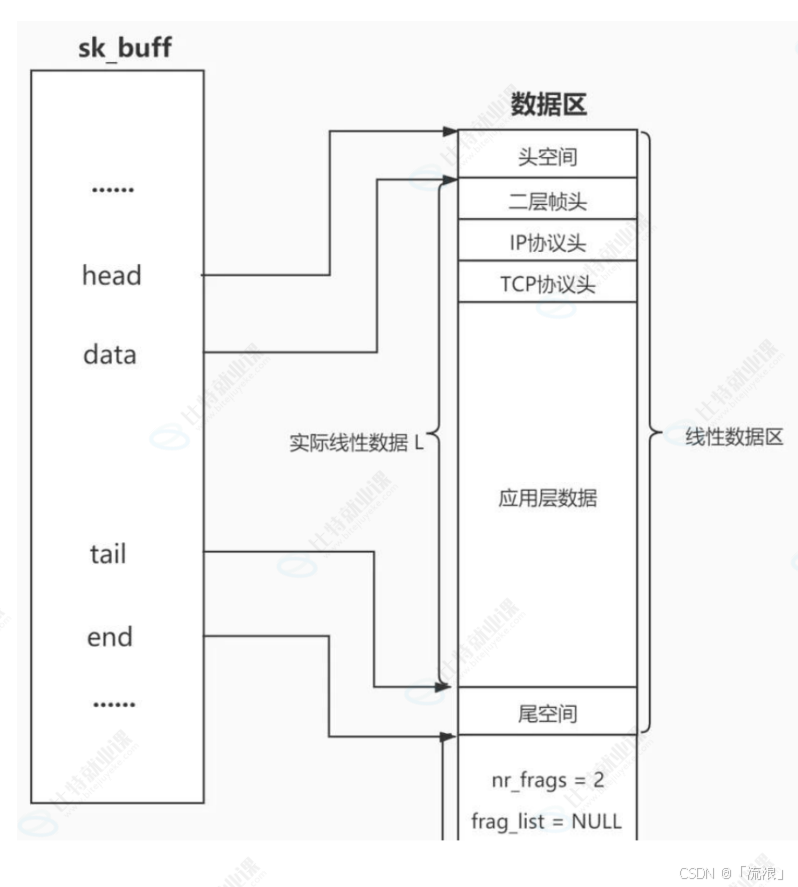
1. head 与 data 划出预留区和数据起点
2. tail 与 end 划出数据末尾和内存末尾
3. 一条报文的内存由报头与有效载荷两部分构成
四个指针把一块内存切成三段:预留区留给报头,数据区装有效载荷,尾部空间留着扩容。
6.3 封包与解包本质是移动 data 指针
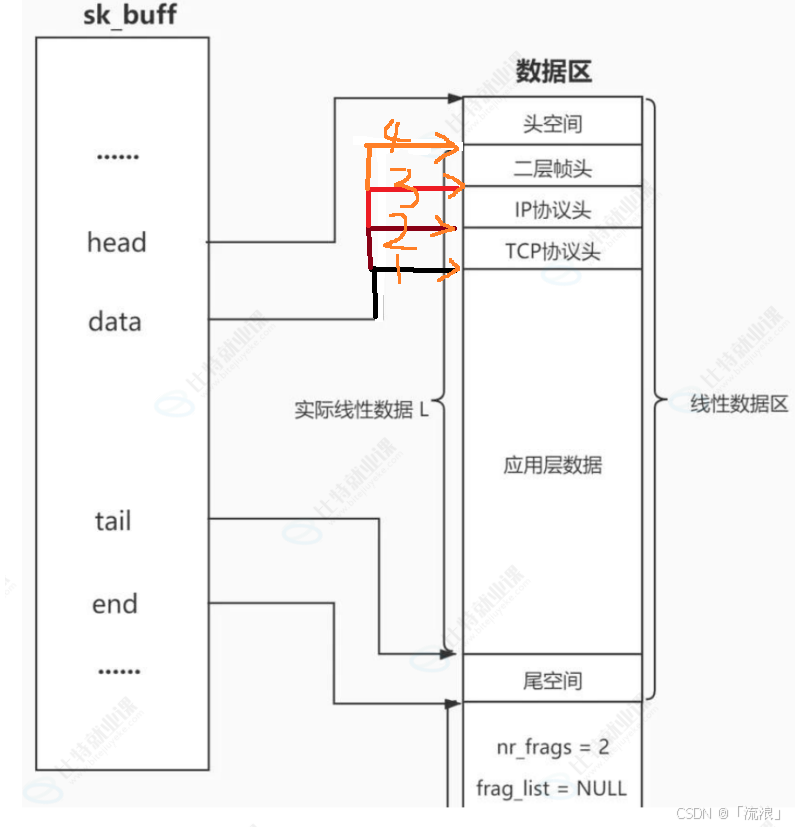
1. 每向下交付一层,data 前移对应报头大小
2. 解包时 data 后移,正好相反
3. 接收方的报文以 sk_buff 形态被双链表与队列管理
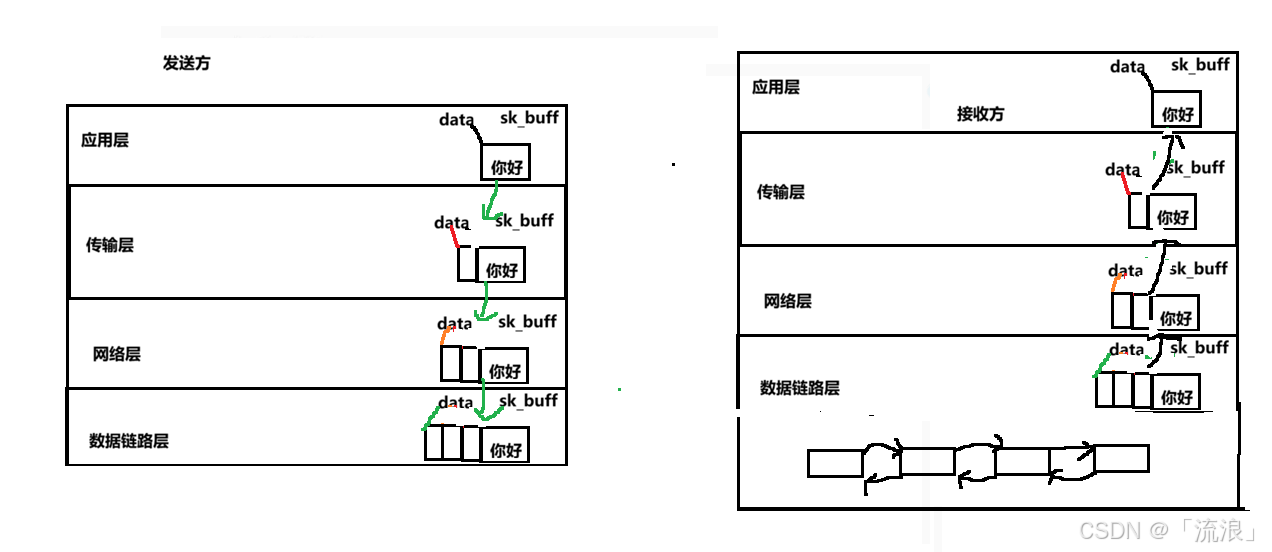
4. UDP 报头与载荷的分离、分用由此统一解释
5. 真实内核的 sk_buff 比四指针模型复杂
封包不是把数据一层层拷进新缓冲区,而是让 data 指针在预留空间里向前走;解包就是把指针往后挪回来。
七、全篇总结
1. 传输层的职责是交付到进程
2. UDP 报头是 8 字节定长结构
3. 分用靠两级查表
4. 面向数据报保住了报文边界
5. 发送方向不缓存、接收方向要排队
6. 内核用 sk_buff 描述并组织报文
八、文末面试题
8.1 推导题(按本篇知识点,附答案)
【推导】UDP 报头里没有「首部长度」字段,接收方怎么知道前 8 个字节是头、后面全是数据? 答:因为报头长度由协议规定死是 8 字节,接收方读满 8 个字节就直接切,不需要报文自己声明头有多长;IP 报头必须有首部长度字段,是因为它的长度可变(带选项时不固定)。
【推导】UDP 报头里既没有「首部长度」也没有「序号」,而 TCP 两个都有,为什么? 答:首部长度的差别来自可变性——UDP 首部固定 8 字节不用声明,TCP 首部带选项、长度可变必须自带字段说明;序号的差别来自职责——TCP 靠序号做按序交付和重传判定,UDP 这两件事都不做,留个序号字段也没有任何用途。
【推导】sendto 为什么每次都要带目的地址,而 TCP 的 send 不用? 答:UDP 没有连接,报头里的目的 IP 和目的端口只能由本次调用传进来,内核没有别的地方可查;TCP 在建连时已经把对端地址记在连接控制块里,后续 send 直接取用。
【推导】UDP 为什么没有发送缓冲区,却必须有接收缓冲区? 答:发送方向不需要缓冲区,是因为不可靠协议不会重发,留副本没有任何用途;接收方向必须有缓冲区,是因为报文到达的时刻由网络决定、应用层取数据的时刻由自己决定,中间需要一块地方先把报文接住,否则报文一到就只能丢弃。
【推导】sk_buff 的 data 指针既能表示封包又能表示解包,同一套机制为什么能同时干两件事? 答:因为封包和解包都是「在预留空间里改变有效数据的起点」——封包把 data 向前移、让新报头落在 data 前面,解包把 data 向后移、把已经读过的报头排除在外,两者对 data 的操作方向相反但语义完全一致。
【推导】UDP 的接收缓冲区满了以后,新到的报文为什么直接丢,而不是像 TCP 那样让发送方慢下来? 答:因为 UDP 没有流量控制,接收方没有任何手段把「我慢了」这个消息传回发送方,两端之间不存在窗口这回事;缓冲区是这个方向上唯一的缓冲垫,垫满了就只能丢弃,且丢弃后不通知任何人。
8.2 真题(来源已核实,转述注明)
UDP 报头有哪些字段?报头和有效载荷是怎么分离、又怎么交付给上层的? 答:固定 8 字节、四个字段各 16 位,依次是源端口号、目的端口号、UDP 长度(整条数据报的长度,含 8 字节首部)、UDP 校验和;分离靠定长,读满前 8 个字节即为报头、其后全是有效载荷;交付靠分用,从报头取出目的端口号,查 socket 映射表找到对应进程再把有效载荷交上去。 【真题·转述自 牛客网《后端面试高频:UDP协议》】
UDP 的校验和是怎么算的?算出来对不上会怎么处理? 答:发送方把伪首部(源 IP、目的 IP、协议号、UDP 长度)、UDP 首部和数据一起按 16 位分组做反码求和,结果取反填入校验和字段;接收方用同样的方法重算并比对,不一致就把整条数据报丢弃,而且不会通知应用层。 【真题·转述自 CSDN《UDP协议面试指南》】
怎么理解 UDP 的面向数据报? 答:应用层交给 UDP 多长的报文,UDP 就原样发送,既不拆分也不合并;发送端一次 sendto 发 100 字节,接收端就必须一次 recvfrom 收 100 字节,不能循环 10 次每次收 10 字节,读写次数和数量都无法灵活控制。 【真题·转述自 牛客网《后端面试高频:UDP协议》】
UDP 会粘包吗?为什么? 答:不会。粘包的前提是协议把数据当成无边界字节流,TCP 正是如此,多次 write 可能被一次 read 读完;UDP 面向数据报,一次 sendto 的数据在接收端正好由一次 recvfrom 完整取出,边界由协议保留,既不会合并也不会拆分。 【真题·转述自 CSDN《UDP协议面试指南》】
一条 UDP 数据报最大能传多少数据?业务数据超过这个长度怎么办? 答:报头长度字段 16 位,单条数据报上限 65535 字节,扣掉 8 字节首部后数据区最多 65527 字节,在 IPv4 下再扣 20 字节 IP 首部剩 65507 字节;超过就得在应用层手动分包,每块加序号分多次发送,接收端按序号手动拼装。 【真题·转述自 CSDN《UDP协议面试指南》】
DNS 为什么主要用 UDP 而不是 TCP? 答:DNS 查询是一问一答、报文很小,UDP 省掉建连的往返,一次查询一个来回就能出结果,客户端重试的成本也远低于维持一条 TCP 连接;只有在响应超过 512 字节或做区域传送时才会改用 TCP。 【真题·转述自 CSDN《UDP协议面试指南》】
UDP 把能省的全省了,只留下一个 8 字节的报头和一句「送到就到、不到就算」。它不保证的那些事,最后都得由应用层自己补上。