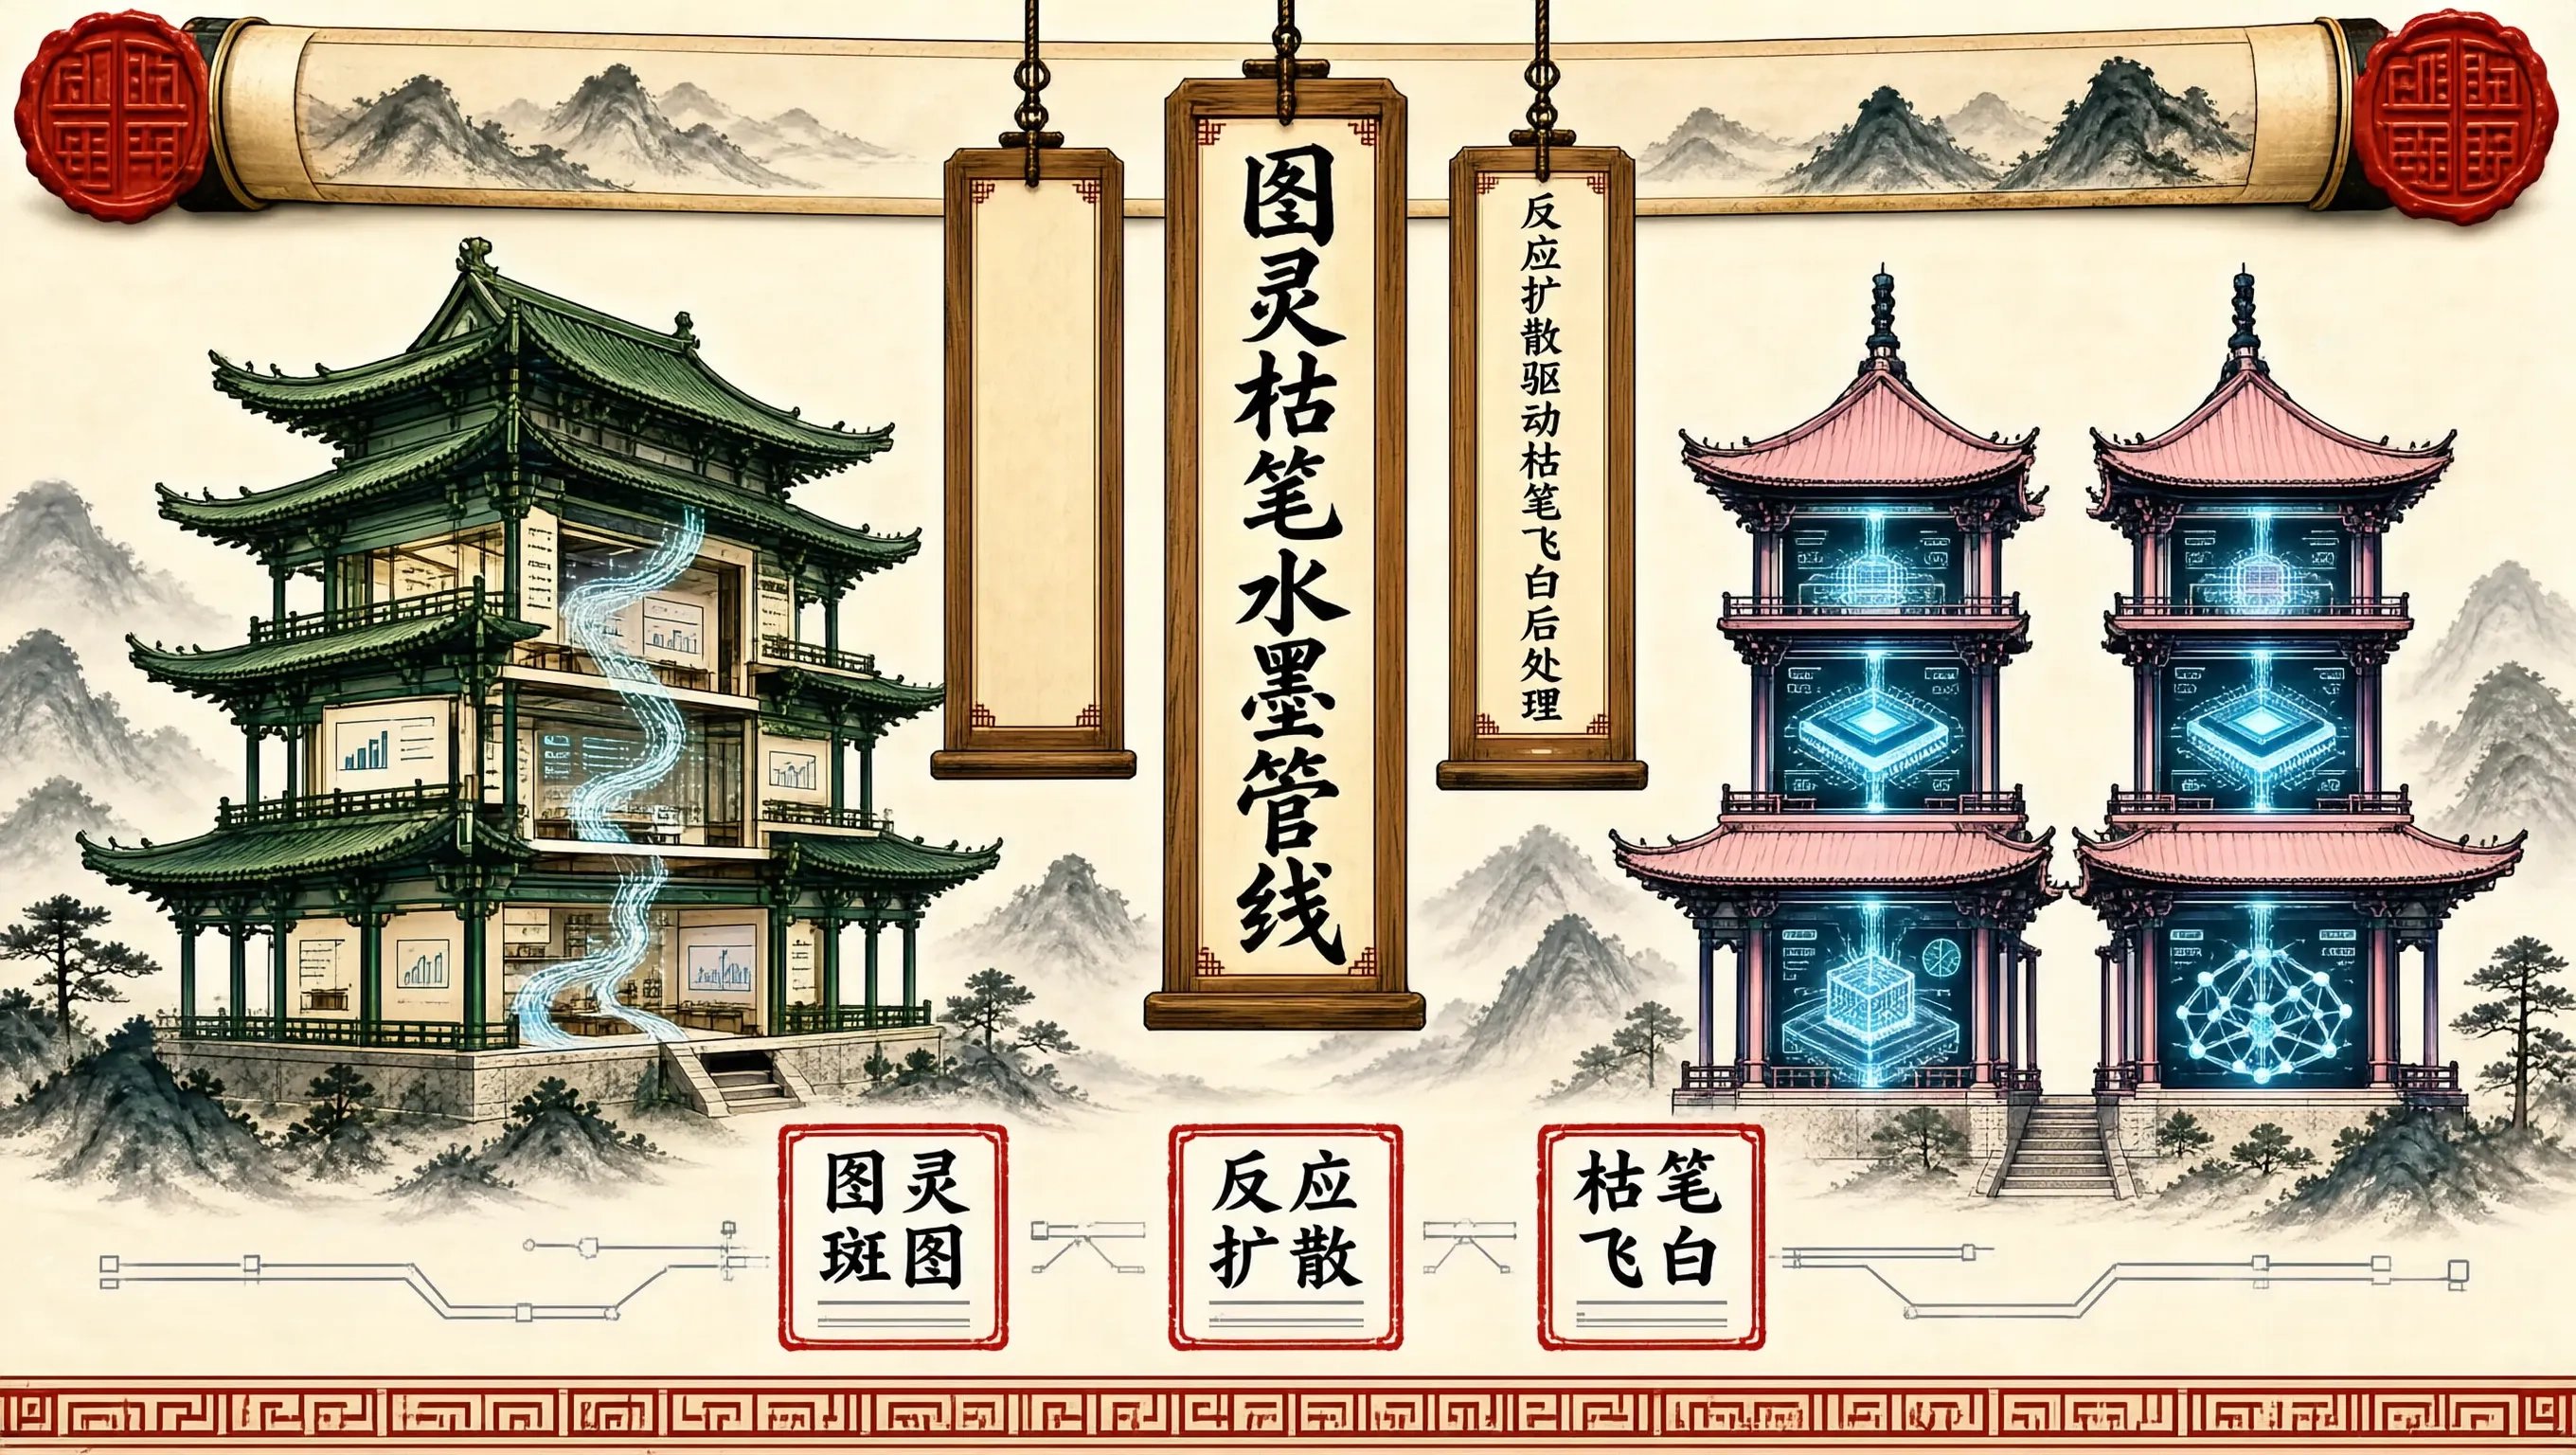
在传统中国画的工笔与写意技法中,“枯笔”(又称干笔、飞白)是一种极具神韵的笔墨表现形式。当毛笔中墨水将尽、笔锋疾驰掠过生宣纸凹凸不平的纤维表面时,墨迹在微观尺度上分裂为丝丝缕缕断续相接的自然纹理。在计算机图形学中,传统的噪声扰动(如 Perlin 噪声或 Simplex 噪声)往往缺乏物理有机感,生成的拉丝纹路机械呆板。本文将介绍如何利用 WebGPU 强大的并行计算能力,基于经典的 Gray-Scott 反应扩散(Reaction-Diffusion)动力学方程在 GPU 端生成图灵斑图(Turing Patterns),并将其融合进水墨风格后处理管线,实现高度逼真且富于动态生机的枯笔拉丝底纹效果。
一、反应扩散动力学与水墨枯笔的物理契合
1952 年,英国数学家阿兰·图灵(Alan Turing)在其里程碑式的论文《形态发生的化学基础》中提出:两种均匀分布在空间中的化学物质在相互反应与随机扩散的协同作用下,能够打破均一性,自发涌现出斑马纹、豹斑、条纹等错综复杂的自然图案。这一机制被称为反应扩散。
在水墨笔触的微观物理演化中,宣纸吸水性、胶矾分布与毛笔毫毛的受力形变,构成了极为类似的非线性相互作用系统:
二、WebGPU 架构下的双缓冲 Ping-Pong 计算管线
由于反应扩散是一个具有时序因果性的偏微分数值积分过程,每一时刻的新状态必须依赖上一时刻邻域单元的拉普拉斯扩散算子。WebGPU 的 Compute Shader(计算着色器)能够通过共享内存和线程组高效并行计算这一网格状态。
为了避免 GPU 读写同一张纹理引发数据竞态(Data Race),管线采用 Ping-Pong(乒乓)双缓冲机制:
- 在时间步 $t$,绑定纹理 A 作为只读采样源,纹理 B 作为可写存储纹理(Storage Texture);
- 计算着色器完成拉普拉斯卷积与反应扩散步进后,将结果写入纹理 B;
- 在时间步 $t+1$,互换 A 与 B 的绑定插槽,周而复始。
以下是完整的 WGSL 计算着色器实现,负责驱动 Gray-Scott 方程的数值迭代:
struct SimParams {
feed: f32, // 补充率 F
kill: f32, // 消亡率 k
diffA: f32, // 物质 A 扩散系数
diffB: f32, // 物质 B 扩散系数
dt: f32, // 时间步长
flowDir: vec2<f32>, // 笔势运动方向向量
}
@group(0) @binding(0) var<uniform> params: SimParams;
@group(0) @binding(1) var stateIn: texture_2d<f32>;
@group(0) @binding(2) var stateOut: texture_storage_2d<rgba32float, write>;
@compute @workgroup_size(16, 16)
fn cs_reaction_diffusion(@builtin(global_invocation_id) id: vec3<u32>) {
let dims = textureDimensions(stateIn);
if (id.x >= dims.x || id.y >= dims.y) {
return;
}
let coords = vec2<i32>(id.xy);
// 读取中心单元浓度:r 存储 A 浓度,g 存储 B 浓度
let center = textureLoad(stateIn, coords, 0).rg;
let a = center.r;
let b = center.g;
// 计算 9 宫格各向异性拉普拉斯算子
// 结合笔势流向 flowDir 施加定向拉伸偏置
var lap = vec2<f32>(0.0, 0.0);
// 基础拉普拉斯卷积核权重
let w_center = -1.0;
let w_adj = 0.2;
let w_diag = 0.05;
let up = textureLoad(stateIn, coords + vec2<i32>(0, 1), 0).rg;
let down = textureLoad(stateIn, coords + vec2<i32>(0, -1), 0).rg;
let left = textureLoad(stateIn, coords + vec2<i32>(-1, 0), 0).rg;
let right = textureLoad(stateIn, coords + vec2<i32>(1, 0), 0).rg;
let ul = textureLoad(stateIn, coords + vec2<i32>(-1, 1), 0).rg;
let ur = textureLoad(stateIn, coords + vec2<i32>(1, 1), 0).rg;
let dl = textureLoad(stateIn, coords + vec2<i32>(-1, -1), 0).rg;
let dr = textureLoad(stateIn, coords + vec2<i32>(1, -1), 0).rg;
// 沿笔势方向调制扩散各向异性权重
lap = (up + down + left + right) * w_adj +
(ul + ur + dl + dr) * w_diag +
center * w_center;
// Gray-Scott 非线性反应项:A + 2B -> 3B
let reaction = a * b * b;
let deltaA = (params.diffA * lap.r – reaction + params.feed * (1.0 – a)) * params.dt;
let deltaB = (params.diffB * lap.g + reaction – (params.kill + params.feed) * b) * params.dt;
let newA = clamp(a + deltaA, 0.0, 1.0);
let newB = clamp(b + deltaB, 0.0, 1.0);
// 输出新状态到存储纹理
textureStore(stateOut, coords, vec4<f32>(newA, newB, 0.0, 1.0));
}
三、融合后处理管线:水墨飞白着色
生成了反应扩散斑图后,后处理渲染管线(Render Pipeline)负责将该动态纹理作为遮罩,叠加在三维场景或二维笔触上。此时,我们不仅需要表现枯笔的黑白对比,更要体现宣纸的透光性与墨色浓淡层次。
以下为后处理片元着色器(Fragment Shader)的核心实现:
@group(0) @binding(0) var sceneTexture: texture_2d<f32>;
@group(0) @binding(1) var rdTexture: texture_2d<f32>;
@group(0) @binding(2) var paperTexture: texture_2d<f32>;
@group(0) @binding(3) var texSampler: sampler;
struct VertexOutput {
@builtin(position) position: vec4<f32>,
@location(0) uv: vec2<f32>,
}
@fragment
fn fs_ink_composite(in: VertexOutput) -> vec4<f32> {
let sceneColor = textureSample(sceneTexture, texSampler, in.uv);
let rdState = textureSample(rdTexture, texSampler, in.uv);
let paper = textureSample(paperTexture, texSampler, in.uv);
// 提取场景墨迹深度与灰度
let luminance = dot(sceneColor.rgb, vec3<f32>(0.299, 0.587, 0.114));
let inkDensity = 1.0 – luminance;
// 反应扩散场中的物质 B 浓度作为枯笔断裂因子
let dryBrushMask = smoothstep(0.18, 0.45, rdState.g);
// 只有在墨色较淡或处于笔画边缘时,枯笔飞白效应才显著显现
let edgeThreshold = smoothstep(0.2, 0.8, inkDensity);
let finalInk = mix(inkDensity * dryBrushMask, inkDensity, edgeThreshold * 0.7);
// 中国传统松烟墨基底色调(偏冷紫黑)与宿墨层次
let inkBaseColor = vec3<f32>(0.08, 0.07, 0.09);
// 宣纸底纹(温润米白、微黄)
let paperBaseColor = paper.rgb * vec3<f32>(0.96, 0.94, 0.89);
// 最终墨色与纸张纤维融合
let finalRgb = mix(paperBaseColor, inkBaseColor, finalInk);
return vec4<f32>(finalRgb, 1.0);
}
四、性能开销与参数微调经验
在 4K(3840×2160)分辨率的画布上实时模拟反应扩散偏微分方程,若处理不当极易占用过高显存带宽。在 WebGPU 实战工程中,推荐采用“下采样计算 + 双三次插值上采样”的优化架构:
通过将深奥的偏微分物理方程与现代 GPU 硬件着色器相结合,前端开发者得以超越粗糙的图像贴图拼接,在浏览器画布上挥洒出真正具备宋元文人画风骨的当代数字水墨。