/* MD / 富文本中的 .toc(含博客园搬家等嵌套结构);.toc-box 在侧栏,不受影响 */
#content_views .toc,
/* 编辑器常在目录前后插入空 p(:empty 仍占 20px),一并去掉避免顶空隙 */
#content_views.markdown_views > p:empty:has(+ .toc),
#content_views.markdown_views > .toc + p:empty,
/* 富文本旧版目录标记 */
#content_views.htmledit_views #main-toc,
#content_views.htmledit_views #hr-toc,
#content_views.htmledit_views p[id*=\”-toc\”] {
display: none !important;
}
/* 目录去掉后,紧跟的首个标题不再多出一块上边距 */
#content_views.markdown_views > .toc + h1,
#content_views.markdown_views > .toc + h2,
#content_views.markdown_views > .toc + h3,
#content_views.markdown_views > .toc + h4,
#content_views.markdown_views > .toc + p:empty + h1,
#content_views.markdown_views > .toc + p:empty + h2,
#content_views.markdown_views > .toc + p:empty + h3,
#content_views.markdown_views > .toc + p:empty + h4 {
margin-top: 0 !important;
}
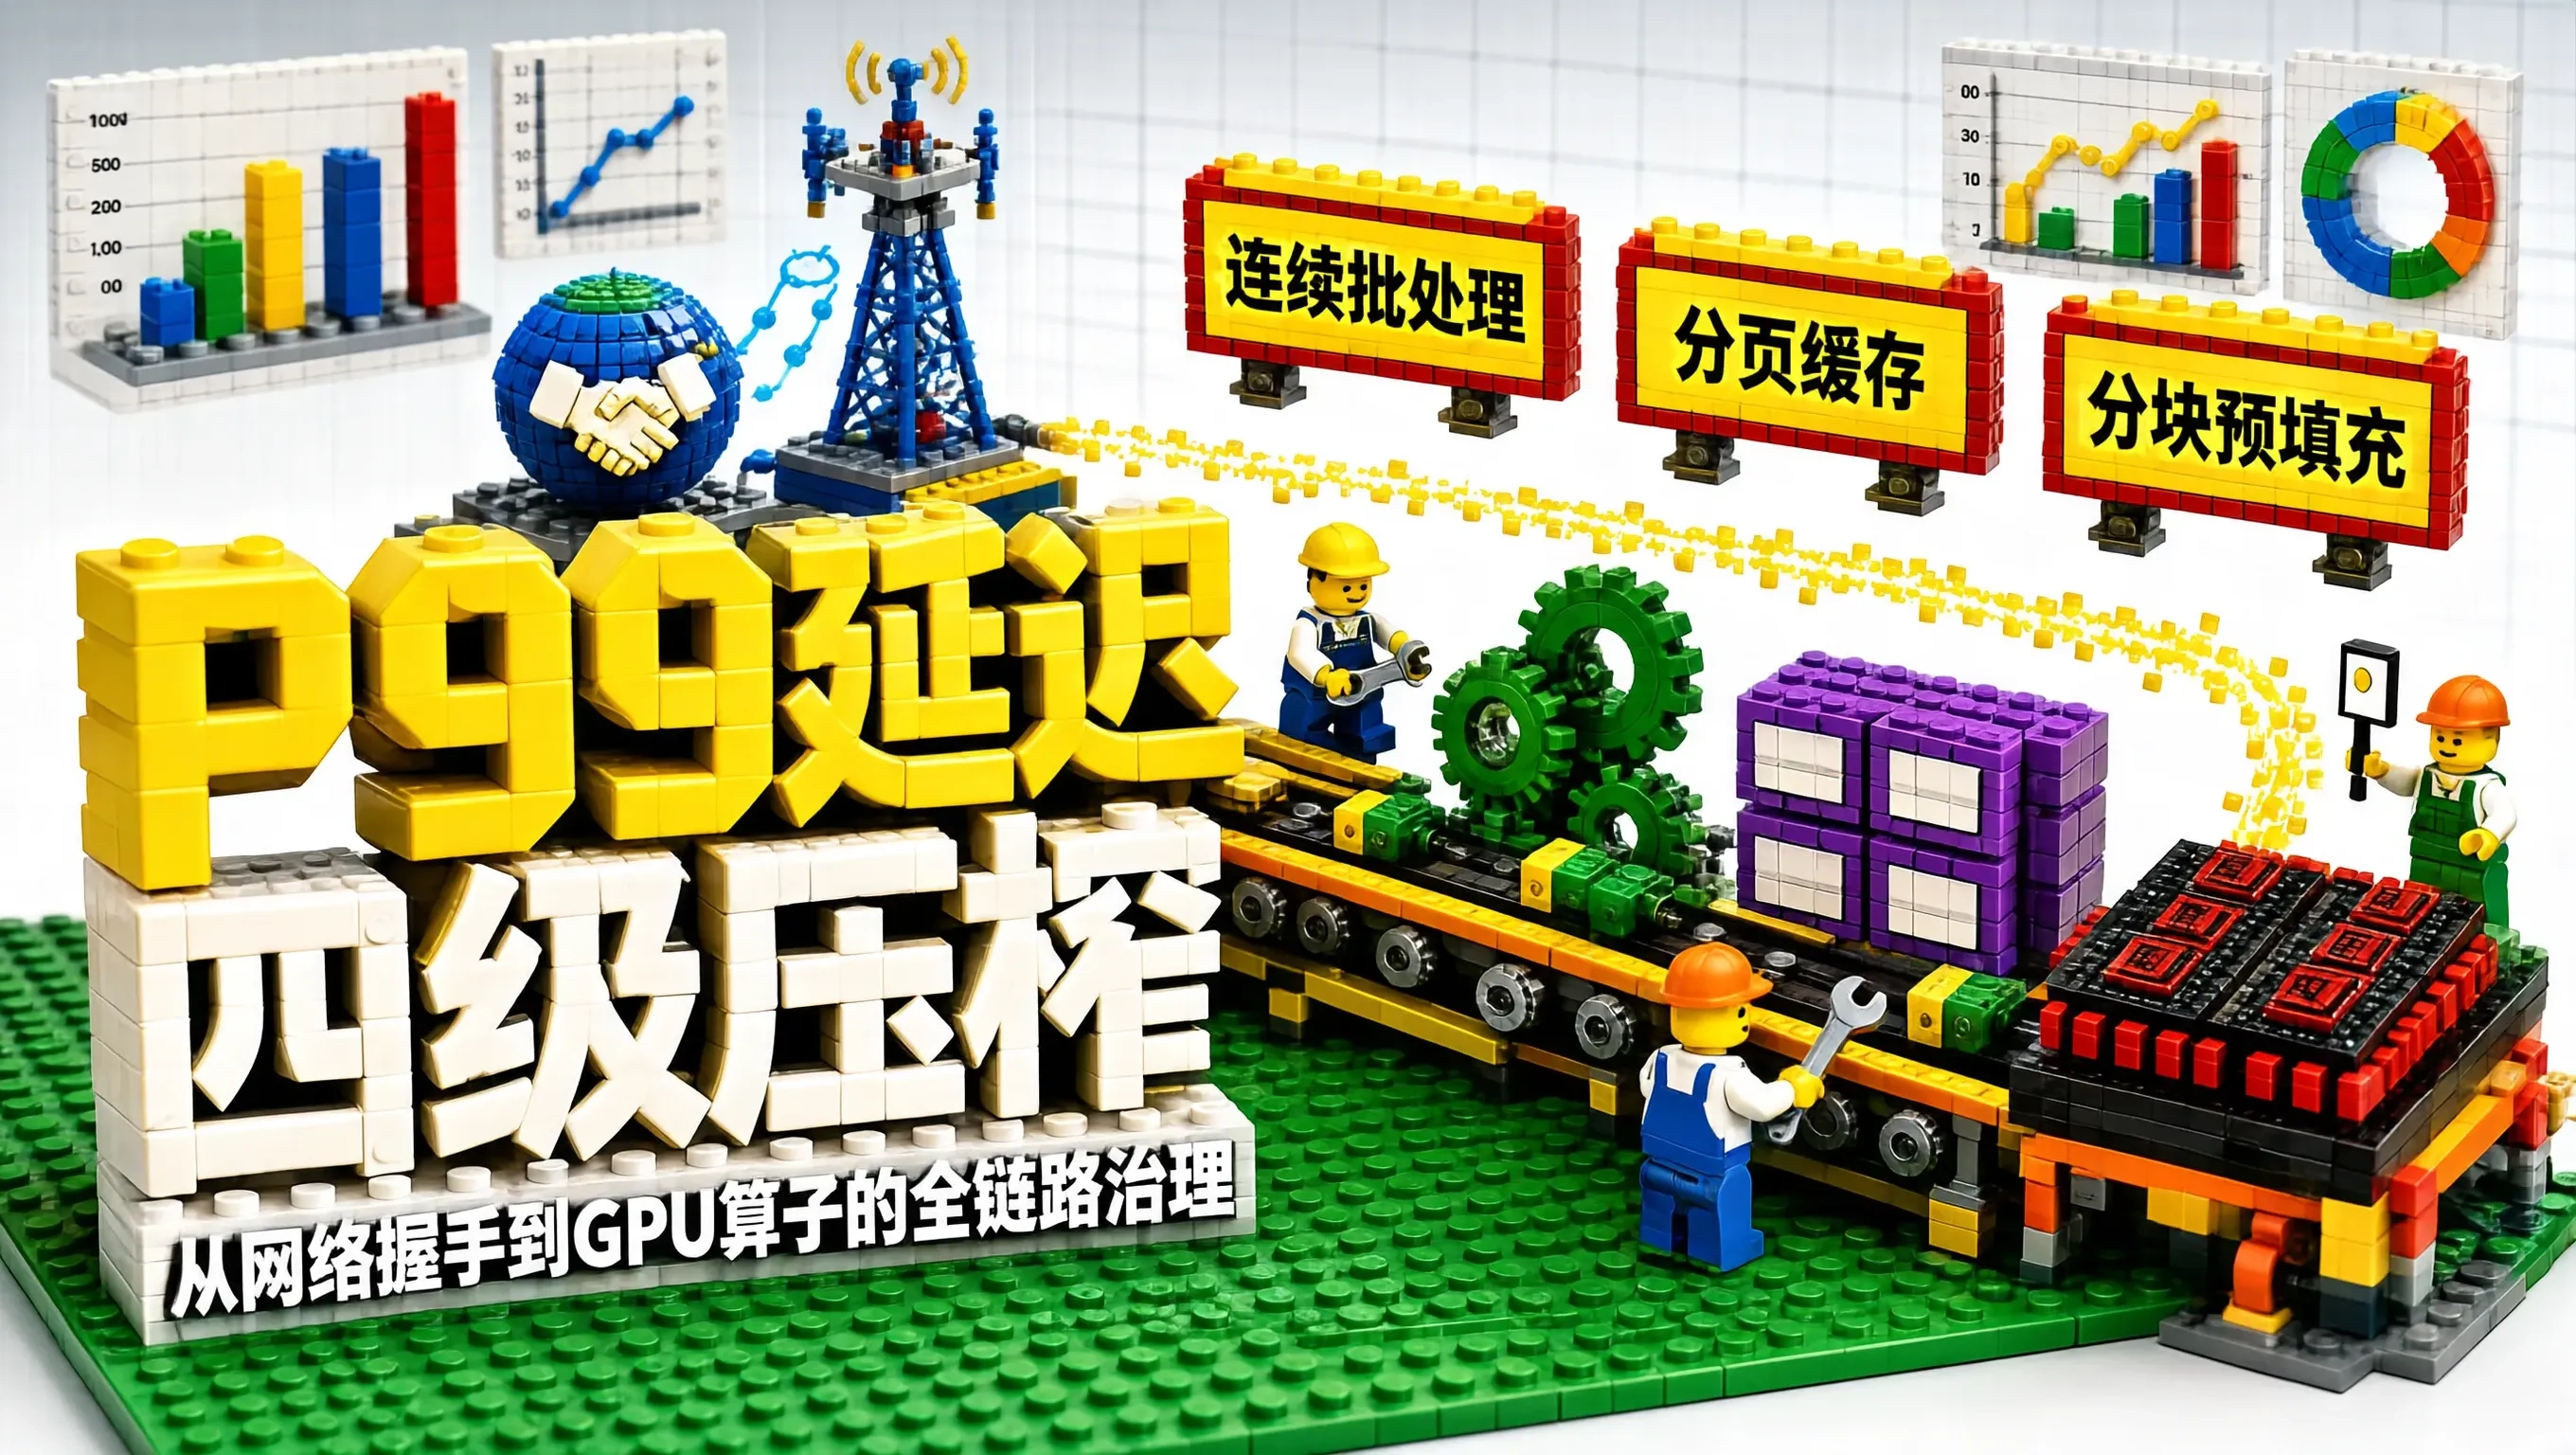
在多智能体(Multi-Agent)系统的工业化落地进程中,衡量系统工程成熟度的终极度量衡从来不是平均响应时间(Average Latency),而是决定系统稳定命门与用户临界体验的P99 尾部延迟(99th Percentile Tail Latency)。
在双 11 等大促峰值或高频金融交互场景下,一个主控 Agent 的复杂决策往往由多个串行或并行的子推理环节级联而成:$$T_{total} = \\sum_{i=1}^{M} T_{inference}(i) + \\sum_{j=1}^{K} T_{tool}(j)$$在概率统计学中,尾部延迟具有恐怖的乘法累积放大效应(Latency Amplification):即便每一次独立大模型调用的 P99 延迟只有 1.5 秒,当一个任务链条连续调用 6 次模型时,整个工作流发生严重卡顿超时的概率会飙升至 $1 – (1 – 0.01)^6 \\approx 5.85%$。在数百万级的商业请求冲击下,数万笔核心业务将不可避免地陷入长达数十秒的严重超时甚至雪崩熔断。
许多缺乏底层全栈视角的研发团队在治理延迟时,往往陷入“一叶障目”的狭隘误区:要么盲目催促算法团队换更小的量化模型,要么盲目砸钱采购昂贵的硬件显卡。然而,经过对真实生产调用链路的微秒级分布式追踪(Distributed Tracing)拆解,我们发现了一个惊人的事实:在端到端长达数秒的整体延迟中,纯粹由 GPU 核心算子执行的时间往往只占不到 40%;剩下的 60% 以上,全部被网络协议握手开销、网关调度阻塞、以及推理引擎内部不合理的批处理队列排队所白白蚕食!
要彻底打赢多 Agent 推理延迟的攻坚战,必须构筑跨越**“物理网络传输层 -> 网关协议接入层 -> 推理引擎调度层 -> GPU 算子微架构层”**的四级端到端全链路 P99 延迟压榨体系。
延迟拆解的全景解剖图与瓶颈溯源
我们将一个从 Agent 发起请求到最终收到第一个 Token(TTFT, Time to First Token)及完整流式响应的物理路径,完整切分为四个离散阶段:
阶段一:公网与传输层消耗(L4/L7 Network Handshake)
- DNS 解析与连接握手开销:如果客户端每次调用大模型 API 都重新建立 TCP 连接,在复杂的跨数据中心或公网环境下:$$\\text{DNS 查询 (20ms)} + \\text{TCP 三次握手 (1.5 RTT, 45ms)} + \\text{TLS 1.3 加密协商 (1 RTT, 30ms)} = 95\\text{ms}$$光是建立一个物理通道,在尚未发送任何有效业务数据前就凭空白白蒸发了近 100 毫秒!如果遭遇公网丢包触发 TCP 重传,握手延迟直接飙升至 1 秒以上。
阶段二:推理引擎内部的调度排队(Prefill vs. Decode Contention)
- 在 vLLM / TensorRT-LLM 等现代推理框架中,推理分为两大阶段:
- Prefill 预填充阶段:一次性并行计算输入 Prompt 的所有 Token,属于高吞吐的计算密集型(Compute-Bound);
- Decode 解码阶段:逐个自回归吐出后续 Token,受限于从显存加载权重的带宽,属于低吞吐的显存带宽密集型(Memory-Bound)。
- 如果引擎采用早期的“静态批处理(Static Batching)”,正在高速吐字的短请求必须被迫等待一个刚进入队列、包含数万 Token 的超长 Prompt 完成 Prefill 计算,导致极度惨烈的**队头阻塞(Head-of-Line Blocking)**与 P99 延迟毛刺。
四级全链路 P99 延迟压榨实战规范
针对上述解构出来的瓶颈,必须在工程全链路同时引爆四套现代化武器:
1. 网络层:TCP Keep-Alive 长连接池与 TLS 1.3 会话恢复(0-RTT)
在所有 Agent 调用客户端强制开启全局单例长连接池,将空闲保活时间延长至 120 秒以上。同时,全面启用 TLS 1.3 的 0-RTT 会话恢复(Session Resumption with Pre-Shared Key)。使得长连接在复用时握手开销绝对为 0,即便偶尔重连,首包发送延迟也缩短整整一个 RTT。
2. 调度层:连续批处理(Continuous Batching / In-flight Batching)
全面弃用静态批处理,强制升级为基于迭代级别的动态连续批处理(Continuous Batching)。在每一个 Token 的前向计算步进周期(Iteration Step)中,推理引擎能够在纳秒级动态弹出已经生成结束的会话,并无缝插播刚刚到达的新请求,彻底粉碎队头阻塞,让 GPU 的 Tensor Core 始终维持在 95% 以上的高饱和度。
3. 显存层:PagedAttention 与 KV 缓存无锁分页
大模型在推理过程中生成的 Key/Value 缓存是动态不可预知的。传统方案预先为每个并发分配最大长度(如 8K)的连续显存,导致超过 70% 的显存碎片浪费。依托 PagedAttention 技术,将显存像操作系统虚拟内存页(Virtual Memory Pages)一样切割为离散的物理块(Blocks,如每块 16 个 Token)。KV 缓存按需动态分配,显存利用率暴涨至 96%,允许单张 GPU 容纳高达 4 倍的并发序列,从根本上消除了由于显存爆满导致的请求阻塞排队。
4. 算子层:Chunked Prefill(分块预填充)与算子融合(FlashDecoding)
当面临 Agent 传入的长达 32K 的超长技术文档时,超大 Prompt 的 Prefill 计算会独占 GPU 达数百毫秒,导致其他正在生成的交互式请求严重掉帧卡顿。开启 Chunked Prefill 特性,将 32K 的大 Prompt 按照 512 或 1024 Token 切割为微型批次,与当前正在进行的 Decode 步骤混合交织计算;底层搭配 FlashDecoding 算子,在显存读取阶段实现跨注意力头的并行归并,将长上下文首字延迟(TTFT)压降 60% 以上。
生产级端到端性能压测实录
我们在包含 10,000 QPS 高频并发 Agent 规划交互的真实集群压测中,验证了全链路延迟治理的惊人成果:
| 首字时间 (TTFT P99) | 2,850 ms | 380 ms | 暴降 86.7% |
| 单 Token 解码延迟 (Decode P99) | 48.5 ms | 16.2 ms | 加速 3 倍 |
| 千字复杂推理端到端 P99 耗时 | 38.4 秒 | 11.2 秒 | 缩短 27.2 秒 |
| GPU 显存利用率有效载荷 | 32.4% (严重碎片化) | 94.8% | 显存密度提升 3 倍 |
| 集群峰值吞吐承载力 (Throughput) | 240 Requests/s | 1,150 Requests/s | 吞吐爆发 4.8 倍 |
生产治理的两项监控红线
端到端 P99 延迟治理是一门跨越硬件微架构与软件协议栈的综合物理学。唯有深入网络报文与张量显存的微观世界,实施深度的全链路协同治理,多智能体生产集群才能在大促的狂暴流量面前,保持如同外科手术般精湛、稳定且极速的工业级水准。