摘要:第一季留下了一个明确的空白——第 33 篇说"第一季最大的空白是评估",而评估的前提是测试。Agent 测试的根本困难是:LLM 有随机性,传统断言(assert result == expected)直接失效。同一个 Prompt 跑两次,输出可能不同;你既不能断言精确字符串,也不能简单地"跑通就算过"。本文讲清三件事:Mock LLM 的四种策略(stub / fake / 录制回放 / 真实调用,各自的适用边界与陷阱)、断言的五种替代方案(结构断言、属性断言、语义相似度、LLM-as-judge、快照回归,以及为什么"精确匹配"在 Agent 场景几乎无用)、三层测试的分工(工具层 100% 确定性覆盖、编排层用 fake 跑通、质量层靠评估而非测试)。并给出 flaky 测试的根因分类与处理原则——这是 Agent 测试的头号敌人,而"失败就重跑"是最糟糕的应对方式。
📌 版本声明:本文基于 Python 3.11+、pytest 8.x、pytest-asyncio 编写,撰写时间 2026 年 10 月。核心断言工具零第三方依赖;语义相似度部分需要 embedding 服务(可替换为任意向量接口)。第 34 篇的录制回放(recorded_llm_call)在本文中作为四种 Mock 策略之一被复用。各测试插件的行为与配置项请以官方文档为准。
适用边界:适用于已有 Agent 实现、需要建立测试体系的工程。若你还在原型阶段、每周都在改 Prompt,那么过早投资测试是浪费——Prompt 天天变,测试天天红。建议的介入时机是"Agent 的核心流程稳定、准备接入真实用户"时。
文章目录
-
- 一、为什么 Agent 测试不一样:断言失效
-
- 1.1 传统断言为什么在这里失效
- 1.2 三个常见的错误应对
- 1.3 正确的思路:把"验证输出"换成"验证性质"
- 1.4 第一季各篇的核心测试点
- 二、Mock LLM 的四种策略
-
- 2.1 四种策略对比
- 2.2 策略选择的判据
- 2.3 实现:Fake LLM
- 2.4 用 Fake 测重试与上下文裁剪
- 2.5 Mock 的注入层次
- 2.6 工具调用的测试:重点是参数,不是返回值
- 三、断言的五种替代方案
-
- 3.1 五种断言法
- 3.2 结构断言:最基础的一层
- 3.3 属性断言:抓真正的错误
- 3.4 语义相似度与 LLM-as-judge
- 3.5 快照回归
- 3.6 怎么选
- 3.7 多轮对话的测试:状态累积比单轮更难
- 3.8 断言强度自检:三个问题
- 四、三层测试的分工
-
- 4.1 Agent 版的测试金字塔
- 4.2 工具层:必须 100% 确定性
- 4.3 编排层:用 Fake 跑通全流程
- 4.4 质量层:这不是测试,是评估
- 4.5 三层测试的判据汇总
- 4.6 Golden Set:质量层的地基
- 五、Flaky 测试:Agent 测试的头号敌人
-
- 5.1 四类根因
- 5.2 为什么"失败就重跑"是最糟的应对
- 5.3 正确的处理流程
- 5.4 什么时候可以接受重跑
- 5.5 CI 分层执行:让测试套件跑得完
- 六、适用边界与风险提示 ⚠️
-
- 6.1 覆盖率在 Agent 项目里的正确用法
- 七、一个可复制的测试骨架
- 八、总结
-
- 落地自检清单(Checklist)
- 常见问题(FAQ)
- 参考资料
一、为什么 Agent 测试不一样:断言失效
1.1 传统断言为什么在这里失效
一个普通服务的测试长这样:
def test_calculate_discount():
assert calculate_discount(100, vip=True) == 80
确定性输入 → 确定性输出 → 精确断言。这个链条在 Agent 上断了:
def test_review_contract():
result = await review_contract(contract_text)
assert result == ??? # ← 填什么?
你没法填。 因为:
| LLM 随机性 | 即使 temperature=0,输出也可能因批处理、浮点非确定性而不同 |
| 表述多样性 | 同一个意思有一百种说法,都是"正确"的 |
| 模型会更新 | 供应商可能悄悄更新模型,输出风格变化 |
| 正确性是程度问题 | "这个审查报告好不好"是连续值,不是布尔值 |
1.2 三个常见的错误应对
面对断言失效,团队通常会依次尝试以下三种做法,三种都有问题:
错误一:断言"跑通就算过"
def test_agent_runs():
result = await agent.run("审查这份合同")
assert result is not None # ← 几乎没测任何东西
这只能验证"没有抛异常"。一个返回空字符串的 Agent 也能通过。 这是最常见的"假测试"。
错误二:断言精确字符串
assert result == "该合同存在三条高风险条款:…" # ← 改天就红
第一次会通过,然后模型更新、或气温微调、或 Prompt 改了个标点,测试就红了。这类测试会在两周内被全量删除或加上 # type: ignore 式的绕过。
错误三:失败就重跑
pytest –reruns 3 # ← 掩盖问题
这是最有害的一种。它把"Agent 行为不稳定"这个真实问题,包装成了"测试偶发失败"这个看起来无害的现象。 第 5 章会专门讲为什么这种做法危险。
1.3 正确的思路:把"验证输出"换成"验证性质"
核心转变是:
传统测试:验证**输出等于什么**(value assertion)
Agent 测试:验证**输出具有什么性质**(property assertion)
举例,同样是测试合同审查:
| 断言报告文本 == 某字符串 | 断言报告是合法 JSON 且符合 schema |
| 断言找出 3 条风险 | 断言每条风险都引用了原文(不凭空编造) |
| 断言风险等级 == high | 断言等级枚举值合法 且 高风险条款确实包含"无限责任"字样 |
| 断言整体正确 | 断言与上一次运行相比没有明显退化(回归) |
第三条是关键:你无法断言"结论对",但可以断言"结论有依据"。这类性质叫不变量(invariant)——不管模型怎么答,这些性质都必须成立。
def test_every_risk_cites_source(result):
"""不变量:每条风险必须引用原文——防止模型编造。
这条断言**不管模型给出几条风险、风险等级是什么**都成立,
因此它是稳定的、有意义的、且能抓住真正的错误(幻觉)。
"""
for risk in result["risks"]:
assert risk["quote"] in result["source_text"], \\
f"风险引用了原文中不存在的内容:{risk['quote'][:30]}"
💡 这条断言抓的是 Agent 最危险的失效模式——幻觉。 它比"断言输出等于某个字符串"有用得多,因为它不会因为模型换个说法就失败,却能在模型编造内容时立刻报错。找不变量,是写 Agent 测试最重要的技能。
1.4 第一季各篇的核心测试点
第一季每一篇都写过测试代码,但它们是分散的。这里收拢成一张表——这张表就是你建立测试套件时的需求清单:
| 22 Pipeline | 阶段顺序、中间态正确传递 | 流程不跳步 |
| 23 MapReduce | 部分失败时成功结果被保留 | 失败是数据不是异常 |
| 24 Supervisor | 停滞检测触发、终止不依赖 LLM | 循环必然终止 |
| 25 黑板 | 冲突可见、陈旧写被拒绝 | 并发正确性 |
| 26 编排引擎 | 单边遍历上限、编译期校验非法图 | 循环可控 |
| 27 通信协议 | 因果排序而非时间戳、并发同键只执行一次 | 幂等与顺序 |
| 28 中间件 | 执行顺序、fail_fast 按中间件生效 | 顺序可预测 |
| 29 事件驱动 | 幂等 acquire 原子占位、位点提交时机 | 不重复不遗漏 |
| 30 状态管理 | 非法转移被拒、深拷贝、恢复后跳过已完成 | 状态正确与恢复省成本 |
| 31 网关 | 三维度限流、熔断三态、降级永不失败 | 治理有效性 |
| 32 Serverless | handler 是纯函数、步骤幂等、批次大小约束 | 可测性与超时预算 |
观察这张表会发现一个规律:第一季所有值得测的东西,没有一条是"断言模型输出了什么",全部是"断言系统具有什么性质"。
这不是巧合——它恰恰说明 Agent 测试的重心应该放在哪:模型输出不可控,但系统对输出的处理方式是可控的,后者才是测试的领地。
💡 这张表还有个实用价值:它是"测试覆盖自检表"。 如果你的系统用到了某个模式,就去看对应那一行——那条测试有没有写。比如用了事件驱动却没测"并发同键只执行一次",那么幂等在最容易失效的地方是裸奔的。
二、Mock LLM 的四种策略
2.1 四种策略对比
| ① Stub(固定响应) | 直接返回一个写死的字符串 | 低 | 零 | ✅ | 只关心"拿到响应后代码怎么走" |
| ② Fake(规则生成) | 按输入规则生成响应 | 中 | 零 | ✅ | 需要根据输入产生不同响应 |
| ③ 录制回放 | 重放真实调用记录 | 高 | 零 | ✅ | 回归测试(第 34 篇) |
| ④ 真实调用 | 真的调 LLM | 最高 | 钱 + 时间 | ❌ | 评估、冒烟、录制阶段 |
四者是互补关系,不是四选一。 一个健康的测试套件里四种都会出现。
2.2 策略选择的判据
| 重试逻辑、超时处理、错误分支 | ① Stub 或 ② Fake(要能精确控制响应) |
| 状态转移、编排流程 | ② Fake(需要不同输入产生不同输出) |
| “改了代码后行为有没有变” | ③ 录制回放 |
| “模型的实际质量如何” | ④ 真实调用(但这属于评估,不是测试——见第 6 章) |
第四条值得强调:真实调用在测试里的定位是评估和录制,不是日常回归。日常回归用真实调用会导致:测试慢(几十秒)、要花钱、结果不稳定。
2.3 实现:Fake LLM
Fake 是四种策略里最需要设计的——Stub 太简单,录制回放第 34 篇已实现,真实调用不需要设计。
"""Fake LLM:按规则生成响应,可精确控制行为。
设计要点:
1. **可注入场景**(正常/超时/限流/畸形),用于测试错误分支。
2. **响应与输入相关**,否则无法测试"不同输入走不同分支"。
3. **记录所有调用**,便于断言"调用了几次、传了什么"。
"""
from __future__ import annotations
import asyncio
import json
from dataclasses import dataclass, field
from typing import Any, Awaitable, Callable
@dataclass
class CallRecord:
"""一次调用记录。"""
model: str
messages: list[dict]
params: dict[str, Any]
class FakeLLM:
"""规则驱动的假 LLM。**零成本、完全确定、可注入异常。**"""
def __init__(self) –> None:
self.calls: list[CallRecord] = field(default_factory=list) if False else []
self._handlers: list[Callable[[str], str | None]] = []
self._scenario: str = "normal" # normal / timeout / ratelimit / malformed
# ———- 场景注入 ———-
def set_scenario(self, scenario: str) –> None:
"""切换行为场景。**测试错误分支的关键。**"""
assert scenario in {"normal", "timeout", "ratelimit", "malformed"}
self._scenario = scenario
# ———- 响应规则 ———-
def on(self, predicate: Callable[[str], bool],
responder: Callable[[str], str]) –> None:
"""注册一条规则:输入满足条件时,用 responder 生成响应。
**后注册的优先级更高**(便于测试里覆盖默认规则)。
"""
self._handlers.insert(0, (predicate, responder))
# ———- 调用入口 ———-
async def chat(self, model: str, messages: list[dict],
**params) –> str:
"""模拟一次 LLM 调用。**签名与真实客户端保持一致。**"""
record = CallRecord(model=model, messages=messages, params=params)
self.calls.append(record)
if self._scenario == "timeout":
await asyncio.sleep(params.get("mock_timeout_s", 999))
if self._scenario == "ratelimit":
raise RuntimeError("429 rate limited")
if self._scenario == "malformed":
return "{ 这不是合法 JSON"
prompt = messages[–1]["content"] if messages else ""
for predicate, responder in self._handlers:
if predicate(prompt):
return responder(prompt)
return f"[fake:{model}] 默认响应(输入 {len(prompt)} 字)"
# ———- 断言辅助 ———-
def call_count(self) –> int:
return len(self.calls)
def last_prompt(self) –> str:
return self.calls[–1].messages[–1]["content"] if self.calls else ""
def prompts_containing(self, keyword: str) –> list[str]:
"""断言"某段信息有没有被放进上下文"——第 24 篇上下文裁剪的核心检查。"""
return [c.messages[–1]["content"] for c in self.calls
if keyword in c.messages[–1]["content"]]
三个设计要点:
① self.calls 记录所有调用。 这让你可以断言"调用了几次"和"上下文里有什么"。前者用于测试重试与缓存,后者用于测试第 24 篇的上下文裁剪——比如断言"给网络专家的上下文里没有数据库指标"。
② 场景注入是测试错误分支的唯一实用方式。 录制回放无法模拟超时(录的是结果不是过程),而 set_scenario("timeout") 可以。
③ on() 的规则注册顺序是"后注册优先"。 这样测试里可以先注册一个宽泛的默认规则,再针对具体用例覆盖它。
2.4 用 Fake 测重试与上下文裁剪
两个真实场景的测试示例:
import pytest
from fake_llm import FakeLLM
@pytest.mark.asyncio
async def test_retry_stops_after_max_attempts():
"""重试:限流后重试至上限,然后放弃(不无限重试)。"""
llm = FakeLLM()
llm.set_scenario("ratelimit")
with pytest.raises(RuntimeError):
await call_with_retry(llm, max_retries=3)
# **关键断言:重试次数正好是 1 + 3,不是无限**
assert llm.call_count() == 4
@pytest.mark.asyncio
async def test_expert_context_excludes_irrelevant_metrics():
"""上下文裁剪:给网络专家的参数里不能出现数据库指标(第 24 篇)。"""
llm = FakeLLM()
llm.on(lambda p: "链路" in p, lambda p: '{"layer_ok": true, "findings": []}')
await network_expert.diagnose(
llm,
context={"network_metrics": {"latency_ms": 800},
"db_metrics": {"slow_queries": 42}}, # ← 不该出现在网络专家的输入里
)
prompt = llm.last_prompt()
assert "latency_ms" in prompt # 相关信息在
assert "slow_queries" not in prompt # **无关信息被裁掉了**
第二个测试守的是第 24 篇最核心的一个洞察:把无关上下文喂给专家,它会开始怀疑错误的方向——“给网络专家看数据库指标,它就会开始怀疑数据库”。这个错误不会报错,只会让结论跑偏,因此必须用测试锁住。
2.5 Mock 的注入层次
Mock 可以注入在三个层次,选哪层很重要:
| 函数层 | 替换你自己封装的 call_llm() | 你的业务逻辑 | 真实 SDK 的行为(重试、超时、参数校验) |
| SDK 层 | 替换 SDK 的 client 方法 | 你的逻辑 + 部分 SDK 行为 | HTTP 层的细节 |
| HTTP 层 | 指向 Mock 服务(第 34 篇 5.6 节) | 全部,含 SDK 的真实行为 | 无 |
拍板建议:日常用函数层(快、简单、稳定),但需要专门补一组 HTTP 层的测试来验证"真实 SDK + 真实错误码"的组合。因为超时和 429 的处理逻辑往往在 SDK 内部,你在函数层 Mock 掉 SDK,就把这部分行为也一起 Mock 掉了——测了个寂寞。
下面这条时序图展示了两个层次的差异:
上游 API
真实 SDK
Mock 层
Agent 逻辑
测试
上游 API
真实 SDK
Mock 层
Agent 逻辑
测试
#mermaid-svg-W1v2Oj4iFSr2QiD0{font-family:\”trebuchet ms\”,verdana,arial,sans-serif;font-size:16px;fill:#333;}@keyframes edge-animation-frame{from{stroke-dashoffset:0;}}@keyframes dash{to{stroke-dashoffset:0;}}#mermaid-svg-W1v2Oj4iFSr2QiD0 .edge-animation-slow{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 50s linear infinite;stroke-linecap:round;}#mermaid-svg-W1v2Oj4iFSr2QiD0 .edge-animation-fast{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 20s linear infinite;stroke-linecap:round;}#mermaid-svg-W1v2Oj4iFSr2QiD0 .error-icon{fill:#552222;}#mermaid-svg-W1v2Oj4iFSr2QiD0 .error-text{fill:#552222;stroke:#552222;}#mermaid-svg-W1v2Oj4iFSr2QiD0 .edge-thickness-normal{stroke-width:1px;}#mermaid-svg-W1v2Oj4iFSr2QiD0 .edge-thickness-thick{stroke-width:3.5px;}#mermaid-svg-W1v2Oj4iFSr2QiD0 .edge-pattern-solid{stroke-dasharray:0;}#mermaid-svg-W1v2Oj4iFSr2QiD0 .edge-thickness-invisible{stroke-width:0;fill:none;}#mermaid-svg-W1v2Oj4iFSr2QiD0 .edge-pattern-dashed{stroke-dasharray:3;}#mermaid-svg-W1v2Oj4iFSr2QiD0 .edge-pattern-dotted{stroke-dasharray:2;}#mermaid-svg-W1v2Oj4iFSr2QiD0 .marker{fill:#333333;stroke:#333333;}#mermaid-svg-W1v2Oj4iFSr2QiD0 .marker.cross{stroke:#333333;}#mermaid-svg-W1v2Oj4iFSr2QiD0 svg{font-family:\”trebuchet ms\”,verdana,arial,sans-serif;font-size:16px;}#mermaid-svg-W1v2Oj4iFSr2QiD0 p{margin:0;}#mermaid-svg-W1v2Oj4iFSr2QiD0 .actor{stroke:hsl(259.6261682243, 59.7765363128%, 87.9019607843%);fill:#ECECFF;}#mermaid-svg-W1v2Oj4iFSr2QiD0 text.actor>tspan{fill:black;stroke:none;}#mermaid-svg-W1v2Oj4iFSr2QiD0 .actor-line{stroke:hsl(259.6261682243, 59.7765363128%, 87.9019607843%);}#mermaid-svg-W1v2Oj4iFSr2QiD0 .innerArc{stroke-width:1.5;stroke-dasharray:none;}#mermaid-svg-W1v2Oj4iFSr2QiD0 .messageLine0{stroke-width:1.5;stroke-dasharray:none;stroke:#333;}#mermaid-svg-W1v2Oj4iFSr2QiD0 .messageLine1{stroke-width:1.5;stroke-dasharray:2,2;stroke:#333;}#mermaid-svg-W1v2Oj4iFSr2QiD0 #arrowhead path{fill:#333;stroke:#333;}#mermaid-svg-W1v2Oj4iFSr2QiD0 .sequenceNumber{fill:white;}#mermaid-svg-W1v2Oj4iFSr2QiD0 #sequencenumber{fill:#333;}#mermaid-svg-W1v2Oj4iFSr2QiD0 #crosshead path{fill:#333;stroke:#333;}#mermaid-svg-W1v2Oj4iFSr2QiD0 .messageText{fill:#333;stroke:none;}#mermaid-svg-W1v2Oj4iFSr2QiD0 .labelBox{stroke:hsl(259.6261682243, 59.7765363128%, 87.9019607843%);fill:#ECECFF;}#mermaid-svg-W1v2Oj4iFSr2QiD0 .labelText,#mermaid-svg-W1v2Oj4iFSr2QiD0 .labelText>tspan{fill:black;stroke:none;}#mermaid-svg-W1v2Oj4iFSr2QiD0 .loopText,#mermaid-svg-W1v2Oj4iFSr2QiD0 .loopText>tspan{fill:black;stroke:none;}#mermaid-svg-W1v2Oj4iFSr2QiD0 .loopLine{stroke-width:2px;stroke-dasharray:2,2;stroke:hsl(259.6261682243, 59.7765363128%, 87.9019607843%);fill:hsl(259.6261682243, 59.7765363128%, 87.9019607843%);}#mermaid-svg-W1v2Oj4iFSr2QiD0 .note{stroke:#aaaa33;fill:#fff5ad;}#mermaid-svg-W1v2Oj4iFSr2QiD0 .noteText,#mermaid-svg-W1v2Oj4iFSr2QiD0 .noteText>tspan{fill:black;stroke:none;}#mermaid-svg-W1v2Oj4iFSr2QiD0 .activation0{fill:#f4f4f4;stroke:#666;}#mermaid-svg-W1v2Oj4iFSr2QiD0 .activation1{fill:#f4f4f4;stroke:#666;}#mermaid-svg-W1v2Oj4iFSr2QiD0 .activation2{fill:#f4f4f4;stroke:#666;}#mermaid-svg-W1v2Oj4iFSr2QiD0 .actorPopupMenu{position:absolute;}#mermaid-svg-W1v2Oj4iFSr2QiD0 .actorPopupMenuPanel{position:absolute;fill:#ECECFF;box-shadow:0px 8px 16px 0px rgba(0,0,0,0.2);filter:drop-shadow(3px 5px 2px rgb(0 0 0 / 0.4));}#mermaid-svg-W1v2Oj4iFSr2QiD0 .actor-man line{stroke:hsl(259.6261682243, 59.7765363128%, 87.9019607843%);fill:#ECECFF;}#mermaid-svg-W1v2Oj4iFSr2QiD0 .actor-man circle,#mermaid-svg-W1v2Oj4iFSr2QiD0 line{stroke:hsl(259.6261682243, 59.7765363128%, 87.9019607843%);fill:#ECECFF;stroke-width:2px;}#mermaid-svg-W1v2Oj4iFSr2QiD0 :root{–mermaid-font-family:\”trebuchet ms\”,verdana,arial,sans-serif;}
函数层 Mock:跳过 SDK
SDK 的重试与超时逻辑未被执行
HTTP 层 Mock:保留 SDK
SDK 的真实重试逻辑被执行
调用业务流程
call_llm() 被替换为 Fake
返回规则生成的响应
调用业务流程
真实 SDK 调用
发往 Mock 服务
返回 429
抛出 SDK 定义的异常
应用层错误处理
2.6 工具调用的测试:重点是参数,不是返回值
工具调用是 Agent 特有的一个测试难点,它有两类失效,且第二类是主要的:
| 选错工具 | 该查数据库的却去查了网络 | 容易(断言工具名即可) |
| 参数生成错误 | 工具选对了,但参数填错或编造 | 难(返回值可能依然"成功") |
为什么第二类更危险:假设 Agent 要调用 query_order(order_id="ORD-123"),但它编造了一个 order_id="ORD-999"。工具会正常执行并返回空结果——没有报错、没有异常、测试也可能通过,只是答案是错的。
所以工具调用的测试重点不是"返回值对不对"(那是工具层的事),而是**“传进去的参数对不对”**:
@dataclass
class ToolCall:
"""工具调用记录。**用于断言 Agent 选了什么工具、传了什么参数。**"""
name: str
args: dict
class RecordingToolRegistry:
"""记录工具调用,不真正执行。**用于测试 Agent 的决策而非工具本身。**"""
def __init__(self) –> None:
self.calls: list[ToolCall] = []
def register(self, name: str, fn=None, *, result=None):
def _wrap(**kwargs):
self.calls.append(ToolCall(name=name, args=kwargs))
return result if result is not None else f"[mock:{name}]"
return _wrap
@pytest.mark.asyncio
async def test_agent_passes_real_order_id_not_invented():
"""参数必须来自上下文,不能凭空编造。"""
tools = RecordingToolRegistry()
agent = build_agent(tools={"query_order": tools.register("query_order", result={"status": "ok"})})
await agent.run("ORD-123 这个订单现在什么状态?")
assert tools.calls[0].name == "query_order"
# **关键断言:参数值必须出现在用户的问题里**
assert tools.calls[0].args["order_id"] == "ORD-123"
"参数值必须出现在用户问题里"这条断言可以泛化成一个通用检查:
def assert_args_grounded(call: ToolCall, context: str) –> None:
"""参数值必须能在上下文里找到出处——防编造。
适用范围:ID、日期、金额、名称这类"事实型"参数。
**不适用于**:模型自己生成的自由文本(比如摘要内容)。
"""
FACTUAL_KEYS = {"id", "order_id", "user_id", "date", "amount", "name"}
for key, value in call.args.items():
if key in FACTUAL_KEYS or key.endswith("_id"):
assert str(value) in context, \\
f"参数 {key}={value!r} 在上下文中找不到出处,可能是编造的"
⚠️ 这条检查有个重要前提:它只适用于"事实型"参数。 如果参数值是模型生成的自由文本(比如"给客户回复的草稿内容"),那它本来就不该在上下文里。误用这条规则会产生大量假失败——判断标准是"这个值是用户提供的,还是模型产生的"。
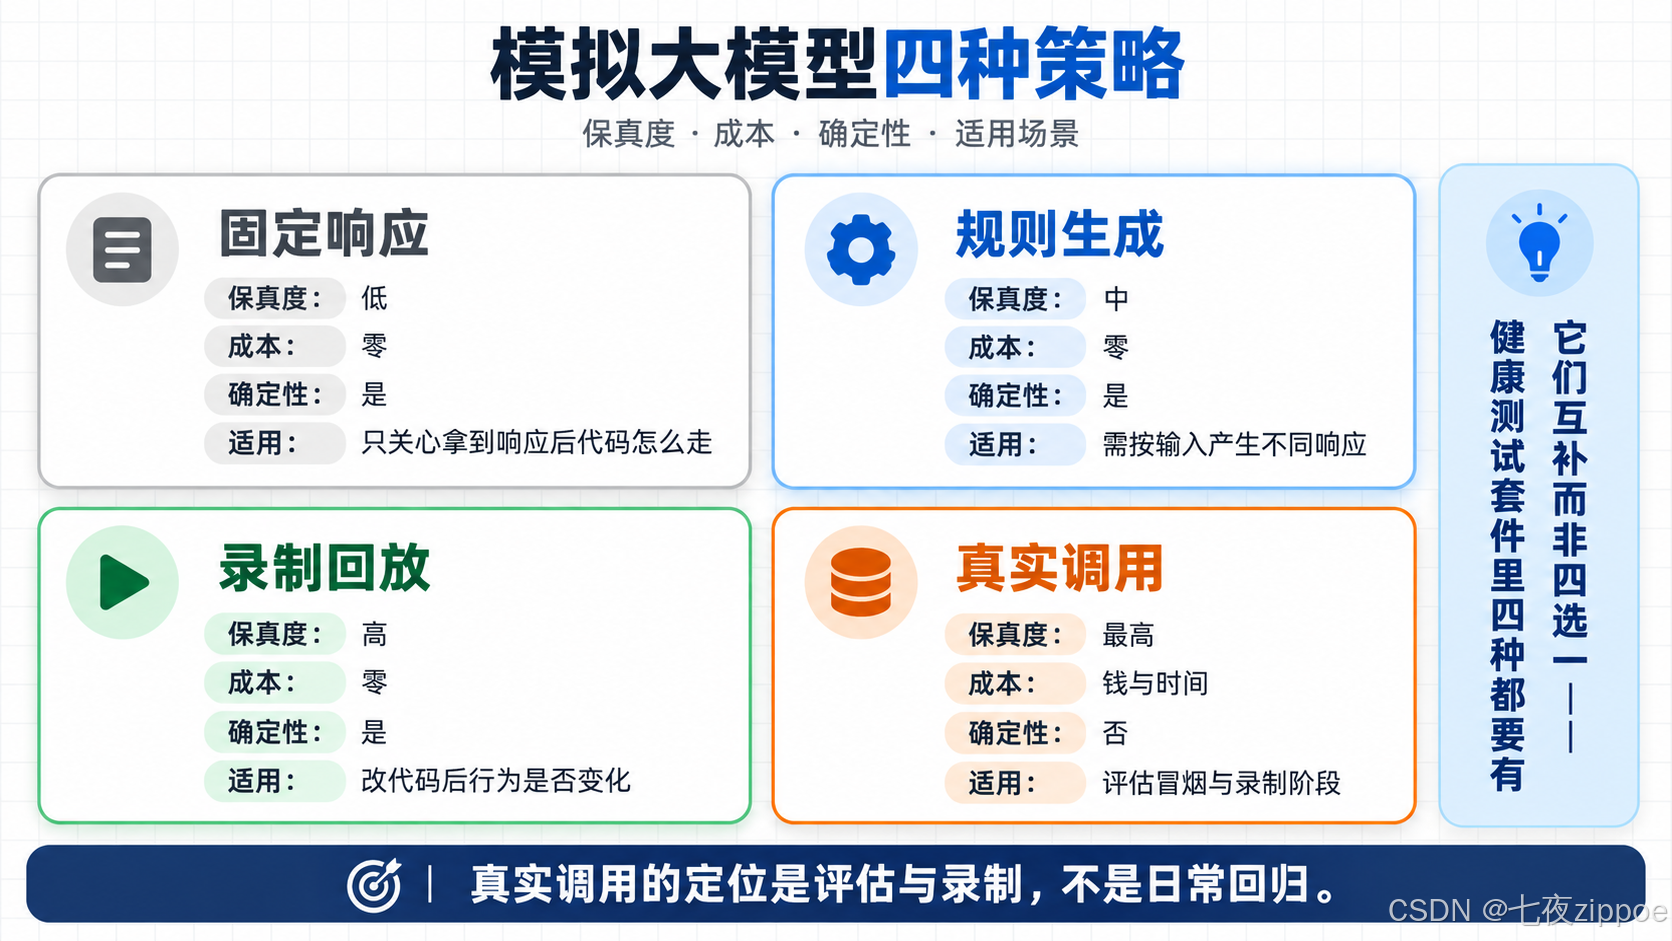
图1:Mock LLM 四种策略——Stub、Fake、录制回放、真实调用的保真度与适用边界
三、断言的五种替代方案
3.1 五种断言法
既然不能精确匹配,用什么替代?五种方法,按强度和成本排序:
| 1 | 结构断言 | 断言输出符合 JSON Schema / 字段齐全 | 低但稳 | 零 | ✅✅ |
| 2 | 属性断言(不变量) | 断言某些性质必然成立 | 中高 | 零 | ✅✅ |
| 3 | 语义相似度 | embedding 余弦相似度 > 阈值 | 中 | 低 | ✅ |
| 4 | LLM-as-judge | 用另一个模型判断是否符合要求 | 高 | 中 | ⚠️ |
| 5 | 快照回归 | 与上次运行对比,人工确认差异 | 中 | 低 | ✅ |
3.2 结构断言:最基础的一层
import jsonschema
RISK_REPORT_SCHEMA = {
"type": "object",
"required": ["risks", "summary"],
"properties": {
"risks": {
"type": "array",
"items": {
"type": "object",
"required": ["clause_index", "level", "reason", "quote"],
"properties": {
"level": {"enum": ["low", "medium", "high"]},
"clause_index": {"type": "integer", "minimum": 0},
},
},
},
"summary": {"type": "string", "minLength": 10},
},
}
def test_report_matches_schema(result):
"""结构断言:**不管内容对不对,格式必须先对。**
这一层能抓住大量实际错误:模型返回了散文而不是 JSON、
枚举值拼错、缺字段。**它是最便宜且最不该省的一层。**
"""
jsonschema.validate(result, RISK_REPORT_SCHEMA)
💡 结构断言的价值被严重低估。 它看起来只是"验格式",但实际能抓住 Agent 最常见的失效之一——模型没按要求的格式输出。而格式错误会导致下游解析失败,这是生产事故的常见起点。每个有结构化输出的 Agent 都应该有 schema 断言。
3.3 属性断言:抓真正的错误
1.3 节已经给了"每条风险必须引用原文"的例子。再给三个实用的不变量:
def test_no_invented_clause_numbers(result, source):
"""不变量:引用的条款编号必须在原文范围内——防幻觉。"""
max_index = count_clauses(source)
for risk in result["risks"]:
assert 0 <= risk["clause_index"] < max_index
def test_high_risk_requires_evidence(result):
"""不变量:高风险必须有具体依据,不能只说"有风险"。"""
for risk in result["risks"]:
if risk["level"] == "high":
assert len(risk["reason"]) >= 20, "高风险需要给出具体理由"
def test_summary_consistent_with_risks(result):
"""不变量:摘要里的数量与实际风险条数一致——防前后矛盾。"""
import re
mentioned = re.findall(r"(\\d+)\\s*条风险", result["summary"])
if mentioned:
assert int(mentioned[0]) == len(result["risks"])
第三条能抓住一类很真实的错误:模型在摘要里说"共 5 条风险",但 risks 数组里只有 3 条。这种前后不一致在 LLM 输出里非常常见,而它会被用户直接看到。
3.4 语义相似度与 LLM-as-judge
当前两种方法不够时(比如要验证"摘要是否涵盖了关键点"),用相似度或裁判:
import math
def cosine(a: list[float], b: list[float]) –> float:
dot = sum(x * y for x, y in zip(a, b))
na = math.sqrt(sum(x * x for x in a))
nb = math.sqrt(sum(y * y for y in b))
return dot / (na * nb) if na and nb else 0.0
async def assert_semantically_close(embed, actual: str, expected: str,
threshold: float = 0.82) –> None:
"""语义相似度断言。**阈值必须自己校准,不要照抄 0.82。**"""
sim = cosine(await embed(actual), await embed(expected))
assert sim >= threshold, f"语义相似度 {sim:.3f} 低于阈值 {threshold}"
JUDGE_PROMPT = """判断下面的回答是否满足要求。只回答 PASS 或 FAIL,并给出一句话理由。
要求:{requirement}
回答:{answer}
格式:PASS|FAIL —— 理由
"""
async def assert_judge(llm, requirement: str, answer: str) –> None:
"""LLM-as-judge。**用于无法用规则表达的质量判断。**"""
verdict = await llm.chat("judge", [
{"role": "user", "content": JUDGE_PROMPT.format(
requirement=requirement, answer=answer)}
], temperature=0)
assert verdict.strip().startswith("PASS"), f"裁判判定不通过:{verdict}"
使用 LLM-as-judge 的三条纪律:
| 裁判模型要与被测模型不同 | 同一个模型评判自己,会系统性偏向自己的风格 |
| temperature 必须为 0 | 裁判本身不能随机,否则测试会 flaky |
| 裁判 Prompt 要定期验证 | 裁判也会不准——用一批人工标注的样本定期校验裁判的准确率 |
⚠️ 第三条最重要也最容易漏。 LLM-as-judge 看起来很美好,但裁判本身的准确率通常在 70%~90% 之间——这意味着它会误判。如果从不验证裁判,你会得到一个"看起来在测质量、实际在随机报错"的测试。建议每季度用 50~100 条人工标注样本校准一次裁判。
3.5 快照回归
def test_prompt_snapshot(regenerate: bool = False):
"""提示词快照:Prompt 变更必须被显式确认。
**这不是"正确性"测试,是"变更感知"测试**——
它保证没有人误改 Prompt,但不判断改得好不好。
"""
from my_agent.domain.contract_review.prompts import REVIEW_SYSTEM_V1
current = REVIEW_SYSTEM_V1
path = Path("tests/snapshots/review_system.txt")
if regenerate or not path.exists():
path.write_text(current, encoding="utf-8")
return
assert current == path.read_text(encoding="utf-8"), (
"提示词已变更。如果是有意修改,请重新生成快照并确认质量未退化。"
)
💡 快照测试在 Agent 项目里比在普通项目里更有价值。 因为 Prompt 是"代码之外的行为定义",它的变更不会引起任何类型错误或测试失败,却会显著改变 Agent 行为。快照让 Prompt 变更变成一个必须显式确认的动作。
3.6 怎么选
#mermaid-svg-PuZ48UHKK6ywsTc3{font-family:\”trebuchet ms\”,verdana,arial,sans-serif;font-size:16px;fill:#333;}@keyframes edge-animation-frame{from{stroke-dashoffset:0;}}@keyframes dash{to{stroke-dashoffset:0;}}#mermaid-svg-PuZ48UHKK6ywsTc3 .edge-animation-slow{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 50s linear infinite;stroke-linecap:round;}#mermaid-svg-PuZ48UHKK6ywsTc3 .edge-animation-fast{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 20s linear infinite;stroke-linecap:round;}#mermaid-svg-PuZ48UHKK6ywsTc3 .error-icon{fill:#552222;}#mermaid-svg-PuZ48UHKK6ywsTc3 .error-text{fill:#552222;stroke:#552222;}#mermaid-svg-PuZ48UHKK6ywsTc3 .edge-thickness-normal{stroke-width:1px;}#mermaid-svg-PuZ48UHKK6ywsTc3 .edge-thickness-thick{stroke-width:3.5px;}#mermaid-svg-PuZ48UHKK6ywsTc3 .edge-pattern-solid{stroke-dasharray:0;}#mermaid-svg-PuZ48UHKK6ywsTc3 .edge-thickness-invisible{stroke-width:0;fill:none;}#mermaid-svg-PuZ48UHKK6ywsTc3 .edge-pattern-dashed{stroke-dasharray:3;}#mermaid-svg-PuZ48UHKK6ywsTc3 .edge-pattern-dotted{stroke-dasharray:2;}#mermaid-svg-PuZ48UHKK6ywsTc3 .marker{fill:#333333;stroke:#333333;}#mermaid-svg-PuZ48UHKK6ywsTc3 .marker.cross{stroke:#333333;}#mermaid-svg-PuZ48UHKK6ywsTc3 svg{font-family:\”trebuchet ms\”,verdana,arial,sans-serif;font-size:16px;}#mermaid-svg-PuZ48UHKK6ywsTc3 p{margin:0;}#mermaid-svg-PuZ48UHKK6ywsTc3 .label{font-family:\”trebuchet ms\”,verdana,arial,sans-serif;color:#333;}#mermaid-svg-PuZ48UHKK6ywsTc3 .cluster-label text{fill:#333;}#mermaid-svg-PuZ48UHKK6ywsTc3 .cluster-label span{color:#333;}#mermaid-svg-PuZ48UHKK6ywsTc3 .cluster-label span p{background-color:transparent;}#mermaid-svg-PuZ48UHKK6ywsTc3 .label text,#mermaid-svg-PuZ48UHKK6ywsTc3 span{fill:#333;color:#333;}#mermaid-svg-PuZ48UHKK6ywsTc3 .node rect,#mermaid-svg-PuZ48UHKK6ywsTc3 .node circle,#mermaid-svg-PuZ48UHKK6ywsTc3 .node ellipse,#mermaid-svg-PuZ48UHKK6ywsTc3 .node polygon,#mermaid-svg-PuZ48UHKK6ywsTc3 .node path{fill:#ECECFF;stroke:#9370DB;stroke-width:1px;}#mermaid-svg-PuZ48UHKK6ywsTc3 .rough-node .label text,#mermaid-svg-PuZ48UHKK6ywsTc3 .node .label text,#mermaid-svg-PuZ48UHKK6ywsTc3 .image-shape .label,#mermaid-svg-PuZ48UHKK6ywsTc3 .icon-shape .label{text-anchor:middle;}#mermaid-svg-PuZ48UHKK6ywsTc3 .node .katex path{fill:#000;stroke:#000;stroke-width:1px;}#mermaid-svg-PuZ48UHKK6ywsTc3 .rough-node .label,#mermaid-svg-PuZ48UHKK6ywsTc3 .node .label,#mermaid-svg-PuZ48UHKK6ywsTc3 .image-shape .label,#mermaid-svg-PuZ48UHKK6ywsTc3 .icon-shape .label{text-align:center;}#mermaid-svg-PuZ48UHKK6ywsTc3 .node.clickable{cursor:pointer;}#mermaid-svg-PuZ48UHKK6ywsTc3 .root .anchor path{fill:#333333!important;stroke-width:0;stroke:#333333;}#mermaid-svg-PuZ48UHKK6ywsTc3 .arrowheadPath{fill:#333333;}#mermaid-svg-PuZ48UHKK6ywsTc3 .edgePath .path{stroke:#333333;stroke-width:2.0px;}#mermaid-svg-PuZ48UHKK6ywsTc3 .flowchart-link{stroke:#333333;fill:none;}#mermaid-svg-PuZ48UHKK6ywsTc3 .edgeLabel{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-PuZ48UHKK6ywsTc3 .edgeLabel p{background-color:rgba(232,232,232, 0.8);}#mermaid-svg-PuZ48UHKK6ywsTc3 .edgeLabel rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-PuZ48UHKK6ywsTc3 .labelBkg{background-color:rgba(232, 232, 232, 0.5);}#mermaid-svg-PuZ48UHKK6ywsTc3 .cluster rect{fill:#ffffde;stroke:#aaaa33;stroke-width:1px;}#mermaid-svg-PuZ48UHKK6ywsTc3 .cluster text{fill:#333;}#mermaid-svg-PuZ48UHKK6ywsTc3 .cluster span{color:#333;}#mermaid-svg-PuZ48UHKK6ywsTc3 div.mermaidTooltip{position:absolute;text-align:center;max-width:200px;padding:2px;font-family:\”trebuchet ms\”,verdana,arial,sans-serif;font-size:12px;background:hsl(80, 100%, 96.2745098039%);border:1px solid #aaaa33;border-radius:2px;pointer-events:none;z-index:100;}#mermaid-svg-PuZ48UHKK6ywsTc3 .flowchartTitleText{text-anchor:middle;font-size:18px;fill:#333;}#mermaid-svg-PuZ48UHKK6ywsTc3 rect.text{fill:none;stroke-width:0;}#mermaid-svg-PuZ48UHKK6ywsTc3 .icon-shape,#mermaid-svg-PuZ48UHKK6ywsTc3 .image-shape{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-PuZ48UHKK6ywsTc3 .icon-shape p,#mermaid-svg-PuZ48UHKK6ywsTc3 .image-shape p{background-color:rgba(232,232,232, 0.8);padding:2px;}#mermaid-svg-PuZ48UHKK6ywsTc3 .icon-shape .label rect,#mermaid-svg-PuZ48UHKK6ywsTc3 .image-shape .label rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-PuZ48UHKK6ywsTc3 .label-icon{display:inline-block;height:1em;overflow:visible;vertical-align:-0.125em;}#mermaid-svg-PuZ48UHKK6ywsTc3 .node .label-icon path{fill:currentColor;stroke:revert;stroke-width:revert;}#mermaid-svg-PuZ48UHKK6ywsTc3 :root{–mermaid-font-family:\”trebuchet ms\”,verdana,arial,sans-serif;}
是
否
能
不能
要
不要
能
不能
简单
复杂
需要断言 Agent 输出
输出是结构化的吗
结构断言 Schema
能找到不变量吗
还要验证内容吗
属性断言 不变量
能表达成语义要求吗
完成
要求复杂吗
快照回归
语义相似度
LLM-as-judge
口诀:能用规则就用规则,规则不行才用模型。 语义相似度和 LLM-as-judge 都很强大,但它们引入了新的不确定性——用它们之前,先确认没有更简单的规则可用。
3.7 多轮对话的测试:状态累积比单轮更难
单轮测试相对简单,但 Agent 的核心价值往往在多轮——而多轮测试的难点是状态在轮次之间累积,错误也会累积。
三个特有的测试点:
| 上下文不丢失 | 第 3 轮时,第 1 轮提到的信息仍在上下文里 | 用户反复重复自己说过的话 |
| 不累积无关信息 | 上下文长度受控,旧信息被压缩或淘汰 | Token 成本线性上涨(第 30 篇) |
| 会话状态不被任务污染 | 任务失败后,用户偏好仍在 | 第 30 篇事故二:重跑污染偏好 |
@pytest.mark.asyncio
async def test_context_survives_three_turns():
"""上下文跨轮保留:第 3 轮时仍能引用第 1 轮的信息。"""
llm = FakeLLM()
session = SessionState(session_id="s1")
await agent.chat(session, "我在审查一份采购合同,对方是供应商 A")
await agent.chat(session, "付款条款有什么问题吗")
await agent.chat(session, "那保密条款呢")
prompt = llm.last_prompt()
assert "采购合同" in prompt # 第 1 轮的信息还在
assert "供应商 A" in prompt
@pytest.mark.asyncio
async def test_failed_task_does_not_pollute_session():
"""任务失败后会话状态必须完好(第 30 篇事故二)。"""
llm = FakeLLM()
llm.set_scenario("ratelimit")
session = SessionState(session_id="s1", user_role="法务", turn_index=5)
with pytest.raises(RuntimeError):
await agent.review(session, "某合同文本")
assert session.user_role == "法务" # 偏好没被重置
assert session.turn_index == 5 # 轮次没被改
💡 第二个测试直接对应第 30 篇 1.2 节的真实事故:运维执行"重置任务上下文"时,把用户偏好一起重置了。这个错误的根源是"生命周期不同的数据放在同一个容器里",而测试是唯一能在它复发时立刻报警的手段。
3.8 断言强度自检:三个问题
写完断言后,用三个问题检查它够不够强:
| ① 把被测代码改坏,它会红吗? | 不会 | 断言是摆设(用变异测试验证) |
| ② 模型换一种说法,它会红吗? | 会 | 断言过强,会变得 flaky |
| ③ 它能描述出"失败原因"吗? | 不能 | 排查成本高,加断言消息 |
问题①是"够不够严",用 6 章的元测试验证。问题②是"会不会太严"——一个只在措辞完全匹配时才通过的断言,本质上是脆弱的。问题③常常被忽略,但一条 assert len(risks) == 3 失败时只显示 assert 2 == 3,而 assert len(risks) == 3, f"预期 3 条风险,实际 {len(risks)}:{[r['reason'] for r in risks]}" 能直接告诉你发生了什么。
理想的断言应该同时满足三条:能真正失败、不因措辞变化而失败、失败时能说清原因。这三条往往指向同一个方向——断言不变量,而不是断言具体值。
多轮测试的一个实用技巧:把一轮对话封装成 fixture,让测试用例读起来像剧本:
async def script(agent, session, lines: list[str]) –> None:
"""按剧本跑多轮对话。**让测试意图一目了然。**"""
for line in lines:
await agent.chat(session, line)
这样上面的测试可以写成 await script(agent, session, ["我在审查…", "付款条款…", "那保密条款呢"])——测试用例本身就成了可执行的文档。
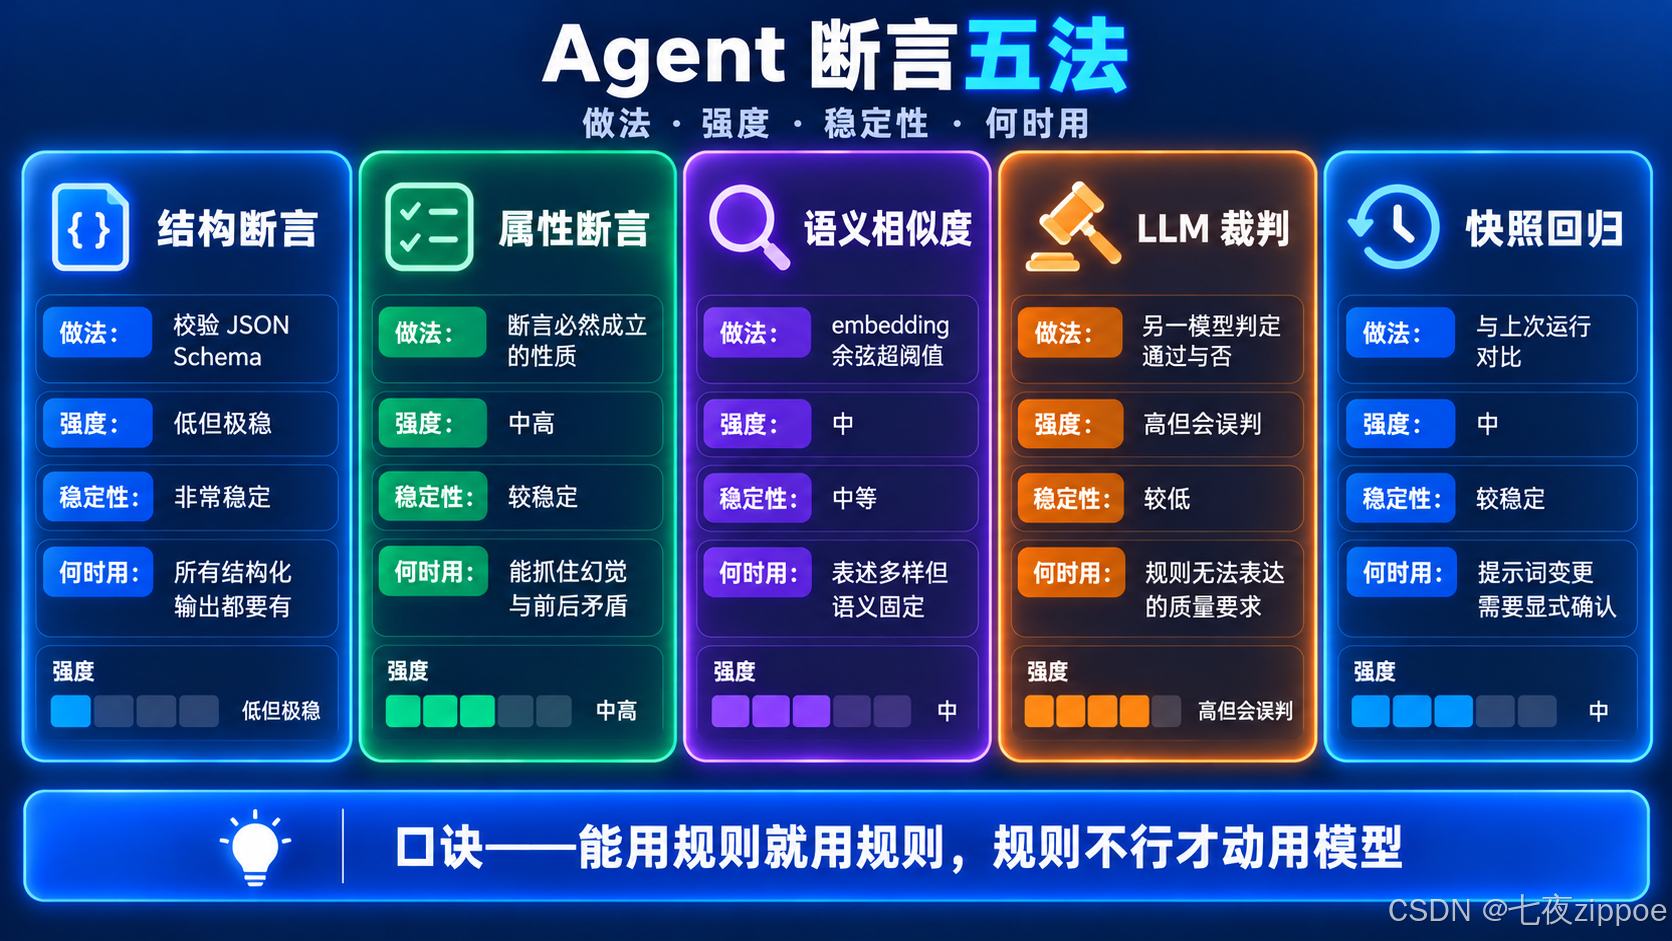
图2:Agent 测试的五种断言法——结构、属性、语义相似度、LLM裁判、快照回归的选择依据
四、三层测试的分工
4.1 Agent 版的测试金字塔
传统测试金字塔是"大量单测 + 少量集成 + 极少量 E2E"。Agent 场景需要调整:
/\\
/ \\ 质量层:评估(第 36 篇)——不是测试,是度量
/—-\\
/ 编排层 \\ Fake LLM 跑完整流程,验证协作
/———-\\
/ 工具层 \\ 100% 确定性覆盖,零 Mock
/————–\\
关键变化:工具层的测试比例要远高于传统项目。
| 工具层(确定性代码) | 70% | 60% | 工具是纯代码,且工具出错会直接导致 Agent 行为错误 |
| 编排层(流程协作) | 20% | 30% | 分支、重试、状态转移的复杂度更高 |
| 质量层(评估) | 10%(E2E) | 10% | 但性质从"测试"变成"评估" |
4.2 工具层:必须 100% 确定性
工具是 Agent 里唯一完全确定性的部分,因此也是唯一能做传统断言的部分:
def test_parse_clauses_handles_empty():
assert parse_clauses("") == []
def test_parse_clauses_splits_by_numbering():
text = "第一条 甲方义务\\n第二条 乙方义务"
result = parse_clauses(text)
assert len(result) == 2
assert result[0].index == 0
assert "甲方" in result[0].text
def test_parse_clauses_rejects_oversized_input():
"""护栏:超大输入必须被拒绝,不能原样塞进上下文。"""
with pytest.raises(ValueError):
parse_clauses("x" * 1_000_001)
def test_tool_error_is_structured_not_exception():
"""工具失败必须返回结构化错误,而不是抛裸异常(第 23 篇原则)。"""
result = fetch_contract("not-exist")
assert result.ok is False
assert result.error.code == "NOT_FOUND"
为什么工具层必须 100% 覆盖:工具的输出会直接进入 LLM 上下文。一个返回了错误数据的工具,会让模型基于错误信息给出看似合理的错误结论——这是最典型的一类静默失效。
4.3 编排层:用 Fake 跑通全流程
编排层测的是"组件之间怎么协作",不需要真实 LLM:
@pytest.mark.asyncio
async def test_supervisor_escalates_when_no_progress():
"""停滞检测:连续两轮无新发现就必须停止(第 24 篇的三道保险之一)。"""
llm = FakeLLM()
# 让专家永远返回"没找到问题"
llm.on(lambda p: True, lambda p: '{"layer_ok": true, "findings": []}')
state = await supervisor.run(llm, max_rounds=10)
assert state.round_index <= 3, "无进展时应提前停止,不应跑满 10 轮"
assert llm.call_count() <= 4
@pytest.mark.asyncio
async def test_mapreduce_partial_failure_keeps_successful_results():
"""部分失败:600 个任务里 3 个失败,其余 597 个结果必须保留(第 23 篇)。"""
llm = FakeLLM()
llm.on(lambda p: "失败用例" in p, lambda p: (_ for _ in ()).throw(RuntimeError("boom")))
llm.on(lambda p: True, lambda p: "ok")
results = await map_reduce(llm, items=list(range(600)))
ok = [r for r in results if r.ok]
failed = [r for r in results if not r.ok]
assert len(ok) == 597
assert len(failed) == 3
第二个测试守的是第 23 篇的核心结论:失败必须做成 ok=False 的数据而非异常——异常会让 asyncio.gather 中断,导致 597 个成功结果全部丢失。
4.4 质量层:这不是测试,是评估
必须分清的一件事:
| 判据 | 通过 / 不通过(布尔) | 分数(连续值) |
| 频率 | 每次提交 | 定期(每日/每周) |
| 目的 | 防止回归 | 度量质量 |
| 能否阻断发布 | 能 | 通常不阻断(作为参考) |
把评估当成测试来用是错的——评估分数会波动(因为 LLM 随机性),如果用它做 CI 门禁,会产生大量 flaky 失败。第 36 篇会讲怎么把评估做成质量门禁(用阈值 + 趋势而非绝对值)。
4.5 三层测试的判据汇总
| 工具层 | 精确断言全绿 | 代码有 bug,必须修 |
| 编排层 | Fake 场景下流程正确 | 协作逻辑有 bug,必须修 |
| 质量层 | 分数在阈值之上且未退化 | 质量下降,需要分析(不一定是 bug) |
4.6 Golden Set:质量层的地基
质量层依赖一个东西:人工标注的标准集(Golden Set)。没有它,评估结果就没有参照物。
Golden Set 长什么样:
{
"id": "case-001",
"input": "审查这份采购合同的付款条款",
"source": "采购合同样本 A",
"expectations": {
"must_mention": ["验收后付款", "逾期利息"],
"min_risks": 1,
"max_risks": 5,
"forbid_hallucination": true
},
"human_label": {
"correctness": 4,
"completeness": 3,
"note": "漏掉了违约金条款"
}
}
注意 expectations 与 human_label 的区别:前者是可以自动检查的硬约束(对应 3.2/3.3 节的结构与不变量断言),后者是人工打分的软指标(用于评估)。Golden Set 同时服务测试与评估两层。
怎么建:四条实践经验
| 从真实日志采样,不要凭空编造 | 编造的用例不覆盖真实分布,测了等于没测 |
| 优先覆盖"曾经出过错"的用例 | 每一个线上事故都应该变成一条 Golden 用例 |
| 规模 50~200 条就够 | 少于 50 统计上不可靠,多于 200 维护成本陡增 |
| 标注要包含"错在哪",不只是分数 | 只有分数无法指导改进 |
第三条值得强调:很多团队一开始就想建 1000 条的标准集,结果标注到 200 条就停了(人力耗尽),且因为没有维护,半年后一半用例已经过时。50~200 条 + 持续维护,远好于 1000 条 + 停止维护。
⚠️ Golden Set 最大的风险是"污染":如果你用某个版本的模型输出来辅助标注(比如让模型先生成答案,人工只做确认),那么标准集会偏向那个模型的风格。之后评估其他模型时,分数会系统性偏低。标注必须基于事实(真实合同条款、真实业务规则),而不是基于某个模型的输出。
Golden Set 与录制回放的关系:录制回放是"记录过去的行为"(防止变化),Golden Set 是"记录期望的行为"(判断对错)。前者防回归,后者判质量。两者不可替代。
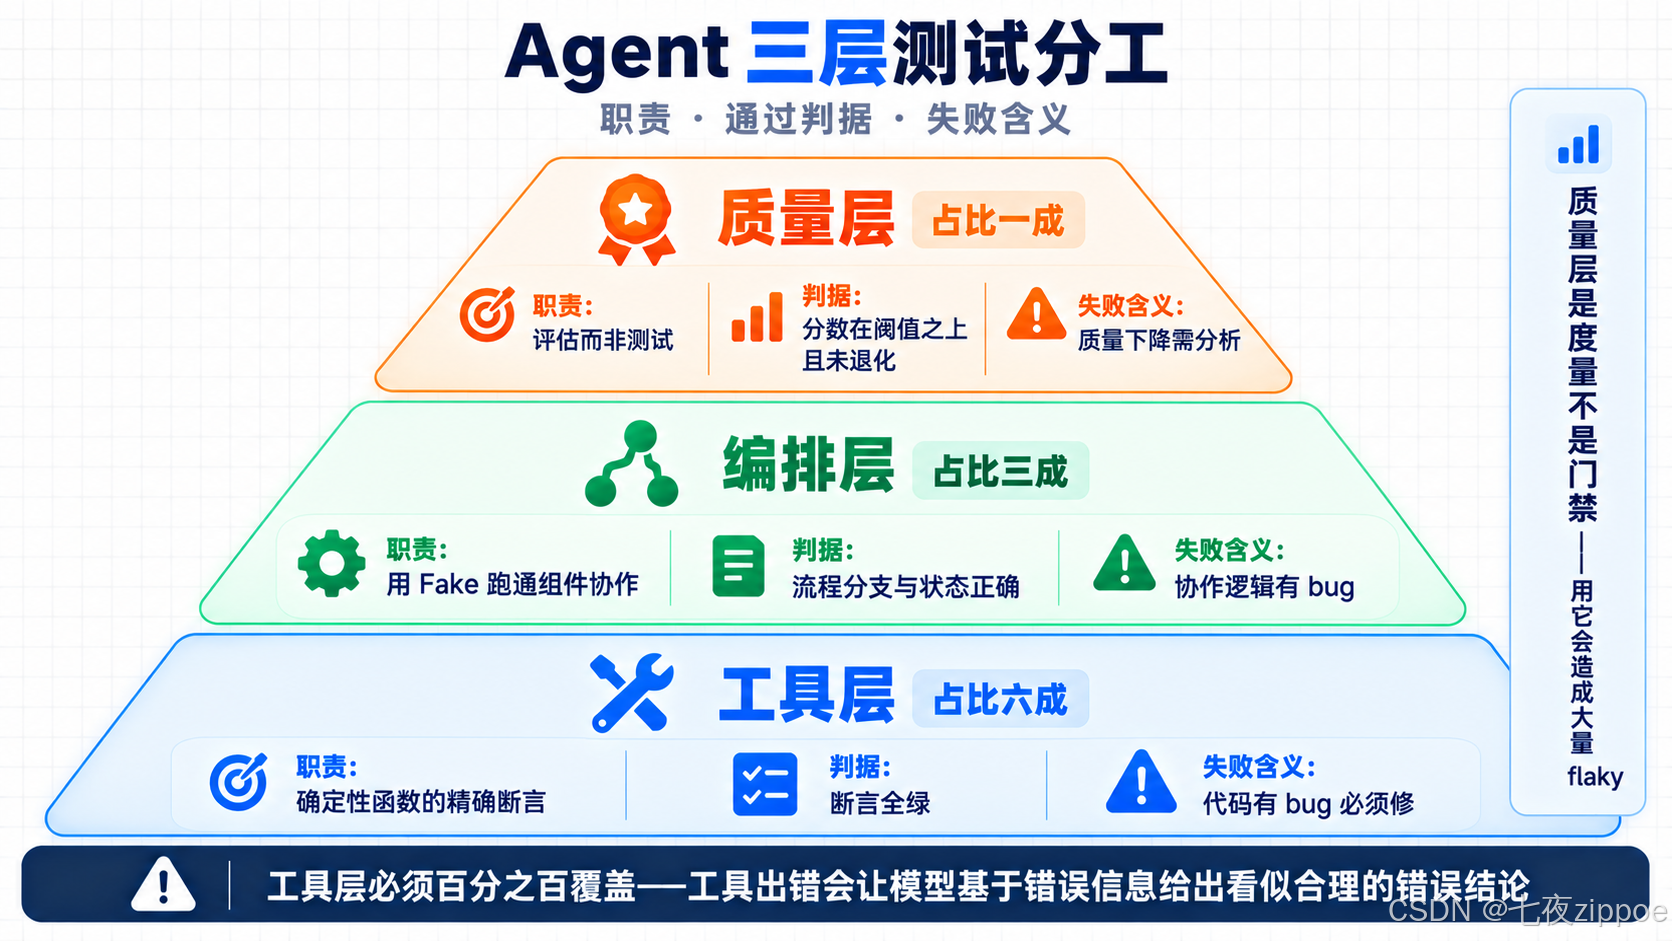
图3:Agent 三层测试的职责、判据与失败含义——工具层、编排层、质量层的分工
五、Flaky 测试:Agent 测试的头号敌人
5.1 四类根因
测试时而通过时而失败,比一直失败更糟糕——它教会团队忽略失败。四类根因:
| 1 | 真实调用了 LLM | 随模型输出波动 | 改用 Fake / 录制回放 |
| 2 | 依赖真实时间 | 超时测试偶发失败 | 注入时钟,不要用 sleep |
| 3 | 依赖并发顺序 | 并发测试结果不稳定 | 显式等待条件,不用固定 sleep |
| 4 | 测试间共享状态 | 单独跑通过,一起跑失败 | 每个测试独立 fixture |
5.2 为什么"失败就重跑"是最糟的应对
pytest –reruns 3 # ❌
这个做法的问题不是"没用",而是它让一个真实问题变得不可见:
| Agent 行为确实不稳定 | 用户会遇到同样的不稳定 |
| 存在并发 bug | 上线后在高并发下暴露 |
| 测试之间有依赖 | 掩盖真实的顺序耦合问题 |
更危险的是它会产生"狼来了"效应:团队习惯了"红了就重跑",某天真正的失败也会被当成 flaky 忽略。
5.3 正确的处理流程
测试 flaky
↓
第一步:确认它是不是真的 flaky(连续跑 10 次,记录失败率)
↓
第二步:定位根因(对照 5.1 的四类)
↓
第三步:修根因(确定性化)
↓
做不到?→ 标记 xfail 并写明原因,**不要静默重跑**
第三步的"确定性化"具体做法:
| 真实 LLM | Fake / 录制回放 + temperature=0 |
| 依赖时间 | 注入 Clock 接口,测试里用假时钟 |
| 并发顺序 | asyncio.Event 显式同步,而非 sleep |
| 共享状态 | fixture 隔离 + 每次清空存储 |
class FakeClock:
"""可注入的时钟。**测试超时逻辑不能用 sleep。**"""
def __init__(self, start: float = 0.0) –> None:
self._now = start
def now(self) –> float:
return self._now
def advance(self, seconds: float) –> None:
self._now += seconds
def test_budget_expires_without_sleeping():
"""预算超时:**推进假时钟**,测试毫秒级完成且不 flaky。"""
clock = FakeClock()
budget = ExecutionBudget(max_wall_clock_s=60, clock=clock.now)
clock.advance(61)
assert budget.exhausted() is True
💡 "注入时钟"这一招的收益远超超时测试本身。 它让所有与时间相关的逻辑(TTL、退避、限流窗口、缓存过期)都能在毫秒内被测到,而不需要任何 sleep。一个项目的测试套件从 3 分钟降到 10 秒,往往就是靠这一个改动。
5.4 什么时候可以接受重跑
只有一个场景:已知的上游偶发故障(比如真实调用时的网络抖动)。这时的正确做法是只给这一小类测试加重跑,而不是全局开启:
@pytest.mark.flaky(reruns=2, reason="依赖真实网络,偶发超时")
@pytest.mark.integration
async def test_real_call_smoke():
...
关键是 reason 参数——它强制你写下"为什么这个测试允许重跑"。写不出理由的,就不许重跑。 这一条把"偷懒"和"必要"区分开了。
5.5 CI 分层执行:让测试套件跑得完
一个常见的失败模式:测试套件越加越多,最后跑一次要 30 分钟,于是没人愿意在本地跑,CI 也成了摆设。
解法是按速度分层,让快反馈和高保真各司其职:
| L1 快测 | 工具层 + 状态 + 路由(零 Mock) | < 10 秒 | 每次保存 |
| L2 编排测 | Fake LLM 跑流程 | < 60 秒 | 每次提交 |
| L3 保真测 | HTTP 层 + 录制回放 | < 5 分钟 | 每次推送 |
| L4 评估 | Golden Set + 真实调用 | 分钟~小时 | 每日夜间 |
# pytest.ini
[tool:pytest]
markers =
l1: 快测,零外部依赖
l2: 编排测,Fake LLM
l3: 保真测,HTTP 层与录制回放
l4: 评估,真实调用(非门禁)
addopts = -m "not l4" # 默认不跑评估
# 本地开发:只跑 L1(秒级反馈)
pytest -m l1
# 提交前:L1 + L2
pytest -m "l1 or l2"
# CI:L1~L3
pytest -m "not l4"
# 夜间:全量
pytest
addopts = -m "not l4" 这一行很重要:它让"跑测试"的默认行为是快速的。如果默认跑全量,团队会逐渐养成"跳过测试"的习惯——这比没有测试更糟。
flaky 测试的处理流程(5.3 节的图版本):
#mermaid-svg-tXVljdldoBT5OfA5{font-family:\”trebuchet ms\”,verdana,arial,sans-serif;font-size:16px;fill:#333;}@keyframes edge-animation-frame{from{stroke-dashoffset:0;}}@keyframes dash{to{stroke-dashoffset:0;}}#mermaid-svg-tXVljdldoBT5OfA5 .edge-animation-slow{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 50s linear infinite;stroke-linecap:round;}#mermaid-svg-tXVljdldoBT5OfA5 .edge-animation-fast{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 20s linear infinite;stroke-linecap:round;}#mermaid-svg-tXVljdldoBT5OfA5 .error-icon{fill:#552222;}#mermaid-svg-tXVljdldoBT5OfA5 .error-text{fill:#552222;stroke:#552222;}#mermaid-svg-tXVljdldoBT5OfA5 .edge-thickness-normal{stroke-width:1px;}#mermaid-svg-tXVljdldoBT5OfA5 .edge-thickness-thick{stroke-width:3.5px;}#mermaid-svg-tXVljdldoBT5OfA5 .edge-pattern-solid{stroke-dasharray:0;}#mermaid-svg-tXVljdldoBT5OfA5 .edge-thickness-invisible{stroke-width:0;fill:none;}#mermaid-svg-tXVljdldoBT5OfA5 .edge-pattern-dashed{stroke-dasharray:3;}#mermaid-svg-tXVljdldoBT5OfA5 .edge-pattern-dotted{stroke-dasharray:2;}#mermaid-svg-tXVljdldoBT5OfA5 .marker{fill:#333333;stroke:#333333;}#mermaid-svg-tXVljdldoBT5OfA5 .marker.cross{stroke:#333333;}#mermaid-svg-tXVljdldoBT5OfA5 svg{font-family:\”trebuchet ms\”,verdana,arial,sans-serif;font-size:16px;}#mermaid-svg-tXVljdldoBT5OfA5 p{margin:0;}#mermaid-svg-tXVljdldoBT5OfA5 defs #statediagram-barbEnd{fill:#333333;stroke:#333333;}#mermaid-svg-tXVljdldoBT5OfA5 g.stateGroup text{fill:#9370DB;stroke:none;font-size:10px;}#mermaid-svg-tXVljdldoBT5OfA5 g.stateGroup text{fill:#333;stroke:none;font-size:10px;}#mermaid-svg-tXVljdldoBT5OfA5 g.stateGroup .state-title{font-weight:bolder;fill:#131300;}#mermaid-svg-tXVljdldoBT5OfA5 g.stateGroup rect{fill:#ECECFF;stroke:#9370DB;}#mermaid-svg-tXVljdldoBT5OfA5 g.stateGroup line{stroke:#333333;stroke-width:1;}#mermaid-svg-tXVljdldoBT5OfA5 .transition{stroke:#333333;stroke-width:1;fill:none;}#mermaid-svg-tXVljdldoBT5OfA5 .stateGroup .composit{fill:white;border-bottom:1px;}#mermaid-svg-tXVljdldoBT5OfA5 .stateGroup .alt-composit{fill:#e0e0e0;border-bottom:1px;}#mermaid-svg-tXVljdldoBT5OfA5 .state-note{stroke:#aaaa33;fill:#fff5ad;}#mermaid-svg-tXVljdldoBT5OfA5 .state-note text{fill:black;stroke:none;font-size:10px;}#mermaid-svg-tXVljdldoBT5OfA5 .stateLabel .box{stroke:none;stroke-width:0;fill:#ECECFF;opacity:0.5;}#mermaid-svg-tXVljdldoBT5OfA5 .edgeLabel .label rect{fill:#ECECFF;opacity:0.5;}#mermaid-svg-tXVljdldoBT5OfA5 .edgeLabel{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-tXVljdldoBT5OfA5 .edgeLabel p{background-color:rgba(232,232,232, 0.8);}#mermaid-svg-tXVljdldoBT5OfA5 .edgeLabel rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-tXVljdldoBT5OfA5 .edgeLabel .label text{fill:#333;}#mermaid-svg-tXVljdldoBT5OfA5 .label div .edgeLabel{color:#333;}#mermaid-svg-tXVljdldoBT5OfA5 .stateLabel text{fill:#131300;font-size:10px;font-weight:bold;}#mermaid-svg-tXVljdldoBT5OfA5 .node circle.state-start{fill:#333333;stroke:#333333;}#mermaid-svg-tXVljdldoBT5OfA5 .node .fork-join{fill:#333333;stroke:#333333;}#mermaid-svg-tXVljdldoBT5OfA5 .node circle.state-end{fill:#9370DB;stroke:white;stroke-width:1.5;}#mermaid-svg-tXVljdldoBT5OfA5 .end-state-inner{fill:white;stroke-width:1.5;}#mermaid-svg-tXVljdldoBT5OfA5 .node rect{fill:#ECECFF;stroke:#9370DB;stroke-width:1px;}#mermaid-svg-tXVljdldoBT5OfA5 .node polygon{fill:#ECECFF;stroke:#9370DB;stroke-width:1px;}#mermaid-svg-tXVljdldoBT5OfA5 #statediagram-barbEnd{fill:#333333;}#mermaid-svg-tXVljdldoBT5OfA5 .statediagram-cluster rect{fill:#ECECFF;stroke:#9370DB;stroke-width:1px;}#mermaid-svg-tXVljdldoBT5OfA5 .cluster-label,#mermaid-svg-tXVljdldoBT5OfA5 .nodeLabel{color:#131300;}#mermaid-svg-tXVljdldoBT5OfA5 .statediagram-cluster rect.outer{rx:5px;ry:5px;}#mermaid-svg-tXVljdldoBT5OfA5 .statediagram-state .divider{stroke:#9370DB;}#mermaid-svg-tXVljdldoBT5OfA5 .statediagram-state .title-state{rx:5px;ry:5px;}#mermaid-svg-tXVljdldoBT5OfA5 .statediagram-cluster.statediagram-cluster .inner{fill:white;}#mermaid-svg-tXVljdldoBT5OfA5 .statediagram-cluster.statediagram-cluster-alt .inner{fill:#f0f0f0;}#mermaid-svg-tXVljdldoBT5OfA5 .statediagram-cluster .inner{rx:0;ry:0;}#mermaid-svg-tXVljdldoBT5OfA5 .statediagram-state rect.basic{rx:5px;ry:5px;}#mermaid-svg-tXVljdldoBT5OfA5 .statediagram-state rect.divider{stroke-dasharray:10,10;fill:#f0f0f0;}#mermaid-svg-tXVljdldoBT5OfA5 .note-edge{stroke-dasharray:5;}#mermaid-svg-tXVljdldoBT5OfA5 .statediagram-note rect{fill:#fff5ad;stroke:#aaaa33;stroke-width:1px;rx:0;ry:0;}#mermaid-svg-tXVljdldoBT5OfA5 .statediagram-note rect{fill:#fff5ad;stroke:#aaaa33;stroke-width:1px;rx:0;ry:0;}#mermaid-svg-tXVljdldoBT5OfA5 .statediagram-note text{fill:black;}#mermaid-svg-tXVljdldoBT5OfA5 .statediagram-note .nodeLabel{color:black;}#mermaid-svg-tXVljdldoBT5OfA5 .statediagram .edgeLabel{color:red;}#mermaid-svg-tXVljdldoBT5OfA5 #dependencyStart,#mermaid-svg-tXVljdldoBT5OfA5 #dependencyEnd{fill:#333333;stroke:#333333;stroke-width:1;}#mermaid-svg-tXVljdldoBT5OfA5 .statediagramTitleText{text-anchor:middle;font-size:18px;fill:#333;}#mermaid-svg-tXVljdldoBT5OfA5 :root{–mermaid-font-family:\”trebuchet ms\”,verdana,arial,sans-serif;}
CI 偶发失败
连续跑 10 次记录失败率
失败率 0 为环境问题
失败率大于 0
对照四类根因
找到根因
确定性化完成
确属上游偶发
写明 reason 后接受重跑
稳定
疑似Flaky
确认中
已确认
定位中
修复中
标记豁免
禁止直接加重跑那会掩盖真实问题
唯一可接受重跑的情形且必须写明理由
六、适用边界与风险提示 ⚠️
什么时候不需要这套测试体系:
- 原型阶段、Prompt 每周都在改 → 测试天天红,纯浪费
- 只有一两个 Agent、无外部副作用 → 冒烟测试就够
- 团队没有人力维护录制文件 → Fake 比录制回放更适合
四个必须知道的风险:
| 假阳性测试 | 测试全绿但测的不是想测的行为 | 录制键含全部参数;断言要能真正失败(做一次"变异测试"验证) |
| 测试维护成本 | Prompt 一改,十几个测试要更新 | Prompt 与断言解耦;优先用不变量而非具体内容 |
| Mock 与真实脱节 | Mock 全绿,真实一跑就错 | 必须保留一组 HTTP 层的真实路径测试(2.5 节) |
| 评估当测试用 | 分数波动导致 CI 频繁红 | 评估不做门禁;或用趋势而非绝对值(第 36 篇) |
第一个风险值得展开:怎么确认你的测试真的能抓到错误?答案是变异测试(mutation testing)——故意改坏被测代码,看测试会不会红。
def test_the_test_actually_fails():
"""元测试:确认"引用原文"这条断言真的能抓住幻觉。
**做法:喂一个编造的风险,断言必须失败。**
如果它通过了,说明你的断言是摆设。
"""
bad_result = {
"risks": [{"clause_index": 0, "level": "high",
"reason": "该条款存在无限责任风险",
"quote": "这句话在原文里根本不存在"}],
"source_text": "第一条 甲方应按时付款",
"summary": "共 1 条风险",
}
with pytest.raises(AssertionError):
assert_every_risk_cites_source(bad_result)
💡 这类"元测试"应该至少写两三个,覆盖你最重要的不变量。 它能防止一类特别尴尬的情况:你写了 50 个测试,全绿,但因为断言写错了(比如 assert x in y 写成了 assert y in x),它们从未真正生效过。
测试不要测的东西:
- ❌ 不要断言具体的措辞(“报告里必须出现’建议修改’四个字”)
- ❌ 不要用真实调用做日常回归(慢、贵、不稳)
- ❌ 不要为了覆盖率去测 Prompt 的措辞细节
- ❌ 不要全局开启 –reruns
6.1 覆盖率在 Agent 项目里的正确用法
传统项目追求高行覆盖率,但这个指标在 Agent 项目里会给出误导性的好消息:
| 覆盖率很高(90%+)但线上仍出问题 | Mock 掉 LLM 后,代码路径几乎全跑到了——但模型行为完全没测 |
| 覆盖率提高后质量没提升 | 覆盖率统计的是"代码执行了没有",不是"行为对不对" |
Agent 项目应该看这三个指标,而不是行覆盖率:
| 分支覆盖率 | 错误分支、重试分支是否被触发 | Agent 的复杂度在分支里(超时、限流、部分失败) |
| 不变量覆盖 | 1.4 节那张表里有多少条已实现 | 直接对应真实失效模式 |
| Golden Set 覆盖 | 评估集覆盖了多少真实场景 | 对应"用户实际会怎么用" |
# 分支覆盖率(比行覆盖率更有意义)
pytest –cov=my_agent –cov-branch –cov-report=term-missing
关于"100% 覆盖率"的态度:不要追求。三个理由——① 达到最后 10% 的成本极高(通常是防御性分支和异常兜底);② 覆盖率与质量的相关性在越过某个点(约 70%~80%)后急剧下降;③ 追求覆盖率会导致"为了覆盖而写的测试",这类测试通常断言很弱(比如 assert result is not None),徒增维护成本。
💡 一个实用的替代目标:“错误分支 100% 覆盖,正常路径按需覆盖”。 Agent 的崩溃几乎都发生在错误分支(超时、限流、畸形响应、部分失败),而正常路径的问题通常表现为质量下降(由评估发现,不由测试发现)。把覆盖率预算花在错误分支上,性价比最高。
七、一个可复制的测试骨架
tests/
├── conftest.py # 共享 fixture:fake_llm / fake_clock / settings
├── unit/
│ ├── test_tools.py # 工具层:100% 确定性,零 Mock
│ ├── test_state.py # 状态机与转移
│ └── test_routing.py # 规则路由(不需要 LLM)
├── integration/
│ ├── test_orchestration.py # Fake LLM 跑完整流程
│ ├── test_http_layer.py # **真实 SDK + Mock 服务**(保留 SDK 行为)
│ └── cassettes/ # 录制回放文件
├── eval/
│ ├── test_quality.py # 质量评估(非门禁)
│ └── golden_set.json # 人工标注的标准集
└── snapshots/
└── prompts/ # 提示词快照
conftest.py 的关键 fixture:
import pytest
import pytest_asyncio
from fake_llm import FakeLLM
@pytest.fixture
def fake_llm() –> FakeLLM:
"""每个测试独立的 Fake。**不共享状态**(5.1 节第 4 类根因)。"""
return FakeLLM()
@pytest.fixture
def fake_clock():
from clocks import FakeClock
return FakeClock()
@pytest.fixture(autouse=True)
def _isolated_settings(monkeypatch):
"""自动隔离配置:避免测试之间互相影响。"""
monkeypatch.setenv("ENV", "test")
monkeypatch.setenv("STATE_BACKEND", "memory")
monkeypatch.setenv("LLM_RECORD_MODE", "replay")
from my_agent.config import get_settings
get_settings.cache_clear()
yield
get_settings.cache_clear()
def pytest_collection_modifyitems(items):
"""给慢测试自动打标记,便于 CI 分层执行。"""
for item in items:
if "real" in item.keywords or "eval" in item.nodeid:
item.add_marker(pytest.mark.slow)
_isolated_settings 这个 autouse fixture 很重要:配置是全局单例(第 34 篇用 @lru_cache),测试之间会互相污染。每个测试前清缓存,是防止第 4 类 flaky 根因的必备动作。
💡 最后一个建议:测试名要写"验证什么性质",不要写"测什么场景"。 对比一下——
- ❌ test_contract_review_case_1:看不出它在保证什么
- ✅ test_every_risk_cites_source_text:失败时你立刻知道哪条性质被破坏了
在 Agent 项目里这个区别更重要,因为测试失败时你面对的不是一个简单的数值差异,而是模型的一段输出。一个好的测试名能省下几分钟的排查时间——而在排查 LLM 问题时,几分钟往往不够。
八、总结
回到第 33 篇留下的那个问题——“LLM 有随机性,怎么测?” 本文的答案是三层:
第一,接受"不能断言输出等于什么",改为断言性质。 五种替代方案里,结构断言和不变量断言应该占绝大多数——它们零成本、极稳定,且能抓住最危险的错误(格式错误、幻觉、前后矛盾)。语义相似度和 LLM-as-judge 只在规则无法表达时才用。
第二,Mock 分层,日常用 Fake、回归用录制、SDK 行为用 HTTP 层 Mock。 函数层 Mock 最方便但会跳过真实 SDK 的重试与超时逻辑——所以必须补一组 HTTP 层测试,否则超时处理代码从未被真正执行过。
第三,分清测试与评估。 测试是布尔判据、防回归、能阻断发布;评估是连续分数、度量质量、不做门禁。用评估做 CI 门禁是 flaky 测试的主要来源之一。
关于 flaky,最重要的一句话:"失败就重跑"是把真实问题包装成无害现象。 它掩盖的可能是"Agent 行为确实不稳定"——而这恰恰是用户会遇到的。正确做法是定位四类根因并确定性化,其中"注入时钟"这一招能让测试从分钟级降到秒级。
最后一个提醒:测试体系应该在 Prompt 稳定之后建立。在原型阶段投资测试,得到的只是一堆天天变红的测试和一个"测试没用"的团队印象。时机比完备性更重要。
还有一点值得记住:测试体系的价值不在于"测了多少",而在于"第一次有人改坏代码时,它会不会立刻报警"。 一个只有 20 条不变量断言的测试套件,比一个 200 条 assert result is not None 的套件有用得多——后者永远全绿,也永远无用。
落地自检清单(Checklist)
- ✅ 没有用精确字符串断言 LLM 输出
- ✅ 结构化输出都有 schema 断言
- ✅ 至少三条不变量断言(引用存在、枚举合法、前后一致)
- ✅ 工具层零 Mock、100% 确定性覆盖
- ✅ 编排层用 Fake LLM 跑通流程,不依赖真实调用
- ✅ 有一组 HTTP 层测试保留真实 SDK 行为
- ✅ 录制键包含全部影响输出的参数(尤其 temperature)
- ✅ 断言经过变异测试验证(能真正失败)
- ✅ 提示词有快照测试,变更需显式确认
- ✅ 时间相关逻辑注入时钟,测试里无 sleep
- ✅ 未全局开启 –reruns;允许重跑的测试写明了 reason
- ✅ 配置 fixture 每个测试隔离(清 lru_cache)
- ✅ 评估不做 CI 门禁(或用趋势而非绝对值)
- ✅ 测试套件能在秒级跑完(否则没人愿意跑)
常见问题(FAQ)
Q1:Mock 掉 LLM 之后,测试还有意义吗?
有,但测的东西变了。Mock 之后你测的是"给定某个响应,Agent 代码是否正确处理"——这覆盖了解析、分支、重试、状态转移、错误处理。真正没被覆盖的是"模型本身的质量",那属于评估(第 36 篇),不是测试的职责。
Q2:语义相似度的阈值怎么定?
必须自己校准,不能照抄。 做法:准备 20~30 组人工标注的"(可接受 / 不可接受)"样本,跑一遍看相似度分布,取能把两类分开的值作为阈值。不同领域、不同 embedding 模型的合适阈值差异很大。
Q3:LLM-as-judge 的裁判用什么模型?
与被测模型不同的模型,且要足够强。用同一个模型评判自己会系统性偏向自己的输出风格。另外裁判的 temperature 必须为 0,否则你的测试会变得 flaky。
Q4:录制回放和 Fake 该选哪个?
回归测试用录制回放(保证行为不变),错误分支与边界场景用 Fake(需要人为制造超时、429、畸形响应)。两者都该有。日常开发的快速迭代期,Fake 更好用,因为录制文件会随 Prompt 变化而失效。
Q5:测试跑得太慢怎么办?
三个最常见的提速点,按顺序排查:① 把 sleep 换成注入时钟(往往能省下 80% 的时间);② 确认没有测试在真实调用 LLM(检查 LLM_RECORD_MODE);③ 并发执行(pytest-xdist)。第一项的效果通常远超后两项。
Q6:Prompt 改了,测试要全改吗?
取决于断言类型。不变量断言不需要改(“每条风险引用原文"与 Prompt 内容无关);精确内容断言需要改(这也是为什么应该优先写不变量);快照测试需要重新生成并人工确认。这就是为什么 3.6 节强调"能用规则就用规则”。
Q7:评估测试要跑多久一次?
建议每日一次(夜间),而不是每次提交。因为评估要真实调用、耗时较长、且结果有波动。重点是看趋势而非单次绝对值——分数从 0.85 掉到 0.78 需要关注,0.85 和 0.84 的差异没有意义。
Q8:小团队要不要建这么全的测试?
不用全建。最小可用集是:① 工具层的确定性测试(零成本、收益最高);② 一组 schema + 不变量断言;③ 一个 Fake LLM 跑通主流程。这三样能在半天内建起来,覆盖大部分真实风险。其余的按需加。