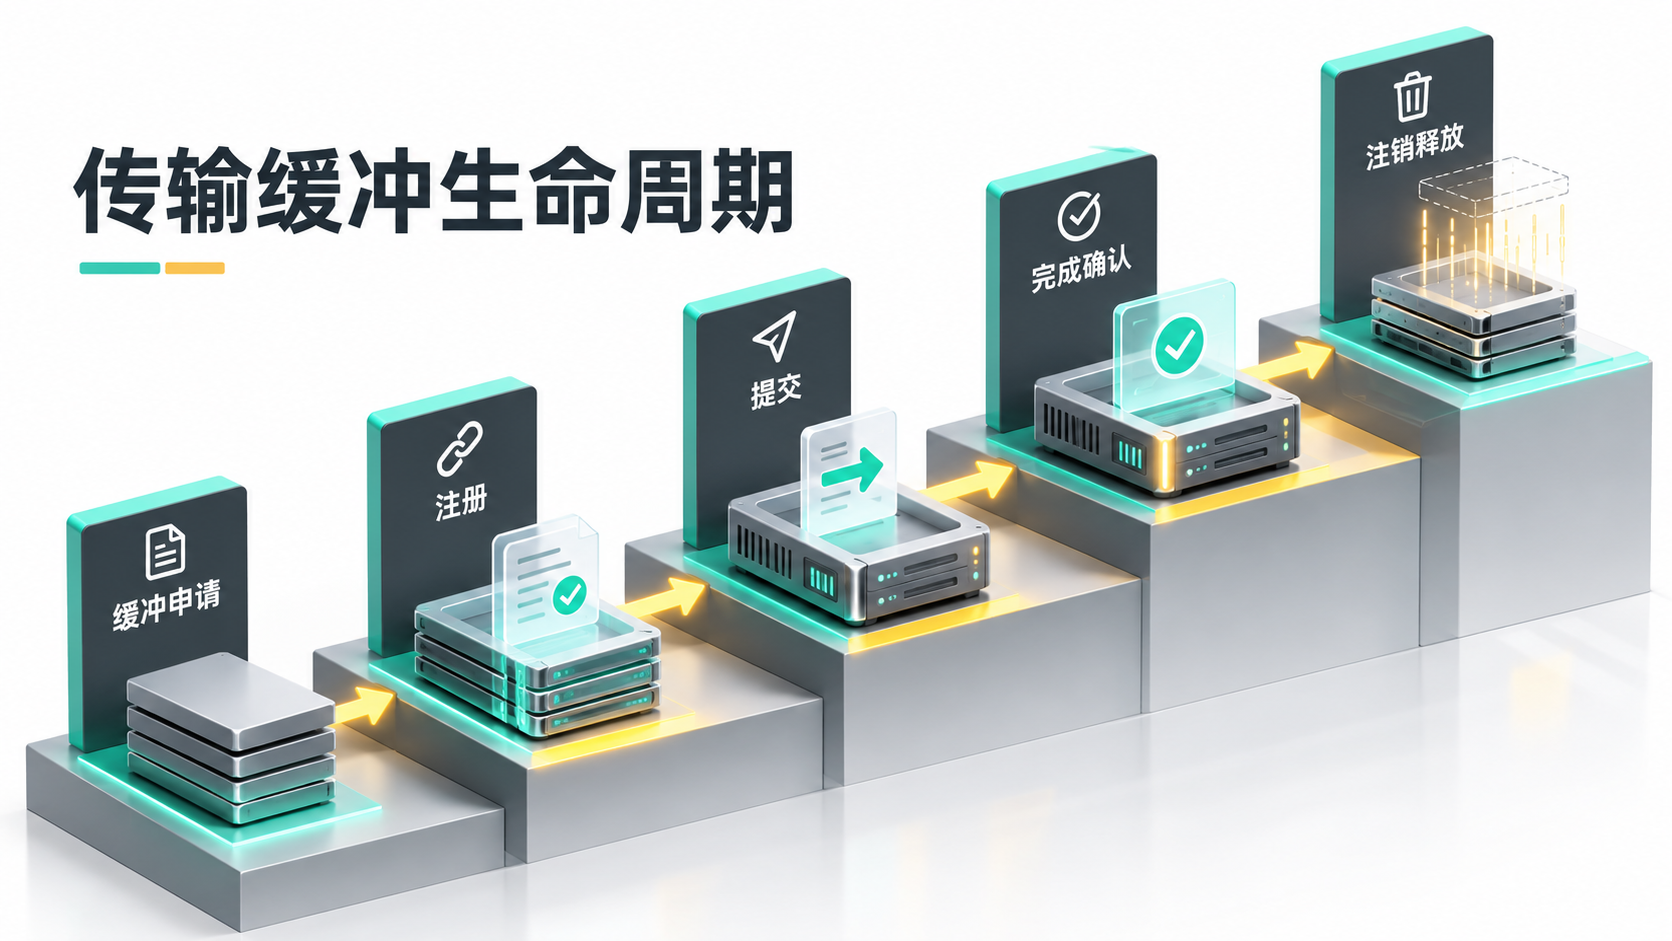
一段代码调用了 ibv_post_send,并不说明它完成了权重传输。队列对、完成队列、内存注册和对端连接若没有建立,后面的轮询甚至没有合法对象可用。教程里省去初始化,再把剩下几行称为生产引擎,会让读者误判完成边界。
NIXL push 传输说明描述了设备内存传输与完成通知的关系。它不是一个可以绕过拓扑、驱动、内存注册与同步规则的“零拷贝”口号。
提交不是完成
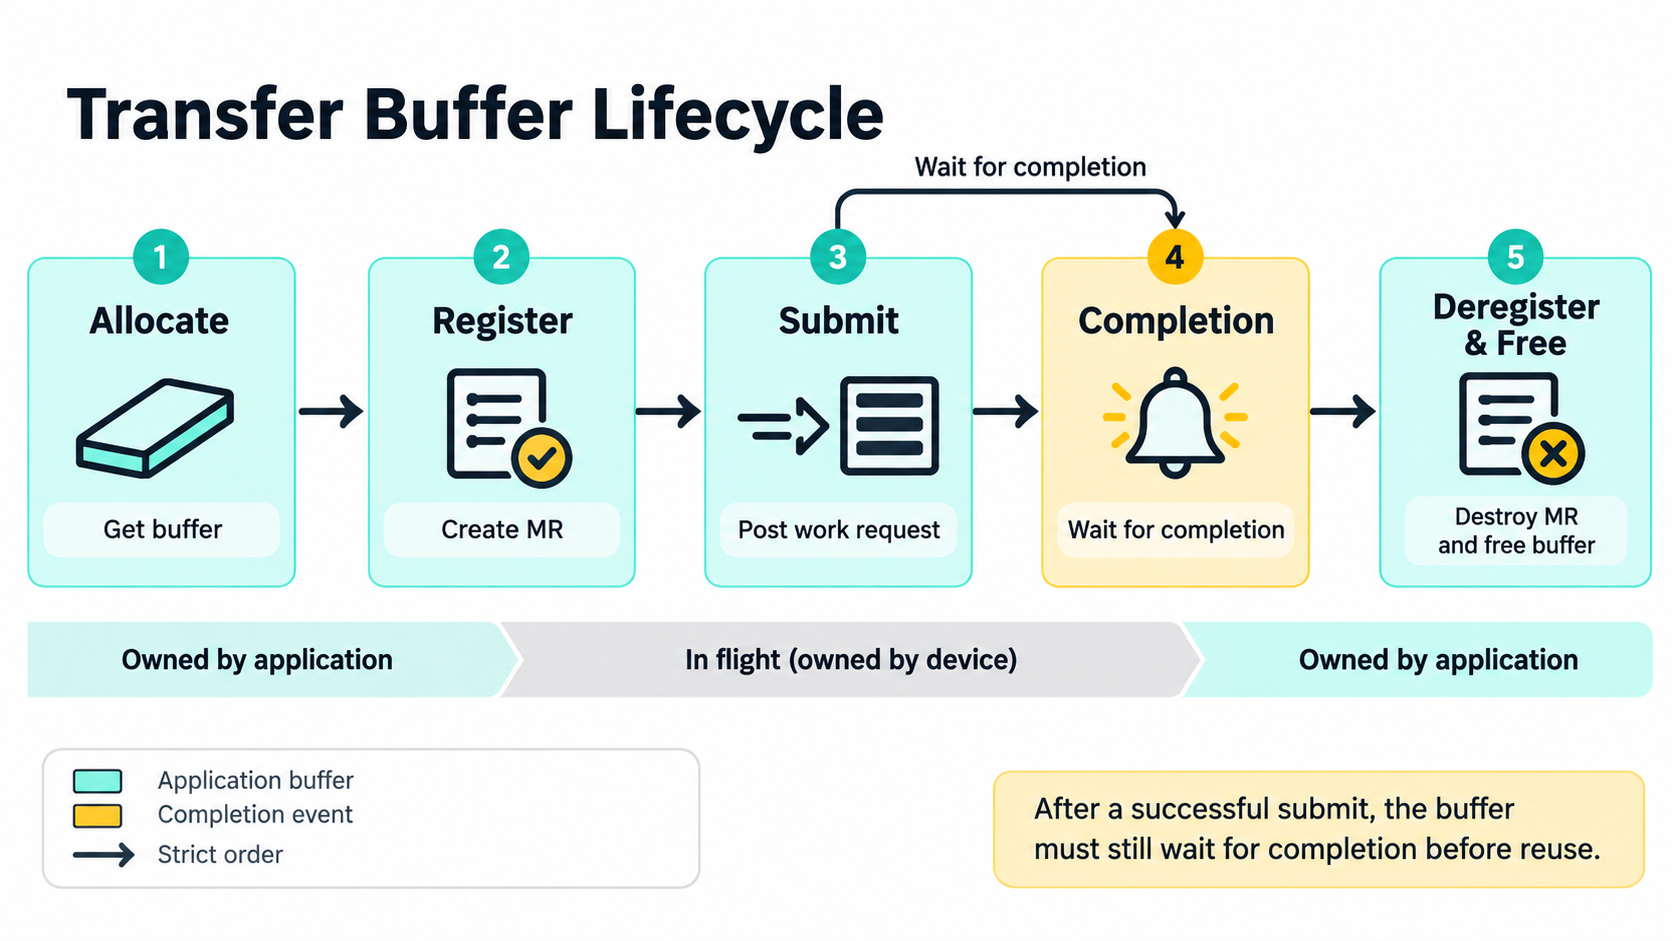
生命周期示意不等于完整 RDMA 程序;提交成功之后仍需等待完成,缓冲才可安全复用。
下面用状态机演示一个关键规则:传输在途时禁止释放缓冲。它不是 RDMA API 的替代实现,也没有执行网络 I/O。
class Buffer:
def __init__(self): self.state = "registered"
def submit(self):
assert self.state == "registered"
self.state = "in_flight"
def complete(self):
assert self.state == "in_flight"
self.state = "completed"
def release(self):
if self.state == "in_flight": raise RuntimeError("transfer not completed")
self.state = "released"
b = Buffer(); b.submit()
try: b.release()
except RuntimeError: print("blocked early release")
b.complete(); b.release()
assert b.state == "released"
print(b.state)
运行输出:
blocked early release
released
真实传输还必须检查 completion 状态、长度、请求身份和错误恢复。发送端的完成与业务接收端是否已经安装好权重,也不能混为一谈;多分片模型需要一致的 revision 与完整提交条件。
把控制路径与数据路径分开
10 月 14 日的NIXL push 传输介绍展示了提前注册目的块、等待两侧就绪再触发传输的方式。性能改善来自依赖重排与后台工作,也不是仅仅把 TCP 换成 RDMA。
对于权重加载,先测总字节数、分片数量、注册成本与持久缓存命中,再检查网络是否位于关键路径。跨 PCIe 根、GPU 与网卡的亲和性可能影响数据路径,但应从目标机器证据判断,不能只凭配置文件上的 annotation 宣称已启用 GDR。
本文只验证 CPU 生命周期规则,未创建 QP/CQ、未注册 GPU 内存、未测 RDMA 或 NIXL。完整程序应以官方示例和匹配版本为起点,在小缓冲校验内容后再扩大模型尺寸。

