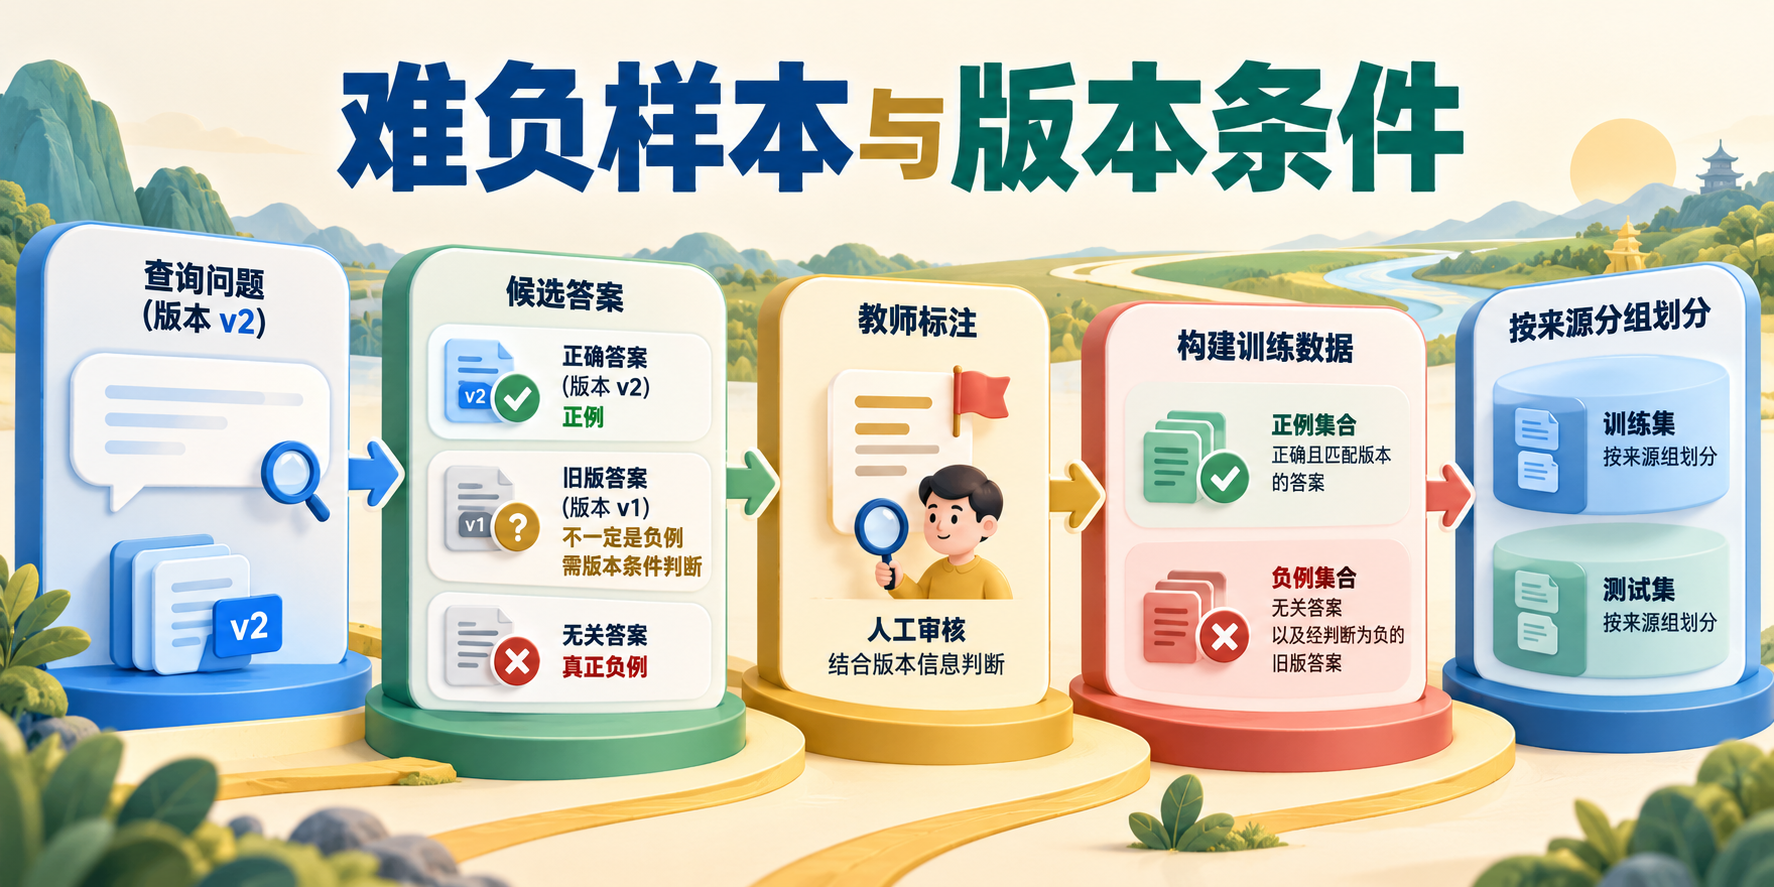
查询问的是“v2 版本里默认超时多久”,v1 手册里写了另一个数。它很适合作为难例,却不该在所有查询里都被贴成负例。用户如果改问“v1 的默认值”,同一段文档立刻变成正确答案。
重排模型需要学习查询与文档之间的条件关系,而不是“旧文档永远错”。BGE 的重排模型卡提供了真实模型的使用入口;训练集构造仍要由业务说明何时相关、何时过期,以及适用的权限和版本。模型卡
难负例先过语境审查
保留与查询版本相符的正例;版本不符的候选可以标成条件负例;缺少版本条件时先标待审。相似度高不等于一定是负例,Teacher 给低分也不能替代事实核对。尤其是多答案问题,另一个正确表述不应被挖成“越难越好”的负例。
分割训练和测试时,按来源文档或实体组拆分,而不是随机拆相邻切片。否则同一条规范在训练里出现正文、测试里出现附录,分数可能很好看,真正的新文档却没有被检验。
让标签生成器先拒绝缺字段
下面只做版本条件与数据划分审计,不训练模型。它不把“只取前三个”当成永远足够的负例集合;训练时若需要固定数量,应明确补齐、跳过还是变长组,而不是硬把张量 reshape 成四列。
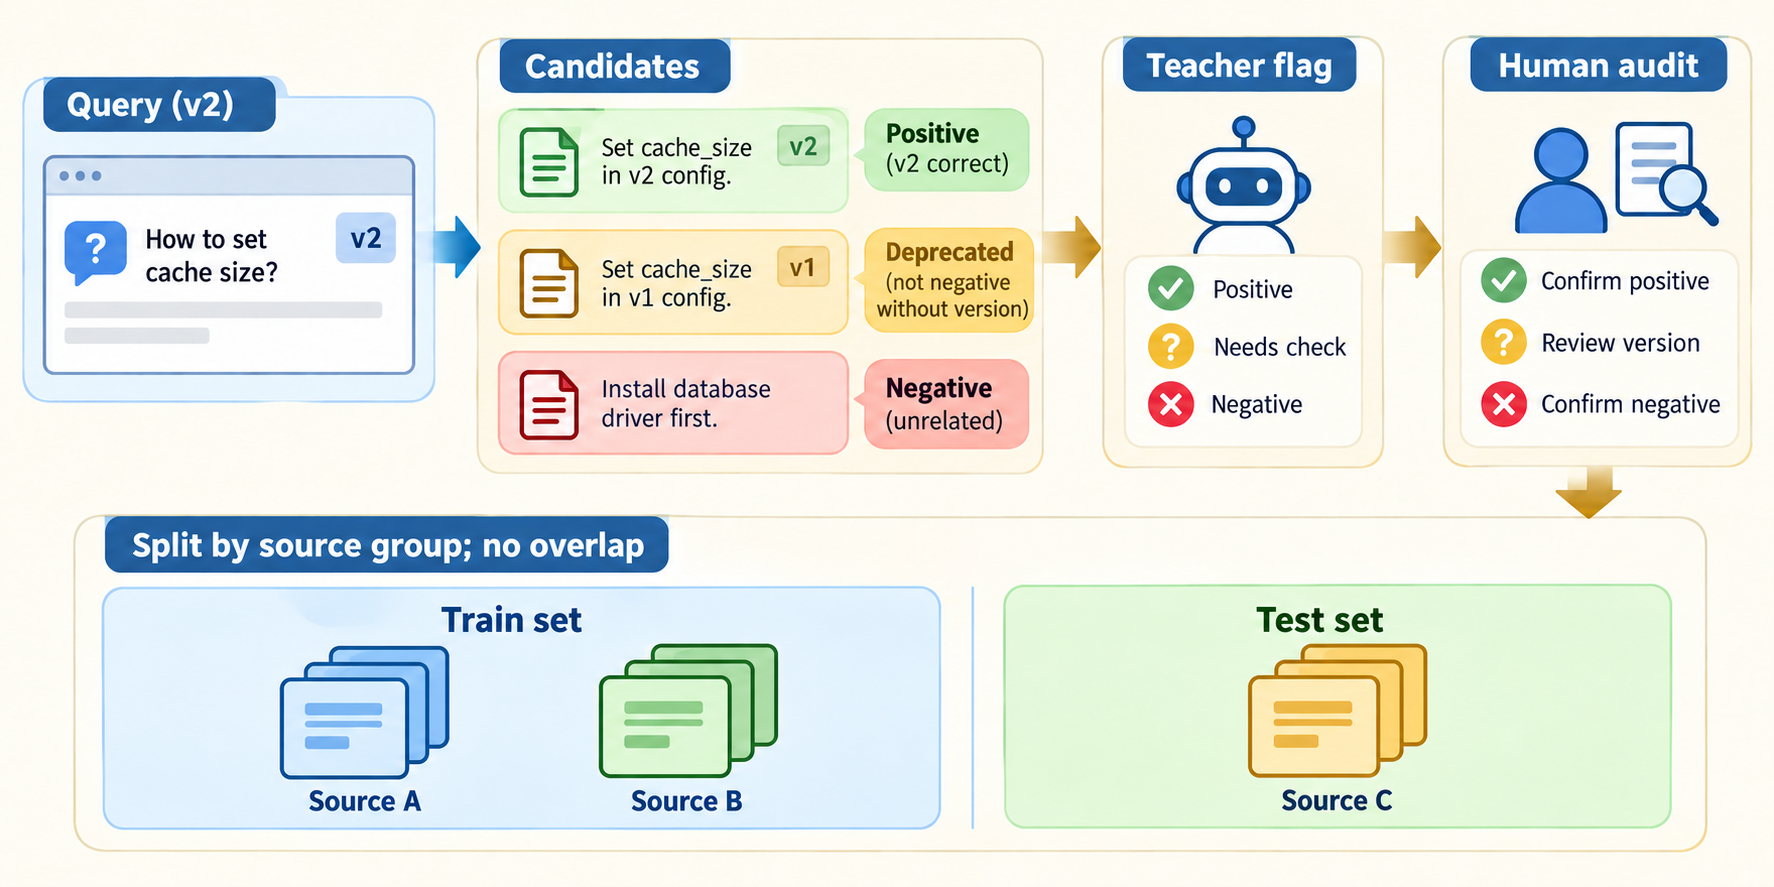
图中的旧版候选需要看查询条件,Teacher 标记只负责进入审查队列。标签不确定时留下待审状态,比强行补齐训练负例更诚实。
def label(query_version, doc_version, fact_matches):
if not fact_matches:
return "negative"
if query_version is None or doc_version is None:
return "review"
return "positive" if query_version == doc_version else "conditional_negative"
def audit_split(train, test):
train_sources = {x["source_group"] for x in train}
test_sources = {x["source_group"] for x in test}
if train_sources & test_sources:
raise ValueError("source leakage")
assert label("v2", "v2", True) == "positive"
assert label("v2", "v1", True) == "conditional_negative"
assert label(None, "v1", True) == "review"
assert label("v1", "v1", True) == "positive"
train = [{"source_group": "manual-A"}]
audit_split(train, [{"source_group": "manual-B"}])
try:
audit_split(train, [{"source_group": "manual-A"}])
except ValueError:
pass
else:
raise AssertionError("leaked source accepted")
print("version-sensitive labels checked; source-group leakage rejected")
例子跑通以后,还要验证什么
这段代码已在本地 macOS、CPython 3.9.6 下运行,实际输出为 version-sensitive labels checked; source-group leakage rejected。它验证的是例子中的数据约束与分支,不包含线上服务的吞吐或延迟测量。
没有下载 BGE 权重、调用 Teacher、使用 GPU 或训练模型。示例不能支持准确率、MRR 或幻觉率改善。真实实验应固定正负例来源、版本判据、训练测试组与模型 revision,人工抽查假负例,并同时检查新任务收益和通用任务退化。
延伸阅读
- BAAI bge-reranker-v2-m3 模型卡:真实重排模型的任务和使用边界,本文没有执行推理。