文章目录
-
- 1. 先把问题讲清楚:LoRA 之后为什么还会显存不够
- 2. QLoRA 的一句话版本
- 3. 先算显存:全参、LoRA、QLoRA到底差在哪里
- 4. 4bit 量化到底在做什么
- 5. 为什么 QLoRA 使用 NF4,而不是普通 int4
- 6. Double Quantization:连 scale 也要省
- 7. Paged Optimizer:解决的是显存峰值,不是权重大小
- 8. 一个最小“伪QLoRA”实验:冻结量化基座,只训练LoRA
- 9. 真实训练配置骨架怎么读
- 10. target_modules 该怎么选
- 11. QLoRA 的训练参数怎么调
- 12. OOM 排查:按这个顺序来
- 13. 什么时候不要用 QLoRA
- 14. 评估:不能只看“训完了”
- 15. 常见误区
- 16. 总结
- 大模型视角
- 下一篇
摘要:QLoRA(Quantized LoRA)解决的是一个很现实的问题:LoRA 已经把“需要训练的参数”降下来了,但基础模型权重本身仍然要占显存。QLoRA 的做法是把冻结的基础模型权重以 4bit 形式加载,只训练 LoRA adapter,从而让开发者在更小显存上完成指令微调。本文会先算清训练显存到底花在哪里,再解释 4bit 量化、NF4、double quantization、paged optimizer 各自解决什么问题,并给出一个可运行的“伪 QLoRA”小实验和一份真实 PEFT 配置骨架,帮助你知道什么时候该用 QLoRA、什么时候不该用。
- 前置知识:专栏二第 49 篇 SFT、第 50 篇 LoRA;专栏一第 18 篇混合精度、第 4 篇矩阵运算
- 阅读时间:45-60 分钟
- 代码环境:Python 3.10+;概念实验使用 PyTorch 2.x;真实训练配置需要 transformers、peft、bitsandbytes
- 读完目标:能解释 QLoRA 为什么省显存,能看懂 load_in_4bit、nf4、double_quant、bnb_4bit_compute_dtype,能按清单排查 QLoRA 训练 OOM
1. 先把问题讲清楚:LoRA 之后为什么还会显存不够
上一篇 LoRA 已经讲过:完整微调会更新大模型的所有权重,而 LoRA 只训练两个低秩矩阵
A
A
A 和
B
B
B:
W
′
=
W
+
α
r
B
A
W' = W + \\frac{\\alpha}{r}BA
W′=W+rαBA
这里
W
W
W 是基础模型原始权重,训练时冻结;
A
A
A 和
B
B
B 是很小的 LoRA adapter,训练时更新。这个设计已经省掉了大量梯度和优化器状态。
但 LoRA 没有解决另一个问题:基础模型权重虽然不训练,仍然要常驻显存。 一个 7B 模型如果用 FP16/BF16 存权重,仅权重本身就大约需要 13GB 左右空间;训练时还要放激活值、LoRA 参数、优化器状态、CUDA 缓存和临时张量。于是你会看到一种常见情况:
模型能加载,推理也能跑;
一开始做 SFT,就 OOM。
QLoRA 的切入点很直接:既然基础权重不更新,能不能用更低精度存起来?这就是 4bit 量化的作用。
2. QLoRA 的一句话版本
QLoRA 可以先理解成:
冻结的 4bit 基础模型 + 可训练的 LoRA adapter + 更高精度的计算通路
更细一点,训练时通常是:
注意一个容易误解的点:QLoRA 不是“整个训练都在 4bit 里算”。4bit 主要是存储格式;实际矩阵计算通常会使用 BF16/FP16/FP32 这类计算 dtype。存储 dtype 和计算 dtype 要分开理解。 
3. 先算显存:全参、LoRA、QLoRA到底差在哪里
训练显存不是一个数字,而是多项开销相加。先用一个粗略估算建立数量级直觉。
对于一个参数量为
N
N
N 的模型,权重存储开销约为:
weight memory
=
N
×
bits
8
\\text{weight memory} = N \\times \\frac{\\text{bits}}{8}
weight memory=N×8bits
这只是权重,不包括激活、梯度、优化器状态和框架缓存。下面用代码估算不同位宽下的权重大小。
# Python 3.10+,无额外依赖
def weight_memory_gb(params_billion, bits_per_param):
params = params_billion * 1_000_000_000
bytes_used = params * bits_per_param / 8
return bytes_used / 1024 ** 3
for params in [7, 13, 34]:
print(f"\\n{params}B 模型权重粗略大小:")
for bits in [16, 8, 4]:
print(f" {bits:2d}bit: {weight_memory_gb(params, bits):6.2f} GB")
你会看到:从 16bit 到 4bit,理论权重存储降为四分之一。对 7B 模型来说,这就是从十几 GB 降到几 GB 的量级。 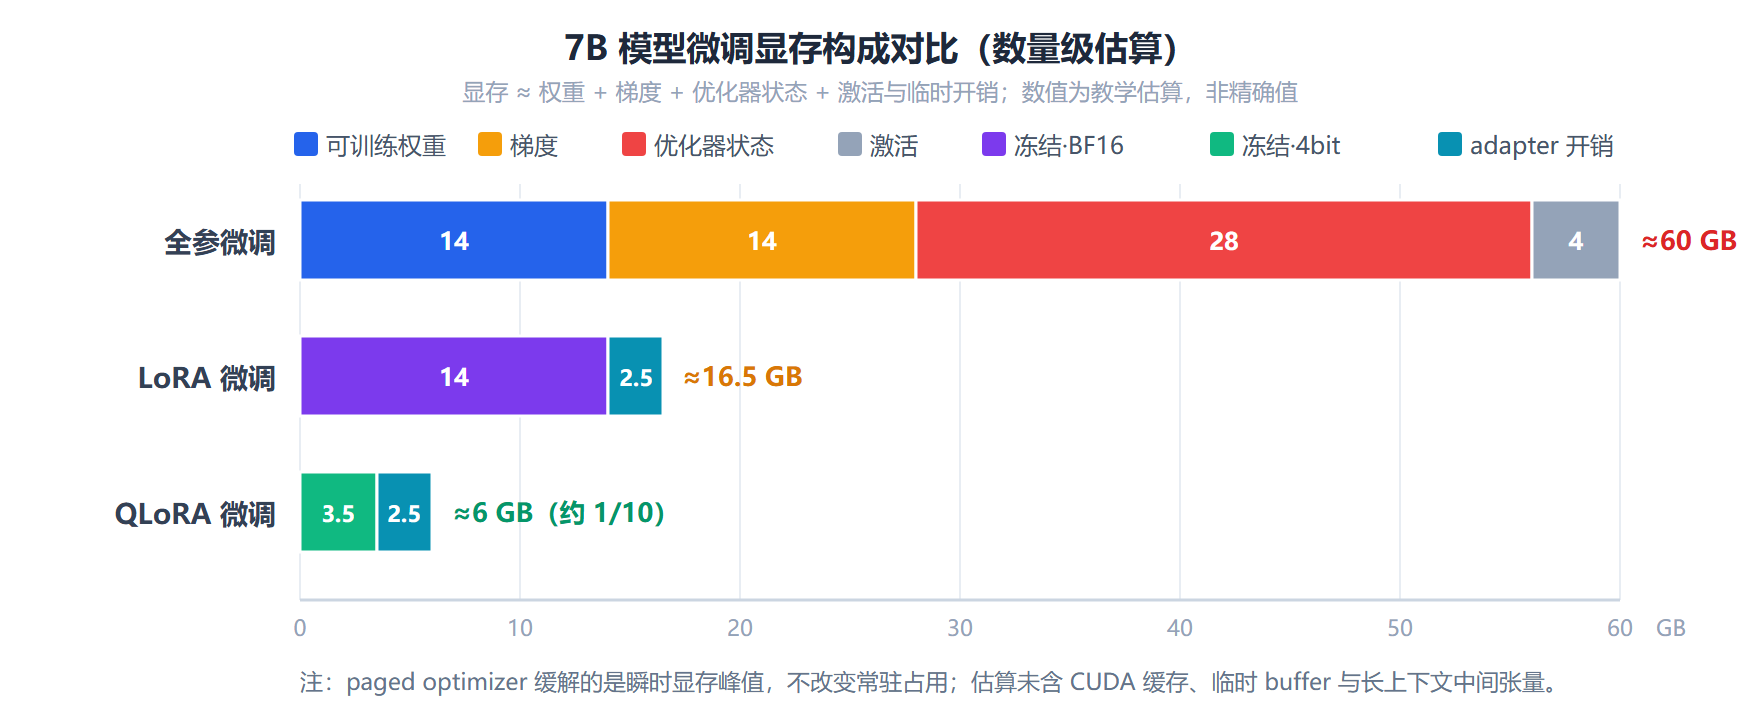
但为什么我一直说“理论”?因为真实 QLoRA 还需要额外保存:
- 量化 scale / zero point / codebook 等元数据;
- LoRA adapter 参数;
- LoRA 的梯度和优化器状态;
- 前向反向所需激活值;
- CUDA kernel 临时 buffer;
- 长上下文带来的额外中间张量。
所以 QLoRA 能显著省显存,但不能让训练显存只等于“4bit 权重文件大小”。
4. 4bit 量化到底在做什么
量化的核心是:用更少的离散值近似原来的连续权重。为了先理解,不急着讲 NF4,我们先看最普通的线性 4bit 量化。
假设一组权重在区间
[
w
m
i
n
,
w
m
a
x
]
[w_{min}, w_{max}]
[wmin,wmax] 内。4bit 一共能表示 16 个等级。我们可以把连续权重映射到 0 到 15 的整数,再反量化回近似浮点数。
公式可以写成:
q
=
round
(
w
−
w
m
i
n
s
)
q = \\text{round}\\left(\\frac{w – w_{min}}{s}\\right)
q=round(sw−wmin)
w
^
=
q
⋅
s
+
w
m
i
n
\\hat{w} = q \\cdot s + w_{min}
w^=q⋅s+wmin
其中
s
s
s 是量化步长:
s
=
w
m
a
x
−
w
m
i
n
15
s = \\frac{w_{max} – w_{min}}{15}
s=15wmax−wmin
大白话解释:把原来的数轴切成 15 个间隔,每个权重找到离自己最近的刻度。反量化后得到的
w
^
\\hat{w}
w^ 和原始
w
w
w 会有误差,这个误差就是量化损失。
下面写一个最小量化/反量化实验:
# Python 3.10+ / torch >= 2.0
import torch
def quantize_4bit_linear(w):
w_min = w.min()
w_max = w.max()
scale = (w_max – w_min) / 15
q = torch.round((w – w_min) / scale).clamp(0, 15).to(torch.uint8)
w_hat = q.float() * scale + w_min
return q, w_hat, scale
torch.manual_seed(0)
w = torch.randn(1024)
q, w_hat, scale = quantize_4bit_linear(w)
mse = torch.mean((w – w_hat) ** 2).item()
print("原始权重前5个:", w[:5])
print("反量化前5个:", w_hat[:5])
print("量化MSE:", mse)
print("4bit整数前5个:", q[:5])
这段代码不是 QLoRA 的真实 NF4 实现,但它能帮你看懂量化的基本逻辑:低 bit 存储会节省空间,同时引入近似误差。
5. 为什么 QLoRA 使用 NF4,而不是普通 int4
普通线性 int4 的刻度是均匀的:每个等级之间距离相同。但神经网络权重通常不是均匀分布,很多权重集中在 0 附近,极端大值较少。
NF4(NormalFloat 4-bit)的想法是:既然预训练权重常常接近正态分布,就用更适合正态分布的 4bit 表示点。这样 16 个可表示值不会均匀撒在数轴上,而是更照顾常见权重所在的区域。
可以用一个直觉对比:
普通 int4:尺子刻度均匀,0附近和极端值附近一样稀疏。
NF4:刻度按权重分布设计,常见区域更精细,少见区域更粗。
为什么这有用?因为如果大量权重集中在 0 附近,那在 0 附近提供更合适的表示点,整体量化误差可能更小。 
这里要注意事实边界:NF4 的具体码本和实现细节由 bitsandbytes 等库处理,写业务代码时通常不需要手写 NF4。你需要知道的是:
- bnb_4bit_quant_type="nf4" 表示使用 NF4 量化类型;
- NF4 主要服务于冻结基础权重的低误差存储;
- 它不能保证没有质量损失,最终仍要评估。
6. Double Quantization:连 scale 也要省
量化不只保存 4bit 权重,还要保存反量化所需的 scale 等元数据。为了降低误差,量化通常按 block 分组:每一小块权重有自己的 scale。
假设每 64 个权重一组,每组保存一个 16bit scale。对于大模型,这些 scale 加起来也会占空间。Double quantization 的思路是:再把这些 scale 也量化一次,减少元数据开销。
我们用代码算一个简单账。下面不追求和真实实现逐字节一致,只看量级关系。
# Python 3.10+,无额外依赖
def quant_metadata_mb(num_params, group_size=64, scale_bits=16):
groups = (num_params + group_size – 1) // group_size
bytes_used = groups * scale_bits / 8
return bytes_used / 1024 ** 2
params = 7_000_000_000
for group in [32, 64, 128]:
mb = quant_metadata_mb(params, group_size=group, scale_bits=16)
print(f"group={group:3d}, 16bit scale 元数据约 {mb:8.1f} MB")
你会发现:即使每组只存一个 scale,大模型上也不是完全可以忽略。Double quantization 的价值就在于进一步压缩这些量化元数据,让 4bit 方案更接近理论节省。
7. Paged Optimizer:解决的是显存峰值,不是权重大小
训练时显存不是平滑曲线。某些 step 会因为长样本、激活、临时 buffer、优化器状态访问而出现峰值。Paged optimizer 试图通过分页管理优化器状态,缓解突然的显存峰值。
它解决的问题更像是:
平时显存够,但某些 batch 或某些更新时刻突然 OOM。
不是:
模型基础权重太大,根本加载不进去。
所以排查 OOM 时不要把 paged optimizer 当万能药。如果是 max_seq_length 太长、micro batch 太大、没有开启 4bit 加载,paged optimizer 也救不了根本问题。
8. 一个最小“伪QLoRA”实验:冻结量化基座,只训练LoRA
真实 QLoRA 依赖 bitsandbytes 的 4bit kernel。为了让你不安装复杂依赖也能理解机制,我们写一个教学版实验:
- 先生成一个基础线性层权重
W
W
W; - 把
W
W
W 做 4bit 伪量化并冻结; - 额外训练 LoRA 矩阵
A
A
A 和B
B
B; - 让 LoRA 学习一个目标增量,观察 loss 是否下降。
这不是生产级 QLoRA,只是机制演示。
# Python 3.10+ / torch >= 2.0
import torch
import torch.nn as nn
import torch.optim as optim
class FakeQuantLinear(nn.Module):
def __init__(self, weight):
super().__init__()
q, w_hat, _ = quantize_4bit_linear(weight)
# 教学版:直接保存反量化后的近似权重,并冻结
self.register_buffer("weight", w_hat)
self.register_buffer("qweight", q)
def forward(self, x):
return x @ self.weight.t()
class QLoRALinearToy(nn.Module):
def __init__(self, base_weight, r=4, alpha=8):
super().__init__()
self.base = FakeQuantLinear(base_weight)
self.r = r
self.scale = alpha / r
d_out, d_in = base_weight.shape
self.A = nn.Parameter(torch.randn(r, d_in) * 0.01)
self.B = nn.Parameter(torch.zeros(d_out, r))
def forward(self, x):
base_out = self.base(x)
lora_out = (x @ self.A.t() @ self.B.t()) * self.scale
return base_out + lora_out
torch.manual_seed(42)
d_in, d_out = 32, 16
base_w = torch.randn(d_out, d_in) * 0.2
true_delta = torch.randn(d_out, d_in) * 0.03
true_w = base_w + true_delta
x = torch.randn(512, d_in)
y = x @ true_w.t()
model = QLoRALinearToy(base_w, r=4, alpha=8)
opt = optim.AdamW([model.A, model.B], lr=5e-2)
for step in range(101):
pred = model(x)
loss = ((pred – y) ** 2).mean()
opt.zero_grad()
loss.backward()
opt.step()
if step % 20 == 0:
print(step, float(loss))
print("base weight requires_grad:", model.base.weight.requires_grad)
print("A requires_grad:", model.A.requires_grad)
print("B requires_grad:", model.B.requires_grad)
这个实验应该看到 loss 逐步下降,同时基础权重不参与梯度更新。它说明 QLoRA 的训练直觉:量化基座提供原模型能力,LoRA 分支学习任务所需的补偿。
这里也能看出 QLoRA 的边界:如果 4bit 量化误差太大,或者任务需要的变化不是低秩 adapter 能表达的,训练效果就会受限。
9. 真实训练配置骨架怎么读
真实项目里,你通常不会手写 QLoRA 层,而是用 transformers + bitsandbytes + peft。下面是一份配置骨架,用来说明关键参数。它不是完整训练脚本,但足够帮助你读懂项目配置。
# Python 3.10+
# pip install transformers peft bitsandbytes accelerate
import torch
from transformers import AutoModelForCausalLM, BitsAndBytesConfig
from peft import LoraConfig, get_peft_model, prepare_model_for_kbit_training
model_name = "your-base-model"
bnb_config = BitsAndBytesConfig(
load_in_4bit=True,
bnb_4bit_quant_type="nf4",
bnb_4bit_use_double_quant=True,
bnb_4bit_compute_dtype=torch.bfloat16,
)
model = AutoModelForCausalLM.from_pretrained(
model_name,
quantization_config=bnb_config,
device_map="auto",
)
model = prepare_model_for_kbit_training(model)
lora_config = LoraConfig(
r=16,
lora_alpha=32,
lora_dropout=0.05,
target_modules=["q_proj", "k_proj", "v_proj", "o_proj", "gate_proj", "up_proj", "down_proj"],
task_type="CAUSAL_LM",
)
model = get_peft_model(model, lora_config)
model.print_trainable_parameters()
逐项解释关键参数:
- load_in_4bit=True:以 4bit 形式加载基础权重;
- bnb_4bit_quant_type="nf4":使用 NF4 量化类型;
- bnb_4bit_use_double_quant=True:开启 double quantization,进一步压缩量化元数据;
- bnb_4bit_compute_dtype=torch.bfloat16:矩阵计算使用 BF16;如果硬件不支持 BF16,可能需要 FP16;
- prepare_model_for_kbit_training:为 k-bit 训练做必要准备,例如处理某些层的 dtype 和梯度;
- r:LoRA rank,控制 adapter 容量;
- lora_alpha:LoRA 缩放强度;
- lora_dropout:LoRA 分支 dropout,小数据时可缓解过拟合;
- target_modules:在哪些线性层上加 LoRA。不同模型命名不同,必须按模型结构检查。
如果你只记住一件事,就是:QLoRA 省显存主要靠 4bit 冻结基座;任务适配能力主要靠 LoRA 的 target modules、rank、数据质量和训练配置。
10. target_modules 该怎么选
很多教程会直接写:
target_modules=["q_proj", "v_proj"]
这能跑,但不一定最好。不同选择代表不同取舍:
| q_proj, v_proj | 常见轻量配置,主要影响注意力读写 | 低 |
| q_proj, k_proj, v_proj, o_proj | 更完整影响注意力模块 | 中 |
| 再加 gate_proj, up_proj, down_proj | 同时适配 FFN,表达能力更强 | 更高 |
| embedding / lm_head | 特殊任务可能有用,但风险和成本更高 | 视情况 |
选择时不要只看别人配置。建议顺序是:
11. QLoRA 的训练参数怎么调
一个稳妥的起点:
{
"max_seq_length": 2048,
"per_device_train_batch_size": 1,
"gradient_accumulation_steps": 16,
"learning_rate": 0.0002,
"num_train_epochs": 1,
"warmup_ratio": 0.03,
"lr_scheduler_type": "cosine",
"gradient_checkpointing": true,
"optim": "paged_adamw_8bit",
"bf16": true,
"logging_steps": 10,
"save_steps": 200,
"eval_steps": 200
}
这些不是通用最优值,只是起点。调参时优先关注:
- 数据量小:减少 epoch,增加 dropout,避免 rank 太大;
- 格式任务:重点看格式合法率,不只看 loss;
- 长文本任务:逐步增加 max_seq_length,不要一开始拉满;
- 显存紧张:先降 max_seq_length 和 micro batch,再考虑降 rank;
- 训练不稳定:检查学习率、warmup、异常样本和 mixed precision。
12. OOM 排查:按这个顺序来
QLoRA OOM 最容易让人误判。很多人第一反应是“4bit 不是很省显存吗?”但 OOM 往往不是权重本身,而是激活值或配置。
建议按下面顺序排查:
1. 确认真的 load_in_4bit=True,而不是只设置了 LoRA。
2. 打印 trainable parameters,确认没有意外训练全参数。
3. 降低 max_seq_length,例如 4096 -> 2048 -> 1024。
4. 把 per_device_train_batch_size 降到 1。
5. 用 gradient_accumulation_steps 保持全局 batch。
6. 开启 gradient_checkpointing。
7. 减少 target_modules,先只训 attention 投影。
8. 降低 LoRA rank,例如 64 -> 32 -> 16 -> 8。
9. 检查数据里是否有超长样本没有截断。
10. 检查评估和保存时是否临时占用额外显存。
经验上,max_seq_length 和 micro batch 是最常见的 OOM 来源。长上下文 SFT 即使使用 QLoRA,也会因为激活值变大而吃显存。
13. 什么时候不要用 QLoRA
QLoRA 是低显存利器,但不是默认最优。
不建议优先用 QLoRA 的情况:
- 你有足够显存,BF16 LoRA 更简单、更快、更少兼容问题;
- 任务对数值精度非常敏感,4bit 量化损失不可接受;
- 训练速度比显存更重要,而当前 4bit kernel 在你的硬件上不快;
- 你需要全参数微调或深度持续预训练;
- 部署环境不支持对应量化格式;
- 你的主要问题其实是数据质量差,而不是显存不够。
选择 QLoRA 的合理理由应该是:显存是主要瓶颈,并且 LoRA 级别的任务适配足够满足需求。
14. 评估:不能只看“训完了”
QLoRA 训练后至少要比较四个版本:
base model
base model + prompt/RAG
LoRA/QLoRA adapter
旧线上模型或旧 adapter
评估指标包括:
- 目标任务准确率;
- 格式合法率;
- 长文本稳定性;
- 幻觉和无证据拒答;
- 通用能力回归;
- 推理延迟和显存;
- 量化后是否出现重复、乱码、退化。
特别注意:QLoRA 训练阶段用了 4bit,不代表部署时一定也用同样方式。你可以保存 adapter,在推理时选择 4bit base + adapter,也可以在条件允许时合并到更高精度 base 上评估。部署方案也要重新测。
15. 常见误区
误区一:QLoRA 等于 LoRA 加一个参数。 不只是参数。它涉及 4bit 加载、量化类型、计算 dtype、double quantization、paged optimizer 和 k-bit training 准备。
误区二:4bit 训练一定和 BF16 一样好。 4bit 是近似存储,会带来量化误差。很多任务表现很好,但不能不评估。
误区三:显存只看模型权重大小。 SFT 的激活值、序列长度、batch、梯度检查点和临时 buffer 都会影响显存。
误区四:rank 越大越安全。 rank 大会增加参数、显存和过拟合风险。小数据任务常常不需要很大 rank。
误区五:adapter 可以随便换基座。 QLoRA/LoRA adapter 必须匹配同一个基础模型、结构、tokenizer 和 target modules。
16. 总结
QLoRA 的核心价值,是把冻结基础模型权重压到 4bit 存储,同时只训练 LoRA adapter,让较小显存也能完成大模型 SFT。它的关键组件分别解决不同问题:NF4 降低 4bit 权重量化误差,double quantization 压缩量化元数据,paged optimizer 缓解优化器状态带来的显存峰值,LoRA adapter 承担任务适配。
但 QLoRA 不是免费的能力提升。它用量化误差和实现复杂度换显存空间。真正做项目时,应先确认显存瓶颈,再控制 max_seq_length、batch、rank 和 target modules,用独立评估集验证质量。能用 BF16 LoRA 稳定解决的问题,不必强行 QLoRA;显存受限但任务适配明确时,QLoRA 是非常实用的方案。
大模型视角
从大模型工程角度看,QLoRA 体现了一个重要原则:训练成本不只取决于可训练参数量,也取决于冻结权重的存储方式和训练过程的中间状态。 LoRA 解决“训练哪些参数”,QLoRA 进一步解决“冻结参数怎么更便宜地放进显存”。理解这两个层次,你就能更准确地评估微调方案,而不是只看教程里说“单卡可训”。
下一篇
下一篇会讲 DoRA、LoRA+、AdaLoRA、IA3 等 LoRA 变体。学完 QLoRA 后再看这些方法,要重点问:它们是在降低显存、提高表达能力、改善优化速度,还是更细地分配 adapter 容量?不同目标对应不同选择。