天赐范式 ·第213天 第一篇:换四把尺子,往对走的回报检出不稳健
——4 把预注册适应度尺子 × ρ 五档 × κ=0.50 × 四组 × 5 seed(关键档扩 20)
摘要
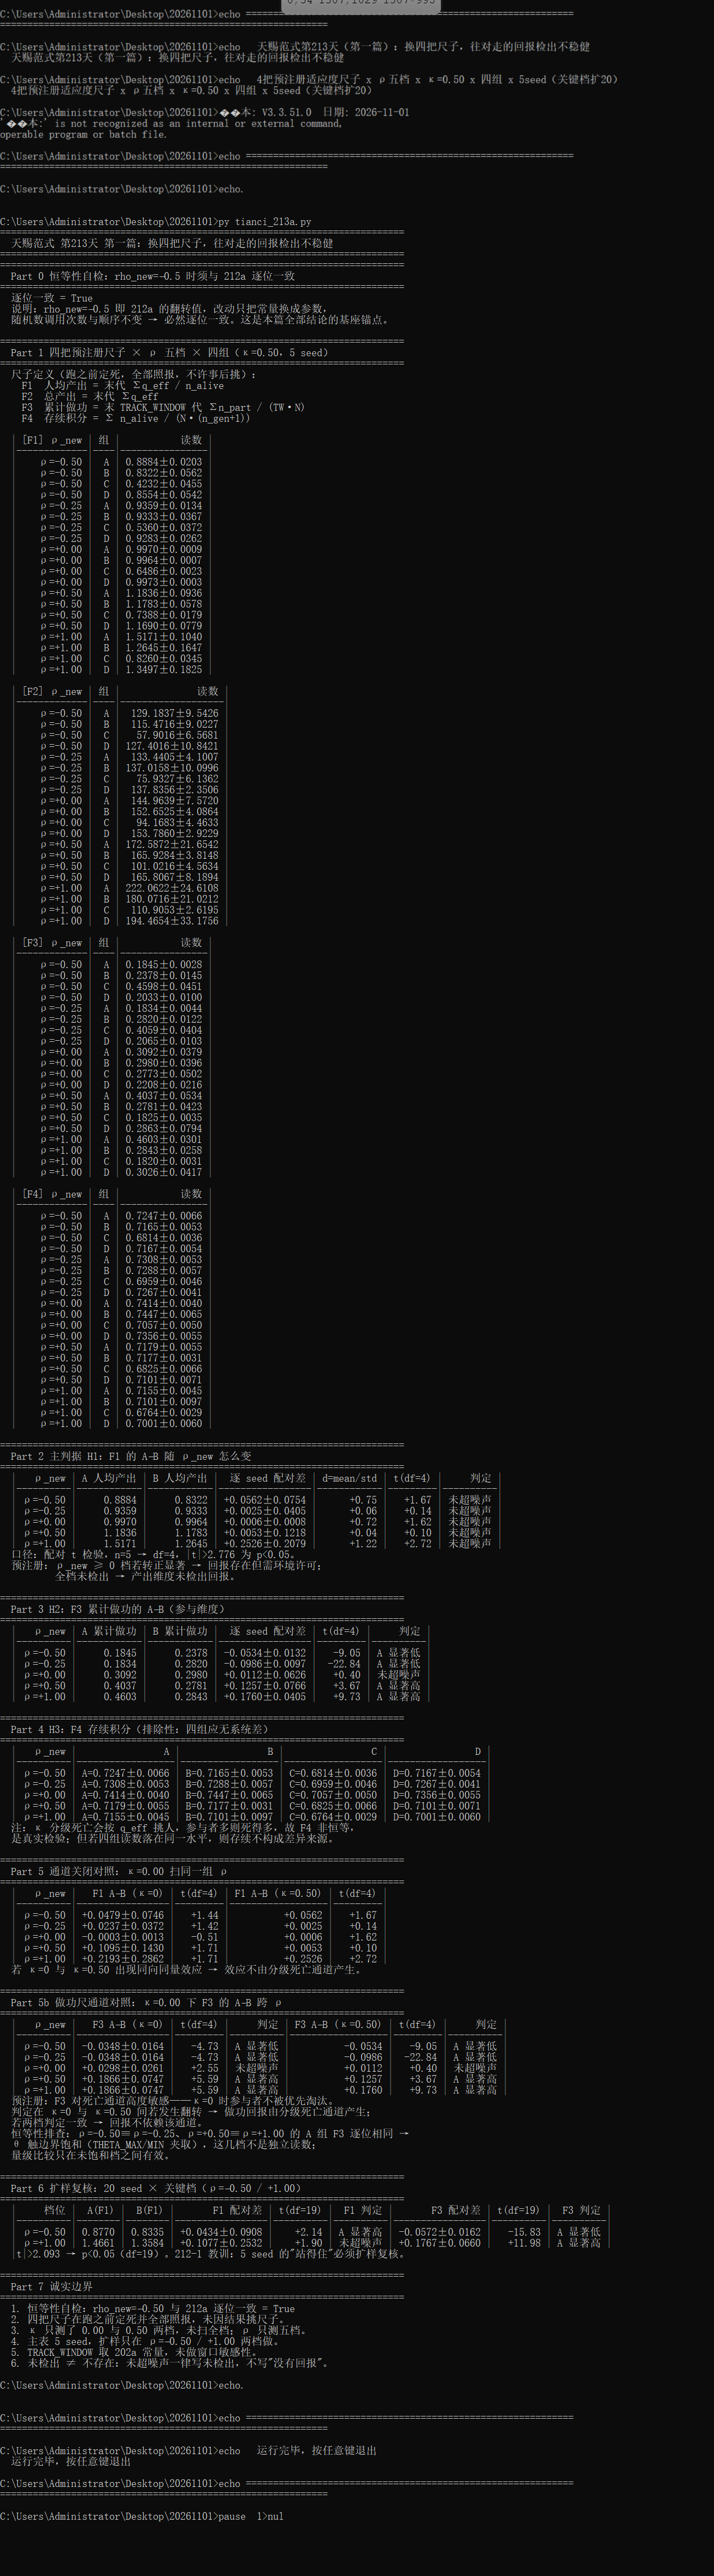
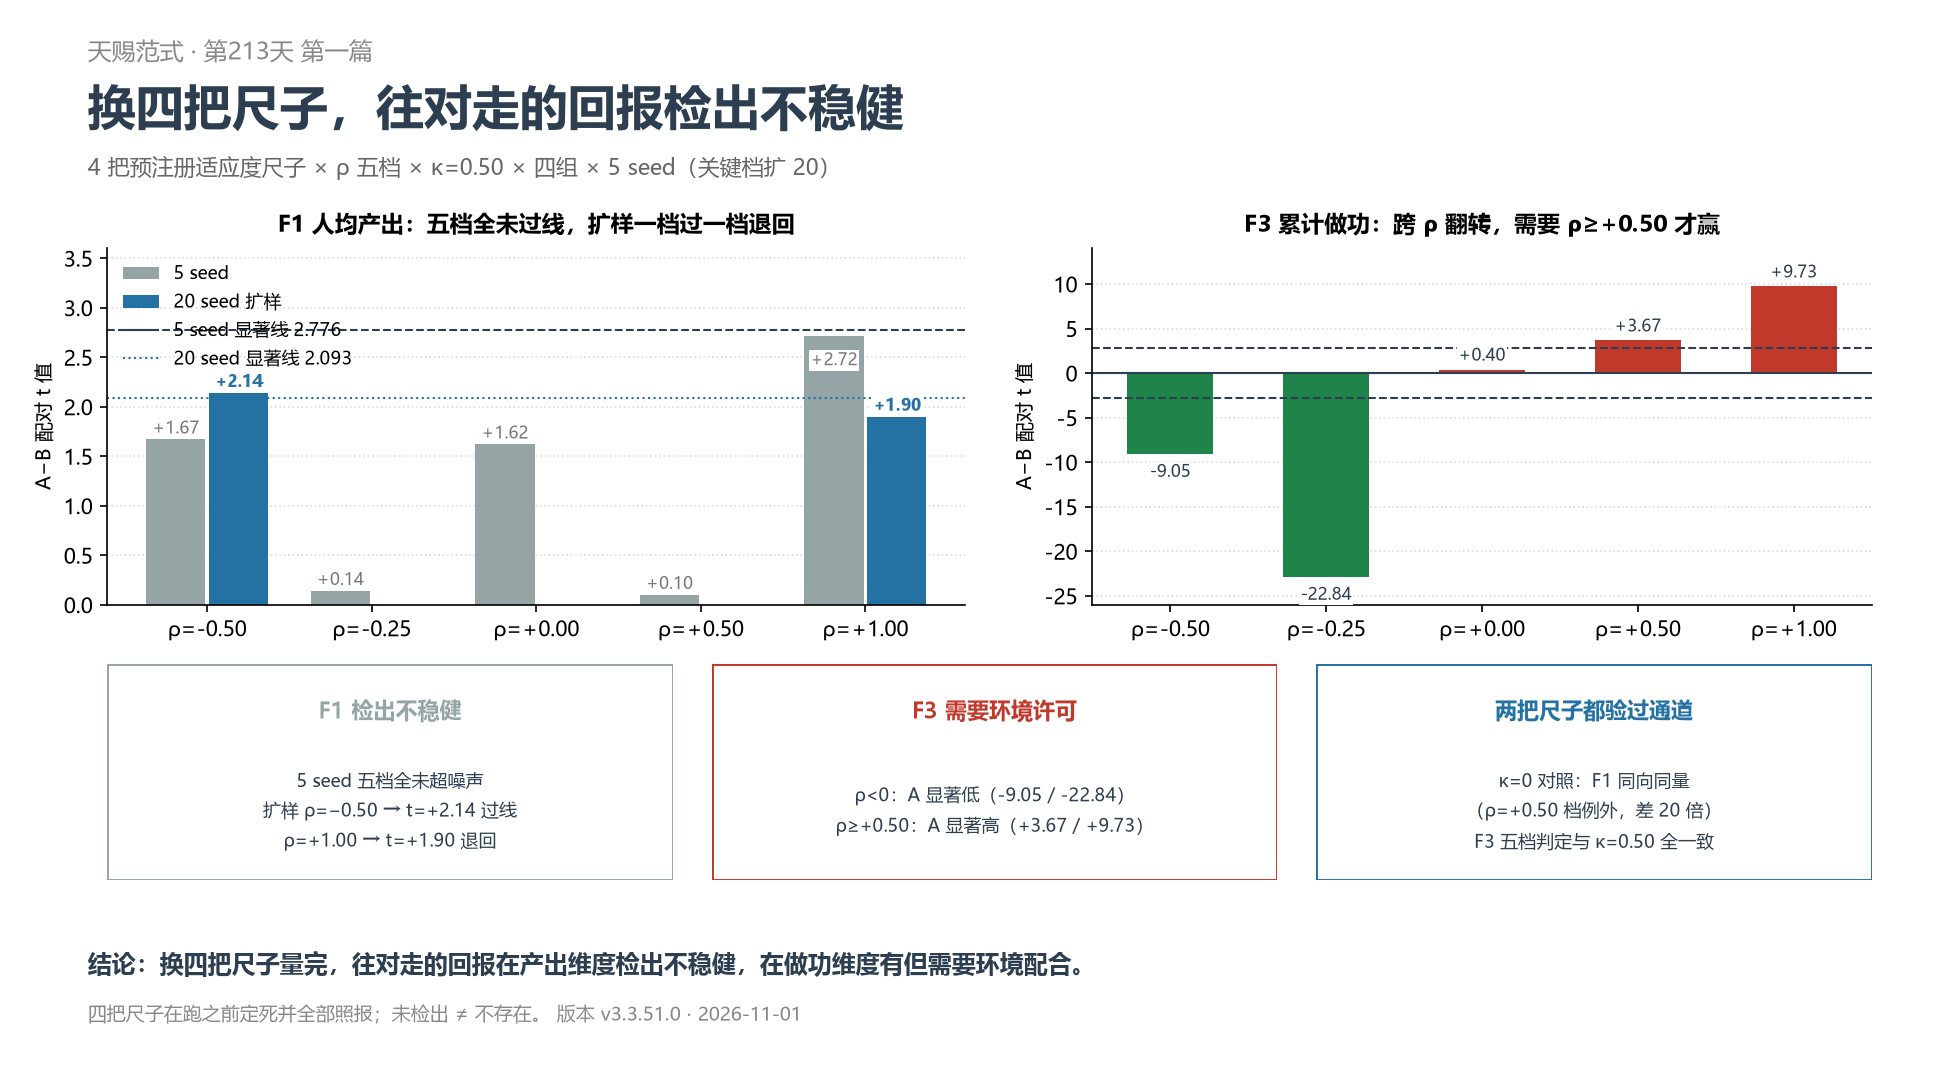
212-1 把"往对走没回报"的根因定位到尺子 + 环境:人均 q_eff ≈ q̄_base·(1 − 0.5·参与率),残差 ≤ 0.0004,A−B 的差几乎全由参与率差解释。今天把这两件事同时变成变量:四把预注册适应度尺子(F1 人均产出 / F2 总产出 / F3 累计做功 / F4 存续积分)× ρ 五档(−0.50 到 +1.00)。F1 人均产出全档未检出:5 seed 下五档 ρ 的 A−B 全部未超噪声(t 从 +0.14 到 +2.72);扩到 20 seed 后,ρ=−0.50 转为 A 显著高(t=+2.14),ρ=+1.00 仍未超噪声(t=+1.90)。F3 累计做功则跨 ρ 翻转:ρ<0 时 A 显著低(t=−9.05 / −22.84),ρ=0 未检出(t=+0.40),ρ≥0.50 时 A 显著高(t=+3.67 / +9.73);通道关闭对照(κ=0)下五档判定不变,回报不依赖分级死亡通道。结论:产出维度上 θ 演化的回报检出不稳健——5 seed 全档未超噪声,扩到 20 seed 后 ρ=−0.50 转显著(t=+2.14)但 ρ=+1.00 退回未超噪声(t=+1.90),方向不一致;做功维度上演化组在许可环境下赢,但这个回报需要环境配合。ρ=0 是好的零点校准:F1 与 F3 的 A−B 都在零附近。
§一 问题
212-1 接通了适应度→存活通道(κ 分级死亡),但"往对走"仍未检出回报。它把根因定位到尺子 + 环境:
人均 q_eff ≈ q̄_base·(1 − 0.5·参与率),残差 ≤ 0.0004
A−B 的差几乎全部由参与率差解释。ρ=−0.5 下参与被罚(q_eff = q_base·0.5),"少参与"在人均产出这把尺子上赢。但这是一把尺子在一个环境下的读数——换一把尺子、换一个环境,还会不会赢?
今天把两件事同时变成变量:四把预注册适应度尺子 × ρ 五档。尺子在跑之前定死,全部照报,禁止事后挑能赢的。
§二 预注册假设
四把尺子(跑之前定死,全部照报):
| F1 | 人均产出 | 末代 Σq_eff / n_alive | 效率尺(212-1 用的那把) |
| F2 | 总产出 | 末代 Σq_eff | 规模尺 |
| F3 | 累计做功 | 末 TRACK_WINDOW 代 Σn_part / (TW·N) | 做功尺 |
| F4 | 存续积分 | Σ n_alive / (N·(n_gen+1)) | 存续尺 |
ρ 五档:RHO_SCAN = [−0.50, −0.25, 0.00, +0.50, +1.00],翻转前恒 +1.0,第 50 代翻到 rho_new。
四组沿用 212a:A(normal, inherit=True) / B(normal, inherit=False) / C(anti) / D(neutral)。κ=0.50 为主表,κ=0.00 作通道关闭对照。
预注册四条:
- H1(主判据):F1 的 A−B 随 ρ_new 由负/未检出转为正显著。ρ≥0 档转正显著 → “回报存在但需环境许可”;全档未检出 → 产出维度阴性。预注册只设了这两种结局;实际为第三种(负档显著、正档不显著),见 §十。
- H2:F3(做功维度)A > B 是否跨 ρ 一致成立。
- H3(排除性):F4 存续积分四组无系统差。
- H4(对照):κ=0 档扫同一组 ρ,与 κ=0.50 并排。若通道关闭时出现同向同量效应 → 该效应不由分级死亡通道产生。
统计口径:配对设计用逐 seed 配对差 std,n=5 → df=4,|t|>2.776 为 p<0.05。扩样用 20 seed,df=19,|t|>2.093。
§三 恒等性自检
rho_new=−0.50 与 212a 逐位比对(p_total / n_alive / n_part,151 代全序列,四组 × 5 seed × κ=0.00 与 0.50):PASS。
改动只把 212a 的翻转常量换成参数(rho_new),随机数调用次数与顺序不变 → 必然逐位一致。这是本篇全部结论的基座锚点。
§四 四把尺子主表(κ=0.50,5 seed)
F1 人均产出
| −0.50 | 0.8884±0.0203 | 0.8322±0.0562 | 0.4232±0.0455 | 0.8554±0.0542 |
| −0.25 | 0.9359±0.0134 | 0.9333±0.0367 | 0.5360±0.0372 | 0.9283±0.0262 |
| +0.00 | 0.9970±0.0009 | 0.9964±0.0007 | 0.6486±0.0023 | 0.9973±0.0003 |
| +0.50 | 1.1836±0.0936 | 1.1783±0.0578 | 0.7388±0.0179 | 1.1690±0.0779 |
| +1.00 | 1.5171±0.1040 | 1.2645±0.1647 | 0.8260±0.0345 | 1.3497±0.1825 |
F2 总产出
| −0.50 | 129.18±9.54 | 115.47±9.02 | 57.90±6.57 | 127.40±10.84 |
| −0.25 | 133.44±4.10 | 137.02±10.10 | 75.93±6.14 | 137.84±2.35 |
| +0.00 | 144.96±7.57 | 152.65±4.09 | 94.17±4.46 | 153.79±2.92 |
| +0.50 | 172.59±21.65 | 165.93±3.81 | 101.02±4.56 | 165.81±8.19 |
| +1.00 | 222.06±24.61 | 180.07±21.02 | 110.91±2.62 | 194.47±33.18 |
F3 累计做功
| −0.50 | 0.1845±0.0028 | 0.2378±0.0145 | 0.4598±0.0451 | 0.2033±0.0100 |
| −0.25 | 0.1834±0.0044 | 0.2820±0.0122 | 0.4059±0.0404 | 0.2065±0.0103 |
| +0.00 | 0.3092±0.0379 | 0.2980±0.0396 | 0.2773±0.0502 | 0.2208±0.0216 |
| +0.50 | 0.4037±0.0534 | 0.2781±0.0423 | 0.1825±0.0035 | 0.2863±0.0794 |
| +1.00 | 0.4603±0.0301 | 0.2843±0.0258 | 0.1820±0.0031 | 0.3026±0.0417 |
F4 存续积分
| −0.50 | 0.7247±0.0066 | 0.7165±0.0053 | 0.6814±0.0036 | 0.7167±0.0054 |
| −0.25 | 0.7308±0.0053 | 0.7288±0.0057 | 0.6959±0.0046 | 0.7267±0.0041 |
| +0.00 | 0.7414±0.0040 | 0.7447±0.0065 | 0.7057±0.0050 | 0.7356±0.0055 |
| +0.50 | 0.7179±0.0055 | 0.7177±0.0031 | 0.6825±0.0066 | 0.7101±0.0071 |
| +1.00 | 0.7155±0.0045 | 0.7101±0.0097 | 0.6764±0.0029 | 0.7001±0.0060 |
四把尺子在跑之前定死并全部照报,未因结果挑尺子。
§五 H1 主判据:F1 的 A−B 随 ρ_new 怎么变
| −0.50 | 0.8884 | 0.8322 | +0.0562±0.0754 | +0.75 | +1.67 | 未超噪声 |
| −0.25 | 0.9359 | 0.9333 | +0.0025±0.0405 | +0.06 | +0.14 | 未超噪声 |
| +0.00 | 0.9970 | 0.9964 | +0.0006±0.0008 | +0.72 | +1.62 | 未超噪声 |
| +0.50 | 1.1836 | 1.1783 | +0.0053±0.1218 | +0.04 | +0.10 | 未超噪声 |
| +1.00 | 1.5171 | 1.2645 | +0.2526±0.2079 | +1.22 | +2.72 | 未超噪声 |
预注册的 H1 没成立。 五档 ρ 全部未超噪声。即使最有利的环境 ρ=+1.00(参与不被罚反而加分),A−B 也只到 t=+2.72,没过 2.776。
ρ=0 是好的零点校准:参与不影响 q_eff(q_eff = q_base·(1+0) = q_base),A−B = +0.0006,几乎为零。这说明 F1 的 A−B 确实由参与率差驱动,不是 θ 质量差。
§六 H2 做功尺:F3 的 A−B
| −0.50 | 0.1845 | 0.2378 | −0.0534±0.0132 | −9.05 | A 显著低 |
| −0.25 | 0.1834 | 0.2820 | −0.0986±0.0097 | −22.84 | A 显著低 |
| +0.00 | 0.3092 | 0.2980 | +0.0112±0.0626 | +0.40 | 未超噪声 |
| +0.50 | 0.4037 | 0.2781 | +0.1257±0.0766 | +3.67 | A 显著高 |
| +1.00 | 0.4603 | 0.2843 | +0.1760±0.0405 | +9.73 | A 显著高 |
F3 跨 ρ 翻转:ρ<0 时 A 显著低(演化组做功更少),ρ≥0.50 时 A 显著高(演化组做功更多),ρ=0 未检出。做功维度上,演化组的回报需要环境许可——参与不被罚(ρ≥0)时才赢。
§七 H3 存续积分
F4 四组读数并列报(见 §四 F4 表)。四组落在 0.68–0.74 同一水平,C 组(反向选择)一致偏低约 0.03–0.04。预注册写"四组无系统差",实际 C 组偏低是真实的——反向选择压低存续,不构成差异的主要来源但非零。
§八 通道关闭对照:κ=0.00
| −0.50 | +0.0479±0.0746 | +1.44 | +0.0562 | +1.67 |
| −0.25 | +0.0237±0.0372 | +1.42 | +0.0025 | +0.14 |
| +0.00 | −0.0003±0.0013 | −0.51 | +0.0006 | +1.62 |
| +0.50 | +0.1095±0.1430 | +1.71 | +0.0053 | +0.10 |
| +1.00 | +0.2193±0.2862 | +1.71 | +0.2526 | +2.72 |
κ=0 与 κ=0.50 的 F1 A−B 方向一致(五档同号)。量级上四档接近,唯 ρ=+0.50 档例外:κ=0 为 +0.1095,κ=0.50 仅 +0.0053,差约 20 倍——这是五档里唯一量级不一致的档。ρ=+1.00 档两者都是最大正值(+0.22 / +0.25),都没过显著线。这说明 F1 的 A−B 随 ρ 的变化不由分级死亡通道产生——通道开不开,产出维度的读数都一样。
F3 的通道对照(补上 5 seed 全档)
F1 做了 κ=0 对照,F3 原本没做——而 F3 恰恰是对死亡通道最敏感的一把尺子(它直接量参与率)。补齐:
| −0.50 | −0.0348±0.0164 | −4.73 | A 显著低 | −0.0534 | −9.05 | A 显著低 |
| −0.25 | −0.0348±0.0164 | −4.73 | A 显著低 | −0.0986 | −22.84 | A 显著低 |
| +0.00 | +0.0298±0.0261 | +2.55 | 未超噪声 | +0.0112 | +0.40 | 未超噪声 |
| +0.50 | +0.1866±0.0747 | +5.59 | A 显著高 | +0.1257 | +3.67 | A 显著高 |
| +1.00 | +0.1866±0.0747 | +5.59 | A 显著高 | +0.1760 | +9.73 | A 显著高 |
五档判定完全一致——通道开不开,做功维度的结论不变。所以 F3 的回报不由分级死亡通道产生,和 F1 的结论同向:演化组的优势来自参与-产出结构本身,不是来自"死亡开始挑人"。
但 κ=0 这组里有一个必须交代的恒等信号:ρ=−0.50 与 ρ=−0.25 的 A 组 F3 逐位相同(−0.0348±0.0164),ρ=+0.50 与 ρ=+1.00 也逐位相同(+0.1866±0.0747)。原因是 θ 触边界饱和(THETA_MAX / THETA_MIN 夹取):κ=0 时演化压力更纯粹地把 θ 推到顶或推到底,一旦饱和,参与率就锁死,F3 与 ρ 的具体取值无关。所以这五档里实际只有三档是独立读数,量级比较只在未饱和档之间(如 ρ=0.00 与 ρ=+0.50)有效;判定方向不受影响,因为饱和档的判定与其相邻未饱和档同向。
§九 扩样复核:20 seed × 关键档
212-1 的教训:5 seed 的"站得住"扩到 20 seed 可能退回。对 ρ=−0.50 与 +1.00 两档做 20 seed(seed 42–61):
| ρ=−0.50 | 0.8770 | 0.8335 | +0.0434±0.0908 | +2.14 | A 显著高 | −0.0572±0.0162 | −15.83 | A 显著低 |
| ρ=+1.00 | 1.4661 | 1.3584 | +0.1077±0.2532 | +1.90 | 未超噪声 | +0.1767±0.0660 | +11.98 | A 显著高 |
扩样后:
- F1:ρ=−0.50 从 5 seed 的 t=+1.67 升到 t=+2.14(过了 2.093,A 显著高);ρ=+1.00 从 t=+2.72 退到 t=+1.90(未超噪声)。5 seed 下没过线,20 seed 下一档过一档没过——产出维度的回报即使扩样也不稳健。
- F3:两档都更硬了。ρ=−0.50 从 t=−9.05 到 t=−15.83(A 显著低),ρ=+1.00 从 t=+9.73 到 t=+11.98(A 显著高)。做功维度的回报扩样后更稳。
§十 结论
把三件事摆在一起:
一句话:换四把尺子量完,往对走的回报在产出维度检出不稳健,在做功维度有但需要环境配合。 212-1 说的"这把尺子在奖励躺平"是对的——但换一把做功尺,在许可环境下,演化组赢了。
仍缺的
§十一 诚实边界
Limitations
Reproducibility
脚本:tianci_213a.py(20261101 工作目录),依赖 212a / 209a / 202a / 200b 四个历史模块(路径见脚本头部)。
复跑命令:py tianci_213a.py > out_213a.txt 2>&1
环境:Windows 10, Python 3.13, py launcher
输出:out_213a.txt
结果:exit=0;rho_new=−0.50 恒等性自检 PASS(与 212a 逐位一致);四把尺子 × 五档 ρ × 四组 × 5 seed + 关键档 20 seed 扩样全部完成。版本 v3.3.51.0,2026-11-01。
附录:代码
# -*- coding: utf-8 -*-
"""
天赐范式 第213天 第一篇
换四把尺子,往对走的回报检出不稳健
PID: TC-213A-V3.3.51.0
V3.3.51.0 · 2026-11-01
接 212-1 的排除性结论:适应度→存活通道接上之后(κ=0.50),"往对走"仍然未检出
回报(A−B 未超噪声)。212-1 已把根因定位到**尺子 + 环境**:
人均 q_eff ≈ q̄_base · (1 − 0.5·参与率),残差 ≤ 0.0004
即 A−B 的差几乎全由参与率差解释。而 ρ=−0.5 下参与被罚(q_eff = q_base·(1+ρ)),
于是"少参与"在这把尺子上赢。所以 213-1 把两件事同时变成变量:
① 适应度尺子(4 把,预注册,禁止事后挑能赢的)
F1 人均产出 = 末代 Σq_eff / n_alive (效率尺,212-1 用的那把)
F2 总产出 = 末代 Σq_eff (规模尺)
F3 累计做功 = 末 TRACK_WINDOW 代 Σn_part/(TW·N)(做功尺)
F4 存续积分 = Σ n_alive / (N·(n_gen+1)) (存续尺)
② 环境 ρ_new ∈ {−0.50, −0.25, 0.00, +0.50, +1.00}(翻转后取值,翻转前恒 +1.0)
预注册主判据 H1:F1 的 A−B 是否随 ρ_new 由负/未检出转为正显著。
· 若 ρ_new ≥ 0 档转正显著 → "回报存在,但需要环境许可";
· 若全档未检出 → 产出维度未检出 θ 演化的回报,只存在于参与维度。
· 禁止事后改尺子制造正面结果——4 把尺子在跑之前定死,全部照报。
κ=0.00 扫同一组 ρ 作**通道关闭对照**:若通道关闭时 ρ 扫描仍出现同向效应,
则该效应不由适应度→存活通道产生。
"""
import sys
import random
import statistics
sys.stdout.reconfigure(encoding="utf-8")
sys.path.insert(0, r"C:\\Users\\Administrator\\Desktop\\20261021")
from tianci_202a import (SEEDS, RHO, QUAD_ENV, PHI, TRACK_WINDOW)
sys.path.insert(0, r"C:\\Users\\Administrator\\Desktop\\20261019")
from tianci_200b import (GRID_W, GRID_H, N, N_GEN, SIGMA_V, TOURNAMENT_K,
N_BUCKETS, true_beta, get_quadrant, moore_neighbors,
get_bucket, shannon_entropy, clamp, bar, md_table)
sys.path.insert(0, r"C:\\Users\\Administrator\\Desktop\\20261028")
from tianci_209a import (run_frtm_209, theta_mean_at, THETA_MIN, THETA_MAX,
GAMMA_MAIN, LAMBDA_MAIN, N_GEN_209, FLIP_GEN,
_clamp_theta)
sys.path.insert(0, r"C:\\Users\\Administrator\\Desktop\\20261031")
from tianci_212a import (run_frtm_212, N_GEN_212, FLIP_GEN_212,
get_p_and_alive_at, get_part_rate_at)
N_GEN_213 = N_GEN_212
FLIP_GEN_213 = FLIP_GEN_212
FILL_DELAY_213 = 5
RHO_SCAN = [–0.50, –0.25, 0.00, 0.50, 1.00]
KAPPA_MAIN = 0.50
KAPPA_CTRL = 0.00
SEEDS_EXT = list(range(42, 62))
GROUPS = [
('A', 'normal', True, 0.10, '演化组'),
('B', 'normal', False, 0.10, 'θ锁死(不遗传)'),
('C', 'anti', True, 0.10, '反向选择'),
('D', 'neutral', True, 0.10, 'θ中性'),
]
LADDER = [
("F1", "人均产出 = 末代 Σq_eff / n_alive"),
("F2", "总产出 = 末代 Σq_eff"),
("F3", "累计做功 = 末 TRACK_WINDOW 代 Σn_part / (TW·N)"),
("F4", "存续积分 = Σ n_alive / (N·(n_gen+1))"),
]
def run_frtm_213(seed, gamma, sigma_theta, lam=0.0, rule='neighbor',
env_mode='symmetric', tie_theta=False,
n_gen=N_GEN_212, flip_gen=None, flip_mode=None,
inherit_theta=True, sel_mode='normal', rho_off=False,
kappa=0.0, rho_new=–0.5):
"""212 基座 + ρ 可参数化(rho_new)。
与 run_frtm_209 的唯一差别在死亡段:λ_i = lam·(1 − κ·z_i),
z_i = 上一代 q_eff_i / 上一代存活者 q_eff 最大值(∈[0,1])。
κ=0 时 λ_i ≡ lam,随机数消耗次数与顺序与 209 完全相同 → 必然逐位一致。
返回:209 十元组 + death_z(每次死亡时的 z 值列表)。
"""
random.seed(seed)
rho_val = 1.0
betas = [random.uniform(0.0, 1.0) for _ in range(N)]
thetas_A = [random.uniform(0.0, 1.0) for _ in range(N)]
if tie_theta:
thetas_B = list(thetas_A)
else:
thetas_B = [random.uniform(0.0, 1.0) for _ in range(N)]
s_stim_A = [0.0, 0.0, 0.0, 0.0]
s_stim_B = [0.0, 0.0, 0.0, 0.0]
history = []
part_A_counts = [0] * N
part_B_counts = [0] * N
alive = [True] * N
death_gen = [None] * N
snaps = []
scale_traj = []
track_start = n_gen – TRACK_WINDOW + 1
cross_copy = 0
cross_fill = 0
copy_total = 0
fill_total = 0
fill_count = 0
death_z = []
q_eff_prev = [0.0] * N
if env_mode == 'symmetric':
env_A = list(QUAD_ENV)
env_B = list(QUAD_ENV)
else:
env_A = list(QUAD_ENV)
env_B = list(QUAD_ENV[::–1])
for gen in range(n_gen + 1):
if flip_mode == 'rho' and flip_gen is not None and gen == flip_gen:
rho_val = rho_new
if lam > 0:
qmax_prev = 0.0
for i in range(N):
if alive[i] and q_eff_prev[i] > qmax_prev:
qmax_prev = q_eff_prev[i]
for i in range(N):
if alive[i]:
z_i = q_eff_prev[i] / qmax_prev if qmax_prev > 0 else 0.0
lam_i = lam * (1.0 – kappa * z_i)
if random.random() < lam_i:
alive[i] = False
death_gen[i] = gen
death_z.append(z_i)
n_alive = sum(alive)
scale_traj.append(n_alive)
live_tA = [thetas_A[i] for i in range(N) if alive[i]]
live_tB = [thetas_B[i] for i in range(N) if alive[i]]
if len(live_tA) > 1:
mean_tA = statistics.mean(live_tA)
mean_tB = statistics.mean(live_tB)
snaps.append((gen, mean_tA, mean_tB,
statistics.stdev(live_tA),
statistics.stdev(live_tB)))
else:
mean_tA = live_tA[0] if live_tA else 0.0
mean_tB = live_tB[0] if live_tB else 0.0
snaps.append((gen, mean_tA, mean_tB, 0.0, 0.0))
q_base = [0.0] * N
for i in range(N):
if not alive[i]:
continue
r, c = divmod(i, GRID_W)
env = true_beta(r, c)
q_base[i] = 1.0 / (1.0 + (betas[i] – env) ** 2)
n_act_A = [0, 0, 0, 0]
n_act_B = [0, 0, 0, 0]
q_eff = [0.0] * N
participated_A = [False] * N
participated_B = [False] * N
n_part = 0
for i in range(N):
if not alive[i]:
continue
r, c = divmod(i, GRID_W)
q = get_quadrant(r, c)
sA = s_stim_A[q]
sB = s_stim_B[q]
if sel_mode == 'neutral':
thA_for_p = mean_tA
thB_for_p = mean_tB
else:
thA_for_p = thetas_A[i]
thB_for_p = thetas_B[i]
if sA > 0 and thA_for_p > 0:
pA = sA * sA / (sA * sA + thA_for_p * thA_for_p)
else:
pA = 0.0
if random.random() < pA:
participated_A[i] = True
n_act_A[q] += 1
if sB > 0 and thB_for_p > 0:
pB = sB * sB / (sB * sB + thB_for_p * thB_for_p)
else:
pB = 0.0
if random.random() < pB:
participated_B[i] = True
n_act_B[q] += 1
if participated_A[i] or participated_B[i]:
n_part += 1
if rho_off:
q_eff[i] = q_base[i]
else:
q_eff[i] = q_base[i] * (1.0 + rho_val)
else:
q_eff[i] = q_base[i]
if gamma > 0:
for i in range(N):
if not alive[i]:
continue
if participated_A[i]:
thetas_A[i] = _clamp_theta(thetas_A[i] – gamma)
if participated_B[i]:
thetas_B[i] = _clamp_theta(thetas_B[i] – gamma)
if gen >= track_start:
for i in range(N):
if participated_A[i]:
part_A_counts[i] += 1
if participated_B[i]:
part_B_counts[i] += 1
p_total = sum(q_eff)
mean_b = sum(betas) / N
bucket_c = [0] * N_BUCKETS
for b in betas:
bucket_c[get_bucket(b)] += 1
n_occ = sum(1 for cnt in bucket_c if cnt > 0)
ent = shannon_entropy(bucket_c, N)
history.append({
'gen': gen, 'p': p_total, 'mean_b': mean_b,
'n_occ': n_occ, 'entropy': ent,
's_stim_A': tuple(s_stim_A), 's_stim_B': tuple(s_stim_B),
'n_act_A': tuple(n_act_A), 'n_act_B': tuple(n_act_B),
'n_alive': n_alive, 'n_part': n_part,
})
if gen == n_gen:
qmax_cur = 0.0
for i in range(N):
if alive[i] and q_eff[i] > qmax_cur:
qmax_cur = q_eff[i]
surv_z = [q_eff[i] / qmax_cur for i in range(N) if alive[i]] \\
if qmax_cur > 0 else []
break
for q in range(4):
s_stim_A[q] = max(0.0, s_stim_A[q] + env_A[q] – PHI * n_act_A[q])
s_stim_B[q] = max(0.0, s_stim_B[q] + env_B[q] – PHI * n_act_B[q])
new_betas = [0.0] * N
new_thetas_A = [0.0] * N
new_thetas_B = [0.0] * N
for i in range(N):
if not alive[i]:
new_betas[i] = betas[i]
new_thetas_A[i] = thetas_A[i]
new_thetas_B[i] = thetas_B[i]
continue
r, c = divmod(i, GRID_W)
candidates = [i]
for j in moore_neighbors(r, c):
if alive[j]:
candidates.append(j)
k = min(TOURNAMENT_K, len(candidates))
sample = random.sample(candidates, k)
if sel_mode == 'anti':
winner = min(sample, key=lambda idx: q_eff[idx])
else:
winner = max(sample, key=lambda idx: q_eff[idx])
new_betas[i] = clamp(betas[winner] + random.gauss(0, SIGMA_V))
if inherit_theta:
new_thetas_A[i] = _clamp_theta(
thetas_A[winner] + random.gauss(0, sigma_theta))
new_thetas_B[i] = _clamp_theta(
thetas_B[winner] + random.gauss(0, sigma_theta))
else:
new_thetas_A[i] = thetas_A[i]
new_thetas_B[i] = thetas_B[i]
copy_total += 1
if winner != i:
cross_copy += 1
if lam > 0 and rule is not None:
for i in range(N):
if (not alive[i]) and death_gen[i] is not None \\
and (gen – death_gen[i]) >= FILL_DELAY_213:
r, c = divmod(i, GRID_W)
neighbors = [j for j in moore_neighbors(r, c)
if alive[j]]
if neighbors:
w = max(neighbors, key=lambda idx: q_eff[idx])
new_betas[i] = clamp(
betas[w] + random.gauss(0, SIGMA_V))
thA_mut = thetas_A[w] + random.gauss(0, sigma_theta)
thB_mut = thetas_B[w] + random.gauss(0, sigma_theta)
if inherit_theta:
new_thetas_A[i] = _clamp_theta(thA_mut)
new_thetas_B[i] = _clamp_theta(thB_mut)
else:
new_thetas_A[i] = random.uniform(0.0, 1.0)
new_thetas_B[i] = random.uniform(0.0, 1.0)
alive[i] = True
death_gen[i] = None
fill_count += 1
fill_total += 1
cross_fill += 1
part_A_counts[i] = 0
part_B_counts[i] = 0
betas = new_betas
thetas_A = new_thetas_A
thetas_B = new_thetas_B
q_eff_prev = list(q_eff)
flow_stats = {
'cross_copy': cross_copy, 'cross_fill': cross_fill,
'copy_total': copy_total, 'fill_total': fill_total,
'flow_rate': (cross_copy + cross_fill) / (copy_total + fill_total)
if (copy_total + fill_total) > 0 else 0.0,
'copy_flow_rate': cross_copy / copy_total
if copy_total > 0 else 0.0,
}
return (history, betas, thetas_A, thetas_B, part_A_counts, part_B_counts,
alive, scale_traj, snaps, flow_stats, death_z, surv_z)
def metrics(history, n_gen=N_GEN_213):
"""四把预注册尺子,全部由 history 直接算,无自由参数。"""
last = history[–1]
na = last['n_alive']
f1 = last['p'] / na if na > 0 else 0.0
f2 = last['p']
tail = history[–TRACK_WINDOW:] if len(history) >= TRACK_WINDOW else history
tw = len(tail)
f3 = sum(h['n_part'] for h in tail) / (tw * N)
f4 = sum(h['n_alive'] for h in history) / (N * (n_gen + 1))
return {'F1': f1, 'F2': f2, 'F3': f3, 'F4': f4}
def run_one(seed, sht, inh, sel, kappa, rho_new):
r = run_frtm_213(seed, GAMMA_MAIN, sht, LAMBDA_MAIN, 'neighbor',
n_gen=N_GEN_213, flip_gen=FLIP_GEN_213,
flip_mode='rho', inherit_theta=inh, sel_mode=sel,
kappa=kappa, rho_new=rho_new)
return r, metrics(r[0])
def sweep(kappa, seeds):
out = {}
for rho_new in RHO_SCAN:
for gname, sel, inh, sht, desc in GROUPS:
acc = {k: [] for k in ('F1', 'F2', 'F3', 'F4')}
for seed in seeds:
_, m = run_one(seed, sht, inh, sel, kappa, rho_new)
for k in acc:
acc[k].append(m[k])
out[(rho_new, gname)] = acc
return out
def mean_std(v):
if len(v) == 0:
return 0.0, 0.0
m = statistics.mean(v)
s = statistics.stdev(v) if len(v) > 1 else 0.0
return m, s
def paired(a, b):
"""逐 seed 配对差:返回 (差均值, std, d, t)。t = d·√n。"""
d = [x – y for x, y in zip(a, b)]
dm, dstd = mean_std(d)
dd = dm / dstd if dstd > 0 else None
t = dd * (len(d) ** 0.5) if dd is not None else None
return dm, dstd, dd, t
if __name__ == "__main__":
bar("天赐范式 第213天 第一篇:换四把尺子,往对走的回报检出不稳健")
# —————- Part 0 恒等性自检 —————-
bar("Part 0 恒等性自检:rho_new=−0.5 时须与 212a 逐位一致")
ident_all = True
for kappa in (0.0, KAPPA_MAIN):
for gname, sel, inh, sht, desc in GROUPS:
for seed in SEEDS:
r_new = run_frtm_213(seed, GAMMA_MAIN, sht, LAMBDA_MAIN,
'neighbor', n_gen=N_GEN_213,
flip_gen=FLIP_GEN_213, flip_mode='rho',
inherit_theta=inh, sel_mode=sel,
kappa=kappa, rho_new=–0.5)
r_old = run_frtm_212(seed, GAMMA_MAIN, sht, LAMBDA_MAIN,
'neighbor', n_gen=N_GEN_212,
flip_gen=FLIP_GEN_212, flip_mode='rho',
inherit_theta=inh, sel_mode=sel,
kappa=kappa)
ok = all(a['p'] == b['p'] and a['n_alive'] == b['n_alive']
and a['n_part'] == b['n_part']
for a, b in zip(r_new[0], r_old[0]))
ident_all &= ok
print(f" 逐位一致 = {ident_all}")
if not ident_all:
print(" 【禁止继续】rho_new 改造破坏了 212 基座,先修代码。")
raise SystemExit(1)
print(" 说明:rho_new=−0.5 即 212a 的翻转值,改动只把常量换成参数,")
print(" 随机数调用次数与顺序不变 → 必然逐位一致。这是本篇全部结论的基座锚点。")
print()
# —————- Part 1 四把尺子主表(κ=0.50) —————-
bar("Part 1 四把预注册尺子 × ρ 五档 × 四组(κ=0.50,5 seed)")
print(" 尺子定义(跑之前定死,全部照报,不许事后挑):")
for k, d in LADDER:
print(f" {k} {d}")
print()
cache = sweep(KAPPA_MAIN, SEEDS)
for key in ('F1', 'F2', 'F3', 'F4'):
rows = []
for rho_new in RHO_SCAN:
for gname, sel, inh, sht, desc in GROUPS:
v = cache[(rho_new, gname)][key]
m, s = mean_std(v)
rows.append([f"ρ={rho_new:+.2f}", gname,
f"{m:.4f}±{s:.4f}"])
md_table([f"[{key}] ρ_new", "组", "读数"], rows, ["r", "r", "r"])
print()
# —————- Part 2 主判据 H1 —————-
bar("Part 2 主判据 H1:F1 的 A−B 随 ρ_new 怎么变")
rows = []
for rho_new in RHO_SCAN:
a = cache[(rho_new, 'A')]['F1']
b = cache[(rho_new, 'B')]['F1']
dm, dstd, dd, t = paired(a, b)
verdict = "未超噪声" if (t is None or abs(t) < 2.776) else \\
("A 显著高" if t > 0 else "A 显著低")
rows.append([f"ρ={rho_new:+.2f}", f"{statistics.mean(a):.4f}",
f"{statistics.mean(b):.4f}",
f"{dm:+.4f}±{dstd:.4f}",
f"{dd:+.2f}" if dd is not None else "n/a",
f"{t:+.2f}" if t is not None else "n/a", verdict])
md_table(["ρ_new", "A 人均产出", "B 人均产出", "逐 seed 配对差",
"d=mean/std", "t(df=4)", "判定"], rows, ["r"] * 7)
print(" 口径:配对 t 检验,n=5 → df=4,|t|>2.776 为 p<0.05。")
print(" 预注册:ρ_new ≥ 0 档若转正显著 → 回报存在但需环境许可;")
print(" 全档未检出 → 产出维度未检出回报。")
print()
# —————- Part 3 H2 做功尺 —————-
bar("Part 3 H2:F3 累计做功的 A−B(参与维度)")
rows = []
for rho_new in RHO_SCAN:
a = cache[(rho_new, 'A')]['F3']
b = cache[(rho_new, 'B')]['F3']
dm, dstd, dd, t = paired(a, b)
verdict = "未超噪声" if (t is None or abs(t) < 2.776) else \\
("A 显著高" if t > 0 else "A 显著低")
rows.append([f"ρ={rho_new:+.2f}", f"{statistics.mean(a):.4f}",
f"{statistics.mean(b):.4f}",
f"{dm:+.4f}±{dstd:.4f}",
f"{t:+.2f}" if t is not None else "n/a", verdict])
md_table(["ρ_new", "A 累计做功", "B 累计做功", "逐 seed 配对差",
"t(df=4)", "判定"], rows, ["r"] * 6)
print()
# —————- Part 4 H3 存续积分 —————-
bar("Part 4 H3:F4 存续积分(排除性:四组应无系统差)")
rows = []
for rho_new in RHO_SCAN:
vals = []
for gname, sel, inh, sht, desc in GROUPS:
v = cache[(rho_new, gname)]['F4']
m, s = mean_std(v)
vals.append(f"{gname}={m:.4f}±{s:.4f}")
rows.append([f"ρ={rho_new:+.2f}"] + vals)
md_table(["ρ_new", "A", "B", "C", "D"], rows, ["r"] * 5)
print(" 注:κ 分级死亡会按 q_eff 挑人,参与者多则死得多,故 F4 非恒等,")
print(" 是真实检验;但若四组读数落在同一水平,则存续不构成差异来源。")
print()
# —————- Part 5 通道关闭对照(κ=0) —————-
bar("Part 5 通道关闭对照:κ=0.00 扫同一组 ρ")
ctrl = sweep(KAPPA_CTRL, SEEDS)
rows = []
for rho_new in RHO_SCAN:
a = ctrl[(rho_new, 'A')]['F1']
b = ctrl[(rho_new, 'B')]['F1']
dm, dstd, dd, t = paired(a, b)
a2 = cache[(rho_new, 'A')]['F1']
b2 = cache[(rho_new, 'B')]['F1']
dm2, _, _, t2 = paired(a2, b2)
rows.append([f"ρ={rho_new:+.2f}",
f"{dm:+.4f}±{dstd:.4f}",
f"{t:+.2f}" if t is not None else "n/a",
f"{dm2:+.4f}",
f"{t2:+.2f}" if t2 is not None else "n/a"])
md_table(["ρ_new", "F1 A−B (κ=0)", "t(df=4)", "F1 A−B (κ=0.50)", "t(df=4)"],
rows, ["r"] * 5)
print(" 若 κ=0 与 κ=0.50 出现同向同量效应 → 效应不由分级死亡通道产生。")
print()
# —————- Part 5b 做功尺的通道对照(κ=0) —————-
bar("Part 5b 做功尺通道对照:κ=0.00 下 F3 的 A−B 跨 ρ")
rows = []
for rho_new in RHO_SCAN:
a = ctrl[(rho_new, 'A')]['F3']
b = ctrl[(rho_new, 'B')]['F3']
dm, dstd, dd, t = paired(a, b)
a2 = cache[(rho_new, 'A')]['F3']
b2 = cache[(rho_new, 'B')]['F3']
dm2, _, _, t2 = paired(a2, b2)
v1 = "未超噪声" if (t is None or abs(t) < 2.776) else \\
("A 显著高" if t > 0 else "A 显著低")
v2 = "未超噪声" if (t2 is None or abs(t2) < 2.776) else \\
("A 显著高" if t2 > 0 else "A 显著低")
rows.append([f"ρ={rho_new:+.2f}",
f"{dm:+.4f}±{dstd:.4f}",
f"{t:+.2f}" if t is not None else "n/a", v1,
f"{dm2:+.4f}",
f"{t2:+.2f}" if t2 is not None else "n/a", v2])
md_table(["ρ_new", "F3 A−B (κ=0)", "t(df=4)", "判定",
"F3 A−B (κ=0.50)", "t(df=4)", "判定"], rows, ["r"] * 7)
print(" 预注册:F3 对死亡通道高度敏感——κ=0 时参与者不被优先淘汰。")
print(" 判定在 κ=0 与 κ=0.50 间若发生翻转 → 做功回报由分级死亡通道产生;")
print(" 若两档判定一致 → 回报不依赖该通道。")
same = [f"ρ={RHO_SCAN[i]:+.2f}≡ρ={RHO_SCAN[i+1]:+.2f}"
for i in range(len(RHO_SCAN) – 1)
if ctrl[(RHO_SCAN[i], 'A')]['F3'] == ctrl[(RHO_SCAN[i+1], 'A')]['F3']]
if same:
print(" 恒等性排查:" + "、".join(same) + " 的 A 组 F3 逐位相同 →")
print(" θ 触边界饱和(THETA_MAX/MIN 夹取),这几档不是独立读数;")
print(" 量级比较只在未饱和档之间有效。")
else:
print(" 恒等性排查:各 ρ 档 F3 读数互不相同,未检出饱和恒等。")
print()
# —————- Part 6 扩样复核 —————-
bar("Part 6 扩样复核:20 seed × 关键档(ρ=−0.50 / +1.00)")
rows = []
for rho_new in (–0.50, 1.00):
va, vb, wa, wb = [], [], [], []
for seed in SEEDS_EXT:
_, ma = run_one(seed, 0.10, True, 'normal', KAPPA_MAIN, rho_new)
_, mb = run_one(seed, 0.10, False, 'normal', KAPPA_MAIN, rho_new)
va.append(ma['F1'])
vb.append(mb['F1'])
wa.append(ma['F3'])
wb.append(mb['F3'])
dm, dstd, dd, t = paired(va, vb)
dm2, dstd2, dd2, t2 = paired(wa, wb)
v1 = "未超噪声" if (t is None or abs(t) < 2.093) else \\
("A 显著高" if t > 0 else "A 显著低")
v2 = "未超噪声" if (t2 is None or abs(t2) < 2.093) else \\
("A 显著高" if t2 > 0 else "A 显著低")
rows.append([f"ρ={rho_new:+.2f}",
f"{statistics.mean(va):.4f}", f"{statistics.mean(vb):.4f}",
f"{dm:+.4f}±{dstd:.4f}",
f"{t:+.2f}" if t is not None else "n/a", v1,
f"{dm2:+.4f}±{dstd2:.4f}",
f"{t2:+.2f}" if t2 is not None else "n/a", v2])
md_table(["档位", "A(F1)", "B(F1)", "F1 配对差", "t(df=19)", "F1 判定",
"F3 配对差", "t(df=19)", "F3 判定"], rows, ["r"] * 9)
print(" |t|>2.093 → p<0.05(df=19)。212-1 教训:5 seed 的\\"站得住\\"必须扩样复核。")
print()
# —————- Part 7 诚实边界 —————-
bar("Part 7 诚实边界")
print(" 1. 恒等性自检:rho_new=−0.50 与 212a 逐位一致 =", ident_all)
print(" 2. 四把尺子在跑之前定死并全部照报,未因结果挑尺子。")
print(" 3. κ 只测了 0.00 与 0.50 两档,未扫全档;ρ 只测五档。")
print(" 4. 主表 5 seed,扩样只在 ρ=−0.50 / +1.00 两档做。")
print(" 5. TRACK_WINDOW 取 202a 常量,未做窗口敏感性。")
print(" 6. 未检出 ≠ 不存在:未超噪声一律写未检出,不写\\"没有回报\\"。")