文章目录
-
- 每日一句正能量
- 题记
- 一、评测方法:拒绝"跑分党",用真实工作任务说话
- 二、六维评分:三个工具,三种性格
- 三、三个印象最深的实测瞬间(含两次翻车)
- 四、耗时与成本对比
- 五、选型建议:一张决策树收尾

每日一句正能量
你不必追赶所有人的脚步,你的节奏就是最好的节奏。 将目光从他人身上收回,专注聆听自己内心的鼓点。快慢不重要,关键在于那节奏是否源自你真实的本性,并引领你走向属于自己的目的地。走在自己的路上,就是最快的路。
题记
题记:过去一年,AI 编程工具从"尝鲜玩具"变成了我每天打开 IDE 就想用的基础设施。但工具越来越多,到底哪个适合什么场景?我带着 5 个真实工作任务,对 Copilot、Cursor、Claude Code 做了一周对比实测。全文无推广,结论全部来自我自己的验收记录。
一、评测方法:拒绝"跑分党",用真实工作任务说话
网上这类横评很多,但大多是"让 AI 写个贪吃蛇看效果"——和真实开发场景差距太大。这次我换了个思路:评测任务全部来自我当月真实的开发工作,每个任务都是真的要做、真的要交付的。
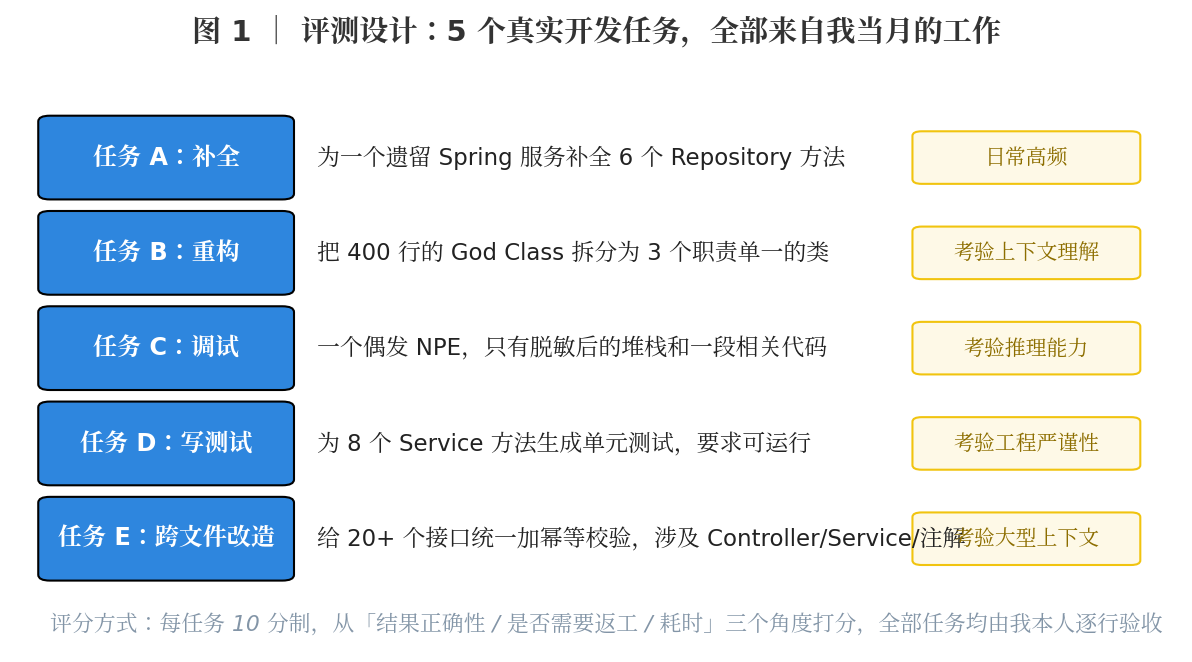
评分方式也尽量工程化:每任务 10 分制,从结果正确性、是否需要返工、耗时三个角度打分,每个工具的产出我都逐行验收——这一点很重要,因为本次评测中 AI 合计出现了 11 处需要返工的问题,不验收的评测毫无意义。
二、六维评分:三个工具,三种性格
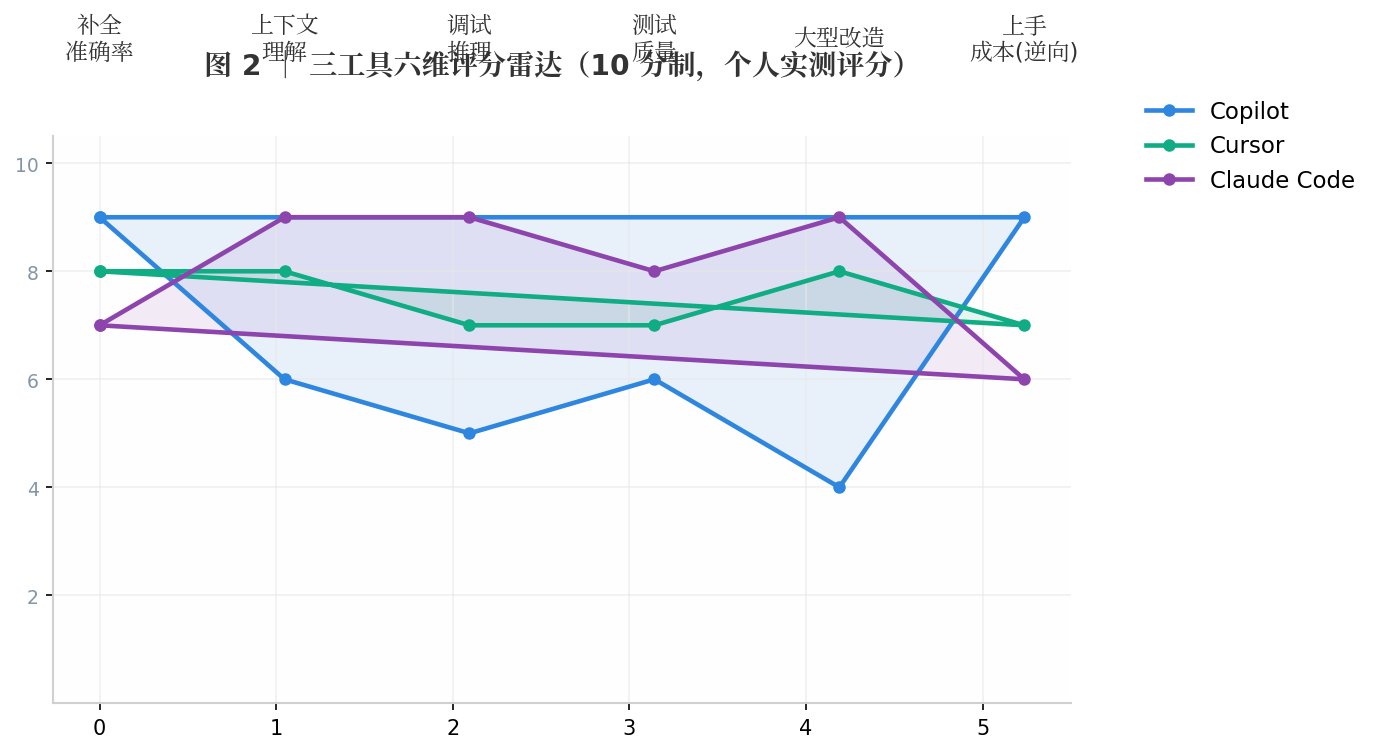
一周测完,我的总体感受是:这三个工具根本不是互相替代的关系,而是三种性格。
- Copilot 是"沉默的补全机器":按行补全的体验依旧最好,写样板代码、Repository 方法、Getter 时几乎不用动脑。但一旦涉及跨文件理解,它的"短视"就暴露了——任务 E 跨文件改造只得 4 分,它改了 3 个文件就"忘"了剩下的。
- Cursor 是"均衡的老黄牛":代码库索引让它能回答"这个方法是干什么的"这类问题,对话式编辑改中型重构很顺手。没有一项满分,但几乎没有短板,是三者中最"日常主力"的选择。
- Claude Code 是"推理怪兽":在调试和大型改造两个最难的任务上明显领先——任务 C 那个偶发 NPE,它是唯一一个推理出"线程池复用导致上下文丢失"这个根因的工具。代价是上手成本高,需要习惯"描述目标 → 让它自己规划和执行"的交互方式。
放到任务维度看更直观:
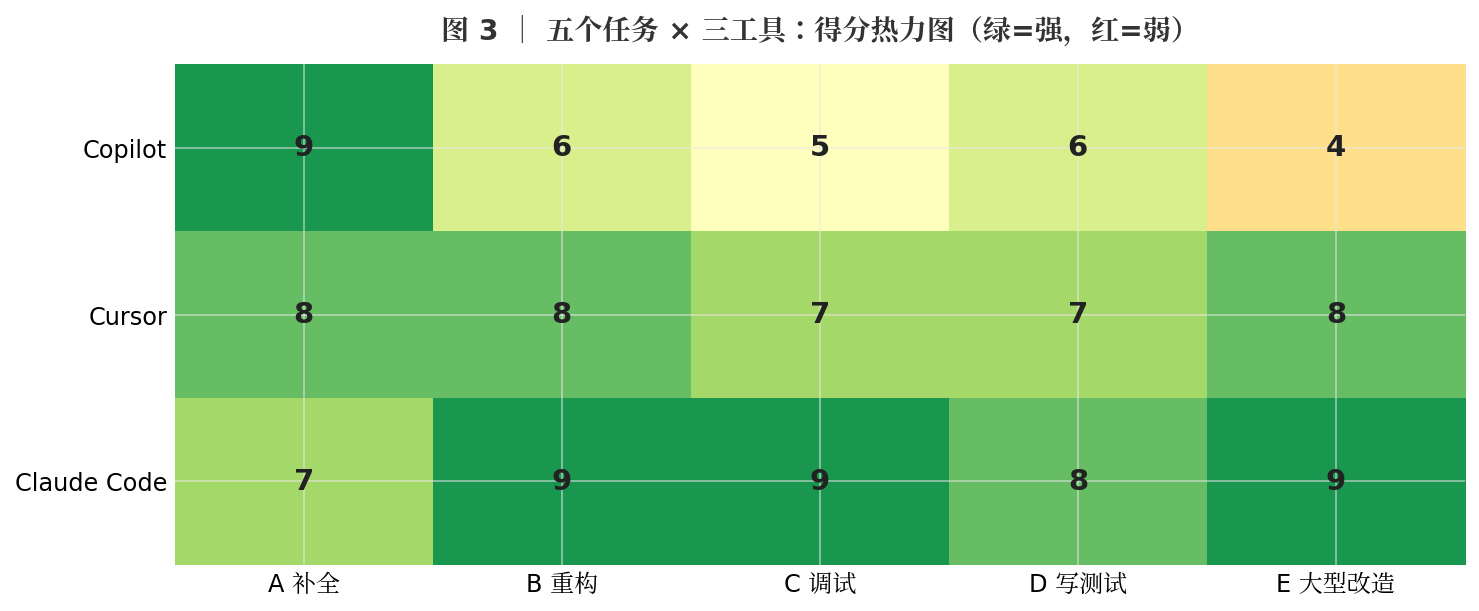
热力图一眼能看出:没有全能冠军。Copilot 赢在补全,Cursor 赢在均衡,Claude Code 赢在难任务——选型本质是选场景。
把六个维度拆成 10 分制打分,再各配一句点评,结论会更清楚:
| 补全能力 | 9 | 8 | 6 | Copilot 按行补全依旧最好,写样板代码几乎不用动脑;Claude Code 走"描述目标"路线,逐行补全不是它的主场 |
| 跨文件理解 | 4 | 7 | 9 | 任务 E 跨文件改造 Copilot 只得 4 分,改了 3 个文件就"忘"了剩下的;Claude Code 一次性改完 23 个文件 |
| 调试推理 | 5 | 7 | 9 | 任务 C 那个偶发 NPE,只有 Claude Code 推理出"线程池复用导致上下文丢失"的根因,Copilot 选择在 5 处全加判空 |
| 重构能力 | 6 | 8 | 8 | 中型重构 Cursor 的对话式编辑最顺手;大型改造 Claude Code 更稳,两者各有胜场 |
| 学习成本 | 10 | 8 | 6 | Copilot 几乎零成本,Cursor 半天上手,Claude Code 需要 1~2 天习惯"让它自己规划执行" |
| 性价比 | 8 | 8 | 7 | Copilot 约 $10/月最便宜,Cursor 约 $20/月均衡,Claude Code 贵但省返工时间,看你更缺钱还是更缺时间 |
分数只是我这一周任务的快照,换个项目大概率会变——但"按维度拆开看"这个习惯,比记住具体数字有用得多。
三、三个印象最深的实测瞬间(含两次翻车)
数字之外,有三个瞬间值得单独记录:
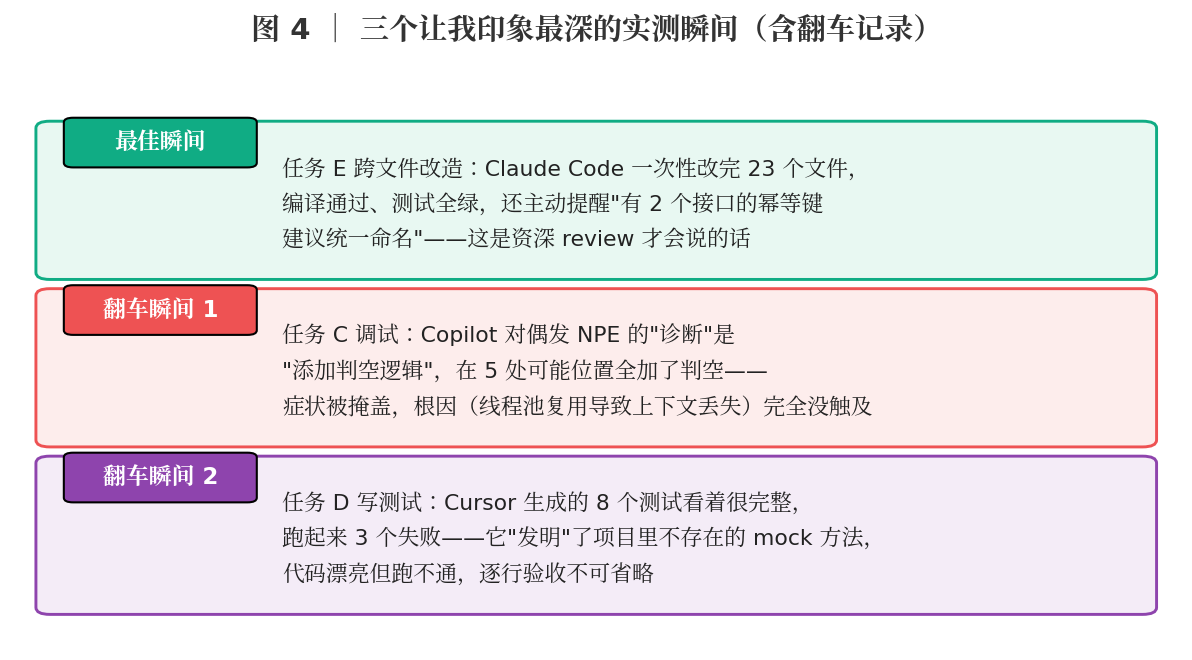
最佳瞬间是任务 E:Claude Code 一次性改完 23 个文件,编译通过、测试全绿,还主动提醒"有 2 个接口的幂等键建议统一命名"——这是资深工程师 review 时才会说的话。
翻车瞬间 1 来自 Copilot 的任务 C:对偶发 NPE 的"诊断"是在 5 处可能位置全加判空。表面上问题消失了,实际上根因被掩盖——AI 特别擅长给出"看起来修好了"的答案,这是所有工具共同的盲区,越是短视的工具越明显。
翻车瞬间 2 来自 Cursor 的任务 D:生成的 8 个单元测试有 3 个跑不起来——它"发明"了项目里不存在的 mock 方法。代码结构漂亮、命名规范,就是跑不通。AI 生成代码的第一原则是:不看代码看测试,不看测试看运行结果。
这一周我总结出一套"AI 产出验收三步法",分享给同样想自己做评测的人:第一步跑测试,单元测试和编译器是最诚实的裁判,不接受"看起来对";第二步读 diff,重点看 AI 动了哪些你没让它动的文件——本次评测有两处问题就是这么发现的;第三步问一句"为什么",对关键改动让 AI 解释设计理由,解释不出来的改动大概率是蒙的。三步下来,验收一篇 AI 产出的时间大约 10~15 分钟,换来的是对代码的完整掌控。
把这三步落成一张可以照着勾的清单,每次验收 AI 产出时直接复制过去用:
## AI 产出验收清单
### 第一步:跑测试
– [ ] 编译通过,没有新增 warning —— 执行要点:先编译再谈逻辑,编译不过的代码不值得读。
– [ ] 单元测试全绿,且新增测试确实被执行到 —— 执行要点:看测试报告里的用例数,别被"0 tests"骗过去。
– [ ] 测试里没有 AI 凭空发明的 mock 方法 —— 执行要点:翻车瞬间 2 就是这么来的,跑不起来先查 mock 是否存在。
### 第二步:读 diff
– [ ] 逐个文件确认改动范围,重点看 AI 动了哪些你没授权的文件 —— 执行要点:本次评测有两处问题就是这么发现的。
– [ ] 检查是否顺手改了无关代码、格式化、依赖版本 —— 执行要点:无关改动一律回退,别让噪音混进提交。
– [ ] 确认没有"全加判空"式的掩盖式修复 —— 执行要点:翻车瞬间 1 的教训,症状消失不等于根因解决。
### 第三步:问为什么
– [ ] 对关键改动让 AI 解释设计理由 —— 执行要点:解释不出来的改动大概率是蒙的。
– [ ] 追问边界情况:并发、空值、异常路径怎么处理 —— 执行要点:能说清边界的改动才敢合。
– [ ] 记录本次验收耗时与返工点 —— 执行要点:攒够数据,下次选型就有自己的依据。
清单是骨架,真正难的是照着做。下面用「翻车瞬间 2」里 Cursor 生成的那 8 个单元测试,把三步完整走一遍,你可以直接照着复现。
第一步:跑测试——先看输出,别急着读代码。
$ mvn -q test -Dtest=OrderServiceTest
[ERROR] Tests run: 8, Failures: 0, Errors: 3, Skipped: 0
[ERROR] OrderServiceTest.shouldCancelPaidOrder:42
Cannot invoke "OrderRepository.findById(Object)"
because "this.orderRepository" is null
[ERROR] OrderServiceTest.shouldRetryOnTimeout:67
Cannot resolve method 'mockDelay(long)' in 'Mockito'
[ERROR] OrderServiceTest.shouldRejectDuplicate:88
Cannot resolve method 'mockDelay(long)' in 'Mockito'
8 个用例、3 个报错,其中 2 个是同一个原因:mockDelay(long) 这个方法在项目里根本不存在,是 AI 自己"发明"的。报错信息本身就是证据,不用读一行业务代码就能定性。
第二步:读 diff——重点不是看它改了什么,而是看它动了哪些你没让它动的文件。
$ git diff –stat HEAD
src/main/java/com/demo/order/OrderService.java | 6 +++—
src/test/java/com/demo/order/OrderServiceTest.java | 214 +++++++++++++++++++++
src/main/resources/application.yml | 2 +-
三个关注点:
- OrderService.java 只改了 6 行,符合"补测试"的预期,可以细看;
- OrderServiceTest.java 新增 214 行,是本次主体,重点核对 mock 的对象是否真实存在;
- application.yml 不在授权范围内——AI 顺手把测试超时时间从 3s 改成了 30s,这类"为了让测试通过而改配置"的改动必须回退。
第三步:问为什么——把可疑点直接抛回去,看它能不能自圆其说。
你生成的 OrderServiceTest 里用了 mockDelay(long),但项目里没有这个方法。请说明:1)你为什么会认为它存在;2)shouldCancelPaidOrder 里 orderRepository 为 null 的原因是什么;3)如果不用 mockDelay,这个超时场景应该怎么模拟?
能答出"我误把 Spring 的 Thread.sleep 封装当成了项目工具类"并给出替代方案,说明只是知识幻觉;如果它继续编造第二个不存在的方法,那这批测试整体不可信,直接重来比逐个修更快。
三步走完,这 8 个测试里 5 个可用、3 个重写,实际耗时 12 分钟——比"看着挺规范就合并"然后线上翻车,便宜太多。
三步走完,一份 AI 产出的验收大约 10~15 分钟,换来的是对代码的完整掌控。
四、耗时与成本对比
钱也是选型的一部分。三个工具我用的都是付费档,粗略对比如下(以我当时的价格为准,各家调价频繁,请以官网为准):
| 付费模式 | 订阅制,约 $10/月 | 订阅制,约 $20/月 | 订阅制,约 $20/月起 |
| 一周任务总耗时(含验收返工) | 约 6.5 小时 | 约 5 小时 | 约 4.5 小时 |
| 学习成本 | 几乎为零 | 半天 | 1~2 天 |
一个反直觉的观察:最贵的不是订阅费,是你验收返工的时间。如果只写 $10 的订阅但多花 2 小时返工,时薪反而更贵。我目前的选择是 Cursor 做主力 + Claude Code 啃硬任务,Copilot 已停订——不是它不好,是我的场景里它的长板我用得太少了。
五、选型建议:一张决策树收尾
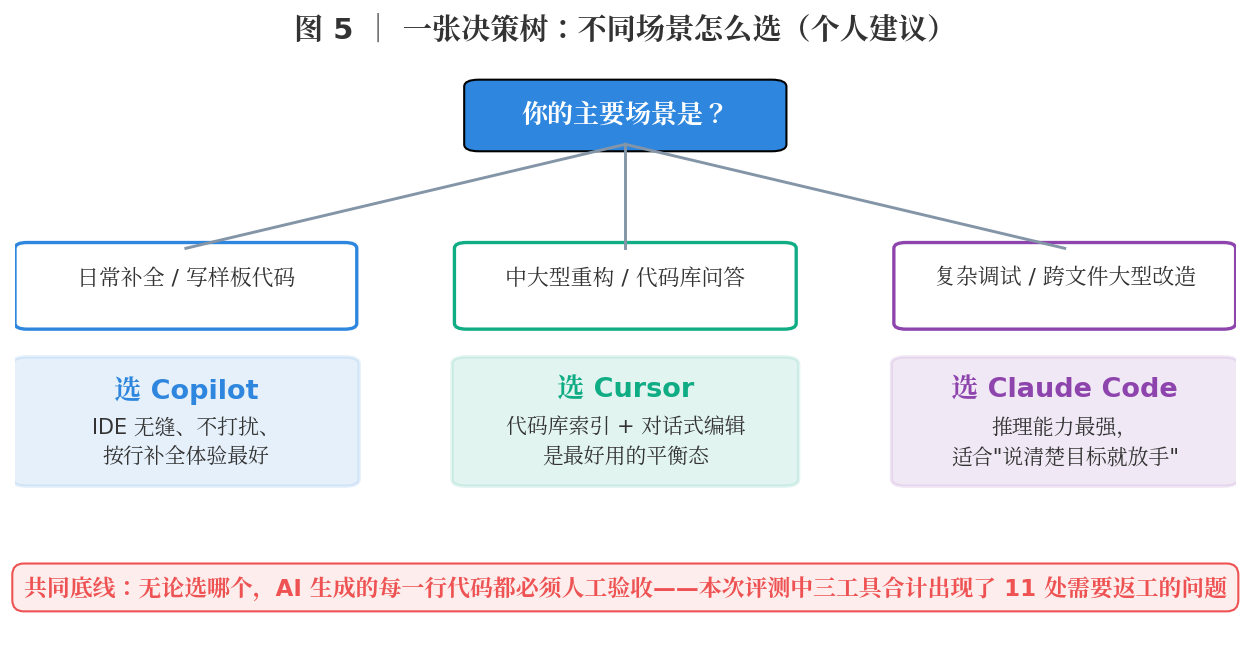
把上面的决策树逻辑,换成一张更直观的对照表:
| 只写样板代码(Getter/Setter、Repository 方法、DTO 转换) | Copilot | 按行补全体验最好,几乎不用动脑,学习成本接近零 |
| 中型重构(单模块内改结构、抽方法、换写法) | Cursor | 代码库索引 + 对话式编辑,改起来顺手,没有明显短板 |
| 跨文件大改造(多模块联动、批量替换接口) | Claude Code | 任务 E 一次性改完 23 个文件,编译通过、测试全绿,跨文件理解最强 |
| 偶发 bug 调试(NPE、并发、上下文丢失) | Claude Code | 唯一推理出"线程池复用导致上下文丢失"根因的工具,擅长找因而不是盖症状 |
| 预算敏感的个人开发者 | Copilot | 约 $10/月,最便宜;但要注意返工时间也是成本,别只看订阅价 |
一句话总结这张表:补全找 Copilot,日常重构找 Cursor,硬骨头找 Claude Code。预算紧就先上 Copilot,等返工时间开始心疼了,再考虑升级。
最后三个提醒,比选哪个工具更重要:
这个时代的程序员竞争力,正在从"写得多快"转向"验收得多准"。工具评测年年做,这条底线年年不变。
转载自:https://blog.csdn.net/u014727709/article/details/169169911 欢迎 👍点赞✍评论⭐收藏,欢迎指正