一、什么是索引
MySQL 负责给用户提供数据存储服务,我们的数据最终都存放在磁盘这个外设里。磁盘属于机械设备,对比电子元件,它的运行效率很低,结合 IO 本身的特点,如何提升数据交换的效率,就是 MySQL 里一个很重要的话题。
MySQL 服务本身是运行在内存中的,数据库所有的增删改查操作,还有索引相关的操作,都会在内存里完成。想要提升算法效率,主要看两点:一是数据的组织方式,二是算法本身的好坏。
索引能够提升数据库的查询性能,不需要额外加内存、不用修改程序、也不用调整 SQL,只要正确执行 create index 创建索引,查询速度就有可能提升成百上千倍。但是查询速度的提升是有代价的,会降低插入、更新、删除这些写操作的速度,写操作会带来更多的 IO 开销,所以索引的核心价值,是在海量数据场景下加快检索速度。没有索引和建立索引之后的查询速度差距很大,建立索引的表,查询数据会明显更快。
而索引依靠一种专门的数据结构来提升查找效率,这个数据结构就是 B + 树。
B + 树是一种多路平衡搜索树,它的所有真实数据都存放在叶子节点当中,非叶子节点只用来保存索引键值和子节点的指针,起到目录导航的作用。B + 树的叶子节点之间会用链表串联起来,所有叶子节点按照键值从小到大有序排列,既支持单点精准查找,也很方便做范围查找
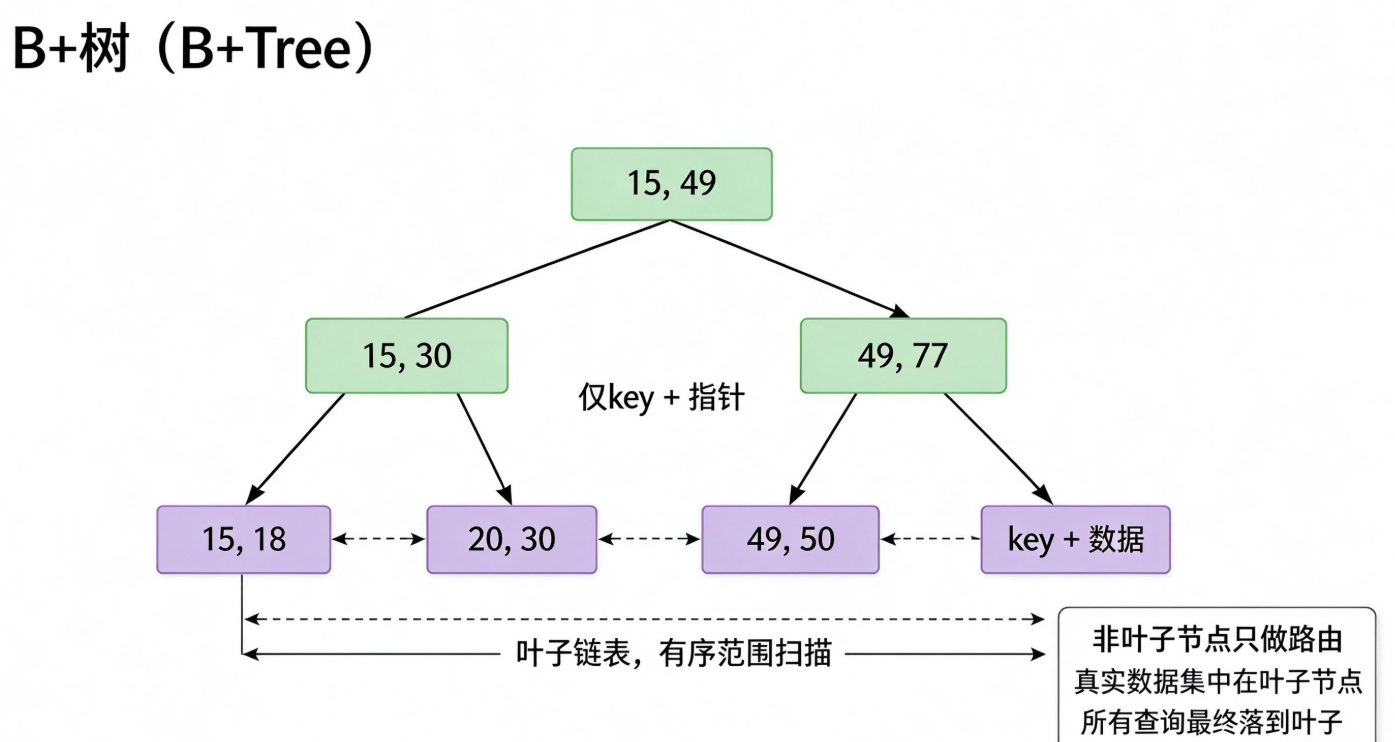
我们来思考为什么 MySQL 索引选择 B + 树,而不是别的数据结构:链表是线性查找,需要挨个遍历,查找效率很低;二叉搜索树在极端情况下会退化成链表,失去二分查找的优势;AVL 树和红黑树是二叉树,树高会更高,查找时要经过更多节点,需要触发更多次磁盘 IO,效率比不上 B + 树;哈希结构在 MySQL 部分引擎中会用到,但是 InnoDB 和 MyISAM 的索引不会采用哈希,哈希不支持范围查询、排序和前缀匹配。
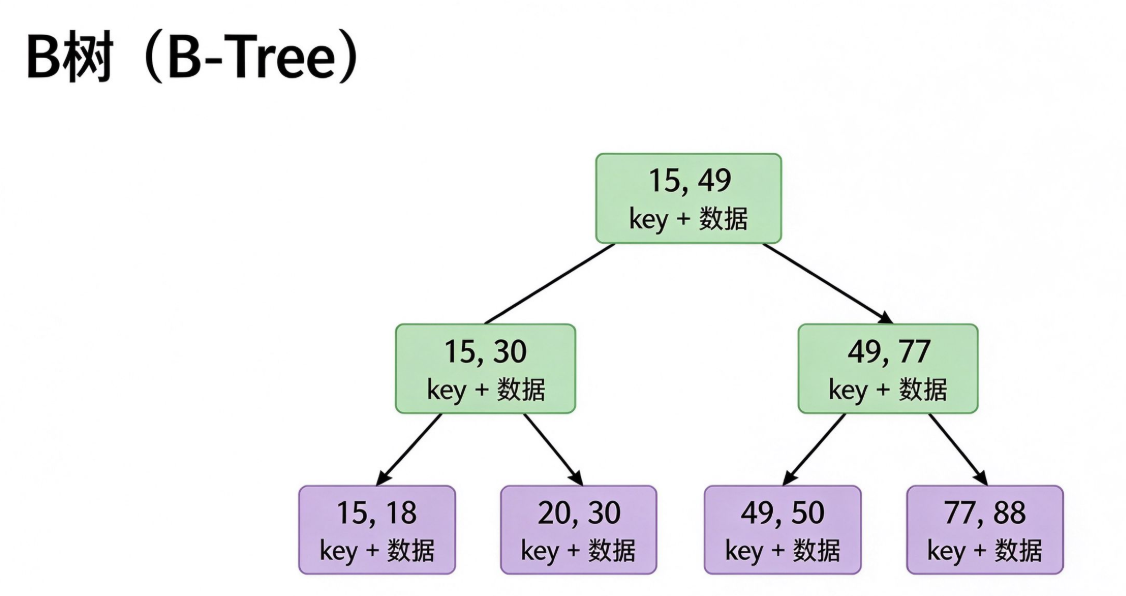
再对比 B 树和 B + 树:B 树的节点里面既存索引键,又存放真实数据,单个节点能容纳的索引条目有限;而 B + 树的非叶子节点只存放目录索引信息,不存放真实数据,同样大小的磁盘页里,可以放下更多的索引条目,树的高度会更低,查找的时候经过的节点更少,磁盘 IO 次数更少,查找效率更高。同时 B + 树叶子节点的链表结构,也让范围查询、分页查询变得十分方便。
所以 InnoDB 索引的底层本质,就是 B + 树这种数据结构。
二、索引的分类
索引分为聚簇索引和非聚簇索引。MyISAM 存储引擎使用的是非聚簇索引。
MyISAM 引擎以 B + 树作为索引结构,它索引 B + 树叶子节点的 data 域存放的不是真实数据,而是数据记录的磁盘地址。 这种把 B + 树索引和真实数据分开存放的方案,我们叫做非聚簇索引;与之相对,把索引和数据放在一起存储的方案,就是聚簇索引。InnoDB 采用聚簇索引,索引和数据放在同一个 B + 树里;MyISAM 是非聚簇索引,索引文件和数据文件相互独立。
下图为MyISAM的主键索引,Col1为主键:
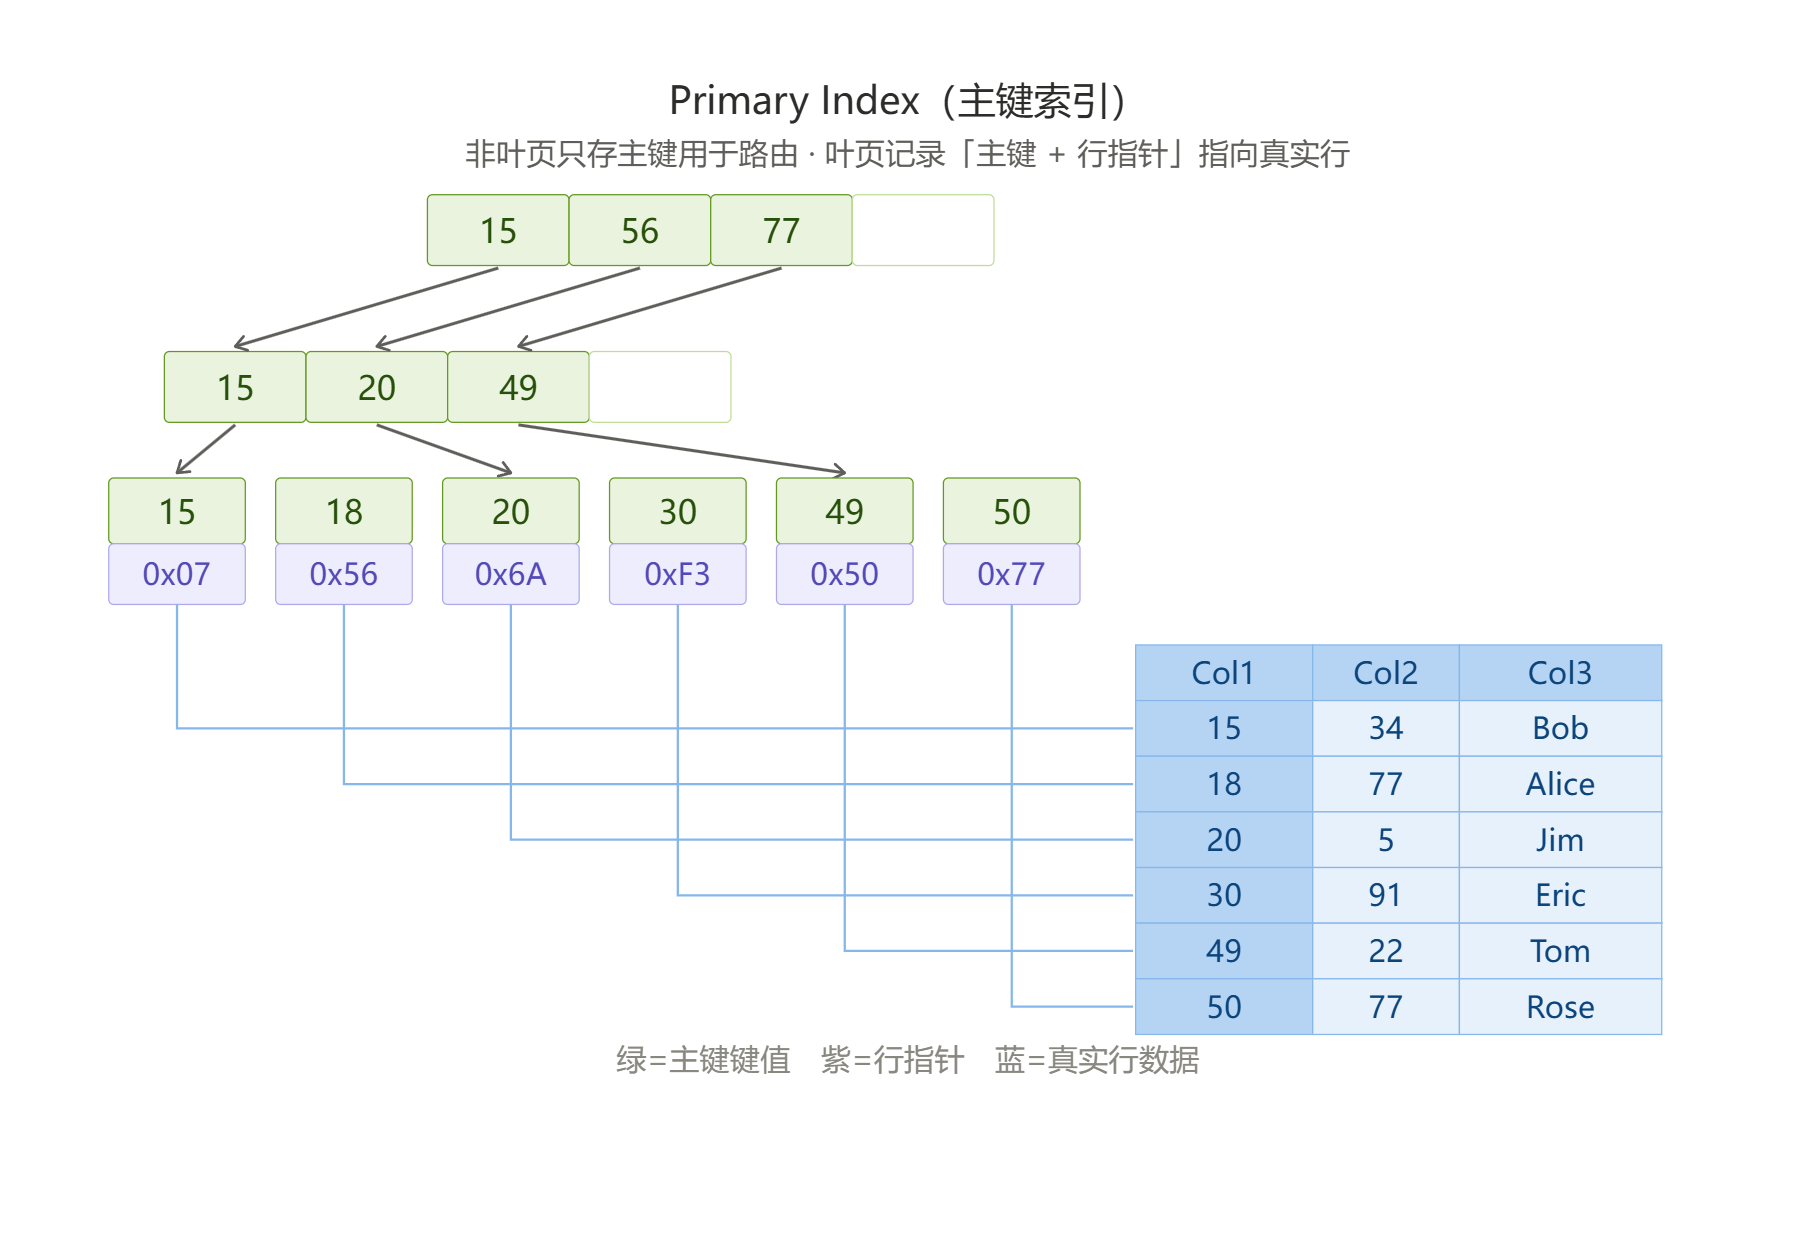 可以看到,叶子节点保存的是数据的地址,索引和数据是相互分离的。
而在 InnoDB 里,主键索引就是聚簇索引,整行数据都存放在主键索引 B + 树的叶子节点中。
innodb的主键索引如下图所示: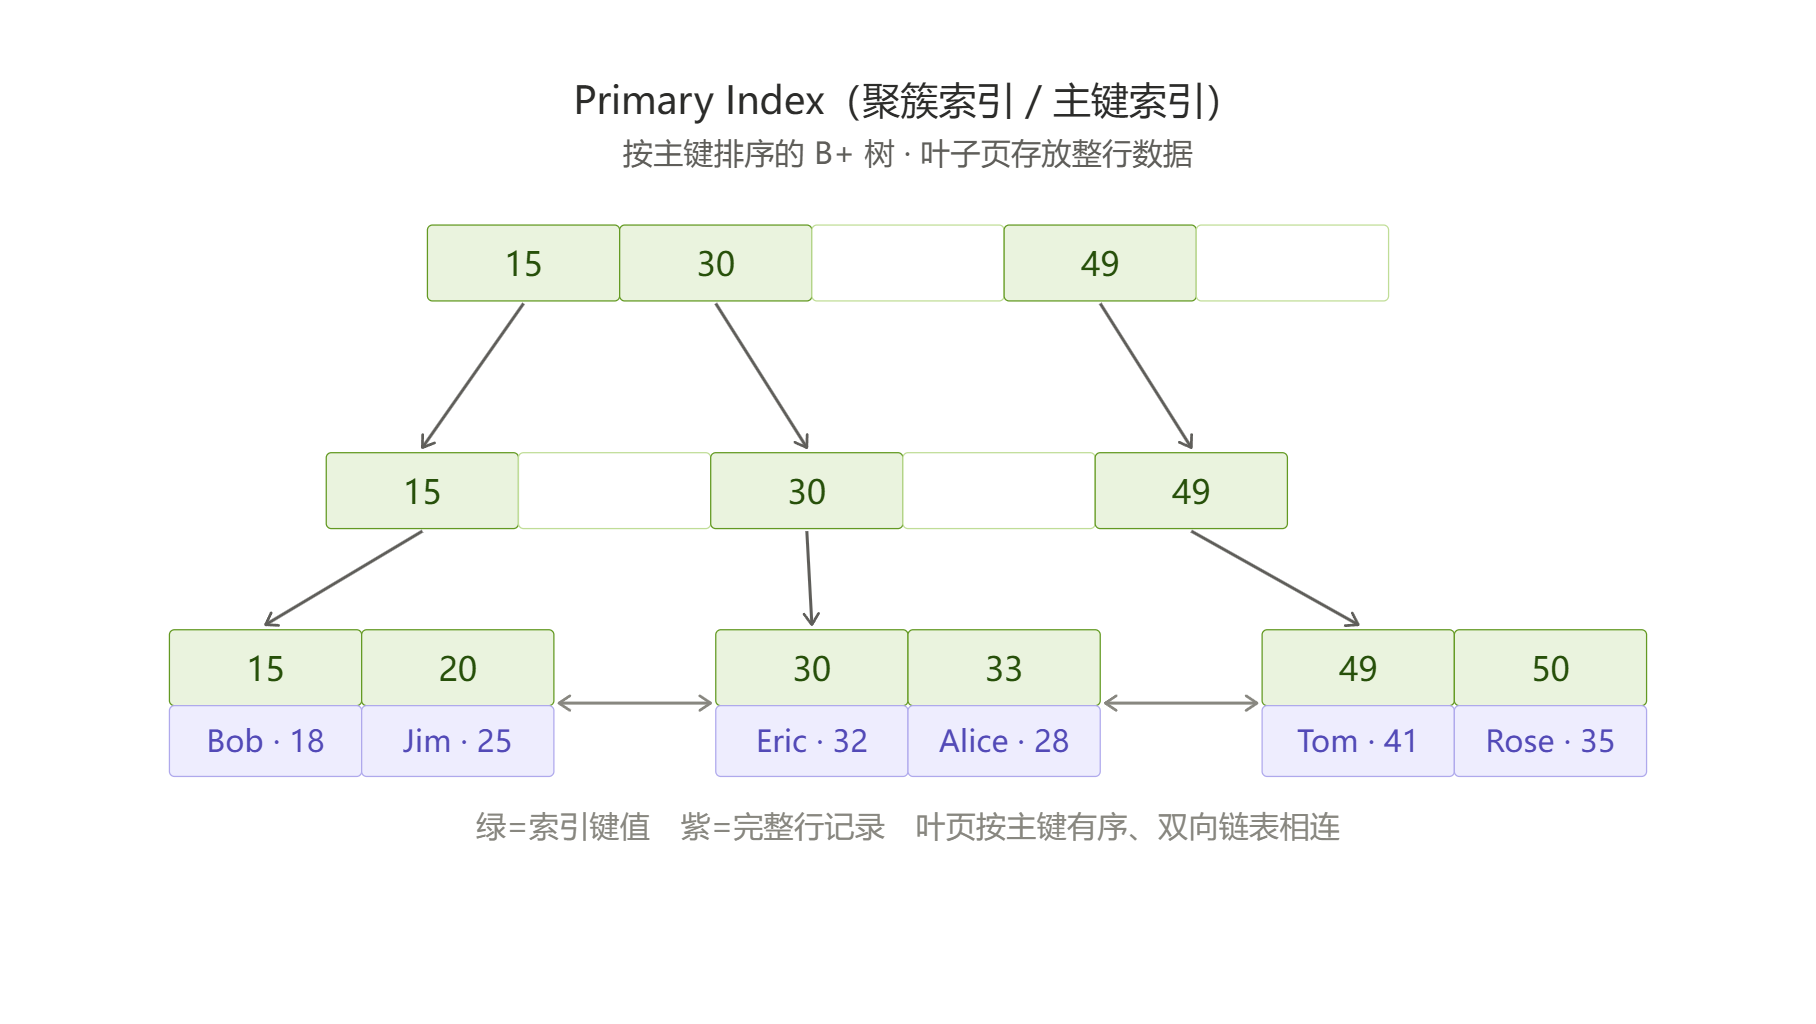 innodb的非主键索引如下图所示:
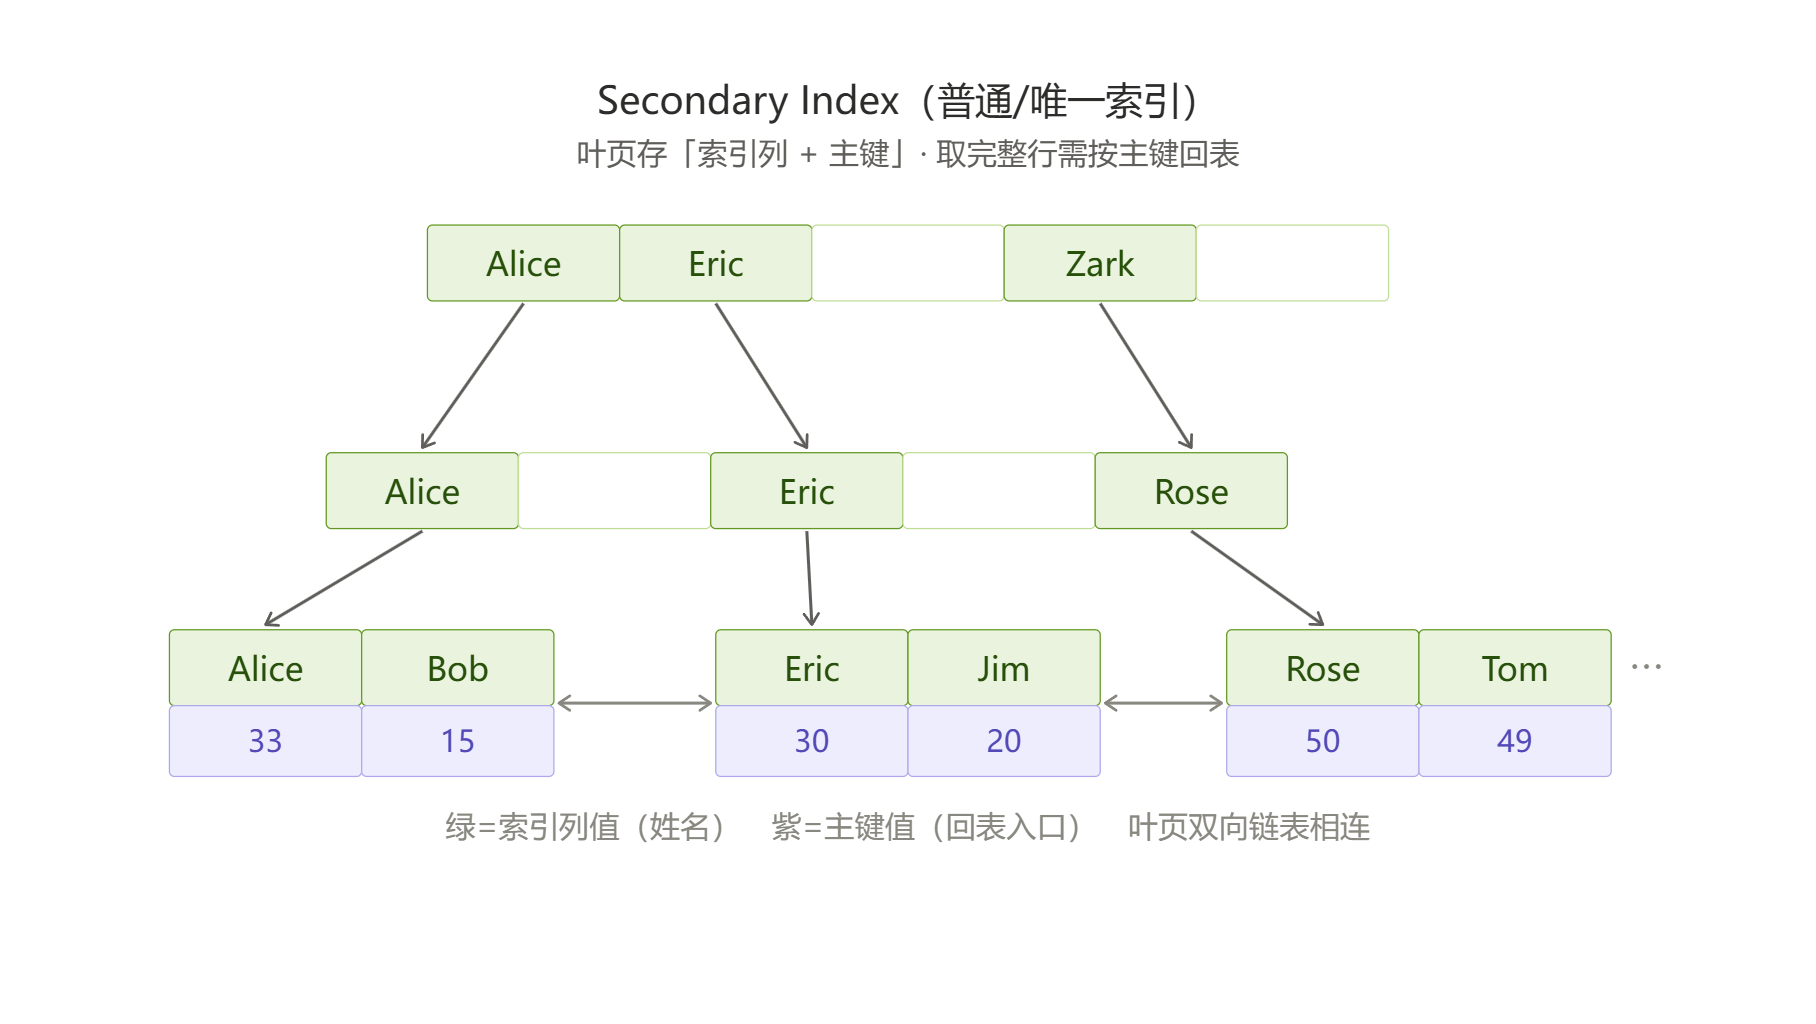
可以看到,InnoDB 的非主键索引中叶子节点并没有数据,而只有对应记录的 key 值。
InnoDB 的普通索引(辅助索引、非主键索引)的 B + 树叶子节点,不会存放完整的一行数据,只会保存这条记录对应的主键值。 所以我们使用普通索引查找数据的时候,要走两次索引查找:第一步先检索辅助索引,拿到对应的主键;第二步拿着这个主键,再去主键的聚簇索引里面查找,最终拿到完整的数据行。这个过程就叫做回表查询。
为何 InnoDB 针对这种辅助(普通)索引的场景,不给叶子节点也附上数据呢?原因就是太浪费空间了。也正是因为每一个索引,都会单独生成一棵 B + 树,所以一张表可以同时存在多棵 B + 树:主键索引是一棵,每建立一个普通索引,就会新增一棵独立的 B + 树。
二、索引操作
主键索引,唯一索引,普通索引
2.1创建索引
2.1.1 主键索引
创建主键索引一共有三种方式
- 第一种方式
— 在创建表的时候,直接在字段名后指定 primary key
create table user1(id int primary key, name varchar(30));
- 第二种方式:
— 在创建表的最后,指定某列或某几列为主键索引
create table user2(id int, name varchar(30), primary key(id));
- 第三种方式:
create table user3(id int, name varchar(30));
— 创建表以后再添加主键
alter table user3 add primary key(id);
主键索引有如下几个特点:
- 一个表中,最多有一个主键索引,当然可以使用复合主键
- 主键索引的效率高(主键不可重复)
- 创建主键索引的列,它的值不能为null,且不能重复
- 主键索引的列基本上是int
这里要注意,不是只有主键才可以建索引;如果我们没有手动设置主键,MySQL 也会自动生成一个隐藏的默认索引。
2.1.2 唯一索引
- 第一种方式
— 在创建表的时候,直接在字段名后指定 unique
create table user1(id int, name varchar(30) unique);
- 第二种方式:
— 在创建表的最后,指定某列或某几列为唯一索引
create table user2(id int, name varchar(30), unique(name));
- 第三种方式:
create table user3(id int, name varchar(30));
— 创建表以后再添加唯一索引
alter table user3 add unique(name);
- 第四种方式:
— 使用 create unique index 创建唯一索引
create unique index uk_name on user3(name);
唯一索引的特点:
- 一个表中,可以有多个唯一索引,也可以使用复合唯一索引
- 唯一索引的列的值不能重复,但是允许为 null
- InnoDB 中唯一索引属于二级索引,叶子节点存放索引值+主键,查询一般会回表
2.1.3 普通索引
普通索引的创建有三种方式:
- 第一种方式
— 在创建表的时候,在表末尾指定普通索引
create table user1(id int, name varchar(30), index idx_name(name));
- 第二种方式:
create table user2(id int, name varchar(30));
— 创建表以后再添加普通索引
alter table user2 add index idx_name(name);
- 第三种方式:
— 使用 create index 创建普通索引
create index idx_name on user2(name);
普通索引的特点:
- 一个表中,可以有多个普通索引,也可以使用复合普通索引
- 普通索引没有唯一性约束,字段值可以重复,也可以为 null
- InnoDB 中普通索引属于二级索引,叶子节点存放索引值+主键,查询一般会回表
2.1.4 索引创建原则
建索引不是越多越好,有几个很实用的建索引原则:
1.经常作为查询条件的字段,适合建立索引;
2.唯一性太差的字段,不适合单独建立索引,就算它经常出现在查询条件里也不推荐;
3.更新非常频繁的字段,不适合建立索引,每次修改数据都要维护索引,会带来大量 IO 开销;
4.不会出现在 where 子句里的字段,就不应该去创建索引。
2.2 查询索引
查询索引
查看表里面已经建立的索引,有三种常用方式: 第一种方法:show keys from 表名;
show keys from goods\\G
- Non_unique:0 代表唯一索引,1代表允许重复的普通索引
- Key_name:索引名称,PRIMARY 代表主键索引
- Seq_in_index:联合索引里,该字段在索引中的顺序
- Column_name:索引对应的字段名
- Index_type:索引类型,我们前面讲的B+树索引这里显示为BTREE
第二种方法:
show index from 表名;
show index 和 show keys 效果完全一样,只是写法不同。
第三种方法:
desc 表名;
这种方式展示的索引信息比较简略,只能简单看到哪些字段带索引,看不到索引完整细节。
2.3 删除索引
删除索引
删除索引分两种情况,主键索引和普通索引的语法不一样: 第一种,删除主键索引:
alter table 表名 drop primary key;
第二种,删除普通索引、唯一索引这类非主键索引:
alter table 表名 drop index 索引名;
这里填写的索引名,就是我们执行 show keys from 表名 结果里的 Key_name 字段。 示例:
alter table user10 drop index idx_name;
需要注意的是,InnoDB中如果主键字段同时带有自增属性,是不能直接删除主键的,需要先去掉自增属性,再删除主键索引。