Memory in the Age of AI Agents: A Survey
论文地址:https://arxiv.org/abs/2512.13564
项目页面:https://github.com/Shichun-Liu/Agent-Memory-Paper-List
进 Q 学术交流群:922230617 或加 CV_EDPJ 进 W 交流群
目录
1. 引言
2. 预备知识:Agent 与 Memory 的形式化定义
2.1 基于 LLM 的 Agent 系统
2.2 Agent 记忆系统
2.3 与其他关键概念的比较
3. 形式(Form):记忆以什么形式存在?
3.1 token 级记忆
3.2 参数化记忆
3.3 潜记忆
4. 功能(Function):为什么 Agent 需要记忆?
4.1 事实记忆
4.2 经验性记忆
4.3 工作记忆
5. 动态(Dynamics):记忆如何形成、演化与使用?
5.1 记忆形成
5.2 记忆演化
5.3 记忆检索
6. 资源与框架
6.1 基准测试与数据集
6.2 开源框架
7. 观点与前沿
7.1 记忆检索 vs. 记忆生成
7.2 自动化记忆管理
7.3 强化学习遇见 agent 记忆
7.4 多模态记忆
7.5 多 agent 系统中的共享记忆
7.6 用于世界模型的记忆
7.7 可信记忆
7.8 与人类认知的联系
8. 结论
1. 引言
随着大语言模型(LLMs)在推理、规划与工具使用等能力上的快速提升,LLM 正在从静态的条件生成模型演化为能够与环境持续交互、具备自主决策能力的 AI agents。在这一转变过程中,记忆(Memory) 被公认为支撑长时推理、持续学习与环境适应的关键能力之一。
本文指出,尽管近两年 agent memory 相关研究爆发式增长,但该领域呈现出明显的 概念碎片化问题:
- 不同工作在动机、实现方式、记忆对象、更新机制与评测协议上差异巨大,传统的 “短期 / 长期记忆” 划分已无法有效刻画当代 agent memory 系统的复杂性
- 同时,“LLM memory”,“RAG” 和 “context engineering” 等概念在实践中频繁被混用,进一步加剧了认知混乱。
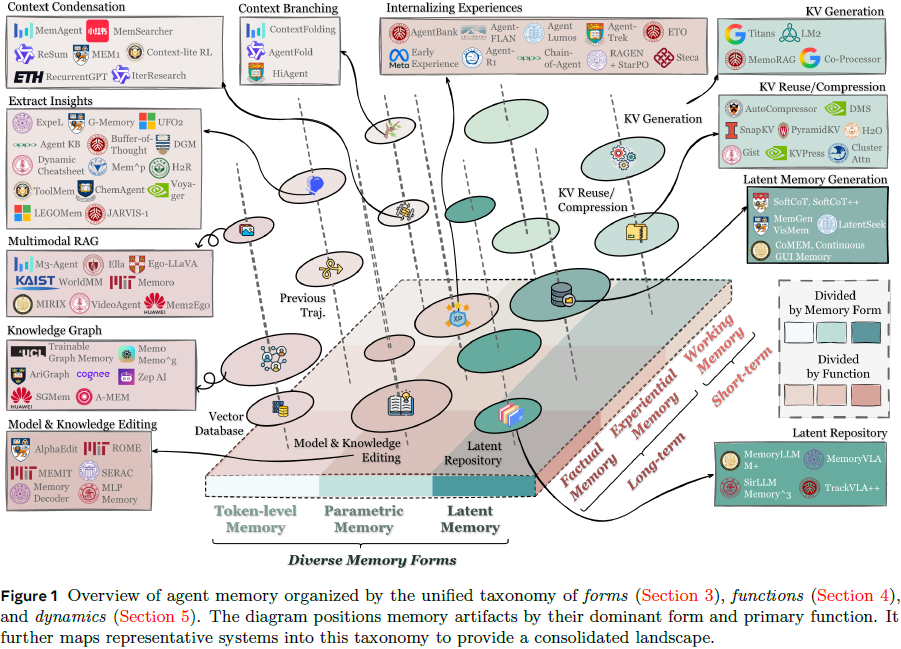
基于此,本文提出以 Forms–Functions–Dynamics(形式–功能–动态) 为核心的统一分析框架,系统梳理 agent memory 的结构形态、功能角色与演化机制:
-
新框架:提出从 形式、功能 和 动态 三个维度系统审视 agent 记忆。
-
形式(Forms):识别三种主要实现方式:token 级、参数化 和 潜(latent)记忆。
-
功能(Functions):提出细粒度分类:事实性记忆、经验性记忆和工作记忆。
-
动态(Dynamics):分析记忆如何随时间形成、演化和检索。
-
资源:汇总了代表性基准测试和开源框架。
-
前沿:探讨了自动化记忆设计、强化学习集成、多模态记忆、多 agent 共享记忆及可信度等未来方向。
2. 预备知识:Agent 与 Memory 的形式化定义
2.1 基于 LLM 的 Agent 系统
本文将 agent 建模为在环境中随时间演化的决策系统。在单 agent 或多 agent 场景下,agent 在每个时间步接收来自环境的观测,并在任务约束下生成动作。
与传统 RL agent 不同,LLM agent 的动作空间涵盖:
-
自然语言生成(回答、解释、中间推理)
-
工具调用(搜索、代码执行、API 调用)
-
显式规划与子目标分解
-
环境控制(导航、文件修改、状态更新)
-
多 agent 通信与协作
在该框架中,LLM 充当条件策略 π,memory 作为外部或内部状态参与决策。
2.2 Agent 记忆系统
由于单次观察信息有限,agent 需要一个 记忆系统 来存取过往信息。该系统可以看作一个随时间演化的记忆状态,可以是文本缓冲区、向量数据库、图结构或混合形式。
记忆的生命周期包含三个核心操作:
-
记忆形成:从当前交互信息(工具输出、推理痕迹等)中筛选有长期价值的内容,形成记忆候选。
-
记忆演化:将新形成的记忆整合到现有记忆库中,可能涉及合并冗余、解决冲突、丢弃无用信息或重组结构。
-
记忆检索:根据当前观察和任务,从记忆库中查询并返回相关的记忆内容,供策略使用。
关键在于,长期和短期记忆效应并非源于两个独立的模块,而是源于上述三个操作在时间尺度上的不同调用模式。例如,在一个任务内部频繁形成和检索记忆表现为短期工作记忆(Working Memory);在任务结束后进行演化整合,则形成长期经验积累(Experiential Memory)。
2.3 与其他关键概念的比较
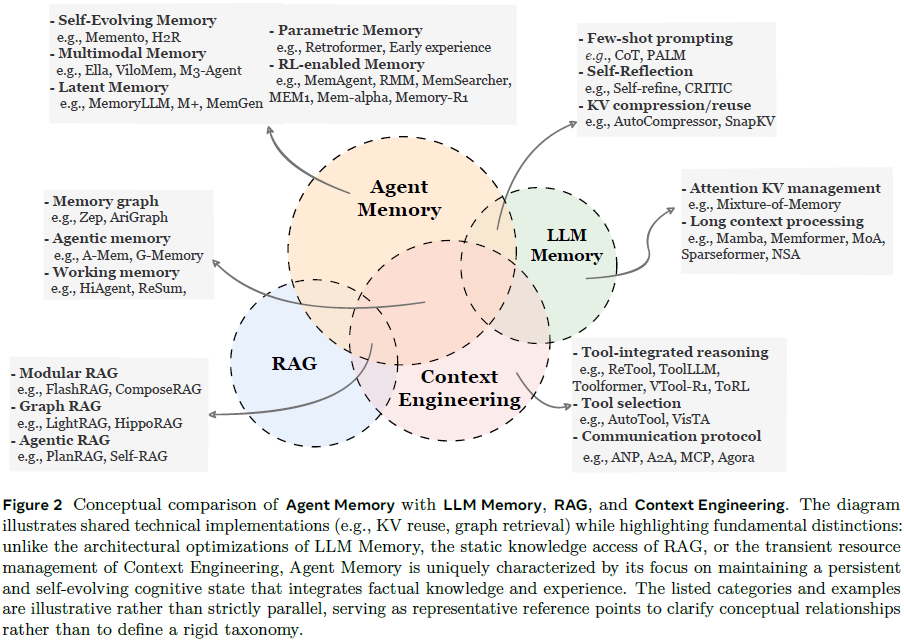
为避免混淆,本节厘清 agent 记忆与三个易混概念的关系:
1)Agent Memory vs. LLM Memory
- LLM Memory:主要关注模型内部机制(KV cache、长上下文建模、结构架构改造)
- Agent Memory:关注 agent 层面的持久化认知状态,支持跨任务、跨时间的经验积累
历史上许多被称为 “LLM memory” 的工作(如 MemGPT、MemoryBank)本质上是 agent memory 的早期实例。,在当前语境下更合理地归类为 agent memory。
2)Agent Memory vs.检索增强生成 (RAG):
它们都涉及构建和利用外部信息库来增强 LLM。
区别在于:
- 传统 RAG 主要从 静态知识源(如文档库)检索,以补充事实、减少幻觉。
- Agent Memory 则是在 agent 与环境的 持续交互 中动态构建和更新的,存储的是 agent 自身行动和环境反馈产生的新信息。
- 简单说,RAG 是 “读外部书”,Agent Memory 是 “写自己的日记”。
随着 Agentic RAG 的兴起,Agent Memory 与 Agentic RAG 在工程实现上高度重叠:
- Agentic RAG 将检索整合到自主决策循环中,由 LLM agent 主动控制检索时机、方式与内容。这类系统常采用迭代查询、多步规划或自主搜索流程,使 agent 能通过审慎推理优化信息需求。
- 共同点:两者均涉及与外部信息存储的自主交互,都支持多步优化流程,并可将检索所得融入后续推理。
- 关键区别 在于,Agentic RAG 通常作用于外部且常为任务专用的数据库,而 Agent Memory 则维护一个内部、持久且自我演化的记忆库,能够跨任务积累知识。
3)Agent Memory vs. 上下文工程(Context Engineering):
在技术实现上,尤其是在管理有限上下文窗口、压缩信息等方面,两者使用相似方法(如摘要、token 修剪)。
区别在于:
- 上下文工程 是一种 资源管理 范式,将上下文窗口视为有限资源,优化其中信息的格式、调度和呈现,以确保执行效率。
- Agent Memory 则是一种 认知建模 范式,关注如何维持一个 持久且自我演进 的认知状态,管理 agent “知道什么” 和 “经历过什么”。
- 前者是优化 “输入界面”,后者是构建 “内在心智”。
3. 形式(Form):记忆以什么形式存在?
记忆可以以不同的架构形式实现。根据信息存储的位置和方式,可分为三类:
3.1 token 级记忆
将信息存储为 显式、离散、可外部访问和编辑 的单元(如文本片段、代码块)。这是最常见、最易解释的形式。
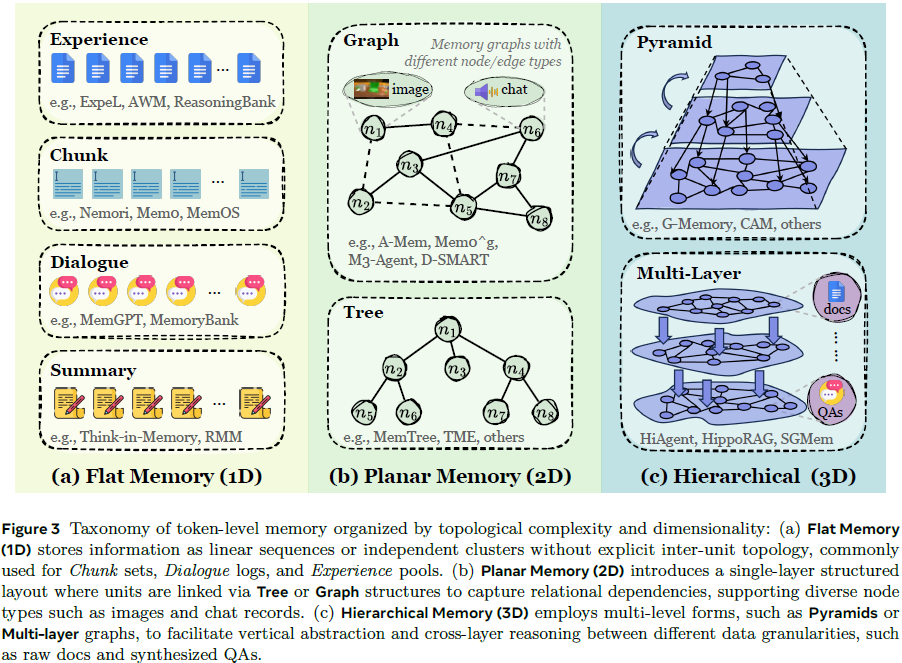
根据组织结构可进一步划分为:
-
扁平记忆(1D):简单堆叠记忆单元,无显式结构(如对话日志列表)。
-
平面记忆(2D):在单层内组织单元,具有明确结构(如图、树、表),能捕捉关系(因果、时间依赖等)。
-
层次记忆(3D):跨多层组织单元,层间有链接,形成立体结构,支持不同抽象层级的信息管理(从原始事实 → 概念 → 任务级知识的纵向抽象)。
token 级记忆:符号化、可寻址、透明。适合需要 显式推理、可控性、可审计性 的场景,如聊天机器人、个性化推荐、企业知识库、高风险领域(法律、合规)。
3.2 参数化记忆
参数化记忆(Parametric Memory)是指将信息 编码在模型参数 中,通常通过:
-
持续训练 / 微调
-
经验蒸馏
-
RL 更新策略
知识以分布式统计模式存储,在模型前向计算中被 隐式 访问。
参数化记忆可分为两类:
1)内部参数化记忆:
- 直接修改基础模型的原始参数来融入知识(如在预训练、后训练阶段注入知识)。
- 优点是推理无额外开销,缺点是更新成本高且易遗忘旧知识。
2)外部参数化记忆:
- 将知识存储在 额外的参数模块 中(如适配器、LoRA、辅助 LM),不修改原模型权重。
- 优点是模块化、可插拔、避免灾难性遗忘,缺点是需与模型内部表示有效对接。
参数化记忆:隐式、抽象、可泛化。适合需要 概念理解、模式归纳和流畅端到端处理 的任务,如角色扮演、数学推理、代码生成、对齐人类价值观。
3.3 潜记忆
潜记忆(Latent memory)是指将信息存储在模型的 内部隐藏状态或表征 中(如注意力 KV 缓存、潜嵌入)。它不暴露为可读文本,而是机器原生、高密度的连续表示。
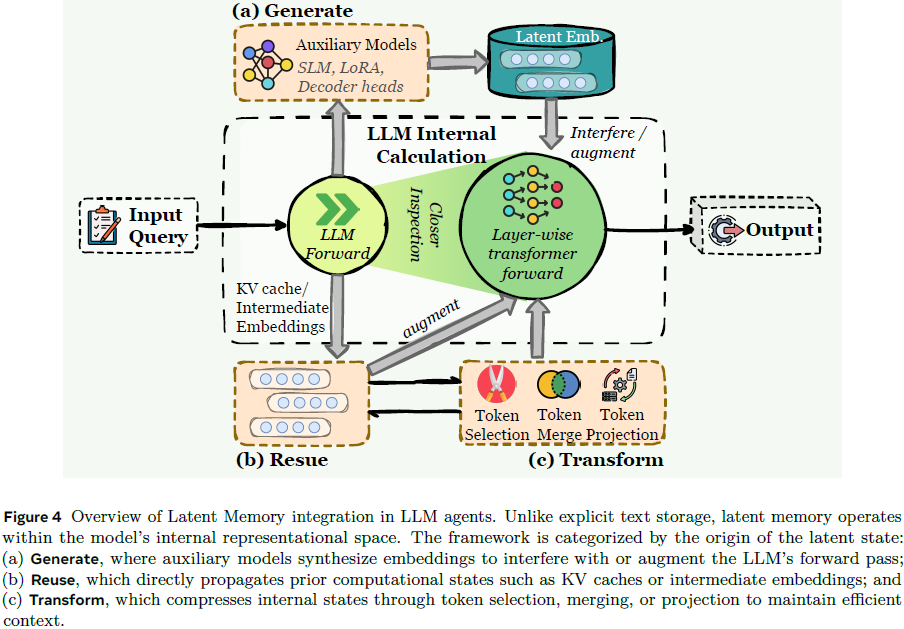
根据潜状态(latent state)是如何形成并被引入 agent 中,潜记忆可分为三类:
-
生成:通过独立模块生成新的潜表征(如压缩长上下文为几个 “概要 token”)作为记忆。
-
复用:直接复用先前计算的内部状态,最常见的是 复用 KV 缓存。
-
转换:对现有潜状态进行压缩、修剪或聚合,以提升效率(如只保留最重要的注意力头)。
潜记忆:高效、高密度、对机器友好但可解释性差。适合 对性能和效率要求高、需跨模态融合、或涉及隐私敏感信息 的场景,如多模态 agent、边缘设备部署、实时交互系统。
4. 功能(Function):为什么 Agent 需要记忆?
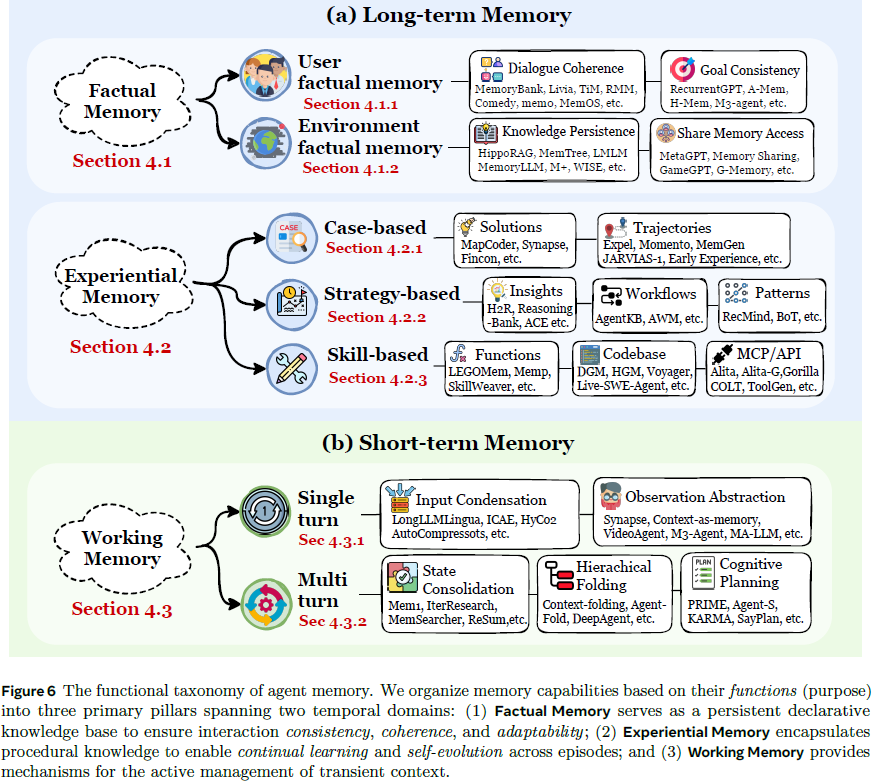
记忆的功能远不止 “记住过去”。从 “为什么需要” 的角度可将 agent 记忆分为三大类:
4.1 事实记忆
事实记忆(Factual Memory):存储关于过去事件、用户信息、环境状态的 显式、可陈述的事实。是确保交互 连贯性、一致性和适应性 的基础。
- 连贯性:体现在强大的上下文感知能力上。智能体能够回忆并整合相关的交互历史,引用用户过往的输入信息,并保持话题的连续性,从而确保其回应构成逻辑关联的对话,而非孤立的话语片段。
- 一致性:意味着其行为和自我表达能保持长期稳定。通过对用户特定信息及自身承诺维持持久的内部状态,智能体避免了自相矛盾和立场随意变更。
- 适应性:表现为基于存储的用户画像和历史反馈来个性化调整行为的能力。因此,其回应风格和决策过程会逐步契合用户的具体需求与特征。
事实记忆类似于人类的 陈述性记忆(declarative memory),包括 “情景记忆”(具体经历)和 “语义记忆”(通用知识)。
根据事实记忆所指代的主要实体(entity),可突出两个核心应用领域:
1)用户事实性记忆:维持与特定用户交互的一致性。例如:
-
对话连贯性:记住用户喜好、历史对话,避免重复提问或立场矛盾。
-
目标一致性:在长程任务中跟踪和更新任务状态与约束,防止目标漂移。
2)环境事实性记忆:维持与外部世界的一致性。例如:
-
知识持久化:存储和检索文档知识、领域事实、代码库状态。
-
共享访问:在多 agent 系统中,维护一个共享的记忆库,以协调行动、避免冗余工作、保持状态一致。
4.2 经验性记忆
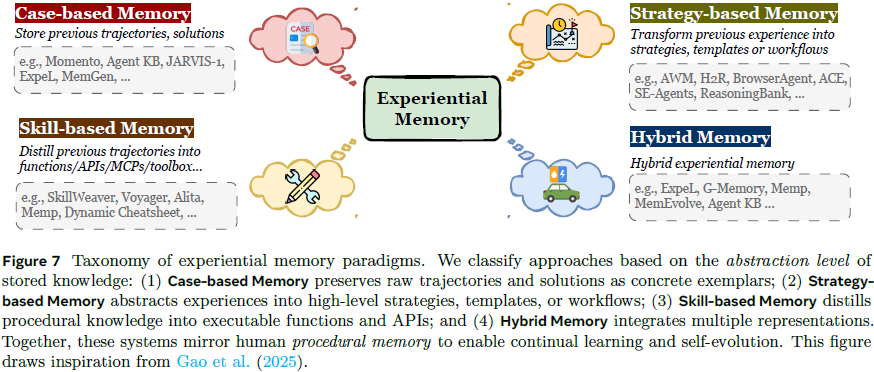
经验性记忆(Experiential Memory):存储从过去 交互轨迹 中抽象出来的 程序性知识和策略。支持 持续学习(continual learning)和自我进化(self-evolution),使 agent 能从成功和失败中学习。
类似于人类的 非陈述性 / 程序性记忆(如技能和习惯)。
依据所存储信息的抽象层级(abstraction level)可对经验记忆进行分类:
- 基于案例(Case)的记忆:存储 原始或 minimally 处理 的交互轨迹和解决方案,作为可复用的具体示例。
- 基于策略(Strategy)的记忆:从轨迹中蒸馏出 可迁移的推理模式、工作流或高层洞见(insight),用于指导新任务的规划。
- 基于技能(Skill)的记忆:将经验封装为 可执行的程序单元,如代码片段、API 调用、工具使用脚本。这是 agent 能力的直接体现。
- 混合记忆:高级 agent 通常综合使用以上多种形式,形成互补的记忆体系。
4.3 工作记忆
工作记忆(Working Memory):在 单个任务或会话期间,对 活跃上下文进行主动管理和操作 的有限容量机制。目标是在有限的注意力预算内,最大化任务相关信息密度,抑制冗余和噪声。
它将 LLM 的上下文窗口从被动缓冲区转变为可控的工作空间。
根据交互动态,工作记忆可分为:
1)单轮工作记忆:处理 单次输入 中的大量信息(如超长文档、视频流)。主要技术包括:
- 输入凝缩:通过重要性选择或编码压缩,减少物理 token 数。
- 观测抽象:将原始观测(如网页 DOM、视频帧)转换为结构化的语义摘要。
2)多轮工作记忆:在 连续交互 中维护 任务状态和历史相关性。主要技术包括:
- 状态巩固:将增长的历史流动态压缩为固定大小的状态表示。
- 层次折叠:按子目标分解任务,只保留活跃子目标的细节,将已完成部分折叠为摘要。
- 认知规划:将外部化的 计划或世界模型 本身作为工作记忆的核心,指导未来行动。
5. 动态(Dynamics):记忆如何形成、演化与使用?
前两章从 静态视角 分析了记忆的 “载体”(形式)和 “目的”(功能)。本章则关注记忆系统的 动态生命周期,即记忆如何随时间形成、更新(演化)和被使用(检索)。这是 agent 记忆区别于静态数据库的核心。
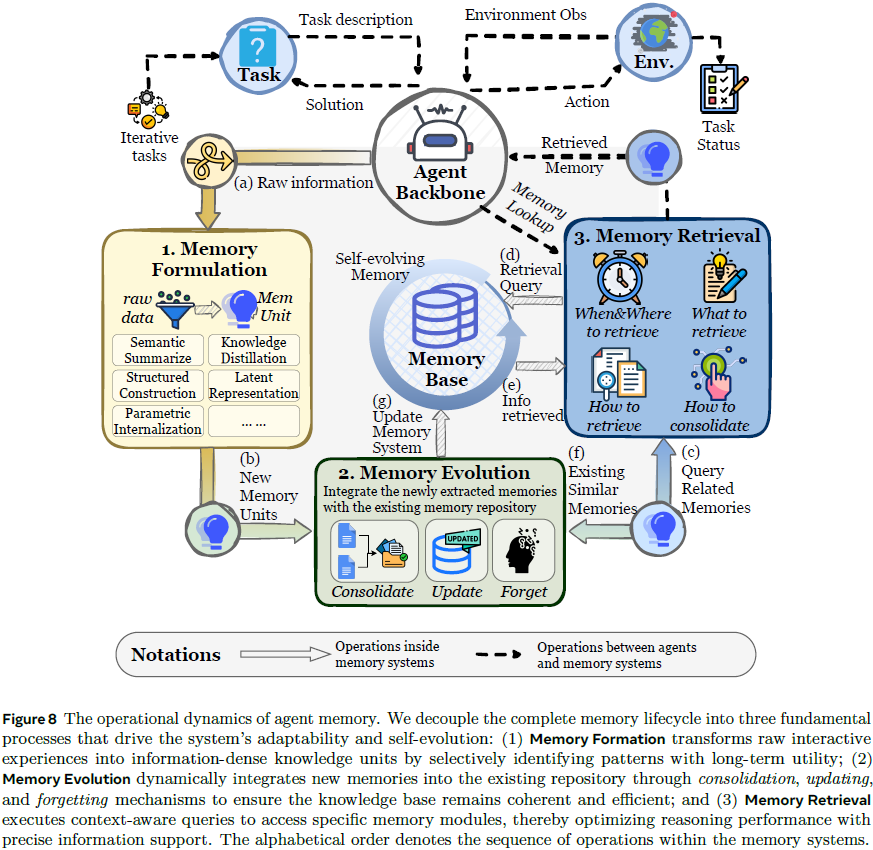
记忆的生命周期包含三个相互关联的基本过程:
5.1 记忆形成
将原始的、冗长的交互数据转化为紧凑、可存储的知识单元。核心是 选择性提取 具有长期价值的信息,而非记录全部历史。
主要方法有五类:
1)语义摘要:将长文本或对话压缩为保留核心语义的摘要(如每日对话总结)。
- 增量式:采用 时间整合 机制,持续将新观测到的信息与现有摘要相融合,从而生成一个不断演化的全局语义表征。
- 分区式(Partitioned):采用 空间分解 机制,将信息划分至不同的语义分区,并为每个分区生成独立的摘要。
2)知识蒸馏:从原始数据中提取特定类型的知识。
-
事实性知识蒸馏:从交互中提取关于用户或环境的明确事实(如用户偏好、物体位置)。
-
经验性知识蒸馏:从成功或失败的轨迹中提炼出策略、工作流或洞见(如“从错误中反思”)。
3)结构化构建:将非结构化数据组织成具有明确拓扑的结构(如图、树)。
-
实体(entity)级构建:提取实体和关系,构建知识图谱。
-
块(chunk)级构建:将文本块或记忆项组织成层次树或图结构。
4)潜表征(Latent Representation):将经验直接编码为机器原生的连续向量或隐藏状态(如特殊记忆 token、压缩后的 embedding)。这种方式信息密度高,利于机器处理,但可解释性差。
5)参数化内化:通过修改模型参数,将记忆直接固化到模型中。
-
知识内化:通过 “模型编辑” 技术注入新事实。
-
能力内化:通过训练(如SFT、RLHF)将解决问题的策略内化为模型本能。
5.2 记忆演化
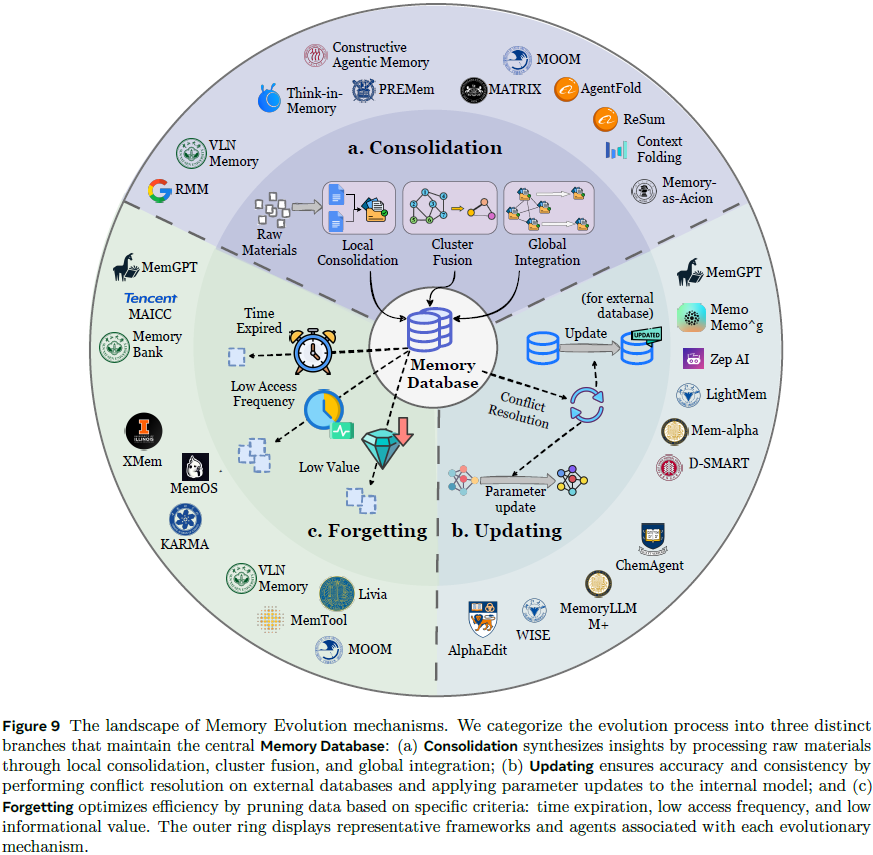
将新形成的记忆与现有记忆库整合,确保记忆库的 紧凑性、一致性和时效性。
包含三个机制:
1)记忆巩固:将新的短期记忆整合到长期知识结构中,形成更泛化的图式。
- 局部整合:侧重于对高度相似的记忆片段进行细粒度更新。
- 集群(Cluster)级融合:采用集群级融合对于捕捉跨实例的规律性至关重要,尤其是在记忆规模增长时。
- 全局整合:此操作执行整体性整合,旨在维持全局连贯性,并从累积经验中提炼出系统级的洞见。
2)记忆更新:当新旧记忆冲突或信息过时,对记忆进行修正。
-
外部记忆更新:修改向量数据库或知识图谱中的条目(如标记失效、替换)。
-
模型编辑:直接修改模型参数以更新内部知识。
3)记忆遗忘:主动移除过时、冗余或低价值信息以释放容量。
-
基于时间:遵循遗忘曲线,丢弃最旧记忆。
-
基于频率:移除最近最少使用的记忆。
-
基于重要性:综合语义、情感等多维度评估,保留高价值记忆。
5.3 记忆检索
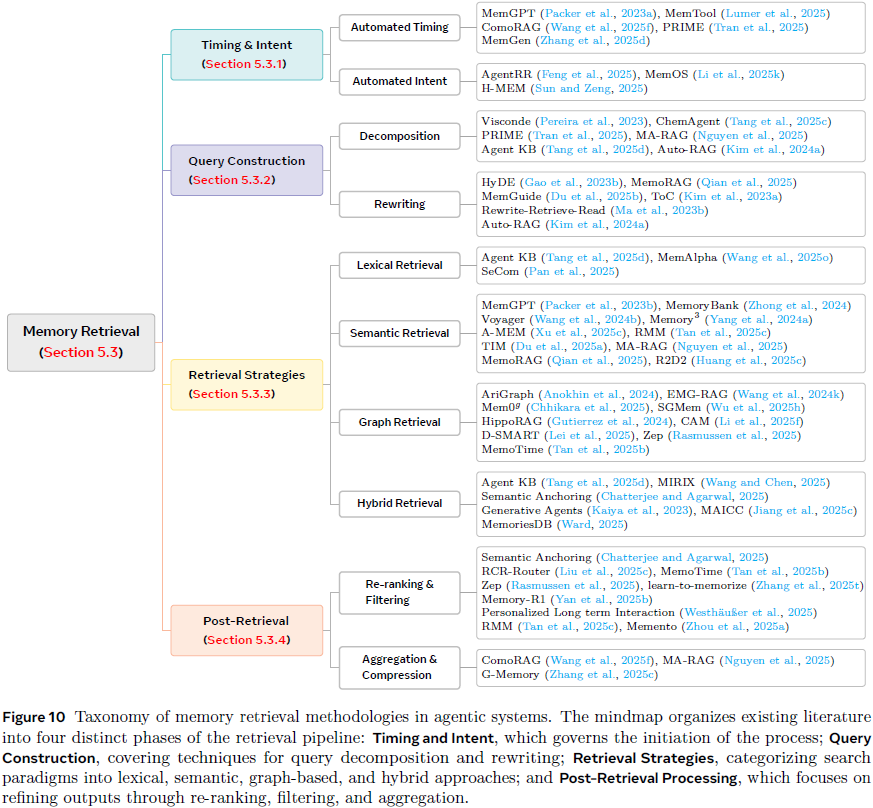
在推理时,从记忆库中高效、准确地获取相关信息。
这是一个多阶段管道:
1)检索时机与意图:决定 何时 触发检索以及 检索哪个 记忆库。从固定检索发展到由 agent 自主决策 触发(如感到知识不足时)。
2)查询(Query)构建:将原始用户查询转化为更适合检索的信号。
-
查询分解:将复杂问题拆分成多个子查询,分别检索。
-
查询重写:生成假设性答案或更精确的查询表述,以更好地匹配记忆索引。
3)检索策略:执行搜索的技术。
-
词汇检索:基于关键词匹配(如 BM25)。
-
语义检索:基于向量相似度匹配(主流)。
-
图检索:在图结构上遍历、扩展,适合多跳推理。
-
生成式检索:直接生成相关文档的标识符(尚不成熟)。
-
混合检索:结合多种策略以获得更好效果。
4)检索后处理:对检索结果进行精炼,再送入 LLM。
-
重排序与过滤:根据相关性、时效性等对结果排序,剔除噪声。
-
聚合与压缩:将多个相关片段合并、去重,生成一个简洁、连贯的上下文。
6. 资源与框架
6.1 基准测试与数据集
为评估 agent 记忆能力,研究者开发或适配了一系列基准:
1)记忆 / 终身学习专用基准:明确测试长期记忆保持、更新和利用能力。例如:
-
MemBench:交互式场景记忆。
-
LoCoMo:长对话记忆连贯性。
-
StreamBench:持续在线学习。
2)其他相关基准:虽不是专为记忆设计,但其长程、多步特性对记忆提出隐式要求。例如:
-
WebArena / SWE-bench:长程网页交互或代码修复,需记住多步状态。
-
GAIA:深度研究任务,需综合多源信息。
6.2 开源框架
一个快速发展的开源记忆框架生态,正在为构建记忆增强的 LLM agents 提供可复用的基础设施。
代表性框架:
-
MemGPT:采用操作系统隐喻,管理分层(长/短期)记忆。
-
Mem0:提供记忆操作(增、删、改、查)的标准接口。
-
Zep:实现为时序知识图谱,支持复杂记忆查询。
-
Pinecone / Chroma:提供向量数据库后端,常用于存储记忆嵌入。
趋势:框架正从简单的向量存储,向支持 结构化记忆、多模态 和 自主管理 演进。
7. 观点与前沿
本章展望 agent 记忆研究的未来范式转变和关键挑战。
7.1 记忆检索 vs. 记忆生成
回顾:传统范式是 “检索” 现有记忆。新趋势是 “生成” 适应当前上下文的新记忆表征(如动态合成记忆 token)。
展望:未来生成式记忆应是 上下文自适应、能融合多模态信号,并且是 可通过学习优化 的。
7.2 自动化记忆管理
回顾:当前系统大多依赖人工规则管理记忆(存什么、何时用)。近期研究让 agent 通过 “工具调用” 自主管理部分记忆操作。
展望:目标是实现 全自动的记忆管理,让 agent 能自主构建、演化和检索记忆,形成自组织的记忆架构。
7.3 强化学习遇见 agent 记忆
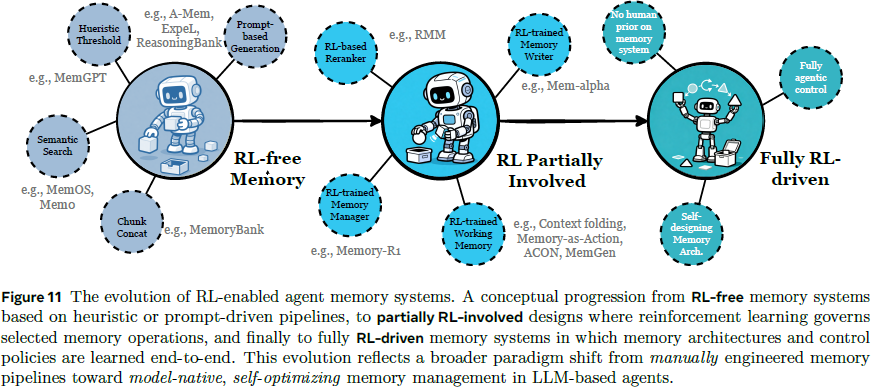
回顾:记忆系统正从启发式管道,过渡到部分环节(如记忆压缩、更新决策)由强化学习优化。
展望:未来可能出现 完全由 RL 驱动 的记忆系统,其记忆架构和控制策略均由端到端学习产生,最小化人为先验。
7.4 多模态记忆
回顾:研究已从文本记忆扩展到视觉、视频记忆,以支持具身 agent 和跨模态一致性生成。
展望:挑战在于设计 真正支持全模态 的统一记忆表征,以支持在丰富真实世界中的稳健交互。
7.5 多 agent 系统中的共享记忆
回顾:从 agent 间孤立记忆加通信,发展到中央共享记忆库(如黑板系统),以减少冗余、促进协作。
展望:共享记忆需进化为 主动管理、适应性的集体表征,并支持基于角色和信任的访问控制,以及学习驱动的同步策略。
7.6 用于世界模型的记忆
回顾:在生成无限长、交互式内容的世界模型中,记忆是维持长期一致性的基石。技术从简单帧缓存,发展到 状态空间模型压缩和显式记忆银行检索。
展望:未来可能采用 双系统架构(快速直觉层+慢速推理层),并发展 主动记忆管理 策略,使记忆成为可查询、可维护的世界状态。
7.7 可信记忆
回顾:记忆引入了隐私、安全、可解释性等新信任挑战(如记忆泄露隐私、无法追溯决策依据)。
展望:可信记忆需围绕三大支柱构建:
-
隐私保护:细粒度访问控制、加密存储、用户可控遗忘。
-
可解释性:记忆访问路径追溯、决策影响分析。
-
抗幻觉:冲突检测、不确定性感知生成、多agent交叉验证。
7.8 与人类认知的联系
回顾:当前 agent 记忆架构(工作记忆+长期记忆)与人类记忆模型(如 Atkinson-Shiffrin 模型)有结构性相似。
展望:关键差距在于人类记忆是 重构性 的,而非精确回放。未来 agent 需引入类似 离线巩固(如 “睡眠” 期重组记忆)和 生成式重构 的机制,以实现更类人的动态记忆和知识内化。
8. 结论
本综述通过 “形式 – 功能 – 动态” 的统一框架,系统梳理了 AI agent 记忆的研究全景。
记忆并非附加组件,而是实现 持久、自适应、具身智能 的基石。未来,向 生成式、自主管理、学习驱动 记忆系统的范式转变,结合对 多模态、多 agent 协作、世界建模及可信度 的深入探索,有望将 LLM 从强大但静态的生成器,转变为 能够持续交互、自我演进并随时间推移进行原则性推理的 agent。