系列专栏: 从 0 开始学习 Redis:底层原理与高并发实战 适合读者: Java 后端初学者、计算机专业学生、准备后端实习的开发者 技术环境: Redis 7.x、JDK 17、Spring Boot 3.x(Java 示例使用 Spring Data Redis) 核心关键词: Redis、单线程、事件驱动、I/O 多路复用、epoll、Pipeline
一、引言:Redis 为什么能这么快?
在 Java 后端项目中,Redis 经常被用来做缓存、计数器、排行榜、分布式锁和热点数据存储。
很多人在刚接触 Redis 时,都会听到一句话:
Redis 之所以快,是因为它是单线程的,而且数据都在内存中。
这句话只说对了一部分。
Redis 的高性能并不是由某一个原因决定的。数据主要存放在内存中、数据结构设计、事件驱动网络模型、命令执行方式,以及客户端减少网络往返等因素,共同影响最终性能。
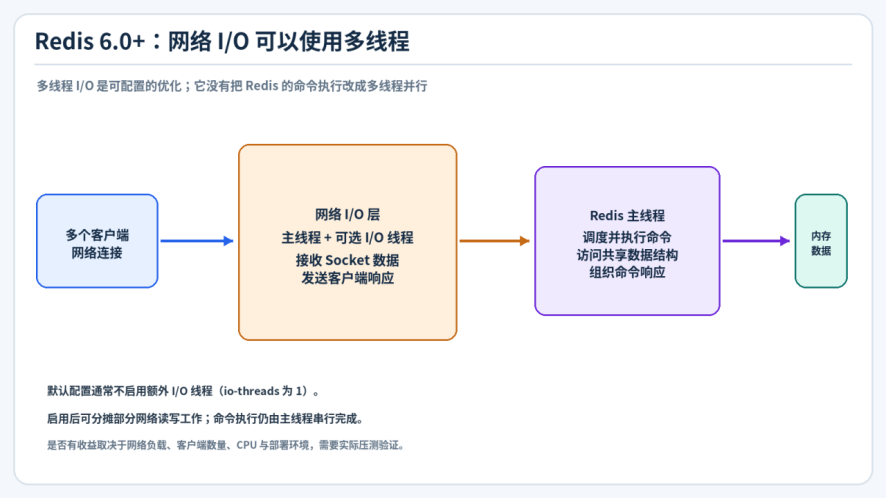
更重要的是,“Redis 是单线程”并不意味着 Redis 整个进程只有一个线程。准确地说,Redis 采用以单线程命令执行为核心的架构,同时也会使用后台线程处理部分任务;从 Redis 6.0 开始,还可以配置网络 I/O 多线程。
本文从一条 GET 命令出发,沿着客户端到服务端的请求路径,理解 Redis 的核心架构。
二、学习目标与环境准备
读完本文,你应该能够回答:
2.1 环境说明
本文以 Redis 7.x 的常见部署方式为背景,命令行示例使用 redis-cli。Java 部分使用 Spring Boot 3.x 常见的 StringRedisTemplate。
如果本机已经安装 Docker,可以启动一个用于学习的 Redis 7 容器:
docker run -d \\
–name redis-study \\
-p 6379:6379 \\
redis:7
查看容器是否正在运行:
docker ps
进入 Redis 命令行:
docker exec -it redis-study redis-cli
以上是启动命令,不代表已经在你的机器上执行。若本机没有安装 Docker,也可以使用 Redis 官方提供的其他安装方式。
三、Redis 的高性能来自哪里?
先把影响 Redis 性能的因素拆开看。
3.1 数据主要存放在内存中
Redis 是以内存为主要工作数据集的存储系统。执行普通的 GET、SET 等命令时,Redis 通常直接访问内存中的数据结构,不需要像传统磁盘数据库那样为每次查询都进行磁盘随机读取。
可以用一个简单的类比理解:
- 内存: 桌面上随手可以拿到的资料;
- 磁盘: 需要打开柜子、找到文件再取出来的资料。
内存访问通常比磁盘访问快得多,但这不代表 Redis 完全不使用磁盘。Redis 仍然可以通过 RDB、AOF 等机制持久化数据;持久化也可能带来额外的 CPU、内存和 I/O 开销。
3.2 数据结构针对常见操作进行了设计
Redis 并不是把所有数据都简单存成普通字符串。它为不同场景提供了 String、Hash、List、Set、ZSet 等数据类型,并为这些类型设计了相应的底层实现。
例如:
- String 可以用于缓存字符串、数字和序列化后的对象;
- Hash 适合表达一个对象的多个字段;
- Set 适合去重和集合运算;
- ZSet 可以按分数维护有序成员,常用于排行榜。
不同命令的时间复杂度并不相同。GET 通常是 O(1),而某些需要遍历大量元素的命令可能是 O(N) 或更高。
因此,不能简单认为“Redis 所有操作都是 O(1)”。使用命令前应查看对应命令文档中的复杂度说明。
3.3 事件驱动与 I/O 多路复用减少连接等待开销
Redis 服务端需要同时面对很多客户端连接。如果每个连接都由一个线程阻塞等待数据,那么连接数量增加时,线程数量和调度开销也可能随之增加。
Redis 的典型网络处理方式是:使用非阻塞 Socket 和 I/O 多路复用机制,监听多个连接的读写就绪事件,再由事件循环处理已经就绪的连接。
这使得 Redis 不必为每个空闲连接都分配一个专门阻塞等待的命令执行线程。
3.4 命令执行以单线程串行为核心
在默认的命令执行模型中,Redis 主线程按顺序执行命令。
这样做的一个重要好处是:对共享数据结构的命令修改不需要在每条普通命令周围都设计复杂的并发锁协调机制,也减少了多线程频繁切换带来的开销。
但代价也很明显:一个执行时间很长的命令,可能拖慢后续其他客户端命令的处理。
3.5 减少不必要的网络往返
Redis 命令本身可能很快,但客户端和 Redis 服务端之间仍然存在网络通信开销。
如果 Java 程序连续执行 100 次 Redis 命令,每次都发送请求、等待响应,再发送下一次请求,就会产生多次网络往返。
Pipeline 可以把多条命令批量发送,减少等待每条命令响应的次数。它优化的是通信过程,不是把 Redis 命令变成并行执行。
四、一条 Redis 命令的完整执行过程
以客户端执行下面的命令为例:
GET user:1001:name
从逻辑上看,一条命令会经历以下过程:

4.1 客户端发送命令
Java 应用通常不会自己拼接 TCP 数据包,而是通过 Redis 客户端库完成连接管理、协议编码和结果解析。
例如,使用 StringRedisTemplate:
String value = stringRedisTemplate
.opsForValue()
.get("user:1001:name");
从业务代码看,这只是一行 Java 调用;但底层客户端需要通过连接向 Redis 发送命令,并读取服务端返回的数据。
4.2 Redis 如何知道哪个客户端有数据可读?
这就涉及 I/O 多路复用。
Redis 不需要不断地对每一个客户端执行阻塞式读取,而是把多个 Socket 的读写事件交给操作系统提供的 I/O 多路复用机制监控。
当某些 Socket 已经具备读取或写入条件时,操作系统会把就绪事件通知 Redis,Redis 再处理对应的事件。
4.3 Redis 执行命令并返回结果
以 GET 为例,Redis 在命令执行阶段查找对应的键,并根据数据类型组织响应。
如果键存在,返回对应值;如果键不存在,则返回空值。
需要注意:Redis 协议中的“空值”与 Java 中的 null 是不同层面的表达。客户端库会负责把 Redis 响应转换成 Java 侧的数据类型。
五、I/O 多路复用:Redis 如何管理大量连接?
5.1 为什么不为每个连接创建一个线程?
假设有 10,000 个客户端连接,其中大部分连接可能只是保持在线,当前并没有发送命令。如果每个连接都绑定一个专门的线程,那么大量线程可能长时间等待网络数据。
线程并不是免费的资源。线程数量增加会带来:
- 线程栈等内存开销;
- 操作系统调度成本;
- 上下文切换开销;
- 大量线程同时竞争 CPU 的问题。
Redis 的事件驱动模型采用另一种思路:让一个事件循环关注多个连接,只有连接发生感兴趣的事件时,才去处理对应的 I/O。
5.2 什么是 I/O 多路复用?
I/O 多路复用(I/O Multiplexing)是一种让一个线程监控多个 I/O 对象是否就绪的机制。
这里的“就绪”可以简单理解为:
- Socket 可读: 当前可以尝试读取数据;
- Socket 可写: 当前可以尝试写入数据。
在不同操作系统上,常见的 I/O 多路复用接口包括:
| select | 多种 Unix-like 系统 | 经典 I/O 多路复用接口,有描述符数量等方面的限制 |
| poll | 多种 Unix-like 系统 | 使用 pollfd 数组描述需要监控的文件描述符 |
| epoll | Linux | Linux 提供的 I/O 事件通知机制 |
| kqueue | BSD、macOS | BSD 系统常见的事件通知机制 |
Redis 会根据平台选择可用的事件处理后端。不要把 Redis 与某一个操作系统接口永久绑定:Linux 上常见的是 epoll,但其他平台并不一定使用 epoll。
5.3 用生活例子理解
假设你在一家餐厅做服务员,需要照看 20 张桌子。
方式一:一个服务员只负责一张桌子。
如果顾客暂时没有需求,服务员也只能站在旁边等待。
方式二:一个服务员负责观察 20 张桌子。
哪张桌子举手了,就先过去处理哪张桌子的需求;没有需求时,不需要一直站在某张桌子旁边。
I/O 多路复用就有点类似第二种方式:
- 客户端连接:餐厅中的桌子;
- Socket:每张桌子的通信通道;
- 操作系统事件通知:告诉服务端哪些连接已经就绪;
- Redis 事件循环:根据通知处理对应连接。

5.4 I/O 多路复用不等于多线程并行执行命令
这是一个非常重要的区别。
I/O 多路复用解决的是:
一个线程如何高效地等待和管理多个连接的 I/O 事件?
它并没有解决:
如何让多个 Redis 命令同时在多个 CPU 核心上并行执行?
在 Redis 的默认命令执行模型中,即使多个客户端的 Socket 同时变得可读,命令执行仍然由主线程按顺序处理。
因此:
- 多个连接可以同时处于等待状态;
- 多个连接可以在同一轮事件处理中陆续被处理;
- 但不能据此认为多个普通 Redis 命令在默认模型下并行执行。
六、Redis 为什么主要采用单线程执行命令?
6.1 单线程执行带来的优势
第一,减少锁竞争。
如果多个线程可以同时修改同一份 Redis 数据,就需要考虑线程安全问题,例如加锁、解锁、锁粒度和死锁等。
Redis 将普通命令执行集中在主线程中串行处理,可以减少共享数据结构上的并发修改问题。
第二,减少线程上下文切换。
线程切换需要操作系统保存和恢复线程执行状态。高频切换会带来额外成本。
单线程命令执行模型减少了这部分开销。
第三,命令执行逻辑更容易维护。
普通命令在主线程中按顺序执行,很多数据结构操作不必额外考虑多个命令同时修改同一数据的情况。
6.2 单线程不意味着 Redis 不支持并发客户端
要区分两个概念:
- 并发连接: 多个客户端可以同时连接 Redis,并等待或发送请求。
- 并行执行: 多个命令在多个 CPU 核心上同时执行。
Redis 可以通过事件驱动模型管理大量客户端连接,但默认命令执行仍然以单线程串行为核心。
这也是为什么“Redis 单线程,所以只能有一个客户端使用”是错误的。
6.3 单线程的局限:慢命令会影响其他客户端
假设 Redis 正在执行一个需要遍历大量元素的命令。
由于普通命令执行是串行的,在这个命令执行完成之前,其他客户端的普通命令可能需要等待。
例如:
KEYS *
KEYS 会遍历当前数据库中的键。键数量很多时,它可能消耗较长时间,影响服务端响应其他请求。
生产环境中不应该把 KEYS * 当作常规遍历手段。需要渐进式遍历时,可以考虑 SCAN,但也要理解 SCAN 的遍历语义和可能返回重复元素等特点。
其他可能需要关注的命令包括:
- 对大型集合执行复杂集合运算;
- 对很大的 List 执行需要移动大量元素的操作;
- 对很大的 ZSet 执行复杂范围或聚合操作。
结论:Redis 单线程执行命令的前提之一,是尽量让每条命令的执行时间足够短。
官方延迟排查文档也特别指出,慢命令可能阻塞后续请求,并建议通过 Slow Log 等工具定位问题。
七、Redis 6.0 为什么又引入了多线程 I/O?
看到这里可能会产生一个疑问:
既然 Redis 主要采用单线程,为什么 Redis 6.0 又引入了多线程 I/O?
原因是:Redis 的命令执行很快时,网络读写本身可能成为性能瓶颈。
一条命令从客户端到服务端,不仅要执行数据结构操作,还需要完成 Socket 读取、响应数据写回等工作。
当客户端数量多、网络流量大时,网络 I/O 会占用主线程一定的处理时间。
Redis 6.0 引入了可配置的 I/O 多线程机制,可以将部分客户端 Socket 的读写工作分摊到 I/O 线程。
7.1 多线程 I/O 与命令执行有什么区别?
可以这样理解:
- 网络 I/O 线程: 帮助处理客户端连接上的网络读写工作;
- Redis 主线程: 仍然负责核心命令执行和共享数据结构访问。
因此,不能把 Redis 6.0 的多线程 I/O 理解成“多个线程同时执行 GET、SET 命令”。
7.2 如何配置 I/O 多线程?
Redis 配置文件中可以设置:
# 设置网络 I/O 线程数量
io-threads 4
# 是否也使用 I/O 线程处理读取
io-threads-do-reads yes
需要理解几个细节:
这两个配置项不能只看名字就随意调整。生产环境修改前,应结合当前 Redis 版本的配置文件和压测结果。
八、Pipeline:减少网络往返,进一步提高吞吐量
前面提到,Redis 的命令执行很快,但网络往返也会消耗时间。
假设 Java 程序需要连续执行 3 条命令:
SET user:1 Alice
SET user:2 Bob
GET user:1
8.1 普通请求方式
普通请求可能是:
每次请求都要等待对应响应,产生多次网络往返。
8.2 使用 Pipeline
Pipeline(管道)允许客户端连续发送多条命令,而不必等待每一条命令的响应,再统一读取这些响应。
客户端 Redis 服务端
SET user:1 Alice ———–>
SET user:2 Bob ———–>
GET user:1 ———–>
按顺序处理命令
<—————————– OK
<—————————– OK
<—————————– Alice
Pipeline 的主要价值是减少请求与响应之间的等待次数,从而降低网络往返开销。
注意:Pipeline 不会让 Redis 在默认模型下并行执行这些命令。 服务端仍然按顺序处理收到的命令。
8.3 Java 中如何使用 Pipeline?
Spring Data Redis 提供了 executePipelined() 方法。
下面是一个简化示例:
import java.util.List;
import org.springframework.dao.DataAccessException;
import org.springframework.data.redis.connection.DefaultStringRedisConnection;
import org.springframework.data.redis.connection.RedisConnection;
import org.springframework.data.redis.connection.StringRedisConnection;
import org.springframework.data.redis.core.RedisCallback;
import org.springframework.data.redis.core.StringRedisTemplate;
public class RedisPipelineService {
private final StringRedisTemplate redisTemplate;
public RedisPipelineService(StringRedisTemplate redisTemplate) {
this.redisTemplate = redisTemplate;
}
public List<Object> executeBatch() {
return redisTemplate.executePipelined(
new RedisCallback<Object>() {
@Override
public Object doInRedis(RedisConnection connection)
throws DataAccessException {
StringRedisConnection stringConnection =
new DefaultStringRedisConnection(connection);
stringConnection.set("user:1", "Alice");
stringConnection.set("user:2", "Bob");
stringConnection.get("user:1");
stringConnection.get("user:2");
// 必须返回 null,执行结果由 Pipeline 统一返回
return null;
}
}
);
}
}
重点理解:
- executePipelined():开启管道执行。
- RedisCallback:定义要在 Redis 连接上执行的操作。
- StringRedisConnection:提供字符串形式的 Redis 命令接口。
- return null:这是 Spring Data Redis Pipeline 回调的要求,实际命令结果由 executePipelined() 返回。
- List<Object>:按照管道中命令的执行顺序保存对应响应结果。
这段代码需要 Spring Data Redis 依赖和可用的 Redis 连接配置;这里只展示核心调用方式,不代表已经在某个环境中运行过。
8.4 Pipeline 使用时要注意什么?
Pipeline 并不是命令越多越好。
客户端批量发送命令时,服务端需要暂存响应结果。如果一次性发送过多命令,可能造成客户端和服务端额外的内存压力。
实际使用时可以:
- 根据业务数据量分批执行;
- 避免构造特别大的单次 Pipeline;
- 能使用 MGET、MSET 等聚合命令时,优先评估聚合命令;
- 注意 Pipeline 本身不提供事务语义;
- 如果多个命令之间存在依赖关系,不能简单地把它们放进 Pipeline 就认为业务逻辑已经具备原子性。
九、Redis 快,但为什么有时还是会很慢?
Redis 的性能并不只取决于服务端命令执行速度。一次完整请求还会受到网络、客户端、操作系统、持久化和业务逻辑等因素影响。
| 网络往返过多 | 单条命令很快,但业务整体耗时高 | Pipeline、MGET、连接复用 |
| 慢命令 | 某些命令执行时间很长,其他请求受影响 | Slow Log、命令复杂度 |
| 大 Key | 单次读写数据量很大 | 拆分数据、控制集合规模 |
| 客户端连接管理不合理 | 频繁创建和关闭连接 | 连接池与连接复用 |
| 持久化开销 | fork 或磁盘 I/O 产生延迟 | RDB/AOF 配置、系统资源 |
| CPU 或网络资源不足 | 高负载时延迟上升 | CPU、网卡、系统指标 |
9.1 使用 redis-cli 观察延迟
redis-cli –latency -h 127.0.0.1 -p 6379
这个命令可以持续观察 Redis 请求往返延迟。具体数值取决于运行环境,不能把某个机器上的测试结果当成 Redis 的固定性能指标。
9.2 查看慢日志
SLOWLOG GET 10
用于查看最近记录的慢命令。
慢日志可以帮助判断命令执行本身是否耗时,但它不能替代应用侧的端到端耗时监控,因为应用请求还包括网络传输、客户端排队、线程调度等时间。
9.3 查看客户端与服务端统计信息
INFO clients
INFO stats
INFO memory
分别查看客户端连接、服务端统计以及内存相关信息。
排查性能问题时,不要只盯着 Redis 命令执行时间,还应该结合 Java 应用的接口耗时、线程池、连接池和网络情况综合分析。
十、常见误区
误区 1:Redis 整个进程只有一个线程
错误。
Redis 以单线程命令执行为核心,但还存在后台线程、子进程,以及 Redis 6.0 开始可配置的网络 I/O 多线程。
误区 2:单线程意味着 Redis 只能处理一个客户端
错误。
Redis 可以通过 I/O 多路复用管理多个客户端连接。单线程主要指核心命令执行的串行化方式,而不是只允许一个客户端连接。
误区 3:I/O 多路复用就是多线程
错误。
I/O 多路复用是操作系统提供的一类事件通知机制,目的是让一个线程能够监控多个 I/O 对象是否就绪。它本身不代表多个命令并行执行。
误区 4:Redis 6.0 多线程后,GET 和 SET 会并行执行
错误。
Redis 6.0 引入的多线程 I/O 主要用于网络读写优化,核心命令执行仍由主线程处理。
误区 5:Pipeline 能让命令并行执行
错误。
Pipeline 主要减少网络往返次数。服务端仍然按照收到的命令顺序处理。
误区 6:Redis 所有命令都是 O(1)
错误。
不同命令有不同的时间复杂度,尤其是涉及大量元素遍历、排序和集合运算时,需要关注数据规模与命令复杂度。
十一、本篇总结
本篇围绕 Redis 的高性能架构,重点理解了以下内容:
下一篇预告
第 2 篇:Redis 五大核心数据类型与底层应用场景详解
下一篇将系统学习 String、Hash、List、Set、ZSet 五大核心数据类型,并结合排行榜、关注关系、计数器、缓存对象等 Java 后端业务场景,讲清楚不同数据结构应该如何选择。
我是程序员大海,下期我们不见不散.
参考资料
本文说明: 文章中的架构图为原创教学示意图,并非 Redis 源码截图;代码用于解释接口调用方式,不包含未经验证的性能测试结果。