/* MD / 富文本中的 .toc(含博客园搬家等嵌套结构);.toc-box 在侧栏,不受影响 */
#content_views .toc,
/* 编辑器常在目录前后插入空 p(:empty 仍占 20px),一并去掉避免顶空隙 */
#content_views.markdown_views > p:empty:has(+ .toc),
#content_views.markdown_views > .toc + p:empty,
/* 富文本旧版目录标记 */
#content_views.htmledit_views #main-toc,
#content_views.htmledit_views #hr-toc,
#content_views.htmledit_views p[id*=\”-toc\”] {
display: none !important;
}
/* 目录去掉后,紧跟的首个标题不再多出一块上边距 */
#content_views.markdown_views > .toc + h1,
#content_views.markdown_views > .toc + h2,
#content_views.markdown_views > .toc + h3,
#content_views.markdown_views > .toc + h4,
#content_views.markdown_views > .toc + p:empty + h1,
#content_views.markdown_views > .toc + p:empty + h2,
#content_views.markdown_views > .toc + p:empty + h3,
#content_views.markdown_views > .toc + p:empty + h4 {
margin-top: 0 !important;
}
本文摘要:生产集群里 stress-app 跑着 1 个副本,HPA 配了 minReplicas: 1、maxReplicas: 10、CPU 目标 50%。
一、问题与结论
压测把单 Pod 的 CPU 打到 request 的 4 倍以上,等了两分钟,REPLICAS 还是 1。
kubectl get hpa stress-app-hpa -o wide
NAME REFERENCE TARGETS MINPODS MAXPODS REPLICAS AGE
stress-app-hpa Deployment/stress-app <unknown>/50% 1 10 1 2d
结论先给:<unknown> 不是“利用率为 0”,而是“指标拿不到”。HPA 拿不到指标时既不扩容也不缩容,副本数原地冻结。所以先别去调 averageUtilization,先确认指标链路是否通。
这条链路只有一条:kubelet → metrics-server → API Server (metrics.k8s.io) → HPA Controller。最快的证据在 Events 里:
kubectl describe hpa stress-app-hpa
Warning FailedGetResourceMetric failed to get cpu utilization: …
Warning FailedComputeDesiredReplicas invalid metrics (0/0 out of 1): …
0/0 out of 1 的意思是:HPA 需要 1 个指标才能算出 desired replicas,实际拿到 0 个。
二、排查与选择依据
按顺序走,每一步都有明确分支。
第一步:确认 Metrics API 是否存在
kubectl get –raw /apis/metrics.k8s.io/v1beta1
返回 NotFound 或 403,说明 metrics-server 未安装或未授权;返回 JSON,说明 API 正常,继续下一步。
第二步:看 metrics-server 的 Pod
kubectl get pods -n kube-system | grep metrics-server
没有输出就是未安装——metrics-server 不在核心组件清单里,kubeadm 不会自动带上它。有 Pod 但不是 Running,直接进第三步。
第三步:读日志定位端点问题
kubectl logs -n kube-system -l k8s-app=metrics-server –tail=50
日志里出现 EOF、TLS、connection refused 或 /metrics/resource 字样,说明问题在 metrics-server 到 kubelet 这一段,而不是 HPA 配置。
替代方案与取舍
| 修复 metrics-server(首选) | 需要 CPU/内存扩缩,指标链断裂 | 一次性安装与证书配置,后续维护成本低 | 只提供 CPU/内存,不覆盖 QPS、队列长度 |
| 手动 kubectl scale | 指标链短期修不好,需立刻止血 | 几乎为零 | 指标恢复后 HPA 会覆盖手动副本数,不能长期用 |
| Prometheus Adapter 自定义指标 | 扩缩依据是业务指标 | 需维护 Prometheus 与 Adapter,链路变长 | 增加故障面与指标延迟 |
| KEDA | 需要缩到 0 或事件驱动扩缩 | 引入新 CRD 与常驻组件 | 事件源不可用会直接影响扩缩行为 |
以下情况不该用这套方案:负载尖峰来自长连接粘滞而非平均 CPU、副本数已经卡在节点可分配资源上限(Pod 进入 Pending)、或扩缩依据根本是自定义业务指标。这三类问题修 metrics-server 不会有任何改善。
三、关键原理
HPA 不采集指标。 它只调用 metrics.k8s.io/v1beta1,数据由 metrics-server 提供,链路断在哪一环,HPA 都表现为 <unknown>。
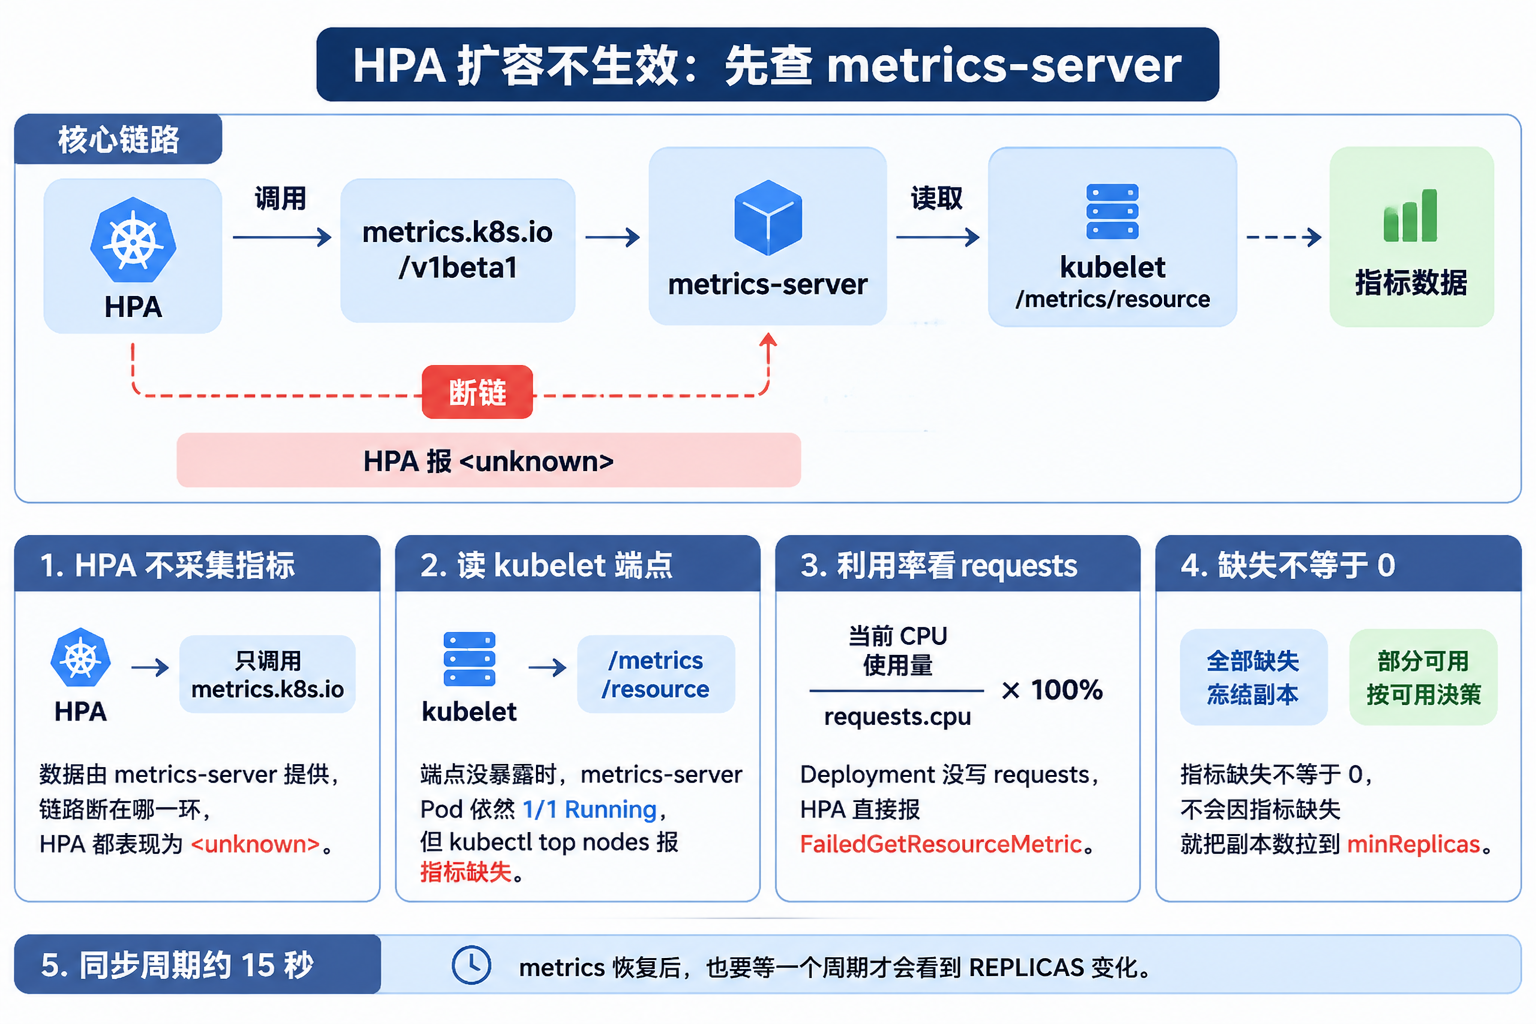
metrics-server 读的是 kubelet 的 /metrics/resource 端点。 端点没暴露时,metrics-server Pod 依然 1/1 Running,kubectl top nodes 却报 metrics not available yet——这是最容易误判为“已安装就该有数据”的场景。
利用率的分母是 resources.requests.cpu。 公式为 当前 CPU 使用量 / requests.cpu。Deployment 没写 requests,HPA 直接报 FailedGetResourceMetric,连数值都算不出来。
指标缺失不等于指标为 0。 所有指标不可用时 HPA 冻结副本数;部分可用时用可用的那部分做决策,也不会因指标缺失就把副本数拉到 minReplicas。
同步周期默认约 15 秒。 metrics 恢复后也要等一个周期才会看到 REPLICAS 变化,别在恢复后 3 秒就判定“还是不生效”。
四、可运行示例
环境:任意可用集群(minikube、k3s 或托管集群)加一个已配置好的 kubectl。以下输出按官方文档描述的行为推演,未在真实集群实测验证。
第一步,部署一个持续消耗 CPU 且写了 request 的 Deployment:
apiVersion: apps/v1
kind: Deployment
metadata:
name: stress–app
spec:
replicas: 1
selector:
matchLabels:
app: stress–app
template:
metadata:
labels:
app: stress–app
spec:
containers:
– name: stress
image: busybox
command: ["sh", "-c", "while true; do echo burn > /dev/null; done"]
resources:
requests:
cpu: 100m
limits:
cpu: 500m
kubectl apply -f deployment.yaml
第二步,创建 maxReplicas: 10 的 HPA:
apiVersion: autoscaling/v2
kind: HorizontalPodAutoscaler
metadata:
name: stress–app–hpa
spec:
scaleTargetRef:
apiVersion: apps/v1
kind: Deployment
name: stress–app
minReplicas: 1
maxReplicas: 10
metrics:
– type: Resource
resource:
name: cpu
target:
type: Utilization
averageUtilization: 50
kubectl apply -f hpa.yaml
第三步,模拟指标链故障(集群本就没装 metrics-server 时跳过此步):
kubectl scale deployment metrics-server -n kube-system –replicas=0
sleep 30
kubectl get hpa stress-app-hpa -o wide
预期输出:
NAME REFERENCE TARGETS MINPODS MAXPODS REPLICAS AGE
stress-app-hpa Deployment/stress-app <unknown>/50% 1 10 1 1m
实际输出(验证方法):kubectl get pods -l app=stress-app 只应看到 1 个 Pod,kubectl describe hpa stress-app-hpa 的 Events 出现 FailedGetResourceMetric。
第四步,恢复 metrics-server:
kubectl scale deployment metrics-server -n kube-system –replicas=1
kubectl wait –for=condition=ready pod -l k8s-app=metrics-server -n kube-system –timeout=120s
kubectl get –raw /apis/metrics.k8s.io/v1beta1 | head -c 300
预期输出:kubectl get hpa stress-app-hpa -o wide 的 TARGETS 变成类似 480%/50% 的百分比,等待一个同步周期后 REPLICAS 升到 6 至 10(受节点资源限制可能达不到 10)。
实际输出(验证方法):kubectl get pods -l app=stress-app 副本数大于 1,且 kubectl describe hpa 不再出现 Warning。清理用 kubectl delete hpa stress-app-hpa && kubectl delete deployment stress-app。
常见失败:metrics-server 是 1/1 Running,HPA 仍是 <unknown>。 原因是 metrics-server 连不上 https://<node>:10250/metrics/resource——要么 kubelet 未暴露该端点,要么 kubelet 证书不被 metrics-server 信任,日志中会有 TLS 或 EOF 报错。修复方向是先从日志确认它在连哪个端点、拿到什么错误,再回到 kubelet 配置或 metrics-server 启动参数中对应处理;具体取值随发行版与版本差异较大,本文不给出未经验证的参数。
五、验证结果与边界
依次确认四件事:kubectl get –raw /apis/metrics.k8s.io/v1beta1 返回 JSON;kubectl top nodes 有数据;HPA 的 TARGETS 是百分比而非 <unknown>;一个同步周期后 REPLICAS 发生变化。
边界与常见误判:
- metrics 修好后仍不扩容:若实际 CPU 利用率本就低于 target,不扩容是正确行为。
- 为了“给足资源”把 requests 拉到与 limits 相同,分母变大,利用率被稀释,HPA 永远看不到超阈值。这是最常见的人为误判。
- 反过来把 requests 设得过小,利用率灵敏,但调度器按 requests 预留资源,节点容易超卖,扩到 10 个副本可能全卡在 Pending。
- 副本数扩不出来但 Pod 处于 Pending,要查节点可分配容量,查 metrics 没有意义。
参考资料
- Kubernetes 官方文档 · Horizontal Pod Autoscaler(autoscaling/v1、v2)
- Kubernetes 官方文档 · Resource Metrics Pipeline
- metrics-server 官方仓库
- kubectl 参考文档 · top 与 get 输出格式