python学习—Python 2.7 与 3.x 差异(arcpy 场景)
发布信息
- 标题:python学习—Python 2.7 与 3.x 差异(arcpy 场景)
- 摘要:ArcGIS Desktop 锁死 Python 2.7,而网上教程九成是 3.x。本文从环境归属讲到 print、除法、异常、字典、中文编码五类实际会撞上的差异,给出 arcpy 场景下的正确写法和一张速查表,附迁移自检清单。
- 标签:Python2.7、Python3、arcpy、ArcGIS、字符编码、版本差异
- 专栏:python学习
系列文章目录
python学习—阻止谷歌浏览器升级 python学习—合并多个word文档之VBA宏代码方法 python学习—合并多个word文档 python学习—详解word邮件合并 python学习—批量复制并重命名文件夹 python学习—字典(Dictionary) python学习—列表和元组 python学习—合并多个Excel工作簿表格文件 python学习—循环语句-控制流 python学习—年会不能停,游戏抽签抽奖 python学习—查找指定目录下的指定类型文件 python学习—统计嵌套文件夹内的文件数量并建立索引表格 python学习—合并TXT文本文件
功能说明
写 arcpy 的人大概都经历过这件事:
在自己电脑上跑得好好的脚本,拷到同事电脑上,双击运行,第一行就给你一个 SyntaxError。或者照着网上教程抄了一段 Python 代码,贴进 ArcMap 的 Python 窗口,满屏红色报错,一句都看不懂。
不是代码写错了,是你抄的是 Python 3 的代码,而 ArcGIS Desktop 只能跑 Python 2.7。
这个坑绕不开:ArcGIS 桌面版最后一版是 10.8.2,它绑定的就是 Python 2.7,不会再变了。而网上能搜到的 Python 教程、ChatGPT 给的代码、新一点的第三方库文档,默认全是 python 3.x 语法。两边的语法差异虽然不大,但每一处都致命——不报错,就是结果错;不报结果错,就是中文乱码。
本文想解决四件事:
- 1 说清电脑上这几套 Python 分别从哪来、谁有 arcpy、谁没有
- 2 列出实际会撞上的语法差异,每条给可直接运行的对比代码
- 3 讲透 arcpy 场景下最痛的中文编码问题,给出正确写法
- 4 一张速查表 + 一份迁移自检清单,改代码时照着对
我使用的 arcgis 软件版本为 10.8.2 版本,自带的 Python 是 2.7.18,32 位。文中的 py2 代码均可直接在 ArcMap 的 Python 窗口运行。 (我的电脑上还另外安装了 python 3.13版本,用来其他 非 arcpy代码使用的环境,使用PyCharm作为IDE编辑器)。
1 先搞清楚:三套 Python,谁是谁
很多人的电脑上同时躺着三个 Python,互相打架。以我的电脑为例:
| Python 版本 | 2.7.18 | 3.6 ~ 3.11(随 Pro 版本) | 3.13 |
| 典型路径 | C:\\Python27\\ArcGIS10.8 | C:\\Program Files\\ArcGIS\\Pro\\bin\\Python\\envs\\arcgispro-py3 | C:\\Users\\xxx\\AppData\\Local\\Programs\\Python\\Python313 |
| 位数 | 32 位 | 64 位 | 64 位 |
| 有没有 arcpy | 有 | 有(另一个 arcpy) | 永远没有 |
| 地图文档模块 | arcpy.mapping | arcpy.mp | — |
关键点一:两个 arcpy 不是同一个东西。
Desktop 的 arcpy 是一堆编译好的 32 位 .pyd 文件,只能被 32 位的 Python 2.7 加载; Pro 的 arcpy 是 64 位、Python 3 的包。 你把 Pro 的 arcpy 目录塞给 Python 3.13,只会得到:
ImportError: DLL load failed: 找不到指定的模块。
或者干脆:
ModuleNotFoundError: No module named 'arcpy'
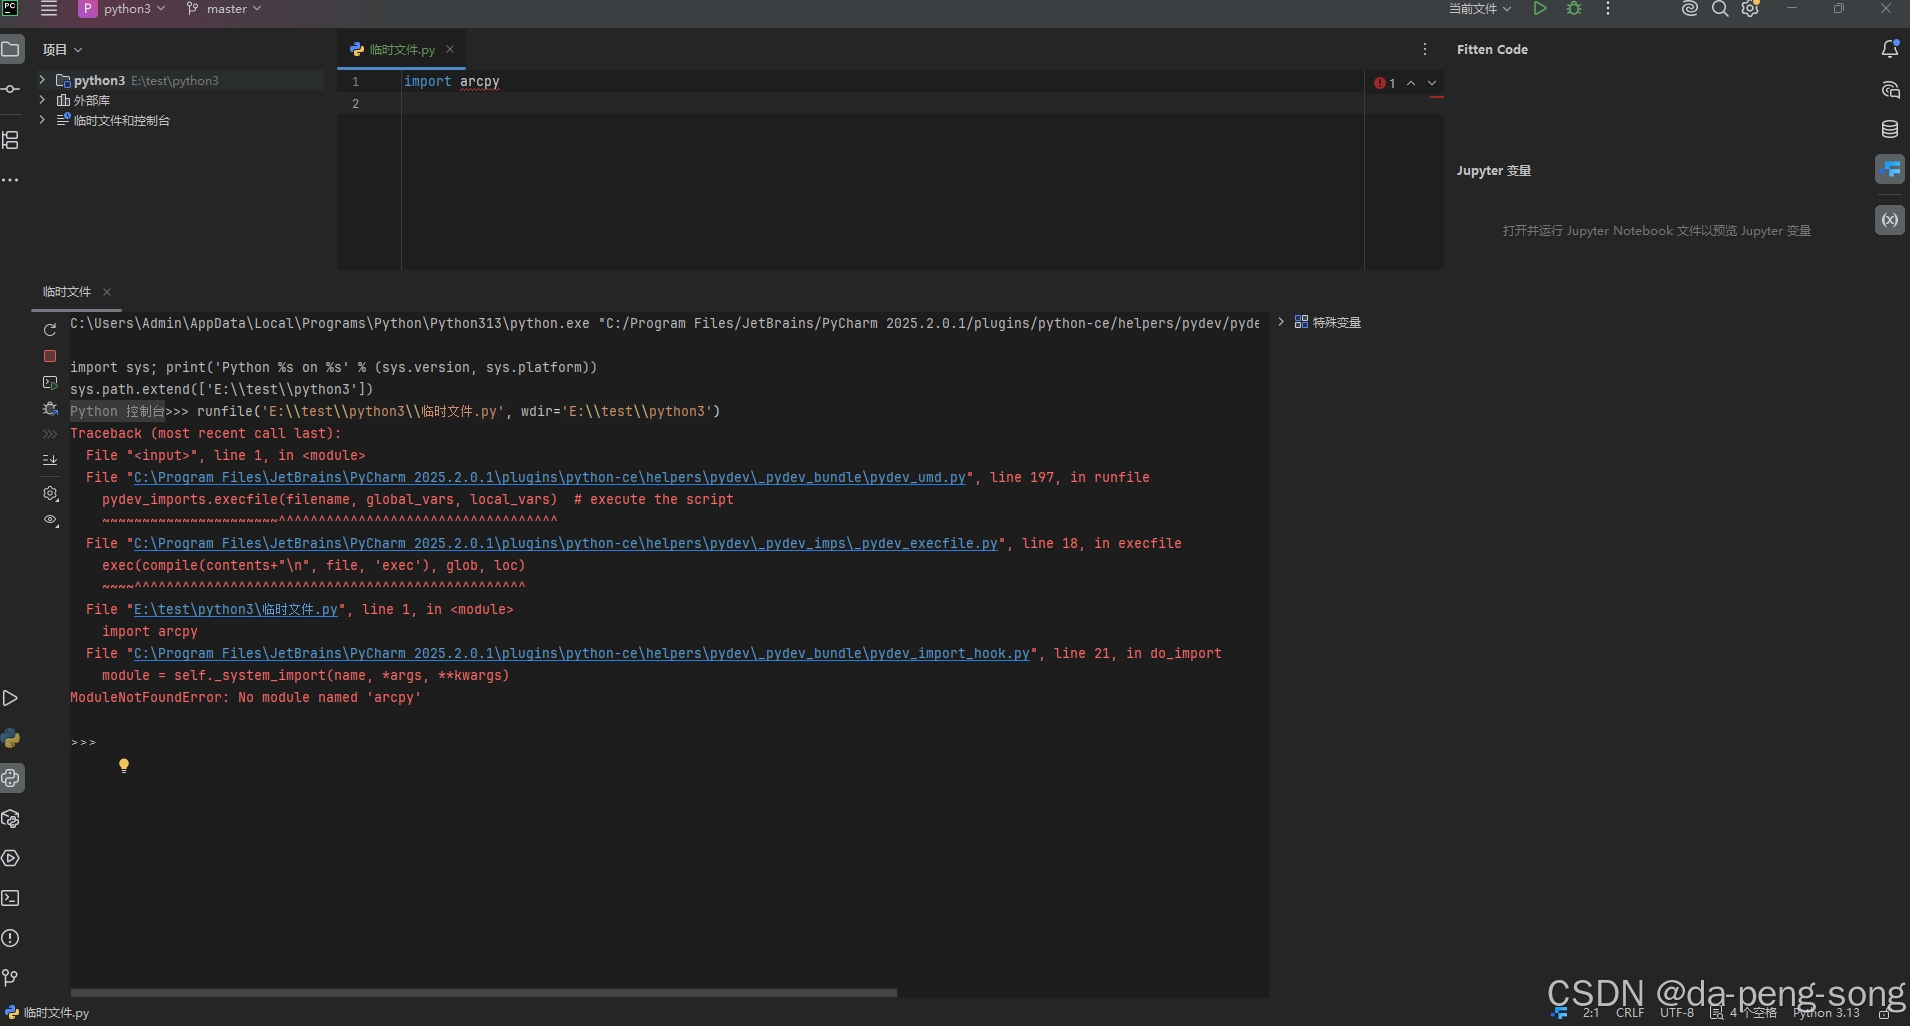
关键点二:自己装的那个 Python 3.13,永远不会有 arcpy。
arcpy 不是 pip 能装的包,它跟着 ArcGIS 安装包一起落盘。所以在 PyCharm 里新建项目,如果 Interpreter 解释器环境 选的是 3.13,import arcpy 必然失败——这不是环境变量没配好,是方向错了。
关键点三:想看当前解释器是谁,一句话。
import sys
print(sys.version)
py2 输出(注意末尾的 32 bit,这是 ArcGIS Desktop 的 Python,别搞混):
2.7.18 (v2.7.18:8d21aa21f2, Apr 20 2020, 20:25:09) [MSC v.1500 32 bit (Intel)]
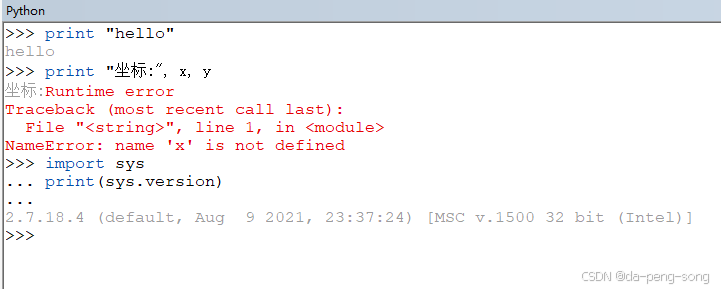
py3 输出长这样:
3.13.0 (main, Oct 7 2024, 12:13:39) [MSC v.1941 64 bit (AMD64)]
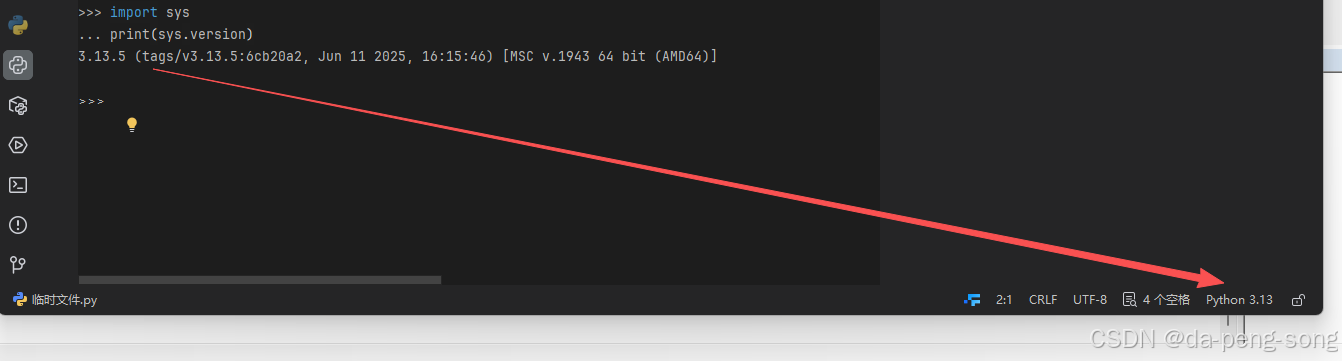
在 ArcMap 的 Python 窗口里第一条命令就敲这个,能避免后面所有误会。
温馨提示:ArcGIS 10.8.2 装完之后,开始菜单里 ArcGIS 组下面有个 Python 2.7 文件夹,里面是 IDLE 和 Python (command line)。IDLE 比 ArcMap 自带的 Python 窗口好用得多——有语法高亮、能保存 .py 文件、报错信息带行号。日常写 arcpy 建议在这里写,调通了再贴进 Python 窗口。
2 语法差异:五处必踩
(1) print:从语句到函数
py2 里 print 是语句,不用括号:
print "hello"
print "坐标:", x, y
py3 里它是函数,必须带括号:
print("hello")
print("坐标:", x, y)
这是最容易被"看起来没问题"骗过去的一处。 print("hello") 在 py2 里也能跑,因为括号被当成普通的分组表达式,等价于 print ("hello")。但一旦有多个参数就露馅:
# py2 中执行
print("坐标:", 100, 200)
py2 输出:
('坐标:', 100, 200)
一个元组。括号被理解成了"把这三个东西打包成元组再打印",而不是"三个参数"。
arcpy 场景:调试时想看游标取出来的值,写成 print(row) 在两边都对,因为只有一个参数。但写成 print("值:", row) 就只在 py3 对。稳妥写法是用格式化:
print("值:{}".format(row))
这种写法两边完全一致。
如果一定要在 py2 里用函数式 print(比如要 end= 参数),加一行:
from __future__ import print_function
(2) 除法:整数相除,小数消失
py2 的 / 遇到两个整数,做的是地板除,直接砍掉小数:
# py2
print 5 / 2 # 2 不是 2.5
print 5 / 2.0 # 2.5 有一边是浮点才正常
print 5 // 2 # 2 地板除,两边一致
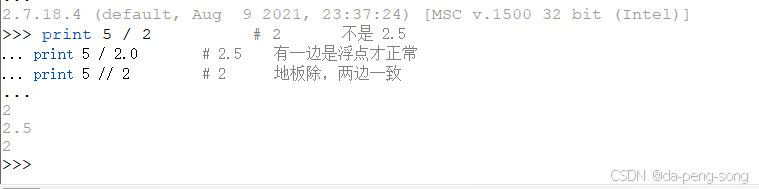
py3 的 / 永远是真除法,// 才是地板除。 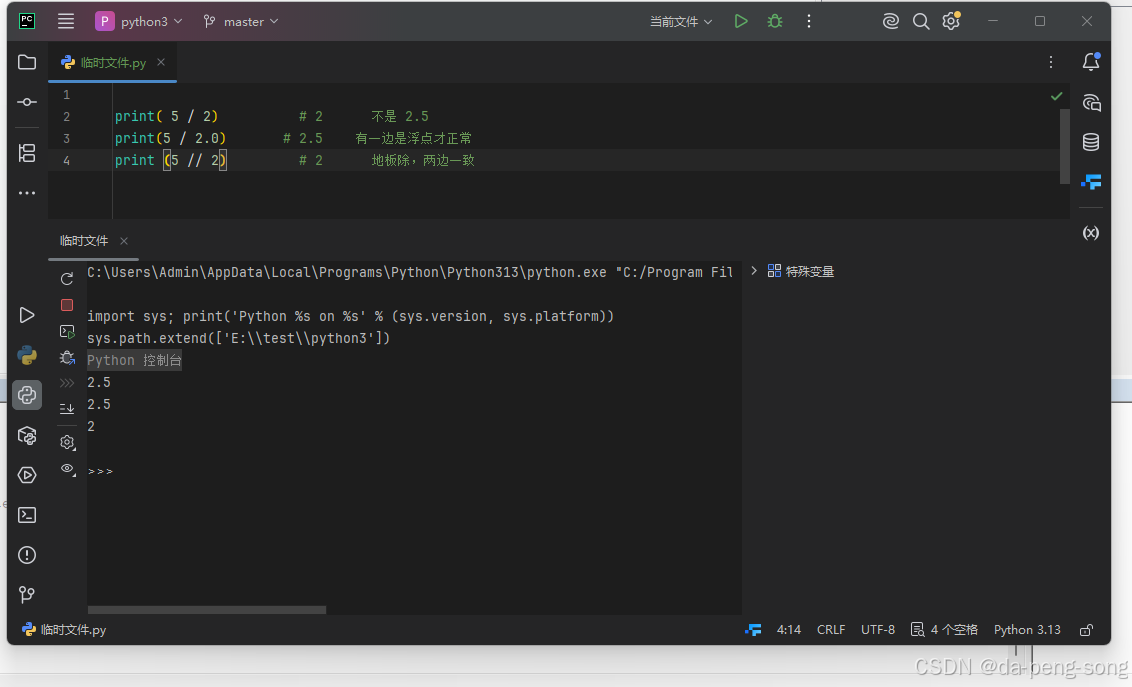
这一处不报错,但结果错,最阴。
arcpy 里最典型的翻车现场是面积单位换算:
# 字段值是 LONG 类型,单位平方米
area = row[0] # 12345678
mu = area / 10000 # py2 得 1234,小数点后全丢
正确写法,主动制造浮点:
mu = area / 10000.0 # 1234.5678
# 或者
mu = float(area) / 10000
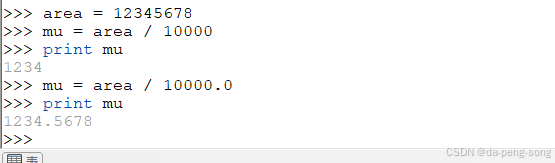
要整体改成本意,加一行让 / 变成真除法:
from __future__ import division
arcpy 场景提醒:arcpy.Describe() 拿到的 extent.width、shape.area 都是浮点,不受影响。真正危险的是属性表里 SHORT / LONG 字段的值——读出来是 int,一转除法就掉精度。
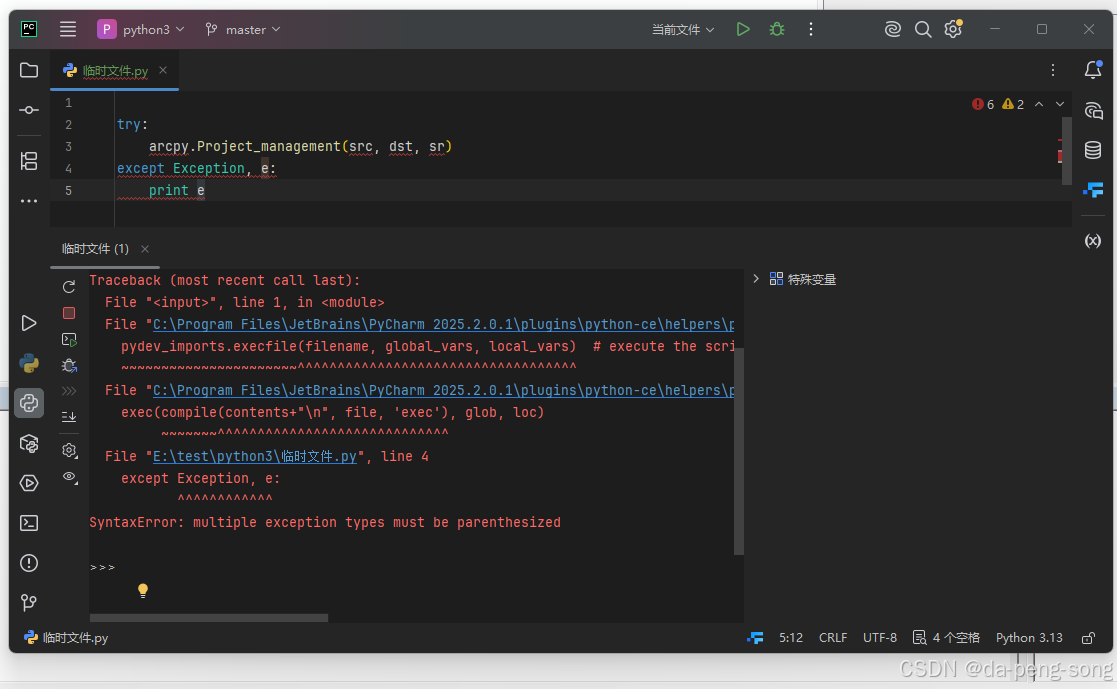
(3) 异常捕获:逗号换成 as
# py2 老写法,py3 直接 SyntaxError
try:
arcpy.Project_management(src, dst, sr)
except Exception, e:
print e
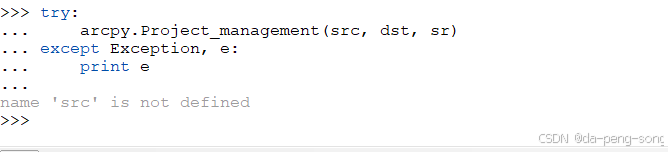
# py2.6+ 和 py3 都认的写法
try:
arcpy.Project_management(src, dst, sr)
except Exception as e:
print(e)
注意:except … as e 在 Python 2.6 就已经支持,所以 py2.7 完全可以用。写 arcpy 代码时统一用 as,能省一半迁移麻烦。
另外 py2 的 print e(不带括号)在 py3 是语法错误,改成 print(e) 或 arcpy.AddError(str(e)) 两边都对。
(4) range 和 xrange
# py2
range(1000000) # 立刻在内存里建一个 100 万元素的 list,占几十 MB
xrange(1000000) # 惰性生成,几乎不占内存
# py3
range(1000000) # 本身就是惰性对象,没有 xrange 这个名字了
arcpy 场景:批处理几千个要素类时,for i in xrange(len(lst)) 在 py2 是标准写法,搬到 py3 报 NameError: name 'xrange' is not defined。
统一写法:
for i in range(len(lst)):
py2 里如果 len(lst) 不大(几千以内),用 range 完全无所谓;要是上万,才需要考虑 xrange。写 arcpy 脚本时列表通常就几十上百项,直接 range 更省心。
更好的做法是根本不用索引:
for fc in lst:
(5) input 和 raw_input
# py2
name = raw_input("输入名称:") # 拿到字符串,安全
name = input("输入名称:") # 等价于 eval(raw_input(…)),输入 1+1 得 2,输入中文不加引号直接报错
# py3
name = input("输入名称:") # 就是 py2 的 raw_input
arcpy 场景:写工具箱脚本时不要用 input()。ArcGIS 工具箱的参数统一走:
fc = arcpy.GetParameterAsText(0)
这样参数从工具对话框传进来,和 Python 版本无关,也就没有这个坑。
(6) 3.x 独有、2.7 必报错的写法
| f"结果:{x}" | 3.6 | SyntaxError: invalid syntax |
| def f(a: int) -> str: 类型注解 | 3.0 / 3.5 | SyntaxError |
| async def / await | 3.5 | SyntaxError |
| yield from | 3.3 | SyntaxError |
| nonlocal x | 3.0 | SyntaxError |
| {**d1, **d2} 字典解包合并 | 3.5 | SyntaxError |
f-string 是最高频的一个。 现在问 AI 要代码,十有八九给你 f-string。改法很简单:
# py3
arcpy.AddMessage(f"共处理 {n} 个图层")
# py2 / 通用
arcpy.AddMessage("共处理 {} 个图层".format(n))
.format() 从 Python 2.6 就有,两边通吃,是我写 arcpy 的默认选择。
3 中文编码:arcpy 最痛的一关
前面几处至少会报错,看得见。编码问题不一样,它时好时坏、换台电脑就变,最耗时间。
(1) 第一行必须写编码声明
py3 源码默认就是 UTF-8,写中文注释毫无压力。py2 默认是 ASCII,源码里只要出现一个中文字符——哪怕是注释——就报:
SyntaxError: Non-ASCII character '\\xe4' in file xxx.py on line 3,
but no encoding declared
所以 py2 脚本第一行(或第二行,如果第一行是 #!/usr/bin/env python)必须写:
# -*- coding: utf-8 -*-
用记事本或 Notepad++ 保存时,文件本身的编码也要选 UTF-8。 声明写 UTF-8、文件实际存成 ANSI,照样报错,而且报错信息更莫名其妙。
(2) py2 里 str 和 unicode 是两回事
这是整个编码问题的根。py3 只有一种字符串 str(就是文本),bytes 单独存在。py2 里:
| str | 字节串,存的是编码后的字节 | "中文" 实际是 6 个字节 |
| unicode | 文本,存的是字符 | u"中文" 是 2 个字符 |
# -*- coding: utf-8 -*-
s = "中文" # str,字节串,内容 = b'\\xe4\\xb8\\xad\\xe6\\x96\\x87'
u = u"中文" # unicode,2 个字符
print type(s) # <type 'str'>
print type(u) # <type 'unicode'>
print len(s) # 6
print len(u) # 2
(3) 三个高频报错,一次说清
① UnicodeDecodeError: ‘ascii’ codec can’t decode byte
来源:把 str 和 unicode 拼在一起,py2 会自动尝试用 ASCII 去解码那个 str。
s = "中文" # str
u = u"abc" # unicode
print s + u # UnicodeDecodeError!
改成同类型再拼:
print s.decode('utf-8') + u # 都变成 unicode 再相加
② UnicodeEncodeError: ‘gbk’ codec can’t encode character
来源:把 unicode 输出到 GBK 环境(Windows 控制台默认 GBK),遇到 GBK 里没有的字符(比如某些少数民族文字、特殊符号)就崩。
print u"℃" # 控制台 GBK 编码,可能报错
③ IOError: [Errno 22] Invalid argument 或路径找不到
来源:arcpy 拿到的是 str 类型的中文路径,内部转码失败。py2 下 arcpy 对 unicode 路径的支持明显更好。
(4) arcpy 里的正确写法
统一原则:脚本内部的所有文本一律用 unicode,只在落盘输出时转成字节。
路径:
# -*- coding: utf-8 -*-
import arcpy, os
# 常量直接加 u 前缀,一步到位
workspace = u"D:\\\\数据\\\\成果"
arcpy.env.workspace = workspace
# 拼接出来的路径也要是 unicode
fc = os.path.join(workspace, u"行政区.shp")
消息输出:
# 不推荐:传入 str,换台电脑可能乱码
arcpy.AddMessage("处理完成:" + name)
# 推荐:全程 unicode
arcpy.AddMessage(u"处理完成:{}".format(name))
注意 .format() 里的变量也必须是 unicode,否则 py2 会尝试把 str 按 ASCII 解码。稳妥写法是准备一个转换函数:
def to_u(s):
"""py2 专用:任意对象转 unicode"""
if isinstance(s, unicode):
return s
if isinstance(s, str):
try:
return s.decode('utf-8')
except UnicodeDecodeError:
return s.decode('gbk')
return unicode(s)
arcpy.AddMessage(u"处理完成:{}".format(to_u(name)))
注意:这个函数只能在 py2 用,unicode 在 py3 里没有这个名字。写双版本兼容时用 sys.version_info 判断。
文件读写:py2 的 open() 读写的是字节,中文内容必须显式指定编码,用 codecs:
import codecs
# 写
with codecs.open(u"D:\\\\数据\\\\清单.txt", 'w', 'utf-8') as f:
f.write(u"图层名称,要素数\\n")
f.write(u"{},{}\\n".format(name, count))
# 读
with codecs.open(u"D:\\\\数据\\\\清单.txt", 'r', 'utf-8') as f:
for line in f:
print(line.strip())
不加 codecs 直接 open(…, 'w') 写中文,在 Windows 上会按 GBK 落盘,别人用 UTF-8 打开就是一堆乱码。
CSV 特别注意:用 csv 模块 + codecs.open 写出来的 UTF-8 CSV,用 Excel 双击打开会乱码(Excel 默认按 GBK 解析)。两个办法:一是文件开头写 BOM,二是改用 GBK。我通常用第一种:
with codecs.open(path, 'w', 'utf-8-sig') as f: # utf-8-sig 会写入 BOM
writer = csv.writer(f)
(5) 批量转换编码
如果手里一堆 txt 编码混乱,用 chardet 探测后统一转 UTF-8。这部分在《python学习—合并TXT文本文件》里有完整代码,这里不重复。
安装 chardet 到 arcpy 环境:
C:\\Python27\\ArcGIS10.8\\python.exe -m pip install chardet
4 字典与迭代
(1) keys / values / items 的返回值
d = {'a': 1, 'b': 2}
# py2:返回 list,可以用索引
d.keys() # ['a', 'b']
d.keys()[0] # 'a' 合法
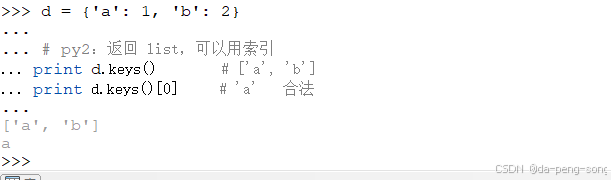
# py3:返回视图对象,不支持索引
d.keys() # dict_keys(['a', 'b'])
d.keys()[0] # TypeError: 'dict_keys' object is not subscriptable
py3 想取第一个键,要转成 list:
list(d.keys())[0]
arcpy 场景:属性表字段名和别名的映射字典,按顺序取字段名时容易踩。建议统一写 list(d.keys()),两边都能跑。
(2) iteritems 在 py3 消失
# py2
for k, v in d.iteritems():
print k, v
# py3
for k, v in d.items():
print(k, v)
通用写法用 d.items()。 在 py2 里 items() 会一次性建 list,字段字典最多几十项,完全无所谓。
(3) has_key 被移除
# py2
if d.has_key('a'):
pass
# py3 / 通用
if 'a' in d:
pass
(4) 排序行为
py2 里 sorted(d.items()) 遇到键类型不一致(比如既有 int 又有 str)不会报错,只是按类型名排;py3 直接抛 TypeError。写字典排序时保证键类型统一即可。
5 库与包管理
(1) pip 到底装到哪去了
电脑上装了 3.13 之后,命令行敲 pip 很可能指向 3.13 的 pip:
pip install docx
结果是装进了 3.13 的 site-packages,arcpy 的 Python 2.7 里 import docx 依旧报错。永远用 -m pip 明确解释器:
C:\\Python27\\ArcGIS10.8\\python.exe -m pip install python-docx
写全路径,不给歧义留空间。
(2) 哪些包能装、哪些不能
| python-docx | 能 | 生成 word 报告 |
| openpyxl | 能 | 读写 xlsx,比 xlrd/xlwt 好用 |
| chardet | 能 | 编码探测 |
| pandas | 谨慎 | 新版已不支持 py2,必须锁 pandas==0.24.2 |
| numpy | 不建议动 | arcpy 自己依赖特定版本,升级会连带崩掉 |
| gdal/geopandas | 不建议 | 与 arcpy 的几何对象不通用,两套并存的坑很深 |
铁律:不要升级 arcpy 环境里已存在的包。 只装新的、arcpy 用不到的小包。装出问题只能重装 ArcGIS,代价太大。
(3) Python 2.7 的包生态已经停更
2020 年 1 月 1 日 py2 停止维护。现在 pip install 报 Could not find a version that satisfies the requirement 是常态。解决办法:
- 优先找老版本:pip install 包名==1.2.3
- 有些包要指定源:-i https://pypi.tuna.tsinghua.edu.cn/simple
- 实在装不上,就回到标准库——os、csv、shutil、codecs、zipfile 这几个模块能覆盖 90% 的办公自动化需求
6 arcpy 本身的变化:mapping 变 mp
语法差异之外,两代 arcpy 的 API 也不一样。最明显的是地图文档模块:
| 地图文档对象 | arcpy.mapping.MapDocument | arcpy.mp.ArcGISProject |
| 取当前文档 | MapDocument("CURRENT") | ArcGISProject("CURRENT") |
| 列出数据框 | arcpy.mapping.ListDataFrames(mxd) | project.listMaps() |
| 列出图层 | arcpy.mapping.ListLayers(mxd, "", df) | map.listLayers() |
| 导出 PDF | arcpy.mapping.ExportToPDF | layout.exportToPDF() |
| 修改图层符号 | arcpy.mapping.UpdateLayer | layer.symbology |
| 文本元素 | arcpy.mapping.ListLayoutElements | layout.listElements("TEXT_ELEMENT") |
# py2 + Desktop
import arcpy
mxd = arcpy.mapping.MapDocument(u"D:\\\\工程\\\\成果.mxd")
df = arcpy.mapping.ListDataFrames(mxd)[0]
for lyr in arcpy.mapping.ListLayers(mxd, "", df):
print lyr.name
mxd.save()
del mxd
# py3 + Pro
import arcpy
aprx = arcpy.mp.ArcGISProject(r"D:\\工程\\成果.aprx")
m = aprx.listMaps()[0]
for lyr in m.listLayers():
print(lyr.name)
aprx.save()
这部分不能只改语法,逻辑要重写。 好在基础工具层完全一致——arcpy.Project_management、arcpy.Clip_analysis、arcpy.da.SearchCursor、arcpy.GetParameterAsText 这些在两边写法一模一样,只是 py3 里 print 要加括号。
所以现有的 arcpy 代码迁移到 Pro,工作量主要集中在 mapping 相关的部分。
7 速查表
写代码时照着对,左边是 py2(Desktop),右边是 py3(Pro / 通用)。
| 输出 | print x | print(x) | print(x) |
| 多参数输出 | print "a", x | print("a", x) | print("a", x) |
| 格式化 | "%s" % x | f"{x}" | "{}".format(x) |
| 真除法 | float(a)/b | a/b | float(a)/b |
| 地板除 | a/b | a//b | a//b |
| 异常 | except E, e: | except E as e: | except E as e: |
| 循环 | xrange(n) | range(n) | range(n) |
| 输入 | raw_input() | input() | arcpy.GetParameterAsText() |
| 字典遍历 | d.iteritems() | d.items() | d.items() |
| 键判断 | d.has_key(k) | k in d | k in d |
| 键列表 | d.keys() | list(d.keys()) | list(d.keys()) |
| 字符串类型 | str = 字节,unicode = 文本 | str = 文本,bytes = 字节 | 全部加 u"" 前缀 |
| 源文件声明 | # -*- coding: utf-8 -*- 必须 | 可省略 | 写上 |
| 文本文件读写 | codecs.open(p,'w','utf-8') | open(p,'w',encoding='utf-8') | 两边写各自的,别硬求统一 |
| 整数类型 | int / long 并存 | 只有 int | 避免 123L 字面量 |
| 地图文档 | arcpy.mapping.MapDocument | arcpy.mp.ArcGISProject | 无法通用,需重写 |
8 迁移自检清单
拿到一段来路不明的代码,或者要把旧脚本换个环境跑,按顺序过一遍:
- 1 先确认解释器版本:import sys; print(sys.version)
- 2 有没有 print "xxx" 这种不带括号的语句?
- 3 有没有 except X, e 这种逗号捕获?
- 4 有没有 xrange、has_key、iteritems?
- 5 有没有 f-string(f"…")或类型注解?py2 要全部改掉
- 6 所有除法:两个整数相除的地方,是不是漏了 .0 或 float()?
- 7 源码第一行有没有 # -*- coding: utf-8 -*-?文件本身是不是真存成了 UTF-8?
- 8 所有路径字符串加 u 前缀了没有?
- 9 有没有 "中文" + u"中文" 这种 str 与 unicode 混拼?
- 10 用到的第三方库,在 py2 下有对应版本吗?python -m pip list 看一下
- 11 涉及 arcpy.mapping 的,目标环境是 Desktop 还是 Pro?
十一条全过一遍,py2 / py3 之间的坑基本就清完了。
后记
Python 2 和 3 的差异,说到底是"历史包袱"和"生态现状"在打架。ArcGIS 桌面版锁死 2.7 是既定事实,短期内不会变;而外部的代码示例、教程、AI 生成的内容,默认都是 3.x。
我的建议是:写 arcpy 时代码直接按 2.7 写,但心里装着 3.x 的写法。凡是能用通用写法的地方就用通用写法(.format()、except as、in 判断键),这样将来真要迁到 Pro,改动量能少一大半。
真正无法通用、必须重写的,只有 arcpy.mapping 那一块。所以如果你的脚本里大量用到了 arcpy.mapping,从一开始就把地图文档操作和数据操作拆成两个模块,迁移时只动前半截。
如果觉得文章不错,请多多点赞添加关注,您的支持就是我的动力。