一、InnoDB 总体架构
通过MySQL :: MySQL 8.0 Reference Manual :: 17.4 InnoDB Architecture 我们可以查看官方提供的架构图。
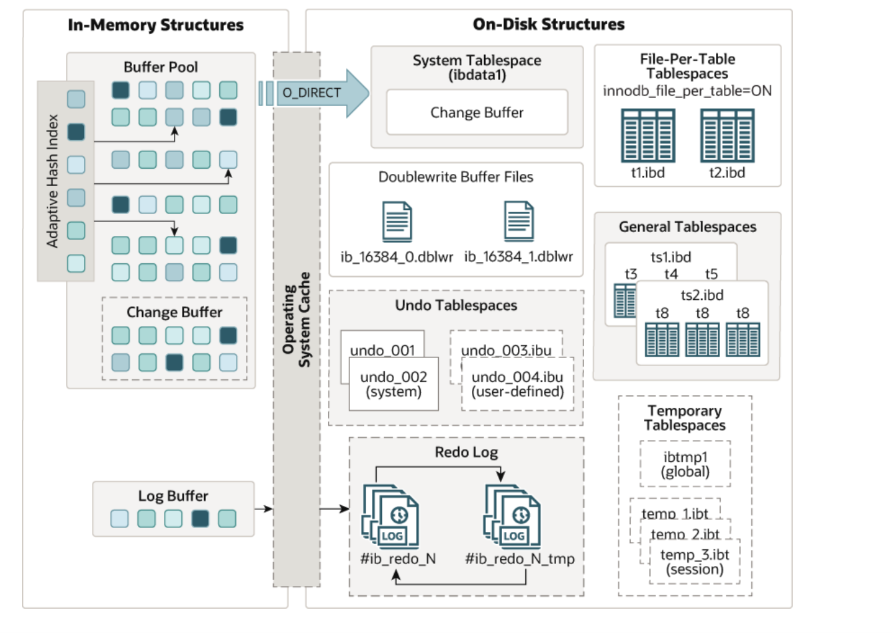
从图中可以看出Innodb架构分为:内存结构和磁盘结构
1.1 为什么设计成"内存结构 + 磁盘结构"两部分
MySQL 作为数据库服务,数据主要接触的设备就是内存和外存,InnoDB 必须对两者分别制定处理方针:
| 职责 | 性能:缓存热点页、缓冲写、加速索引 | 持久化:数据最终落盘 |
| 失效后果 | 重启丢失,靠 redo 恢复 | 数据永久(除介质损坏) |
| 典型结构 | Buffer Pool、Change Buffer、Log Buffer、AHI | 各类表空间、redo log、doublewrite |
用户真实数据最终必须保存在磁盘上;查询时如果每次都从磁盘读,效率极低。依据局部性原理,InnoDB 把读到的页缓存到内存(Buffer Pool),再次查询命中内存即可直接返回。
- Buffer Pool 是磁盘页的缓存(LRU 管理);
- 写操作先改内存中的页(变脏页);
- 持久化靠 WAL:先顺序写 redo log,脏页由后台线程异步刷盘;
- 崩溃恢复靠 redo 重放(已提交)+ undo 回滚(未提交)。
1.2 内存结构四件套
| Buffer Pool | 缓存数据页与索引页 | InnoDB 性能核心,LRU 管理,脏页异步刷盘 |
| Change Buffer | 缓存对非唯一二级索引的写操作 | 把随机写合并,减少随机读;持久化在系统表空间 |
| Log Buffer | 缓冲 redo log 写入 | 攒批后顺序写 redo 文件,减少 IO |
| Adaptive Hash Index | 自适应哈希索引 | 对频繁等值访问的页建内存哈希,O(1) 查找 |
1.3 磁盘结构:
| System Tablespace | 系统表空间(ibdata1):系统元数据、change buffer 等 |
| File-Per-Table Tablespaces | 独立表空间:每表一个 .ibd(默认) |
| General Tablespaces | 通用表空间:多表共享一个 .ibd(CREATE TABLESPACE) |
| Temporary Tablespaces | 临时表空间(ibtmp1、会话临时表空间) |
| Undo Tablespaces | 撤销表空间(undo_001、undo_002):存放 undo log |
| Doublewrite Buffer Files | 双写缓冲文件(8.0 独立 dblwr 文件),防页断裂 |
| Redo Log | 重做日志(#innodb_redo 目录,8.0.30 起 innodb_redo_log_capacity) |
1.4 架构全景(ASCII 示意)
┌───────────────────── InnoDB ─────────────────────┐
│ │
内存结构 │ Buffer Pool Change Buffer Log Buffer AHI │
│ │ │ │ │
│ ▼ ▼ ▼ │
磁盘结构 │ 各类表空间(.ibd/ibdata1) Doublewrite Redo Log │
│ ┌────────────┬─────────────┬──────────────┐ │
│ │ 系统表空间 │ 独立表空间 │ 通用/临时/撤销│ │
│ └────────────┴─────────────┴──────────────┘ │
└──────────────────────────────────────────────────┘
1.5 读写数据流(把结构串起来)
读路径:
SQL → 引擎 → Buffer Pool 命中? ──是──▶ 直接返回
│否
▼
从磁盘读页装入 Buffer Pool → 返回
写路径(WAL):
SQL → 修改 Buffer Pool 中的页(变脏页)
│
├──▶ 写 redo log(Log Buffer → redo 文件,顺序写)
└──▶ 后台线程按 checkpoint 异步刷脏页到磁盘
崩溃时:redo 重放已提交事务,undo 回滚未提交事务——这就是"内存 + 磁盘"能安全协作的关键。
二、表空间和表空间文件
2.1 概念
| 表空间(Tablespace) | 逻辑存储容器:一个表空间由一个或多个数据文件组成,是 InnoDB 组织页/段/区的逻辑单位,用于决定数据在磁盘上的组织方式。 |
| 表空间文件(Tablespace File) | 物理文件:.ibd、ibdata1、undo_001、ibtmp1 等,承载真实的页数据 |
更贴切的说法:表空间类型(系统/独立/通用/临时/撤销)规定了用途与结构规范,具体文件是该类型下的物理实例。
2.2 五类表空间对照表
| 系统表空间 | ibdata1 | 系统元数据、change buffer、回滚段(8.0 中 undo 已独立) |
| 独立表空间 | 表名.ibd | 单表的聚簇索引 + 二级索引 + 元数据页(默认模式) |
| 通用表空间 | 自定义 .ibd | 多表共享,CREATE TABLESPACE ts ADD DATAFILE … |
| 临时表空间 | ibtmp1、会话临时表空间 | 临时表、排序等中间结果 |
| 撤销表空间 | undo_001、undo_002 | undo log(MVCC 与回滚) |
2.3 独立表空间与 innodb_file_per_table
MySQL 5.6.6 起默认 ON,5.7/8.0 延续。
SHOW VARIABLES LIKE 'innodb_file_per_table'; — 默认 ON
- ON:每张表一个独立 .ibd,便于单表管理、OPTIMIZE、空间回收;
- OFF:新建表的数据进入系统表空间(ibdata1),删除表也不会缩小 ibdata1。
2.4 建表时到底生成了什么
| 表名.ibd | 独立表空间文件:数据 + 索引 + 表空间元数据页 |
| 表结构 | 8.0 存数据字典(mysql.ibd),不再有 .frm |
| SDI 页 | 8.0 的 .ibd 内含 SDI 页(JSON 格式表结构描述,可用 ibd2sdi 读取) |
三、数据在表空间中如何组织:页 → 区 → 区组 → 段
3.1 管理单元层级总表
| 页 Page | 16KB | InnoDB 管理的最小单元 = 4 个 4KB 操作系统块 |
| 区 Extent | 64 页 = 1MB | 向操作系统一次申请 1MB,保证区内页连续 |
| 区组 Extent Group | 256 区 = 256MB | 区的管理分组,用 XDES 记录区状态 |
| 段 Segment | 逻辑概念 | 按用途划分(叶子段/非叶子段),由区组成 |
3.2 为什么最小单元是页,而不是操作系统块
- 时间局部性:正在访问的信息近期很可能再次被访问;
- 空间局部性:将来要用的信息大概率与当前信息地址邻近。
页大小由 innodb_page_size 控制,可设 4K/8K/16K/32K/64K(默认 16K)。"4 个 block"只在 16KB 页时成立,页大小变化时对应块数也变。
3.3 页与页之间的块连续吗:用"区"解决
- 区内:一次申请 1MB(64 页),区内页与页之间保证连续;(从而提高io效率)
- 跨区:不保证连续(区的分配可能分散)。
3.4 小表也要一次申请一个区吗?
不需要,否则严重浪费空间。真实机制:
| 新建表 | .ibd 初始约 112KB = 7 页(碎连续),前 4 页是表空间元数据页,其余为初始数据页 |
| 小表增长 | 从碎片区(fragment)按页零散分配(一个区组的前 32 页可作为碎片页分给不同段) |
| 数据变大 | 当某个段内页数超过 32 页后,改为按完整区(64 页)分配 |
3.5 跨区访问怎么办:区组与 XDES
- 区组(Extent Group)管理 256 个区(256MB);
- 每个区的状态和归属记录在 XDES(Extent Descriptor,区组描述符) 数组中;
- 通过 XDES 能快速知道每个区的位置和状态(FREE / NOT_FULL / FULL),高效定位;
- 跨区的硬件随机 IO 无法完全避免。
| 访问位置 | 连续(相邻页 / 块) | 不连续(跳跃访问) |
| 寻址次数 | 一次定位,后续连续读 | 每次访问都要独立定位 |
| 能否预读 / 合并 | ✅ 可预读、可合并成大请求 | ❌ 难以预读,请求无法合并 |
| 机械盘开销 | 寻道一次,之后顺序传输 | 每次都要寻道 + 旋转延迟(毫秒级) |
| SSD 开销 | 大块传输吞吐高 | 小随机 IO 有 FTL 映射、写放大开销 |
| 数据库场景 | redo log 追加写、全表扫描 | B+Tree 逐层查找、二级索引回表、脏页分散刷盘 |
结论:计算偏移量是两种 IO 都要做的 "逻辑寻址" 步骤,不是随机 IO 的定义。随机 IO 描述的是 "目标位置不连续、每次都要重新物理定位、无法预读合并" 这种访问模式,因此产生额外寻址开销。
3.6 表空间头部页与区组管理页
(1)表空间前 4 页(page 0~3,固定元数据页)(第一个区组的第一个区)
| page 0 | FSP_HDR:表空间头,含区组描述符数组 |
| page 1 | IBUF_BITMAP:Change Buffer 位图 |
| page 2 | INODE:File Segment Inode(段信息) |
| page 3 | 8.0 为 SDI 页(表结构 JSON);旧版本为 B-tree 根页 |
(2)其余每个区组的第一个区的前两页
| 该区 page 0 | XDES 数组:管理该区组内 256 个区 |
| 该区 page 1 | IBUF_BITMAP:change buffer 位图 |
3.7 段:叶子段与非叶子段
- 一个索引对应两个段:
- 叶子节点段(leaf segment):存放 B+Tree 叶子页(用户数据 / 索引项);
- 非叶子节点段(non-leaf segment):存放内节点页(索引目录,用于路由查找);
- 一张表有多个索引 → 多个"叶子段 + 非叶子段";
- 段是逻辑概念,不直接对应磁盘上的连续区域;段内的区可以分散在不同区组。
3.8 .ibd 的本质
.ibd 的内容:
.ibd 文件
├── 元数据页(FSP_HDR / IBUF_BITMAP / INODE / SDI)
├── 聚簇索引树(主键索引树,叶子页存整行数据) ← "保存具体数据那一棵"
├── 二级索引树(每个二级索引一棵,叶子页存主键值)
└── (8.0)SDI 页:表结构 JSON
加粗要点:.ibd = 多棵 B+Tree + 表空间元数据页;主键索引树(聚簇索引)的叶子页承载真实数据行。
四、总结
4.1 背诵要点
4.2 一张表串起来
表空间(.ibd)
└── 段(逻辑:叶子段 / 非叶子段)
└── 区(64 页 = 1MB,区内连续)
└── 区组(256 个区 = 256MB,XDES 管理)
└── 页(16KB = 4 个操作系统块)
└── 行(B+Tree 叶子页中的数据记录)
本篇与专题其余篇章的关系:本篇只讲"架构全景 + 表空间组织",Buffer Pool 的 LRU/刷盘、Change Buffer 的合并机制、redo/undo 的格式与恢复流程、Doublewrite 的防断裂原理,分别在后续专篇展开。