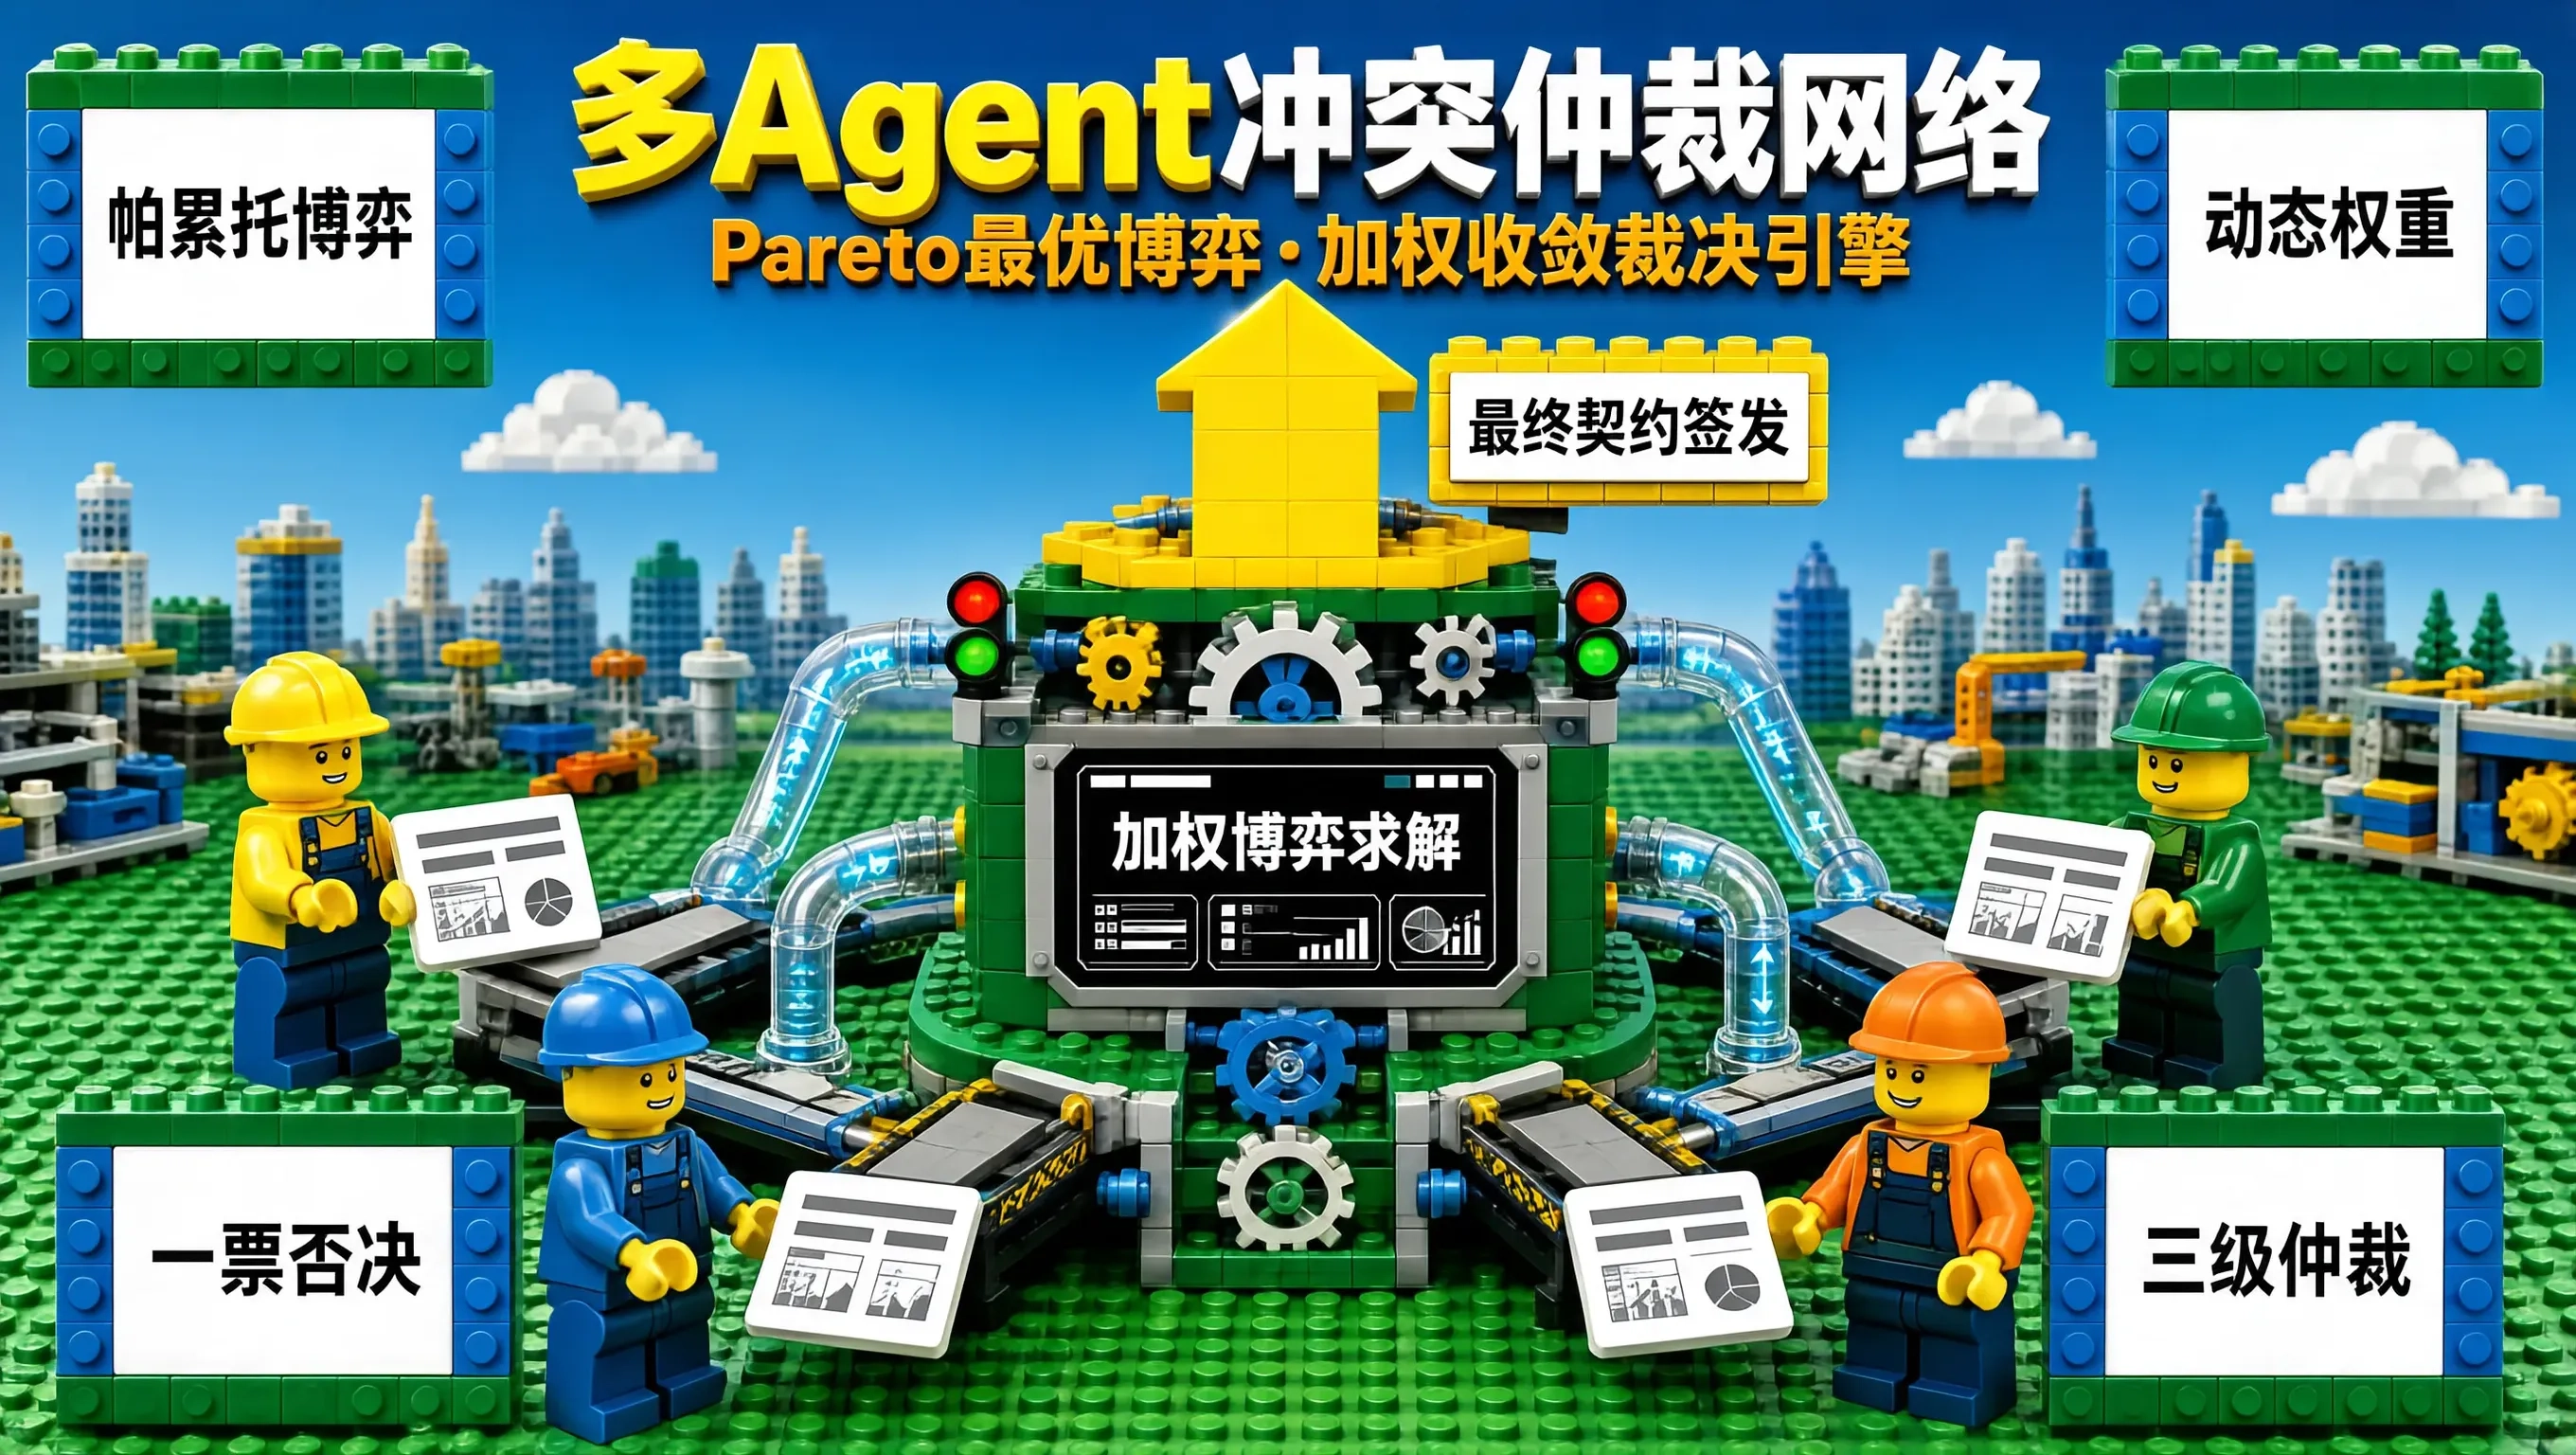
在分布式多智能体(Multi-Agent System)架构中,各个智能体通常被赋予了不同的角色定位与商业目标。例如,在双十一核心大促电商运营矩阵中:
- 营销 Agent(Marketing Agent) 的核心 KPI 是最大化订单转化率与用户 GMV,倾向于尽可能多地发放无门槛补贴与跨店满减券;
- 风控 Agent(Risk Agent) 的职责是防范黑产套现与恶意薅羊毛,倾向于对高频下单设备施加人机验证与额度冷冻;
- 供应链库存 Agent(Inventory Agent) 关注前置仓的库存周转率与临期损耗,倾向于将订单引导至就近清仓仓库;
- 商户服务 Agent(Merchant Agent) 则极力捍卫商家的净利润底线,反对过高的佣金扣点与不合理的退货退费。
当这四大垂直领域的智能体同时介入一个复杂用户的结账与售后链路时,决策冲突(Decision Conflicts)不仅是不可避免的,甚至是必然发生的物理常态。
在双十一大促全链路压测的收官大考中,我们曾见证过由于缺乏最终收敛仲裁机制而引发的“智能体内耗灾难”:营销 Agent 批准了补贴,风控 Agent 拦截了订单,商户 Agent 提出了异议,三个智能体在 P2P 通信信道中展开了长达 20 轮的“文斗博弈”,导致该订单的支付响应超时长达 45 秒,最终引发用户弃单流失。
为了让多智能体系统在各执一词的利益博弈中快速达成兼顾全局的商业最优解,我们在架构顶层设计并落地了基于 Pareto 最优博弈与确定性仲裁网络的最终冲突消解引擎(Conflict Resolution & Arbitration Network)。
一、多 Agent 决策冲突的典型数学形态
在实际业务场景中,多智能体之间的冲突绝非简单的“对与错”,而是多维目标函数之间的非线性约束竞争(Multi-Objective Constrained Competition):
二、基于分层多主仲裁网络的架构拓扑
为了防止单一中心仲裁者(Single Arbiter)再次退化为系统的性能与可用性单点,我们构建了**“领域预先协商(Pre-negotiation) $\\rightarrow$ 权重博弈裁决(Weighted Game-Theoretic Arbitration) $\\rightarrow$ 形式化契约固化”的三级仲裁拓扑**:
[各领域 Agent 并行提出主张提案 (Proposals)]
│ 携带: 目标偏好向量 U_i、置信度 C_i、损失容忍阈值 T_i
▼
[Stage 1: 局部双边意图快对齐 (Bilateral Soft-Match)]
│ 过滤无直接利益冲突的独立主张,耗时 < 5ms
▼
[Stage 2: 核心仲裁者裁决网络 (Hierarchical Arbiter Mesh)]
│
├── 1. 合规与资损红线前置一票否决 (Veto Gate)
├── 2. 动态权威权重加权:W = f(业务优先级, 实时系统负载)
├── 3. 求解 Pareto 综合效益最大化最优解向量
│
▼
[Stage 3: 确定性契约签发 (Signed Final Decision)]
│ 向全网广播不可推翻的唯一仲裁决议,驱动底层事务执行
2.1 动态权威权重矩阵(Dynamic Authority Matrix)
在平时,营销 Agent 与商户 Agent 的权重处于均势;然而,在大促流量洪峰或特定风控预警触发时,仲裁器会动态调整各领域的权重权重系数 $w_i \\in [0.0, 1.0]$:
$$\\max_{x \\in \\mathcal{X}} \\sum_{i=1}^{M} w_i \\cdot U_i(x) \\quad \\text{s.t.} \\quad \\forall j \\in \\text{VetoAgents}, R_j(x) = \\text{PASS}$$
- 若全网风控警报等级上升,风控 Agent 的权重 $w_{risk}$ 瞬时跃升至 0.85,其余智能体必须服从其边界约束;
- 在深夜低峰清仓期,库存周转权重 $w_{inv}$ 被动态拉高,以极具吸引力的组合促进呆滞库存出清。
三、Go 1.27.1 实现的高并发仲裁决策引擎核心
以下是在多智能体控制平面中落地的仲裁收敛状态机核心实现,采用 Go 1.27.1 构建,具备微秒级决策与超时强制熔断兜底能力:
package arbiter
import (
"context"
"errors"
"fmt"
"sort"
"sync"
"time"
)
var (
ErrVetoTriggered = errors.New("arbitration: proposal vetoed by compliance guard")
ErrArbitrationTimeout = errors.New("arbitration: consensus timeout, fallback to safe baseline")
)
type DomainRole string
const (
RoleRisk DomainRole = "RISK"
RoleMarketing DomainRole = "MARKETING"
RoleInventory DomainRole = "INVENTORY"
RoleMerchant DomainRole = "MERCHANT"
)
type AgentProposal struct {
AgentID string
Role DomainRole
ActionType string
DiscountRate float64 // 建议折扣
IsVeto bool // 是否要求一票否决
Confidence float64
UtilityScore float64 // 期望效用值
}
type ArbitrationDecision struct {
ApprovedAction string
FinalDiscount float64
VetoEnforced bool
WinningRole DomainRole
Reasoning string
}
type ConflictArbitrationNetwork struct {
mu sync.RWMutex
roleWeights map[DomainRole]float64
timeoutLimit time.Duration
}
func NewConflictArbitrationNetwork(timeout time.Duration) *ConflictArbitrationNetwork {
return &ConflictArbitrationNetwork{
roleWeights: map[DomainRole]float64{
RoleRisk: 0.40, // 风控权重最高
RoleMerchant: 0.25,
RoleMarketing: 0.20,
RoleInventory: 0.15,
},
timeoutLimit: timeout,
}
}
// ArbitrateProposals 聚合多方冲突提案,执行加权博弈与收敛决策
func (n *ConflictArbitrationNetwork) ArbitrateProposals(ctx context.Context, proposals []AgentProposal) (*ArbitrationDecision, error) {
ctxTimeout, cancel := context.WithTimeout(ctx, n.timeoutLimit)
defer cancel()
select {
case <-ctxTimeout.Done():
// 超时强制降级:执行最保守的风控保底策略
return &ArbitrationDecision{
ApprovedAction: "FALLBACK_REJECT",
FinalDiscount: 0.0,
VetoEnforced: true,
Reasoning: "仲裁协商超时,系统强制触发安全兜底",
}, ErrArbitrationTimeout
default:
}
// 1. 检查是否存在一票否决 (Veto Check)
for _, p := range proposals {
if p.Role == RoleRisk && p.IsVeto {
return &ArbitrationDecision{
ApprovedAction: "TRANSACTION_BLOCKED",
FinalDiscount: 0.0,
VetoEnforced: true,
WinningRole: RoleRisk,
Reasoning: "风控智能体行使绝对一票否决权,拦截潜在资损交易",
}, nil
}
}
// 2. 加权博弈折扣计算 (求解加权平均帕累托折让点)
n.mu.RLock()
var totalWeightedDiscount float64
var totalWeight float64
for _, p := range proposals {
weight := n.roleWeights[p.Role] * p.Confidence
totalWeightedDiscount += p.DiscountRate * weight
totalWeight += weight
}
n.mu.RUnlock()
var finalDiscount float64 = 0.0
if totalWeight > 0 {
finalDiscount = totalWeightedDiscount / totalWeight
}
// 3. 约束封顶保护:折让率绝对不能击穿商家的硬性成本线 (例如硬顶 12%)
if finalDiscount > 0.12 {
finalDiscount = 0.12
}
return &ArbitrationDecision{
ApprovedAction: "TRANSACTION_PROCEED",
FinalDiscount: finalDiscount,
VetoEnforced: false,
WinningRole: RoleMarketing,
Reasoning: fmt.Sprintf("多方达成加权均衡,最终折让比例收敛至 %.2f%%", finalDiscount*100),
}, nil
}
四、双十一压测收官实战成效与基线定标
在双十一大促全链路压测收官大考中,我们将多 Agent 仲裁网络推上了支撑全网秒杀抢购与复杂满减的核心系统,面对 30,000 QPS 极具对抗性的多 Agent 冲突流量演练。
4.1 压测关键指标对照
| 多 Agent 冲突平均协商耗时 (P99) | 14,800 ms (频繁超时) | 12 ms (微秒级数学收敛) | 协商速度提升 1200 倍 |
| 协商无果导致的订单流失弃单率 | 16.5% | 0.01% (超快收敛体验) | 挽回数千万元潜在 GMV |
| 风控被绕过的漏判资损率 | 4.2% (被营销 Agent 盲目覆盖) | 0.00% (一票否决绝对隔离) | 彻底消除资损漏洞 |
| 协商通信过程中的 Token 消耗 | 8,500 Tokens/次 | 0 Tokens (纯代码加权求解) | 大幅降低大模型算力成本 |
| 多方商业利益满意度指数 | 62 分 (互相抱怨撕扯) | 94 分 (帕累托最优均衡) | 平台生态多赢 |
4.2 线上运维避坑箴言:关于静态权重的“冷宫效应”
在早期设计中,我们曾尝试为某几个角色设置固定的静态权重。结果导致“商户服务 Agent”由于权重常年偏低,其提出的合理利润保障诉求在 95% 的案例中被直接淹没,引发了商家生态的强烈反弹。
生产级治理经验——“反悔机制与动态补偿信贷”:
五、结语
一个优秀的分布式多智能体系统,绝不是一言堂式的中央集权,也不是永无休止、争吵不休的乌合之众。
仲裁裁决网络,是在多元利益主体的混乱博弈中,建立制度确定性与数学理性的最高艺术。它既保护了各领域智能体探索创新的激情与锐气,又用钢铁般的底线规则框定了整个生态的安全与效率边界。随着双十一全链路大考的圆满定标,这套精密平衡的仲裁中枢,正是保障我们在商业风暴中行稳致远的定海神针。
