接口报超时,数据库慢查询日志里却找不到对应SQL。诊断助手拿到“响应时间长、活跃连接高”两项信息,马上建议优化查询或增大连接池。
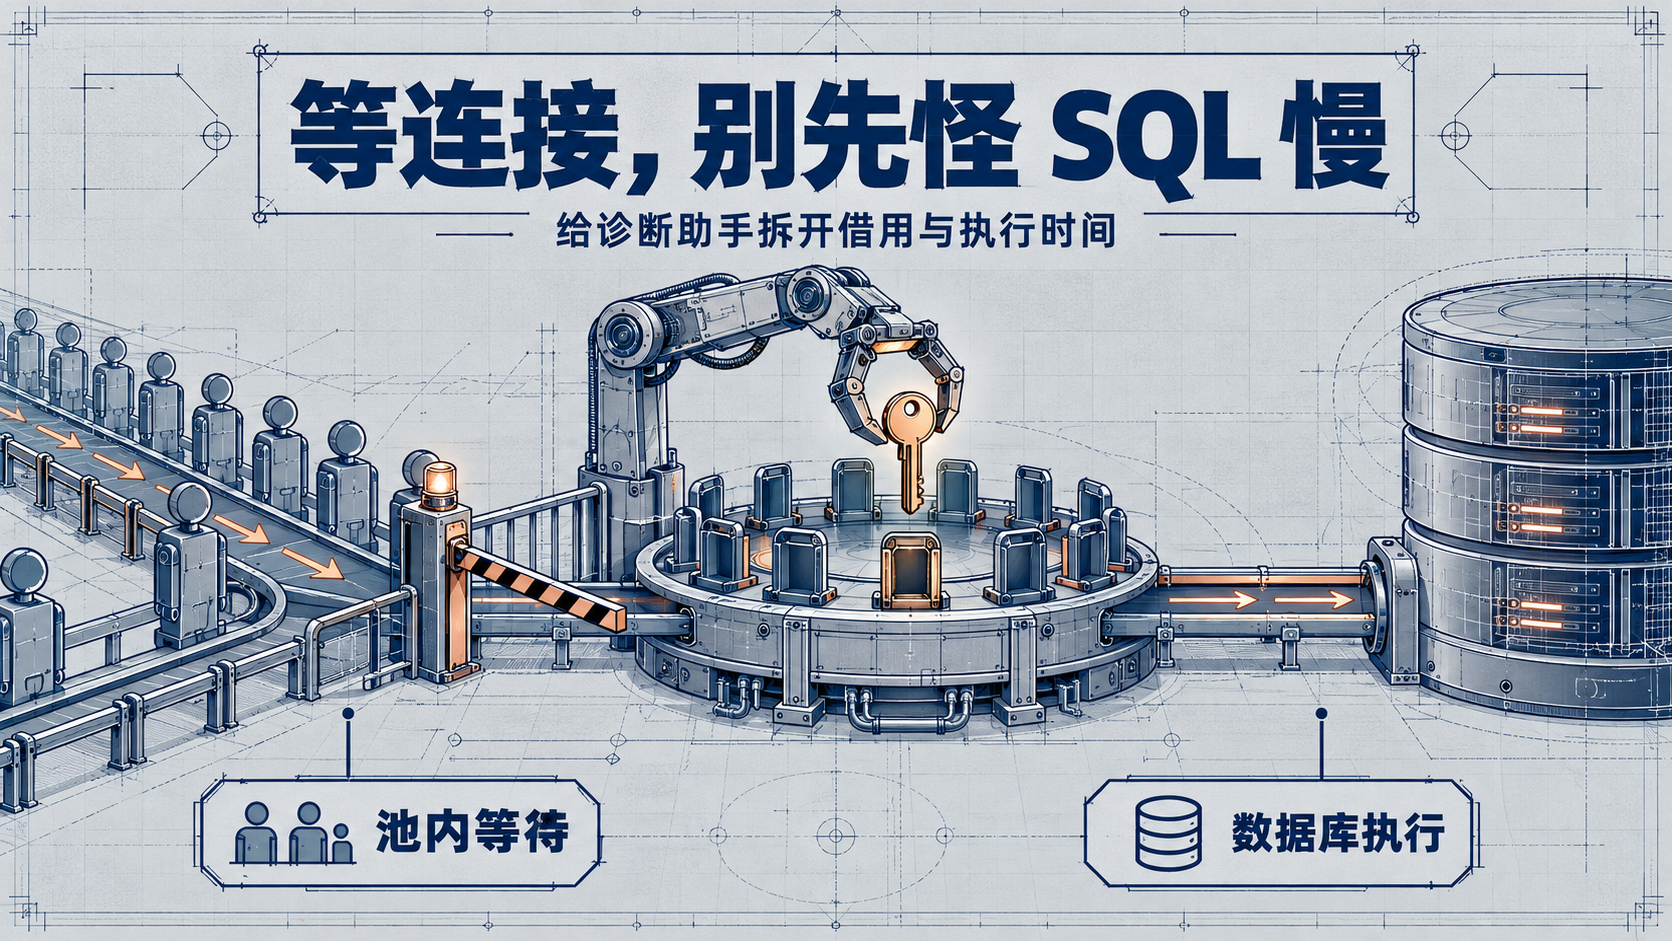
它可能连问题发生在哪一段都没确认。请求还在等连接时,SQL根本没有送到数据库;数据库里当然找不到它的执行耗时。
本文用一个自建单槽租借器,租借一条真实的隔离MySQL连接,实际演示借用超时。它不是现成连接池实现,也不承担吞吐或故障恢复基准,只把诊断输入的时间边界固定下来。底层使用的有界队列及超时行为已核对 Python 3.9 Queue文档;超时参数不是线程能在该时刻精确调度的承诺。
在自有连接上,故意留住租约
实验数据库是MySQL 8.4.11的无网络临时容器。Python驱动启动一条客户端连接,以容量为1的有界队列保存连接句柄。队列只表示“当前可借用句柄”,不是对某款连接池内部结构的推断。
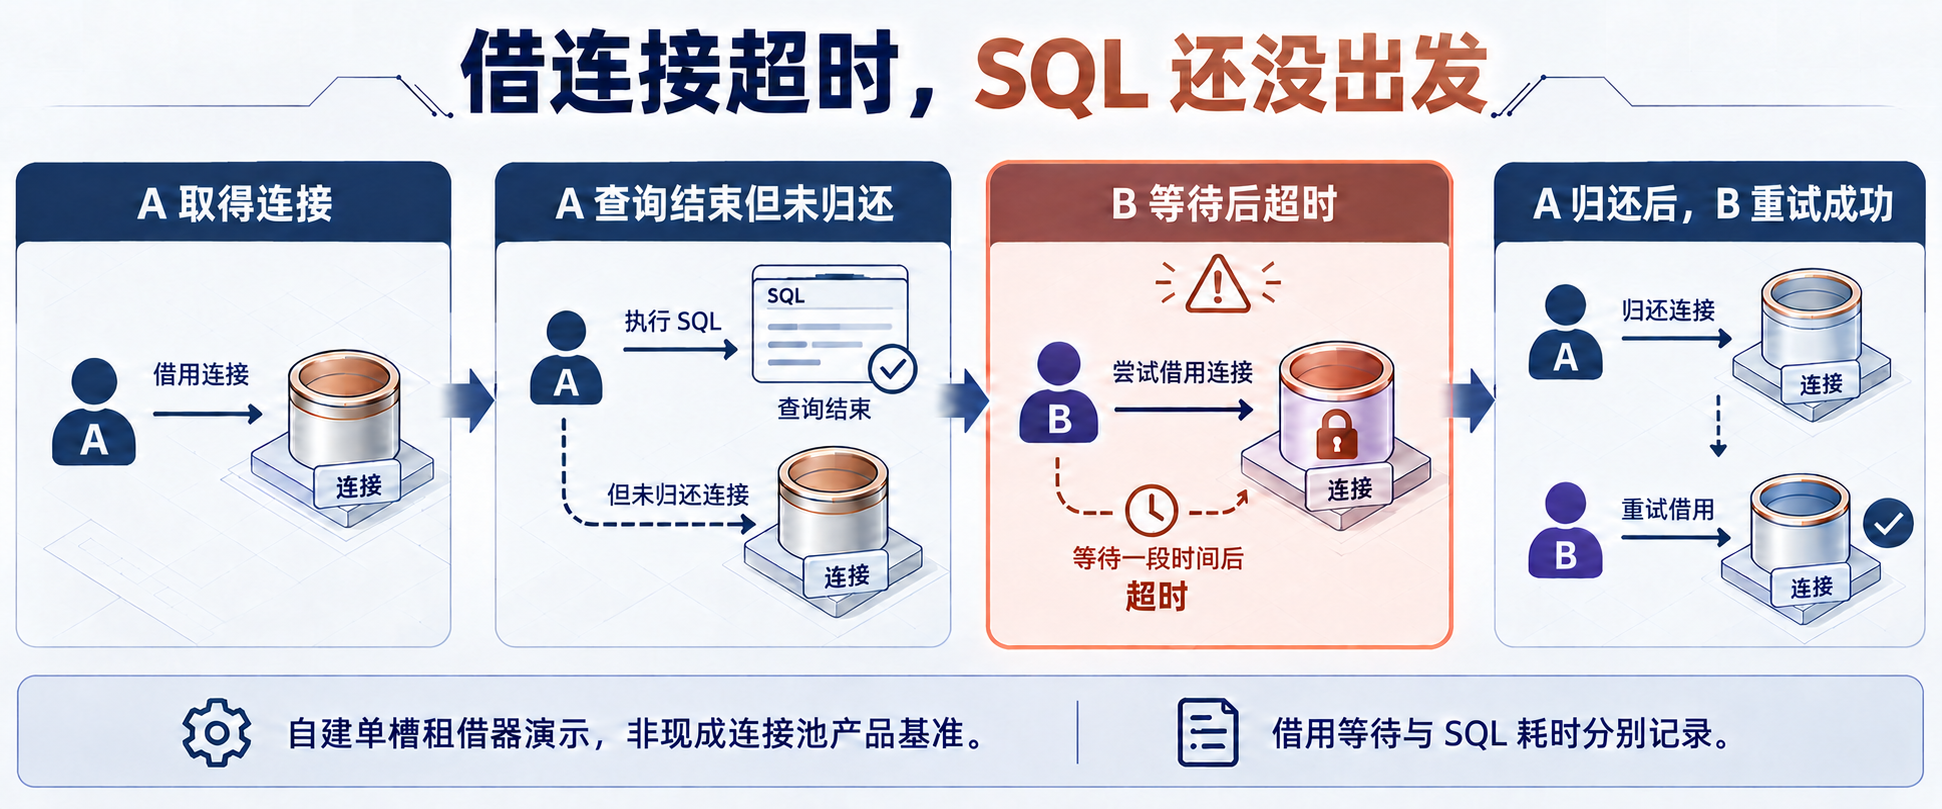
按以下确定顺序执行:A拿走句柄,读取连接ID,再执行SELECT 1;确认查询已返回之后,A故意不归还句柄。B开始借用,最长等待0.1秒。B超时并确认没有发SQL后,A才归还,B再借用并执行SELECT 1。
实际检查得到:A的SELECT 1返回1;B第一次借用超时,没有发送SQL;A归还后,B重试的SELECT 1也返回1。
这里的A、B是逻辑请求角色,不是两条同时执行SQL的数据库连接。整个样本只租借一条真实连接,数据库操作被串行保护。
“查询结束”与“连接归还”之间,还有一段时间
| A借用 | 持有唯一句柄 | 尚未开始 | 读取连接ID |
| A查询 | 等待返回 | 尚未开始 | SELECT 1成功 |
| A未归还 | 查询已结束,仍持有租约 | 借用等待 | B没有SQL |
| B超时 | 仍持有租约 | 借用超时 | B没有SQL |
| A归还 | 释放句柄 | 重试借用 | B的SELECT 1成功 |
因此,连接池容量占用不能简单等同于数据库正在执行的语句数。连接可能被用于结果消费、事务内业务处理,也可能因为异常路径没有归还。具体是哪种情况,必须看租借生命周期。
本例故意制造的是“查询完成但租约仍被持有”,没有制造真实程序泄漏、慢结果消费或事务锁等待,不能把这几种根因混称为已经复现。
给日志加上生命周期,才有地方放耗时
借用开始、借用成功、语句发送、首行返回、结果消费结束、连接归还,应当是不同事件。请求失败时,也记录失败发生在哪一段,而不是只留下一个total_ms。
| request_id与尝试号 | 把第一次失败和重试分开 |
| pool_id、配置版本、容量 | 对应到同一个池与配置 |
| checkout_start、checkout_end | 借连接到底等了多久 |
| lease_id与连接身份 | 哪个请求持有哪条连接 |
| sql_start、sql_end | 只记录实际发送的语句阶段 |
| checkin或discard | 连接如何结束本次租约 |
| 错误类型与取消状态 | 区分借用超时、执行超时和取消 |
应用侧阶段耗时宜使用可比较的单调时钟;跨进程的事件对齐再辅以明确的时间来源。不能把两台机器未校准的墙上时间直接相减,得出精确的借用延迟。
本次驱动实际记录了单调纳秒时间戳、队列可用数量、查询文本与返回结果。它没有接入分布式链路追踪,也没有把这些字段配置成真实监控产品。
B没发SQL,缺少慢查询日志反而是符合预期
样本原始记录中只有三次实际SQL:读取连接ID、A的SELECT 1、B重试的SELECT 1。第一次B借用失败期间,语句列表没有新增项,这一点已用断言核对。
所以当前证据支持“B的失败发生在自建租借器等待阶段”。它不能说明数据库在所有时间都没有压力,也不能把这个例子扩展为“慢日志没有记录就一定是连接池”。
真实系统还可能出现SQL采样未命中、日志丢失、错误路由、连接建立失败或网络问题。把观测缺失标为缺失,不能让AI自动填成“没有执行”。本例能做出明确判断,是因为驱动控制了发送点并保留完整事件顺序。
候选根因要附上支持与反对证据
对这份样本,人工诊断是:A已完成SQL但尚未归还租约,唯一槽位不可借,B因此超时;归还后重试成功,支持这个解释。这里有刻意安排的因果顺序,不是只看两条监控曲线的相关性。
诊断助手可以用相同方式组织真实问题:
| 租约长期未归还 | SQL结束后持有时间长,缺少checkin | 连接实际已丢弃,统计延迟 |
| 数据库执行拖长占用 | 租约内SQL与等待事件同窗增长 | 超时请求尚未发送SQL |
| 创建连接缓慢 | 可用不足且建连阶段耗时增长 | 没有触发建连,全部槽位被占 |
| 流量超过有界容量 | 同窗到达与等待队列持续增加 | 到达未增,持有时间突变 |
这些候选不是本文已经验证的四种故障。只有第一行的受控持有场景在自建租借器中被实际演示,其余是需要补材料的诊断路径。
不要把“增大连接池”当成默认修复
池容量变大可能减少一部分借用等待,也可能让更多并发进入数据库,把队列从应用侧搬到数据库侧。若真正问题是租约不归还,增加容量还会延后暴露故障。
先核对持有时间、归还与丢弃路径、事务边界和请求取消。决定是否调整容量时,应有数据库承载预算、排队上限、超时与拒绝策略,并用自己的隔离负载验证。本文没有运行这种负载,所以不给容量建议值。
同样,借用超时后的重试要有总预算。不能每次都重新给一个完整超时,再把等待无限延长。取消时是否仍排队、超时后是否会迟到获得连接,都要由具体连接池实现测试,不能从这个队列例子推断。
这次有限样本最终只承诺一件事:能区分“借不到连接”和“数据库执行慢”,并用实际发送记录核对。AI诊断先把请求停在哪个阶段说清,再讨论索引或连接数,才不会拿数据库参数修应用租约的问题。