在构建现代应用时,我们常常面临一个痛点:如何让软件不仅被动响应指令,而是能主动理解意图、规划步骤并调用工具去解决复杂问题。传统的函数调用或简单的脚本自动化往往缺乏灵活性,一旦场景稍有变化就需要重写大量逻辑。而智能体(Agent)技术的出现,恰好填补了这一空白。它允许开发者定义具有“思考”能力的程序实体,通过大语言模型作为大脑,结合具体的工具链,自主完成从信息检索、数据分析到执行操作的全流程任务。
对于许多后端工程师和全栈开发者而言,将智能体集成到现有系统中并非遥不可及的理论概念,而是一项亟需落地的工程实践。无论是构建自动化的客服助手、智能数据分析师,还是能够自主运维的系统管家,核心都在于如何高效地搭建开发环境、管理敏感凭证以及编排可靠的工作流。很多初学者容易在环境配置的繁琐步骤中迷失,或者在密钥管理和错误排查上耗费过多精力,导致项目迟迟无法跑通第一个 Demo。
本文将深入探讨从零开始构建智能体应用的完整路径。我们将跳过晦涩的理论推导,直接聚焦于可操作的工程细节:从核心概念的精准定位,到开发环境的快速搭建;从安全的密钥配置策略,到首个智能体项目的初始化实战。更重要的是,我们会详细拆解工具链集成的具体代码实现,分享本地调试与生产部署中的常见坑点及优化技巧。无论你是希望提升现有系统的智能化水平,还是想探索 AI 应用开发的新边界,这套经过验证的实践指南都能帮助你少走弯路,快速构建出稳定、高效且安全的智能体应用。
① 核心概念解析与应用场景定位
智能体(Agent)与传统脚本或普通 API 调用的本质区别,在于其具备“感知 – 规划 – 行动”的闭环能力。在传统模式下,开发者需要硬编码每一个判断分支和执行步骤,程序只是机械地按既定路线运行。而智能体则是以大语言模型为核心控制器,它能够接收模糊的自然语言指令,自主拆解任务目标,动态选择可用的工具(Tools),并在执行过程中根据反馈实时调整策略。这种机制使得系统能够处理非结构化输入,应对未曾预设的异常场景。
在实际应用场景中,智能体的价值主要体现在三类典型需求上。首先是复杂任务自动化,例如企业内部的报表生成系统,智能体可以自动连接数据库查询数据,调用绘图库生成图表,最后撰写分析报告并发送邮件,全程无需人工干预中间环节。其次是交互式辅助系统,如智能技术支持助手,它不仅能回答静态知识库中的问题,还能实时调用工单系统查询用户状态,甚至直接执行重启服务等操作。最后是数据洞察与分析,面对海量日志或非结构化文档,智能体可以自主编写查询语句、提取关键指标并总结趋势,充当初级数据分析师的角色。明确这些场景定位,有助于我们在后续开发中选择合适的模型能力和工具集,避免过度设计或功能不足。
② 开发环境搭建与依赖安装步骤
工欲善其事,必先利其器。构建智能体应用通常基于 Python 生态,因为其拥有丰富的 AI 相关库和便捷的胶水语言特性。首先,建议创建一个独立的虚拟环境,以避免全局依赖冲突。可以使用 venv 或 conda 进行隔离:
python -m venv agent_env
source agent_env/bin/activate # Windows 下使用 agent_env\\Scripts\\activate
环境激活后,核心依赖的安装主要集中在框架层和模型交互层。目前主流的智能体开发框架提供了高层抽象,简化了状态管理和记忆模块的实现。假设我们采用通用的开发模式,需要安装基础的网络请求库、异步处理库以及特定的智能体框架 SDK:
pip install requests aiohttp python-dotenv
pip install your-agent-framework # 替换为实际使用的框架名称
此外,为了支持本地调试和热重载,推荐安装 ipython 和 nodemon(若涉及前端展示)等开发工具。在项目根目录下创建 requirements.txt 文件锁定版本是良好的工程习惯,确保团队协作时环境的一致性。值得注意的是,部分高级功能如向量数据库检索或本地模型推理,可能还需要安装额外的驱动包(如 chromadb 或 torch),应根据具体选用的技术栈按需引入,保持环境轻量化。
③ 账户认证配置与密钥管理方法
智能体应用的核心在于调用大模型服务及第三方 API,这必然涉及敏感的 API Key 和认证凭证。硬编码密钥是严重的安全隐患,一旦代码泄露将导致资源被盗用甚至数据泄露。最佳实践是严格遵循“十二要素应用”原则,将所有敏感信息通过环境变量注入。
首先在项目根目录创建 .env 文件,并将该文件加入 .gitignore 列表,确保其永远不会被提交到版本控制系统中。文件格式如下:
LLM_API_KEY=sk-your-actual-api-key-here
DATABASE_URL=postgresql://user:pass@localhost/dbname
EXTERNAL_TOOL_SECRET=tool-secret-token
在代码中读取这些变量时,推荐使用 python-dotenv 库在应用启动初期加载:
import os
from dotenv import load_dotenv
# 加载 .env 文件内容到环境变量
load_dotenv()
# 安全获取密钥,若不存在则抛出明确错误或提供默认值(仅限开发环境)
api_key = os.getenv("LLM_API_KEY")
if not api_key:
raise ValueError("缺少必要的 LLM_API_KEY 环境变量配置")
对于生产环境,应利用云平台提供的密钥管理服务(如 AWS Secrets Manager 或 Azure Key Vault)来动态获取凭证,而非依赖本地文件。同时,建议为不同功能模块申请最小权限范围的 Token,例如只读权限的数据库账号和仅能调用特定接口的 API Key,通过权限隔离降低潜在风险。
④ 首个智能体项目的创建与初始化
当环境与配置就绪后,我们可以着手创建第一个智能体实例。初始化的核心是定义智能体的“人设”(System Prompt)和基础能力。System Prompt 决定了智能体的行为边界和回复风格,它是智能体的灵魂。
以下是一个最小化的初始化示例,展示如何定义一个专注于代码审查的智能体:
from your_agent_framework import Agent, LLMConfig
# 配置模型参数
llm_config = LLMConfig(
model_name="advanced-model-v1",
temperature=0.2, # 较低温度以保证逻辑严谨性
max_tokens=2048
)
# 定义智能体
code_reviewer = Agent(
name="CodeReviewerBot",
description="专门用于审查 Python 代码质量和安全漏洞的助手",
system_prompt="""
你是一位资深 Python 架构师。你的任务是审查用户提交的代码片段。
请重点关注:
1. 潜在的内存泄漏和资源未释放问题。
2. 不符合 PEP8 规范的写法。
3. 常见的安全漏洞(如 SQL 注入风险)。
输出格式要求:先列出问题点,再给出修改后的代码建议。
""",
llm_config=llm_config
)
在这个阶段,不需要急于挂载复杂的工具。首要目标是验证智能体能否正确加载配置,并根据 System Prompt 做出符合预期的基础回应。可以通过简单的文本输入进行测试,观察其是否严格遵守了“资深架构师”的语气和分析维度。如果智能体开始“幻觉”或偏离主题,通常需要微调 System Prompt 的措辞或调整模型的 Temperature 参数。
⑤ 工具链集成与工作流编排实战
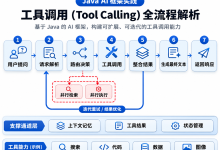
智能体的强大之处在于“手眼通天”,即能够调用外部工具。工作流编排的本质是将多个工具串联,形成解决复杂任务的链条。我们需要定义清晰的工具接口(Function Schema),让大模型理解每个工具的用途、参数及返回值。
假设我们需要智能体具备查询天气和发送通知的能力。首先定义工具函数:
def get_weather(city: str) –> str:
"""获取指定城市的当前天气状况"""
# 模拟 API 调用
return f"{city} 当前晴朗,气温 25 度"
def send_notification(user_id: str, message: str) –> bool:
"""向指定用户发送通知消息"""
print(f"Sending to {user_id}: {message}")
return True
# 注册工具到智能体
code_reviewer.register_tool(get_weather)
code_reviewer.register_tool(send_notification)
在现代框架中,通常支持自动解析函数签名生成 JSON Schema,使模型能够识别何时调用哪个工具。工作流编排则体现在多步推理中。例如,用户指令是“如果北京下雨,就通知用户 ID 为 1001 的人带伞”。智能体会先调用 get_weather("北京"),根据返回结果判断条件是否满足,若满足则自动触发 send_notification。
为了增强鲁棒性,建议在工具调用层增加重试机制和超时控制。对于可能失败的外部 API 调用,包裹一层异常处理逻辑,并将错误信息以自然语言反馈给模型,让其决定是重试还是告知用户无法完成,而不是直接崩溃。
⑥ 本地调试运行与输出结果验证
开发过程中的调试环节至关重要。由于智能体的执行路径具有动态性,传统的断点调试有时难以捕捉其思维过程。有效的调试策略包括开启详细的日志记录和思维链(Chain of Thought)可视化。
在本地运行时,建议启用框架的 verbose 模式,打印出每一步的决策日志:
# 开启详细日志
import logging
logging.basicConfig(level=logging.DEBUG)
# 执行任务
response = code_reviewer.run("检查这段代码:print('hello')")
print(response)
观察日志时,重点关注的不是最终答案,而是中间的“思考过程”:模型是否正确识别了意图?是否选择了正确的工具?传入工具的参数是否符合预期?如果模型陷入了循环调用或选择了错误工具,通常是因为 System Prompt 描述不清或工具定义的特征不明显。
验证输出结果时,除了人工检查,还可以编写自动化测试用例。针对确定性较强的任务(如数学计算、格式化转换),断言输出结果是否符合标准;对于开放性任务,则可以检查输出是否包含了关键词或遵循了指定的结构格式。通过构建一套包含正常场景和边缘场景的测试集,可以持续评估智能体的稳定性。
⑦ 常见部署报错分析与排查思路
在从本地迁移到服务器或容器环境时,常会遇到各类报错。最常见问题之一是“上下文超长”导致的截断错误。当对话历史或工具返回数据过大,超过了模型支持的 Token 上限,请求会直接失败。排查思路是检查输入数据的长度,并在代码层面实施摘要策略或滑动窗口机制,仅保留最近几轮的关键对话信息。
另一类高频错误是“工具调用参数不匹配”。这通常发生在模型生成的参数类型与函数定义不符(例如传入了字符串而非整数)。解决方法是在工具注册时提供更详尽的参数描述(Description),甚至在 System Prompt 中强调参数格式的严格要求。此外,网络超时也是部署环境的常客,特别是在调用外部 API 时。务必在所有网络请求中设置合理的 timeout 参数,并设计降级方案,例如当天气服务不可用时,提示用户暂时无法获取相关信息,而不是让整个进程挂起。
查看报错堆栈时,不要只看最外层的异常,要深入分析内部引发的原因。如果是依赖库版本冲突导致的底层错误,尝试在纯净环境中重新安装依赖,或使用 Docker 容器化部署以屏蔽环境差异。
⑧ 性能优化技巧与资源占用控制
随着业务量增长,智能体的响应速度和资源消耗成为关键指标。优化首要是减少不必要的 Token 消耗。大模型的计费通常基于 Token 数量,冗长的 System Prompt 或过多的对话历史都会增加成本并拖慢速度。技巧包括:压缩 System Prompt 去除冗余修饰词;对长文档输入进行预处理,只提取相关片段送入模型;使用小模型处理简单分类任务,仅在复杂推理时调用大模型。
在并发控制方面,异步编程是必选项。确保所有的 I/O 操作(网络请求、数据库读写)都使用 async/await 语法,避免阻塞主线程。对于高并发场景,可以引入消息队列(如 RabbitMQ 或 Kafka)作为缓冲,将用户的请求排队处理,平滑流量峰值,防止瞬间大量请求打挂模型服务。
内存管理同样重要。智能体在运行过程中可能会缓存大量的中间状态,需定期清理不再需要的上下文数据。对于长期运行的服务,建议设置最大内存阈值,监控进程资源使用情况,必要时采用多实例部署配合负载均衡来分散压力。
⑨ 安全最佳实践与权限隔离策略
安全是智能体落地的底线。除了前文提到的密钥管理,还需防范“提示词注入”攻击。恶意用户可能通过特殊的输入诱导智能体忽略 System Prompt,执行未授权操作。防御策略包括:在输入进入模型前进行过滤,拦截包含特定指令模式的文本;将用户输入与系统指令在数据结构上严格分离,不让用户内容直接拼接到系统提示词中;对敏感操作(如删除数据、转账)增加二次确认机制或限制仅允许受信任的源触发。
权限隔离方面,应遵循最小权限原则。智能体调用的数据库账号不应拥有 DROP 或 ALTER 权限;调用的第三方 API Token 应限制 IP 白名单和调用频率。如果智能体需要访问文件系统,应将其限制在特定的沙箱目录内,禁止访问系统关键路径。
此外,建立完善的审计日志系统,记录每一次工具调用的输入、输出、时间及操作者身份。这不仅有助于故障回溯,也是合规性审查的重要依据。定期对智能体的行为进行红队测试,模拟攻击场景,及时发现并修补逻辑漏洞。
⑩ 进阶功能扩展与生产环境迁移
当基础功能稳定后,可以考虑引入进阶特性以提升体验。长期记忆(Long-term Memory)是一个重要方向,通过向量数据库存储历史交互的关键信息,使智能体能够跨越会话记住用户的偏好和项目背景,实现真正的个性化服务。多智能体协作(Multi-Agent System)则是另一个趋势,将复杂任务拆解,由专门负责规划的“主管智能体”分配给擅长 coding、写作或数据分析的“专家智能体”协同完成,大幅提升解决超复杂问题的能力。
生产环境迁移不仅仅是代码的搬运,更涉及可观测性建设。集成 Prometheus 和 Grafana 监控 QPS、延迟、Token 消耗率及错误率等核心指标。配置告警规则,一旦异常比例超过阈值立即通知开发人员。同时,建立灰度发布机制,新版本智能体先对小部分用户开放,收集反馈并验证稳定性后再全量推送。
最后,保持技术栈的迭代更新。AI 领域发展迅速,新的模型架构和优化工具层出不穷。定期评估现有方案的性能瓶颈,适时引入更高效的推理引擎或更聪明的基座模型,确保持续为用户提供高质量的服务。从 Demo 到生产,是一场关于稳定性、安全性和可扩展性的持久战,唯有严谨的工程化思维才能护航智能体行稳致远。