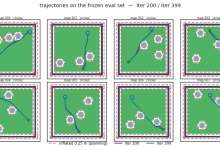
【PPO完全解构】从一次 rollout 到一次权重更新,附带训练曲线判读与策略部署
/* MD / 富文本中的 .toc(含博客园搬家等嵌套结构);.toc-box 在侧栏,不受影响 */#content_views .toc,/* 编辑器常在...
/* MD / 富文本中的 .toc(含博客园搬家等嵌套结构);.toc-box 在侧栏,不受影响 */#content_views .toc,/* 编辑器常在...
写在前面 Agent、Agentic RL在当前(2026年年中)是一个快速发展且仍在持续迭代的方向。本文系统整理当前主要的经典方...
博主是很早接触了长城run这款极简跑酷游戏,当时觉得这款游戏很无聊,但是,现在来看,不失为一份极佳的强化...
2017 年,OpenAI 团队发表《Proximal Policy Optimization Algorithms》,没有提出颠覆...
Franka Panda 机械臂强化学习项目 — 技术文档(已开源) PPO MuJoCo 强化学习训练框架 — 单臂目标到达 ...
 admin