/* MD / 富文本中的 .toc(含博客园搬家等嵌套结构);.toc-box 在侧栏,不受影响 */
#content_views .toc,
/* 编辑器常在目录前后插入空 p(:empty 仍占 20px),一并去掉避免顶空隙 */
#content_views.markdown_views > p:empty:has(+ .toc),
#content_views.markdown_views > .toc + p:empty,
/* 富文本旧版目录标记 */
#content_views.htmledit_views #main-toc,
#content_views.htmledit_views #hr-toc,
#content_views.htmledit_views p[id*=\”-toc\”] {
display: none !important;
}
/* 目录去掉后,紧跟的首个标题不再多出一块上边距 */
#content_views.markdown_views > .toc + h1,
#content_views.markdown_views > .toc + h2,
#content_views.markdown_views > .toc + h3,
#content_views.markdown_views > .toc + h4,
#content_views.markdown_views > .toc + p:empty + h1,
#content_views.markdown_views > .toc + p:empty + h2,
#content_views.markdown_views > .toc + p:empty + h3,
#content_views.markdown_views > .toc + p:empty + h4 {
margin-top: 0 !important;
}
前言
-
折腾了两天本文的环境,终于搞定了
-
我们前面在好几个项目和研究都使用到了这个强化学习常用的 PPO 算法,但是我们其实跳过了很多知识点和工程实现细节没有提及,包括不限于 PPO 的网络如何更新、PPO 训练的时候需要关注哪些参数,以及 PPO 的 loss 以及其余的部分
-
本文我们将使用一个简单的 2d 机器人激光雷达导航的例子,来讲述一下 PPO 的算法实现。
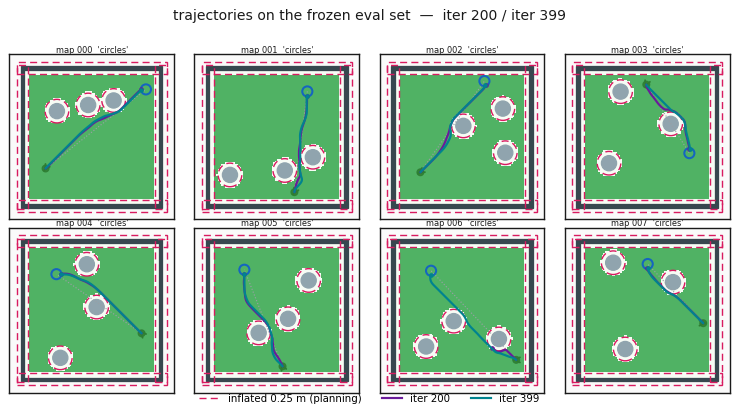
-
同时我们会训练时候的TensorBoard进行分析
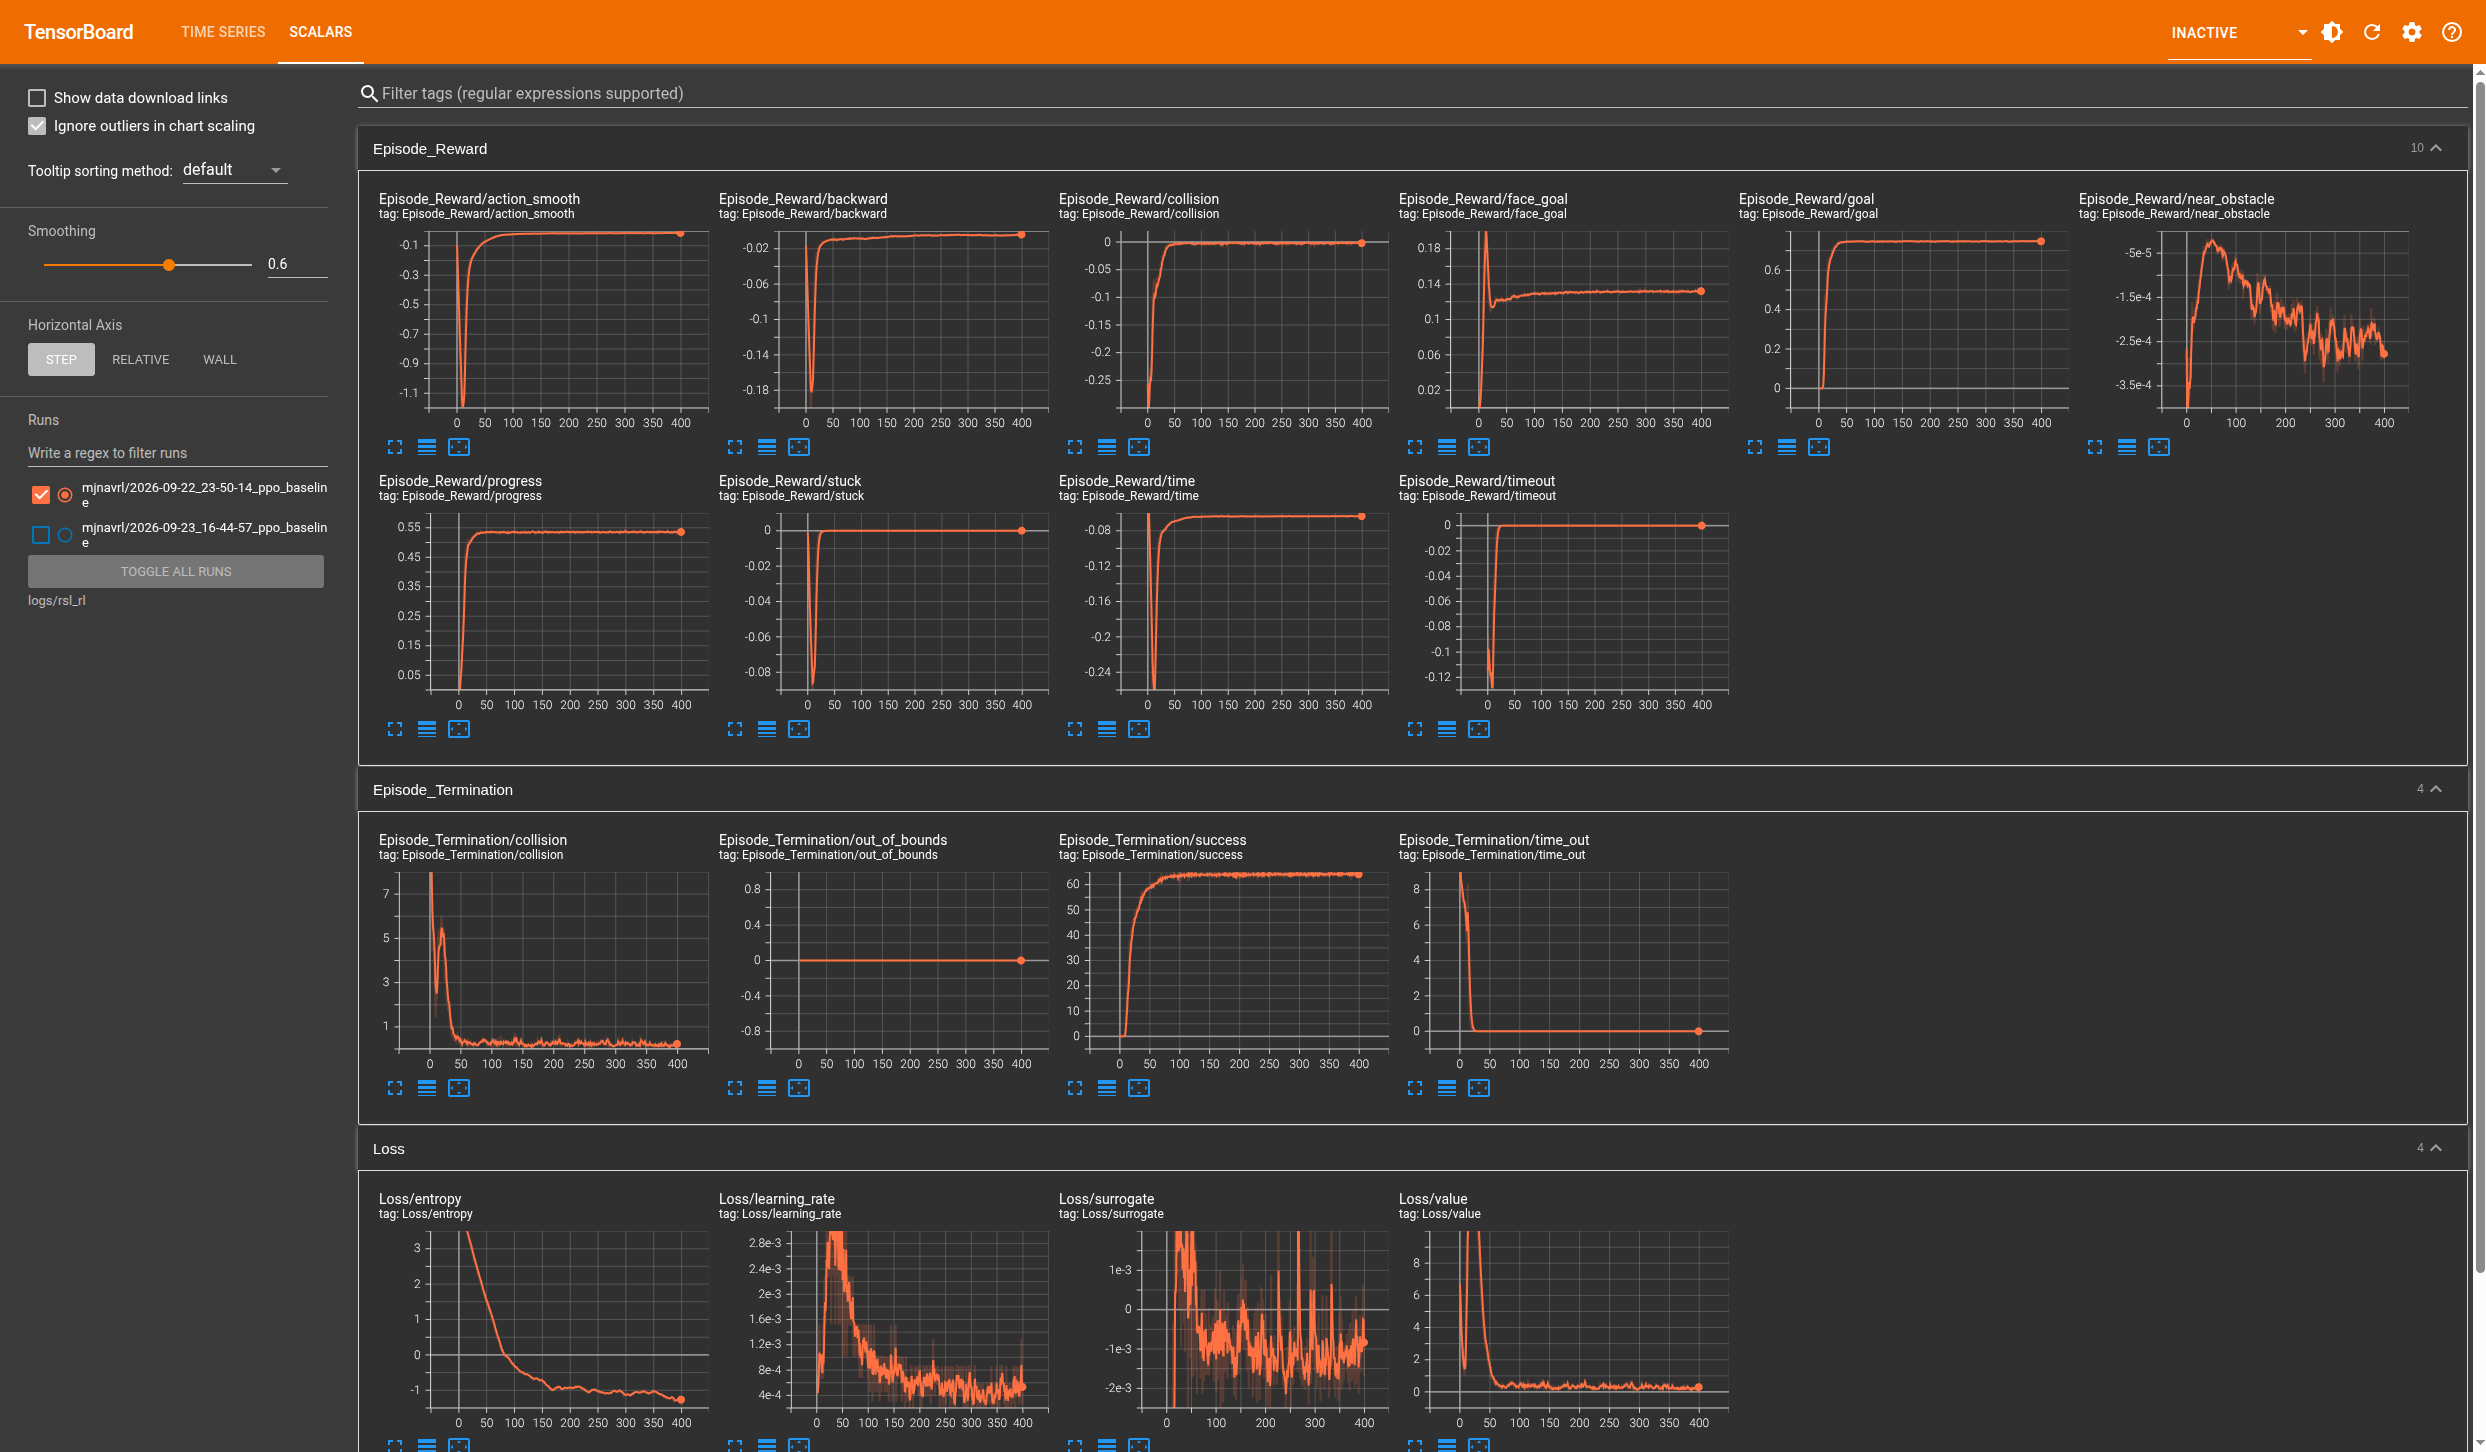
-
需要注意的是,本文默认读者对 PPO 有一个大致的了解和入门
- 【浅显易懂理解强化学习】(七):PPO,策略更新的安全阀
文章目录
-
- 前言
- 0 环境说明
-
-
- 0-1 任务说明
- 0-2 仿真器说明mujocolab
- 0-3 机器人说明
- 0-4 PPO 算法库使用
- 0-5 TensorBoard
-
- 1 PPO单轮step更新
-
-
- 1-1 介绍
- 1-2 环境 reset
- 1-3 step
- 1-4 观测
-
- 1-4-1 obs设计
- 1-4-2 观测构造
- 1-4-3 对接观测
- 1-4-4 网络侧的归一化
- 1-5 Actor
-
- 1-5-1 Actor输入
- 1-5-2 策略网络的特点
- 1-5-3 Actor网络结构的两种模式
- 1-5-4 GaussianDistribution模式下actor网络结构
- 1-5-5 Actor输出
- 1-5-6 action说明
- 1-6 Critic
-
- 1-6-1 Critic输入
- 1-6-2 价值网络的特点
- 1-6-3 critic网络结构
- 1-6-4 非对称AC
- 1-6-5 critic网络输出
- 1-7 环境执行与奖励计算
-
- 1-7-1 环境执行
- 1-7-2 奖励函数的设计
- 1-7-3 rewards注册
- 1-7-4 各项rewards计算
- 1-7-5 dones
- 1-7-6 process_env_step
- 1-8 小节
-
- 2 rollout收集与并行训练
-
-
- 2-1 rollout收集
- 2-2 并行训练与向量化环境(Vectorized Environment)
-
- 2-2-1 介绍
- 2-2-2 向量化环境(Vectorized Environment)
- 2-2-3 实现
- 2-2-4 整体计算
- 2-3 return
-
- 2-3-1 returns介绍
- 2-3-2 Return 与 Value 的关系
- 2-3-3 Return 与 Advantage
- 2-3-4 PPO 中的 Return
- 2-3-5 TD Error 和 GAE(Generalized Advantage Estimation)
- 2-3-6 bootstrap(自举)
- 2-3-7
V
(
s
t
)
V(s_t)
V(st)计算 - 2-3-8 合成
- 2-3-9 Advantage 标准化
- 2-3-10 小节
- 2-4 Min-batch结构
- 2-4-1 整体一览
- 2-4-2 训练结构
- 2-4-3 RolloutStorage
- 2-5 Loss计算
-
- 2-5-1 重新计算网络的输出
- 2-5-2 Actor:Surrogate Loss
- 2-5-3 Critic:Value Loss
- 2-5-4 Entropy Loss(熵损失)
- 2-5-5 Symmetry loss
- 2-5-6 Loss合并
- 2-6 Adaptive Learning Rate(自适应学习率)机制
-
- 2-6-1 总览
- 2-6-2 计算 KL 散度
- 2-6-3 对 Mini-batch 求平均
- 2-6-4 自适应学习率机制
- 2-7 反向传播、迭代与Gradient Clipping
- 2-8 PPO参数表
- 2-9 完整 PPO 数据流
- 2-10 外层训练循环
-
- 3 训练与结果分析
-
-
- 3-1 介绍
- 3-2 训练入口与 TensorBoard
-
- 3-2-1 分小节说明
- 3-2-2 训练进度
- 3-2-3 分项奖励
- 3-2-4 终止原因
- 3-2-5 损失与学习率
- 3-2-6 策略分布
- 3-2-7 吞吐与耗时
- 3-2-8 实时进度
- 3-3 PPO训练结果
-
- 3-3-1 说明
- 3-3-2 pt内容
- 3-3-3 如何使用
- 3-4 PPO轨迹复现
-
- 总结
0 环境说明
0-1 任务说明
- 在一个未知地图的房间内,随机刷新大小不同的障碍物,无运动学约束的机器人利用激光雷达传感器进行已知相对位置的目标点的导航算法实现
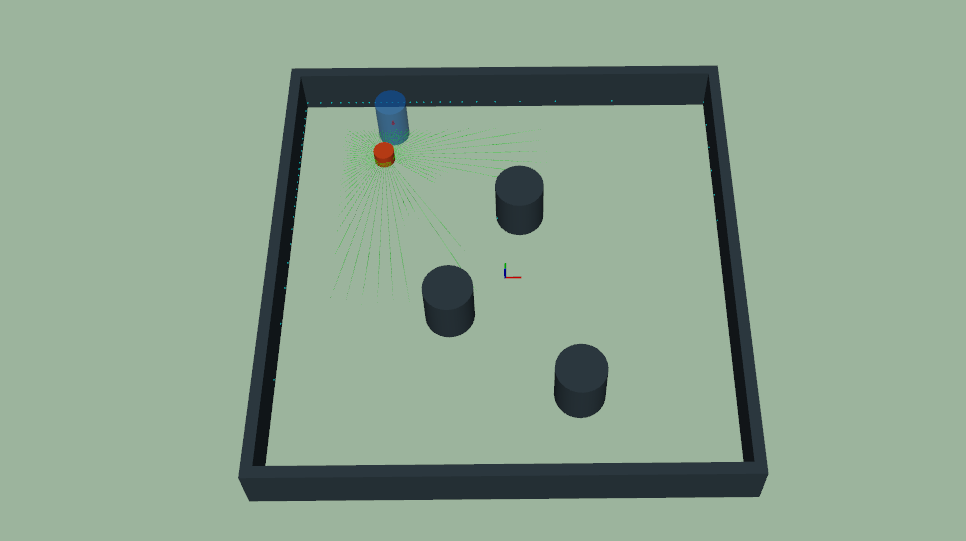
0-2 仿真器说明mujocolab
- mjlab(MuJoCo Warp)是一个基于 MuJoCo 与 NVIDIA Warp 的 GPU 并行机器人学习框架,版本 1.6.0,对外提供与 Isaac Lab 一致的 manager-based 编程接口
说人话:MuJoCo 原本是跑在 CPU 上的物理引擎,Warp 把它的求解器编译成 CUDA 内核,于是几千个环境能在显存里同时前进一步,而不必开几千个进程。
- 我们使用 mujocolab 作为仿真器,将机器人的移动、激光雷达的计算,以及碰撞的计算全部都挪移到 GPU 上
0-3 机器人说明
- 为了简化教学,我们初步不考虑为机器人加入运动学约束,故我们在 mujocolab 中搭建 3-dof 的 joint 用来表征机器人
- 三个关节分别是沿 x 的滑动、沿 y 的滑动与绕 z 的转动,对应平面内两个平动自由度与一个转动自由度
<body name="base" pos="0 0 0">
<!– 平面链。关节不设限位:房间边界由墙负责,不是由关节负责 –>
<joint name="jx" type="slide" axis="1 0 0" limited="false"/>
<joint name="jy" type="slide" axis="0 1 0" limited="false"/>
<joint name="jz" type="hinge" axis="0 0 1" limited="false"/>
<!– body 原点落在地板平面上,圆柱抬到半高,于是 qpos[0..1] 直接就是世界平面坐标 –>
<geom name="shell" type="cylinder" pos="0 0 0.15" size="0.20 0.15" mass="1.0"
contype="1" conaffinity="0"/>
</body>
- 同时为了后续扩展 sim2real,我们的网络定义 action 为
a
t
=
[
v
x
,
v
y
,
ω
]
a_t=[v_x,v_y,\\omega]
at=[vx,vy,ω],并使用 mujocolab 的速度伺服控制器控制机器人移动- 三个执行器都是 velocity 类型,kv 是伺服增益,ctrlrange 是速度指令的物理量上限
- 需要注意的是 forcerange 不能省:速度执行器若力不受限就是一台理想伺服,它用无穷大的力维持指令速度,于是能顶着墙穿过去,碰撞也就不是真的失败了
<actuator>
<!– 线速度:kv = 100,力上限 200 N = 质量 1.0 kg × 最大加速度 200 m/s^2 –>
<velocity name="vx" joint="jx" kv="100" ctrlrange="-1.5 1.5" forcerange="-200 200"/>
<velocity name="vy" joint="jy" kv="100" ctrlrange="-1.5 1.5" forcerange="-200 200"/>
<!– 偏航:kv 与力矩上限由"时间常数与线速度一致"反解,不是拍出来的数 –>
<velocity name="wz" joint="jz" kv="2" ctrlrange="-2 2" forcerange="-20 20"/>
</actuator>
0-4 PPO 算法库使用
- 本文使用 rsl_rl 作为 PPO 算法库
- rsl_rl 是 ETH Zurich 机器人系统实验室维护的轻量强化学习库,主打机器人研究的快速原型,原生支持多 GPU;本工程锁定的是 5.4.2
说人话:它把 PPO、Rollout 存储、向量化环境接口这些训练必需件做成了几百行的可读实现,换算法不用动引擎,换引擎也不用动算法。
- 相关的代码解读:
- 【宇树机器人强化学习】(一):PPO算法的python实现与解析
- 【宇树机器人强化学习】(二):ActorCritic网络和ActorCriticRecurrent网络的python实现与解析
- 【宇树机器人强化学习】(三):OnPolicyRunner和VecEnv以及RolloutStorage的python实现与解析
0-5 TensorBoard
- 本文所使用的 PPO 训练过程中的曲线绘制使用 TensorBoard
- TensorBoard 是 TensorFlow 生态的可视化工具,通过写事件文件记录标量、直方图与图像,训练进程与查看界面相互独立
- 本工程的 logger: tensorboard 会把三条 loss、学习率、动作标准差与分项奖励写进 logs/rsl_rl/<experiment_name>/<时间戳>_<run_name>
1 PPO单轮step更新
众所周知,PPO 训练时候,先与环境交互连续执行 N 个 step 后,收集 rollout(obs、action、reward、done、value、log_prob),然后才计算 GAE 合成 advantage 与 return,紧接着才进行 PPO 更新,mini-batch 计算 actor loss、critic loss,计算 entropy 合成总 loss,最后反复采样循环
1-1 介绍
- 本节我们来介绍,PPO 在单轮 step 中如何收集 obs、action、reward、done、value、log_prob
1-2 环境 reset
- 在每个 step 正式开始前,我们需要对环境进行初始化,初始化包含:
- 场景复位:重建本回合的地图,包括墙体与障碍物的几何与碰撞属性
- 机器人摆放:把本体放回新回合的起点位置与朝向
- 运行期状态清零:回合内的位置窗口、上一帧动作、终止原因等
- 这里有一个容易踩的地方:rsl_rl 的 learn() 不调用 reset
- 复位发生在向量化环境包装器的构造期,mjlab 那一侧把这件事写在了注释里:
def __init__(self, env, clip_actions=None):
self.env = env
# …
self.env.reset() # Reset at the start since rsl_rl does not call reset.
- 于是训练开始时环境是复位过的,之后每一回合的复位由 mjlab 的 step() 内部完成,这一步称为自动复位(auto-reset)
- 自动复位的代价要说清楚:终止那一帧的观测在被调用方读到之前,就已经被换成了下一回合的起点
- 所以评测时必须关掉它(auto_reset=False),否则终点位置与终止原因都拿不到
- 另外 learn() 支持一个参数 init_at_random_ep_len,开起来会把各环境的回合长度随机打散
if init_at_random_ep_len:
self.env.episode_length_buf = torch.randint_like(
self.env.episode_length_buf, high=int(self.env.max_episode_length)
)
- 不这么做的话,4096 个环境会在同一个 step 同时超时,一整批数据只反映"磨蹭到最后"这一种行为
1-3 step
- 在每个 step 环境初始化归位以后,我们就可以进行每 step 的收集 obs、action、reward、done、value、log_prob
- /rsl_rl/rsl_rl/runners/on_policy_runner.py的learn函数中,我们可以看到每个环境step的部分
for _ in range(self.cfg["num_steps_per_env"]):
# Sample actions
actions = self.alg.act(obs)
# Step the environment
obs, rewards, dones, extras = self.env.step(actions.to(self.env.device))
# Check for NaN values from the environment
if self.cfg.get("check_for_nan", True):
check_nan(obs, rewards, dones)
# Move to device
obs, rewards, dones = (obs.to(self.device), rewards.to(self.device), dones.to(self.device))
# Process the step
self.alg.process_env_step(obs, rewards, dones, extras)
# Extract intrinsic rewards if RND is used (only for logging)
intrinsic_rewards = self.alg.intrinsic_rewards if self.cfg["algorithm"]["rnd_cfg"] else None
# Book keeping
self.logger.process_env_step(rewards, dones, extras, intrinsic_rewards)
1-4 观测
- 在初始化环境以后,我们就可以执行这个动作,随后我们就可以进行对环境的观测进行获取
- 对应上面learn函数的观测获取当前状态对应的初始观测。
obs = self.env.get_observations().to(self.device)
1-4-1 obs设计
- 观测层的代码在 src/mjnavrl/obs,分三块:输入上下文、项注册表、装配器
- 关键设计是每一项在注册时就声明自己的来源,只有两类
- DEPLOYABLE:策略在真机上真的拿得到(雷达读数、自身速度、目标方位)
- SIM_ONLY:只有仿真知道真值(真实净空、无噪声扫描、物理接触状态)
- 这不是贴标签,而是函数签名不同:DEPLOYABLE 的函数只收 ctx,SIM_ONLY 的必须收 (ctx, truth)
- 加一项观测就是加一个带装饰器的函数:
@_register("lidar", DEPLOYABLE, lambda _p, d: d.num_beams)
def _lidar(ctx: ObsContext) –> np.ndarray:
"""归一化雷达扫描 (N, B),落在 [0, 1]。"""
return ctx.scan.normalized()
@_register("goal_polar", DEPLOYABLE, const(3))
def _goal_polar(ctx: ObsContext) –> np.ndarray:
"""(N, 3) = [d_g, sin θ_g, cos θ_g]:目标距离与本体系方位。"""
return np.stack(
[ctx.goal_dist_scaled, np.sin(ctx.goal_bearing), np.cos(ctx.goal_bearing)], axis=1
)
- 注册时的第三个参数是这一项的宽度,它是声明式的:不构造假数据也能算出组宽度,于是 PPO 的网络可以在第一个 step 之前就建出来
- 还有一条约定:每项自己负责把自己弄到 O(1),上层不做统一归一化——不同项的量纲差着两个数量级,统一处理必然有一半是错的
1-4-2 观测构造
- 我们定义观测为 78 维向量,由激光、目标特征与速度三段拼接:
-
L
t
(
i
)
L_t^{(i)}
Lt(i) 是第i
i
i 束激光的归一化距离,未命中时取 1; -
d
~
g
\\tilde{d}_g
d~g 是归一化的目标距离; -
θ
g
\\theta_g
θg 是目标相对机身朝向的夹角; -
v
~
t
\\tilde{v}_t
v~t 是归一化线速度;
-
o
t
=
[
L
t
(
1
)
,
…
,
L
t
(
72
)
,
d
~
g
,
sin
θ
g
,
cos
θ
g
,
v
~
t
]
∈
R
78
o_t = \\left[\\ L_t^{(1)}, \\dots, L_t^{(72)},\\ \\tilde{d}_g,\\ \\sin\\theta_g,\\ \\cos\\theta_g,\\ \\tilde{v}_t\\ \\right] \\in \\mathbb{R}^{78}
ot=[ Lt(1),…,Lt(72), d~g, sinθg, cosθg, v~t ]∈R78
- 按本工程的配置,各段宽度为:激光 72 维、目标 3 维、本体系线速度 2 维、角速度 1 维,合计 78 维
- 需要注意的是:
- 归一化是为了防止不同量纲对模型的训练产生误解
- 目标角度的设置为sin和cos是为了防止数值角度在面向目标点180左右的时候发生跳变
- 代码如下,即 src/mjnavrl/obs/terms.py 中注册的另外三项
@_register("vel_body", DEPLOYABLE, const(2))
def _vel_body(ctx: ObsContext) –> np.ndarray:
"""(N, 2) 本体系速度 (前向, 左向),除以 v_max。"""
return ctx.vel_body / ctx.v_max
@_register("omega", DEPLOYABLE, const(1))
def _omega(ctx: ObsContext) –> np.ndarray:
"""(N, 1) 角速度,除以 omega_max。"""
return (ctx.omega / ctx.omega_max).reshape(–1, 1)
@_register("action_prev", DEPLOYABLE, lambda _p, d: d.action_dim)
def _action_prev(ctx: ObsContext) –> np.ndarray:
"""(N, A) 上一帧动作。本工程默认关闭这一项。"""
return ctx.action_prev
- 装配由 src/mjnavrl/obs/builder.py 完成,核心是一句按来源过滤:注册表里所有 DEPLOYABLE 的项构成 policy 组,所有 SIM_ONLY 的项构成 privileged 组
def _build_group(self, name: str, prov: str, params_for) –> GroupSpec:
available = [t for t in TERMS.values() if t.provenance == prov]
resolved = []
for term in available: # TERMS 的插入顺序 = 输出顺序
params = dict(term.params)
params.update(params_for.get(term.name, {}))
if not params.pop("enabled", True): # enabled 由本层消费,不往下传
continue
resolved.append(ResolvedTerm(name=term.name, provenance=prov,
dim=int(term.dim(params, self.dims)), fn=term.fn, params=params))
return GroupSpec(name=name, provenance=prov, terms=tuple(resolved),
dim=sum(t.dim for t in resolved))
- 这样一来 YAML 只能改参数、开关单项,不能决定某一项进哪个组,来源始终由注册表说了算
- 每步产出还要对着声明校验一次形状:不校验的话,某一项悄悄多一列会变成 PPO 反向传播时一个与观测毫无关系的矩阵维度错误,或者更糟——广播成功而静默算错
1-4-3 对接观测
- 装配结果是 numpy 数组,接进 mjlab 的观测管理器只需要一层薄壳
def _obs_term(env: "NavEnv", group: str) –> torch.Tensor:
return env.nav_runtime.obs_group(group)
- 然后在环境配置里把它注册成每个观测组的唯一一项
observations[group] = ObservationGroupCfg(
terms={OBS_TERM: ObservationTermCfg(func=_obs_term, params={"group": group})},
history_length=obs.history_length if obs.history_length > 1 else None,
nan_policy="sanitize",
)
- 这里有一个必须注意的时序:ObservationManager 在构造期就会调用 func(env, **params) 来推断项的形状,那时还没有任何一帧数据
- 所以 obs_group 在没数据时要返回零张量,而不是抛异常,否则环境在第一个 step 之前就建不起来
- 随后我们对接rsl_rl的self.env.get_observations(),回到一开始的
obs = self.env.get_observations().to(self.device)
1-4-4 网络侧的归一化
- 到这里观测的量纲已经统一到 O(1) 了,但 PPO 里还有第二层归一化,它不靠人设计,而是从数据里统计出来
- 两层的分工是这样的:
- 1-4-2 那一层是人为定的尺度:距离除以量程、速度除以 v_max,分母有物理含义,同一个读数在任何时刻的含义都一样
- 这一层是统计尺度:把输入的实际分布对齐到零均值、单位标准差附近。因为即使每项都在 O(1) 量级,它们的均值与方差仍会随策略漂移(雷达读数的均值随房间开阔程度变),而输入层的权重是按当前分布学出来的
- rsl_rl 里这件事由 EmpiricalNormalization 承担,本工程 actor.obs_normalization 与 critic.obs_normalization 都开着
- 统计量不是离线采一批数据算出来的,而是每步观测顺手更新一次,用的是递推的在线均值方差
def update(self, x):
if not self.training:
return
count_x = x.shape[0]
self.count += count_x
rate = count_x / self.count # 本批条数 / 累计条数:越往后改得越少
var_x = torch.var(x, dim=0, unbiased=False, keepdim=True)
mean_x = torch.mean(x, dim=0, keepdim=True)
delta_mean = mean_x – self._mean
self._mean += rate * delta_mean
self._var += rate * (var_x – self._var + delta_mean * (mean_x – self._mean))
self._std = torch.sqrt(self._var)
def forward(self, x):
return (x – self._mean) / (self._std + self.eps)
- 三个细节值得看一眼:
- rate 是一个逐步收缩的权重:跑满一个 rollout(131072 条)之后它是万分之几,所以开局几步统计量动得快,之后基本冻结
- unbiased=False:这里要的是这批数据自己的方差,除以
N
N
N 而不是N
−
1
N-1
N−1 - eps 默认 1e-2,防止某一维方差接近 0 时除爆,它同时也决定了一维最多能被放大到什么程度
- 更新的调用点在 1-7-6 的 process_env_step 里,与梯度更新用同一批数据,但走的是完全不同的两条路:一条改统计量,一条改权重
- 两件必须记住的工程后果:
- 统计量是模块自带的状态(buffer),不是超参,会随 checkpoint 一起存取。推理时喂进去的观测必须用训练时那一份统计量,不能在部署侧重新统计,3-3-3 手写的那个 ObsNormalizer 装的正是这三个 buffer
- actor 与 critic 各有一份自己的归一化器,各统计各的那一组观测。本工程这一版关掉了特权观测,两边吃的是同一组 78 维,两份统计量实际上趋同;一旦按 1-6-4 打开非对称 AC,两边就各统计各的,互相喂不会报错,但价值估计会偏
- 一个自检点:打开 pt 看 obs_normalizer._mean,如果还是全 0、_var 还是全 1,说明一次都没更新过,策略等于在盲训。观测没接通时最先露出来的就是这里
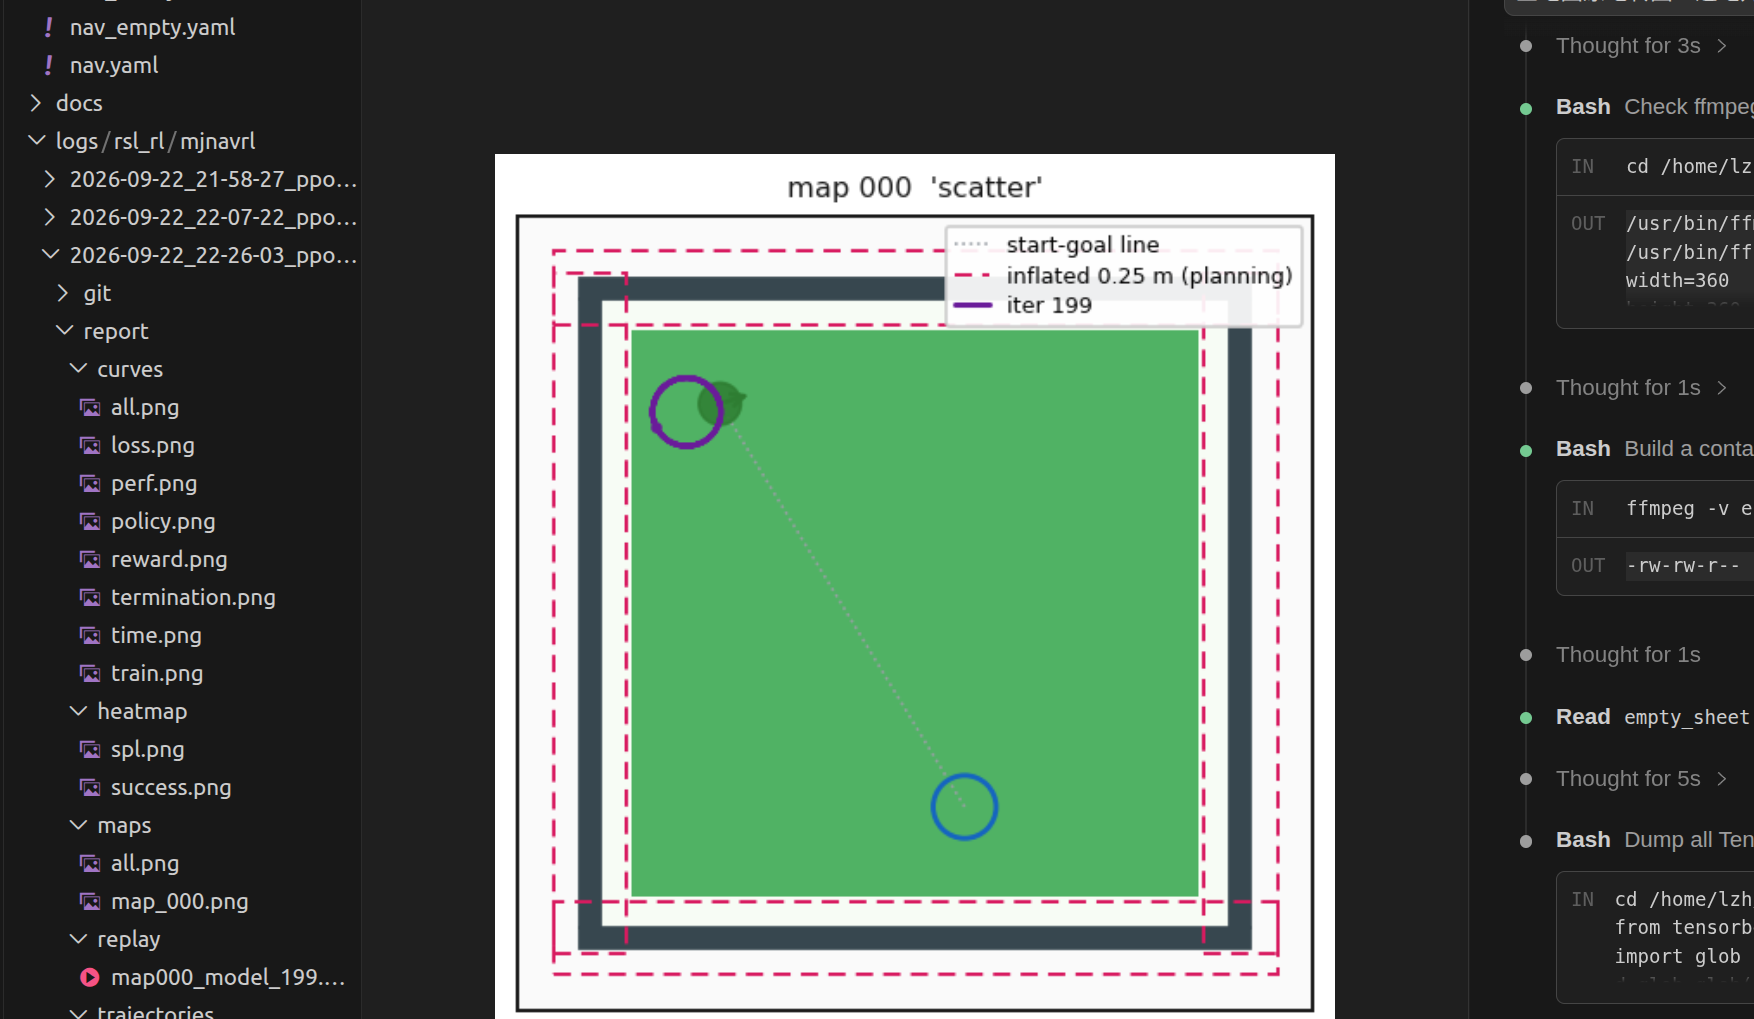
- 贴一张这两天在维修环境遇到的空环境PPO训练不收敛纯转圈,观测没输入绷绷不住了
1-5 Actor
- actor 作为 actor-critic 网络的一部分,主要作用是输入观测获取动作,核心是 policy-based 的策略网络
1-5-1 Actor输入
- 获取到观测以后,我们直接将观测作为 actor 网络的输入
- /rsl_rl/rsl_rl/runners/on_policy_runner.py
actions = self.alg.act(obs)
- 我们把这个函数展开:
def act(self, obs: TensorDict) –> torch.Tensor:
"""Sample actions and store transition data."""
# Record the hidden states for recurrent policies
self.transition.hidden_states = (self.actor.get_hidden_state(), self.critic.get_hidden_state())
# Compute the actions and values
self.transition.actions = self.actor(obs, stochastic_output=True).detach()
self.transition.values = self.critic(obs).detach()
self.transition.actions_log_prob = self.actor.get_output_log_prob(self.transition.actions).detach() # type: ignore
self.transition.distribution_params = tuple(p.detach() for p in self.actor.output_distribution_params)
# Record observations before env.step()
self.transition.observations = obs
return self.transition.actions # type: ignore
- 这一小节我们着重看两个使用到actor网络的地方,分别是
- 计算动作
- 计算动作的log probability
self.transition.actions = self.actor(obs, stochastic_output=True).detach()
self.transition.actions_log_prob = self.actor.get_output_log_prob(self.transition.actions).detach() # type: ignore
- 拓展:detach表示当前为数据采集,不参与梯度计算
1-5-2 策略网络的特点
- 这里我们需要回顾一下策略网络的特点。对于连续动作空间,我们通常假设策略网络输出的动作服从高斯分布,即
a
t
∼
N
(
μ
θ
(
s
t
)
,
σ
θ
2
(
s
t
)
)
\\boxed{ a_t \\sim \\mathcal{N}\\left(\\mu_\\theta(s_t),\\sigma_\\theta^2(s_t)\\right) }
at∼N(μθ(st),σθ2(st)) - 其中
-
s
t
s_t
st 表示当前状态 -
a
t
a_t
at 表示策略网络在状态s
t
s_t
st 下输出的动作, -
μ
θ
(
s
t
)
\\mu_\\theta(s_t)
μθ(st)和σ
θ
(
s
t
)
\\sigma_\\theta(s_t)
σθ(st) 分别表示策略网络输出的动作分布的均值和标准差 -
θ
\\theta
θ 表示策略网络的参数。
-
- 对于多维连续动作,可以表示为
a
t
∼
N
(
μ
θ
(
s
t
)
,
diag
(
σ
θ
2
)
)
\\boxed{ \\boldsymbol{a}_t \\sim \\mathcal{N} \\left( \\boldsymbol{\\mu}_\\theta(s_t), \\operatorname{diag}(\\boldsymbol{\\sigma}_\\theta^2) \\right) }
at∼N(μθ(st),diag(σθ2)) - 因此,策略网络并不是直接确定性地输出一个动作,而是首先根据当前观测
s
t
s_t
st得到动作分布的参数,再从该分布中采样得到最终动作:s
t
→
(
μ
θ
,
σ
θ
)
→
N
(
μ
θ
,
σ
θ
2
)
→
a
t
s_t \\rightarrow \\left(\\boldsymbol{\\mu}_\\theta,\\boldsymbol{\\sigma}_\\theta\\right) \\rightarrow \\mathcal{N}(\\boldsymbol{\\mu}_\\theta,\\boldsymbol{\\sigma}_\\theta^2) \\rightarrow \\boldsymbol{a}_t
st→(μθ,σθ)→N(μθ,σθ2)→at
1-5-3 Actor网络结构的两种模式
- 回顾完策略网络的特点,我们需要谈谈rsl_rl两种关于actor网络的实现,其核心区别就是
σ
θ
(
s
t
)
\\sigma_\\theta(s_t)
σθ(st)(即策略网络输出的动作分布的标准差)是由固定参数生成还是网络生成的- GaussianDistribution
- HeteroscedasticGaussianDistribution
- 它们的区别是
| MLP 输出 | 3 维 = mean | [2, 3] = 6 个数,unbind(dim=-2) 切成 mean | std |
| std 从哪来 | 独立的 nn.Parameter,3 个标量 | 网络的第二片输出,随状态变 |
| input_dim | output_dim = 3 | [2, output_dim] = [2, 3] |
- **PPO 原论文也是A——Schulman 2017 明确用的是 “a separate set of parameters for the log standard deviation”,而不是让网络输出它。理由:
- 参数少(3 个 vs 一整片输出头)
- 探索强度全局统一,训练初期稳。B 有个典型失效模式是某个状态的 σ 塌到 0,那片状态就再也采不出动作了
- 导出/部署简单:deterministic_output 在 A 里直接返回 MLP 输出(因为输出本身就是 mean),B 里要先切 mlp_output[…, 0, :]
1-5-4 GaussianDistribution模式下actor网络结构
- 因此GaussianDistribution模式actor的输出就为只有一个三个维度的mean,std的生成为固定参数
- 这里我们设计了一个对接,把 dict 转成 RslRlModelCfg,将我们的 YAML 配置文件转为 mlp
actor:
class_name: MLPModel
hidden_dims: [256, 256]
activation: elu
obs_normalization: true
distribution_cfg:
class_name: GaussianDistribution
init_std: 1.0
std_type: scalar
- 实际上解析完以后,actor 大致长这个样子
actor_state_dict
obs_normalizer._mean/_var/_std (1, 78) # 输入 78 维(policy 组)
mlp.0.weight (256, 78) mlp.0.bias (256,) # Linear(78 -> 256)
mlp.2.weight (256,256) mlp.2.bias (256,) # Linear(256 -> 256) (mlp.1 = ELU)
mlp.4.weight (3, 256) mlp.4.bias (3,) # Linear(256 -> 3) (mlp.3 = ELU)
distribution.std_param (3,)
- 其中 distribution.std_param (3,) 就是 GaussianDistribution 模式下设定 std 为独立参数
1-5-5 Actor输出
- 因此,有了mean和std,我们就可以从动作分布中采集得到动作
s
t
→
(
μ
θ
,
σ
θ
)
→
N
(
μ
θ
,
σ
θ
2
)
→
a
t
s_t \\rightarrow \\left(\\boldsymbol{\\mu}_\\theta,\\boldsymbol{\\sigma}_\\theta\\right) \\rightarrow \\mathcal{N}(\\boldsymbol{\\mu}_\\theta,\\boldsymbol{\\sigma}_\\theta^2) \\rightarrow \\boldsymbol{a}_t
st→(μθ,σθ)→N(μθ,σθ2)→at
self.transition.actions = self.actor(obs, stochastic_output=True).detach()
- 这里展开核心的部分就是mlp的forward
def forward(
self,
obs: TensorDict,
masks: torch.Tensor | None = None,
hidden_state: HiddenState = None,
stochastic_output: bool = False,
) –> torch.Tensor:
"""Forward pass of the MLP model.
..note::
The `stochastic_output` flag only has an effect if the model has a distribution (i.e., ``distribution_cfg``
was provided) and defaults to ``False``, meaning that even stochastic models will return deterministic
outputs by default.
"""
# If observations are padded for recurrent training but the model is non-recurrent, unpad the observations
obs = unpad_trajectories(obs, masks) if masks is not None and not self.is_recurrent else obs
# Get MLP input latent
latent = self.get_latent(obs, masks, hidden_state)
# MLP forward pass
mlp_output = self.mlp(latent)
# If stochastic output is requested, update the distribution and sample from it, otherwise return MLP output
if self.distribution is not None:
if stochastic_output:
self.distribution.update(mlp_output)
return self.distribution.sample()
return self.distribution.deterministic_output(mlp_output)
return mlp_output
- 因为我们启用的是 GaussianDistribution 模式,也就是指定 stochastic_output,因此我们的返回是
if stochastic_output:
self.distribution.update(mlp_output)
return self.distribution.sample()
- 其中 update 就是利用本轮的 actor 网络输出的 mean,加上我们设定的参数 std 去构造标准正态分布
def update(self, mlp_output: torch.Tensor) –> None:
"""Update the Gaussian distribution from MLP output."""
mean = mlp_output
if self.std_type == "scalar":
std = self.std_param.clamp(self.std_range[0], self.std_range[1])
elif self.std_type == "log":
log_std = self.log_std_param.clamp(self.log_std_range[0], self.log_std_range[1])
std = torch.exp(log_std)
self._distribution = Normal(mean, std)
- sample展开就是torch.distributions.Normal.sample()
a = loc + scale * torch.randn_like(loc) # (4096, 3)
- 也就是从动作分布中随机采样
self.transition.actions_log_prob = self.actor.get_output_log_prob(self.transition.actions).detach() # type: ignore
1-5-6 action说明
- 需要说明的是,这里采样的动作是一个三维度无量纲的向量,对应0-3的机器人动作设计
| a[0] | jx(x 向 slide) | 机体系前向速度 | v_max = 1.5 | +1 对应 1.5 m/s 前进 |
| a[1] | jy(y 向 slide) | 机体系左向速度 | v_max = 1.5 | +1 对应 1.5 m/s 左移 |
| a[2] | jz(z 轴 hinge) | 偏航角速度 | omega_max = 2.0 | +1 对应 2.0 rad/s 逆时针 |
- 最终输出的action就对应到开头的这个地方
actions = self.alg.act(obs)
1-6 Critic
1-6-1 Critic输入
- 同样的在actor输入观测obs的同时,critic也输入观测信息
def act(self, obs: TensorDict) –> torch.Tensor:
"""Sample actions and store transition data."""
# Record the hidden states for recurrent policies
self.transition.hidden_states = (self.actor.get_hidden_state(), self.critic.get_hidden_state())
# Compute the actions and values
self.transition.actions = self.actor(obs, stochastic_output=True).detach()
self.transition.values = self.critic(obs).detach()
self.transition.actions_log_prob = self.actor.get_output_log_prob(self.transition.actions).detach() # type: ignore
self.transition.distribution_params = tuple(p.detach() for p in self.actor.output_distribution_params)
# Record observations before env.step()
self.transition.observations = obs
return self.transition.actions # type: ignore
- 核心的部分是
self.transition.values = self.critic(obs).detach()
1-6-2 价值网络的特点
- critic是价值网络,他的核心是一个价值函数近似器
- 我们定义状态价值函数:
V
π
(
s
t
)
=
E
π
[
∑
k
=
0
∞
γ
k
r
t
+
k
∣
s
t
]
\\boxed{ V^\\pi(s_t) = \\mathbb{E}_\\pi \\left[ \\sum_{k=0}^{\\infty} \\gamma^k r_{t+k} \\mid s_t \\right] }
Vπ(st)=Eπ[k=0∑∞γkrt+k∣st]它表示:
如果当前处于状态
s
t
s_t
st,之后继续按照当前策略
π
\\pi
π 执行,那么从当前时刻开始预计能够获得多少累计回报。
- 因此 critic 不参与动作估计,而是判断当前状态有多好
1-6-3 critic网络结构
- critic网络和actor公用一个类,同样根据参数来配置生成
critic:
class_name: MLPModel
hidden_dims: [256, 256]
activation: elu
obs_normalization: true
- 一个容易忽略的约束是 critic 不能有 distribution_cfg
- 因为 PPO 只拿 critic 出值,而 forward() 在 stochastic_output=False 时返回的正是 MLP 的裸输出,给它配分布完全等价于没有
- 多出来的只是一份没人用的参数,还让读配置的人以为 critic 是随机的
- 展开大概就是这样的:
critic_state_dict
obs_normalizer._mean/_var/_std (1, 78)
mlp.0.weight (256, 78) mlp.0.bias (256,) # Linear(78 -> 256)
mlp.2.weight (256, 256) mlp.2.bias (256,) # Linear(256 -> 256)
mlp.4.weight (1, 256) mlp.4.bias (1,) # Linear(256 -> 1) = V(s)
1-6-4 非对称AC
- 这里需要提一个有意思的东西,默认情况下的actor-critic的输入都是一致的obs,对应本文的观测就都是78维的输入,但是,这里要介绍一种方法,通过显式构造不对称的观测输入(一般都是 critic 获得更多特权观测)
- 非对称AC 指的是 actor 与 critic 输入不同的观测:actor 仍只看可部署量,critic 额外拿到仿真特权量
说人话:critic 只在训练时存在,它唯一的任务是把价值估准;让它作弊不影响策略能不能上真机,因为部署时导出的是 actor。
- 其中特权观测指的是仿真里才有真值的量,本工程一共注册了四项
- truth_clearance(1 维):到最近障碍的真实净空
- truth_scan_clean(72 维):无噪声扫描
- truth_contact(1 维):物理引擎接触表给出的接触标志
- truth_nearest_dir(2 维):指向最近障碍的单位向量,本体系
- 我们的代码也实现了该功能,privileged_enabled: true 就会变成非对称 actor-critic:critic 组变 [policy, privileged],它的 mlp.0.weight 第一维变宽,
def resolve_obs_groups(self, override=None):
"""默认从 privileged_enabled 推出来,不从 YAML 里另读一份。"""
if override is None:
critic = [self.policy_group]
if self.privileged_enabled:
critic.append(self.privileged_group)
return {"actor": [self.policy_group], "critic": critic}
return self._check(override)
- 具体到本工程,打开后 critic 的输入宽度从 78 变为 78 + 76 = 154
- 反过来,把特权组写进 actor 组会被直接拦下:这个错误的表现同样是训练曲线变得更好看,没有任何指标会报警,所以它必须是硬的
- 通常情况下,为critic引入更多的观测信息(如:真值净空、真实接触状态、无噪声扫描)可以为整体PPO训练提供更好的效果,后续我们会出一篇文章来讲解这部分
1-6-5 critic网络输出
- 回到网络输出,critic 的输出是一个标量,即 values,也就是状态价值函数
self.transition.values = self.critic(obs).detach()
1-7 环境执行与奖励计算
1-7-1 环境执行
- 我们回到最上层的函数
def learn(self, num_learning_iterations: int, init_at_random_ep_len: bool = False) –> None:
"""Run the learning loop for the specified number of iterations."""
# 省略部分代码
for _ in range(self.cfg["num_steps_per_env"]):
# Sample actions
actions = self.alg.act(obs)
# Step the environment
obs, rewards, dones, extras = self.env.step(actions.to(self.env.device))
# 省略代码
- 下一步就是将动作执行到环境获得下一步的观测,奖励,以及结束状态dones和其他信息
obs, rewards, dones, extras = self.env.step(actions.to(self.env.device))
- obs 的返回涉及环境的更新,和 PPO 算法无关,这里我们不多介绍,我们着重看 rewards 和 dones
1-7-2 奖励函数的设计
- rewards 的计算顾名思义,机器人通过与环境的交互,我们人为地制定标准去奖励或者惩罚机器人当前的行为,计算出来的 reward 后面会用于计算 PPO 的 loss,具体表现在 critic 计算 td error 的时候使用到 reward
- 需要注意的是,强化学习中,奖励函数的设计会很大程度影响到训练的结果,设置奖励函数本质上就是影响网络收敛到一个符合任务的地方
- 通常来说奖励函数需要配合观测进行设计,网络的输入就是观测,而网络的loss计算用到的是奖励函数计算出来的
- 同时我们可以考虑进行奖励塑形,即引入任务引导,但是过度的引导会导致训练的模型对于不同任务的泛化度下降,变成过拟合的糟糕结果
- 这里也提一个逆强化学习:不从手工设计出发,而是由专家轨迹反推奖励函数,也就是我们无需手动编写,这个后续我们会出几篇文章来说明
1-7-3 rewards注册
- 和之前那期【模仿学习+强化学习】BC+PPO:基于 A* 专家行为克隆下的无地图雷达导航探索 设计的奖励函数一样,我们涉及了特殊的奖励函数注册方式
rewards = {
name: RewardTermCfg(func=_reward_term, params={"name": name}, weight=1.0)
for name in cfg.reward.enabled_terms()
}
1-7-4 各项rewards计算
- 需要注意的是这里只是提供最基础的实现,后续可以根据自己对于环境和任务的理解进行奖励函数的编写与调参,核心的部分就是需要确保不同项之间不会自相违背,数量级是否正确
- 同时需要注意,各项reward的计算可能需要获取环境观测或者其他信息,需要进行包装,这里由于篇幅不进行展开
goal: {weight: 15.0} # bc-ppo success bonus 15;只在判定给 SUCCESS 那一步发
progress: {weight: 2.0} # bc-ppo coef 2.0;势能式 w·(d_{t−1} − d_t),望远镜求和
face_goal: {weight: 0.05, params: {motion_weighted: true}}
# bc-ppo coef 0.05;cosθ_g × |前向速度|/v_max,
# 站着不动拿不到分,所以刷不了
time: {weight: -0.02} # bc-ppo penalty 0.02;每步常数,逼它别磨蹭
near_obstacle: {weight: -0.08, params: {safe_dist: 0.25}}
# bc-ppo penalty 0.08;离障碍 < 0.35 m 按比例扣。
# 口径差:bc-ppo 的 0.35 从机身表面起算,本工程的
# 雷达读数从机身中心起算(差一个 robot.radius)
action_smooth: {weight: -0.02} # bc-ppo coef 0.02;‖a_t − a_{t−1}‖²,抑制抖动
backward: {weight: -0.05, params: {thresh: -0.05}}
# bc-ppo coef 0.05 / thresh -0.05;倒车惩罚。看的是
# 前向指令(动作本身就是机体系,第 0 维即前向)
stuck: {weight: -0.03, params: {window: 25, min_move: 0.30}}
# bc-ppo penalty 0.03;窗口两端净位移 < 0.30 m 就扣,
# 打断绕小圈。window 决定 env 里那块位置缓冲的宽度
collision: {weight: -12.0} # bc-ppo penalty 12;接触即失败终止,且**优先于到达**
timeout: {weight: -4.0} # bc-ppo penalty 4;超时截断那一步
- 表格的形式总结就是:
| progress |
2.0 ( d t − 1 − d t ) 2.0\\,(d_{t-1} – d_t) 2.0(dt−1−dt) |
coef=2.0 | 势函数差分前进奖励 |
| face_goal |
0.05 cos θ g ⋅ ∣ v t ∣ / v max 0.05\\cos\\theta_g \\cdot \\lvert v_t \\rvert / v_{\\max} 0.05cosθg⋅∣vt∣/vmax |
coef=0.05 | 朝向对齐,按速度加权 |
| time |
− 0.02 -0.02 −0.02 |
penalty=0.02 | 每步时间惩罚 |
| near_obstacle |
− 0.08 ⋅ clip ( 0.35 − d min 0.35 , 0 , 1 ) -0.08\\cdot\\text{clip}\\left(\\frac{0.35 – d_{\\min}}{0.35}, 0, 1\\right) −0.08⋅clip(0.350.35−dmin,0,1) |
safe_dist=0.35 | 贴障碍惩罚 |
| action_smooth |
− 0.02 ∥ a t − a t − 1 ∥ 2 -0.02\\lVert a_t – a_{t-1} \\rVert^2 −0.02∥at−at−1∥2 |
coef=0.02 | 抑制动作抖动 |
| backward |
− 0.05 ( − 0.05 − v ~ t ) -0.05\\,(-0.05 – \\tilde{v}_t) −0.05(−0.05−v~t) |
thresh=-0.05 | 倒车惩罚 |
| stuck |
− 0.03 -0.03 −0.03(窗口内位移不足时) |
window=25, min_move=0.30 | 打断原地打转 |
| collision |
− 12.0 -12.0 −12.0 |
penalty=12.0 | 碰撞终止惩罚 |
| success |
+ 15.0 +15.0 +15.0 |
bonus=15.0 | 到达奖励 |
| timeout |
− 4.0 -4.0 −4.0 |
penalty=4.0 | 超时惩罚 |
- 对应的代码实现,
@_register("goal")
def _goal(ctx: RewardContext) –> np.ndarray:
return _flag(ctx, "in_goal")
@_register("progress")
def _progress(ctx: RewardContext, *, gamma: float | None = None) –> np.ndarray:
d, prev = ctx.goal_dist, ctx.prev_goal_dist
out = prev – d
if gamma is not None:
out = out + (1.0 – float(gamma)) * d
return np.asarray(out, dtype=np.float64)
@_register("collision")
def _collision(ctx: RewardContext) –> np.ndarray:
return _flag(ctx, "contact")
@_register("time")
def _time(ctx: RewardContext) –> np.ndarray:
return np.ones(len(ctx.goal_dist), dtype=np.float64)
# ————————————————————————— #
# bc-ppo 那一套(移植过来的)
# ————————————————————————— #
@_register("face_goal")
def _face_goal(ctx: RewardContext, *, motion_weighted: bool = True) –> np.ndarray:
r = np.asarray(ctx.require("cos_goal_bearing"), dtype=np.float64)
if motion_weighted:
ratio = np.abs(ctx.require("v_forward")) / max(1e-6, float(ctx.v_max))
r = r * np.clip(ratio, 0.0, 1.0)
return r
@_register("near_obstacle")
def _near_obstacle(ctx: RewardContext, *, safe_dist: float = 0.35) –> np.ndarray:
d = np.asarray(ctx.require("min_scan"), dtype=np.float64)
safe = float(safe_dist)
ratio = (safe – d) / max(1e-6, safe)
return np.clip(ratio, 0.0, 1.0)
@_register("action_smooth")
def _action_smooth(ctx: RewardContext) –> np.ndarray:
d = np.asarray(ctx.require("action"), dtype=np.float64) – np.asarray(
ctx.require("action_prev"), dtype=np.float64
)
return np.einsum("ij,ij->i", d, d)
@_register("backward")
def _backward(ctx: RewardContext, *, thresh: float = –0.05) –> np.ndarray:
v = np.asarray(ctx.require("v_cmd_body"), dtype=np.float64)[:, 0]
return np.maximum(0.0, float(thresh) – v)
@_register("stuck", history="window", window=25, min_move=0.30)
def _stuck(ctx: RewardContext, *, window: int = 25, min_move: float = 0.30) –> np.ndarray:
w = int(window)
if w < 1:
raise ValueError(f"stuck 的 window 至少为 1,给的是 {w}。")
win = np.asarray(ctx.require("pos_window"), dtype=np.float64)
if win.shape[1] < w:
raise ValueError(
f"stuck 的 window={w},但上下文里的位置窗口只有 {win.shape[1]} 步。\\n"
f" NavState 必须按 RewardBuilder.pos_window 建(见 mjnavrl.env.mjnavrl_env),"
f"否则这一项要么永不触发、要么拿错窗口。"
)
step = np.asarray(ctx.require("step"))
span = np.linalg.norm(win[:, –1] – win[:, –w], axis=1)
return ((step >= w) & (span < float(min_move))).astype(np.float64)
@_register("timeout")
def _timeout(ctx: RewardContext) –> np.ndarray:
return ctx.require("timeout").astype(np.float64)
@_register("out_of_bounds")
def _out_of_bounds(ctx: RewardContext) –> np.ndarray:
return _flag(ctx, "out_of_bounds")
1-7-5 dones
- dones 是一个复合型判据,用于判断当前 step 是否结束
term_or_trunc = terminated | truncated
dones = term_or_trunc.to(dtype=torch.long)
- 其中:
| truncated | reset_time_outs | time_out(time_out=True 那一项) |
| terminated | reset_terminated | success | collision | out_of_bounds |
- 这里需要注意的一点就是,我们需要区别dones与 time_outs 的关系,这影响到后续我们计算 loss 的时候要如何处理
| dones | 决定要不要加
γ V ( s t + 1 ) \\gamma V(s_{t+1}) γV(st+1) |
| time_outs | 决定要不要补一段尾巴 |
1-7-6 process_env_step
- 至此一步的六个量都拿到了,它们会被作为同一个 transition存入 RolloutStorage
obs_t
action_t
reward_t
done_t
value_t
log_prob_t
old_distribution_params
- 尤其要强调:
value 和 log_prob 是在执行动作之前、使用旧策略计算得到的,因此它们会被保存下来,供后面的 GAE 和 PPO 新旧策略比较使用。
- 这是 PPO 区别于普通策略梯度的关键:策略更新之后,我们仍然要能回答"在这批数据上,新策略选到那些动作的概率比旧策略高了多少"
- 展开代码如下:
def process_env_step(self, obs, rewards, dones, extras) –> None:
# Update the normalizers
self.actor.update_normalization(obs)
self.critic.update_normalization(obs)
# Record the rewards and dones
# Note: We clone here because later on we bootstrap the rewards based on timeouts
self.transition.rewards = rewards.clone()
self.transition.dones = dones
# Bootstrapping on time outs
if "time_outs" in extras:
self.transition.rewards += self.gamma * torch.squeeze(
self.transition.values * extras["time_outs"].unsqueeze(1).to(self.device),
1,
)
# Record the transition
self.storage.add_transition(self.transition)
self.transition.clear()
self.actor.reset(dones)
self.critic.reset(dones)
- 几处需要说明:
- rewards.clone() 是必须的:下面要往奖励里加 bootstrap 项,不 clone 会改写环境那边传进来的张量
- update_normalization 用这一步的观测更新归一化统计量,它随 checkpoint 一起存取
- time_outs 那一支是截断与终止的区别所在,两个字段的判据见 1-7-5 的表格
- transition.clear() 把临时容器置空,下一次 act() 从头填
- actor.reset(dones) 对 MLP 是空操作,只有 RNN 才需要
- 走到这里,一步的数据就完整进了 RolloutStorage,循环回到 1-3 的 for 开头执行下一步
1-8 小节
- 回顾整个小节,在每一步中,我们分别往 actor 和 critic 输入观测,分别得到动作分布以及价值函数的值,然后我们使用在动作分布中采样的动作输入环境得到这一步的奖励 reward,以及是否结束标志位 dones,同时我们更新环境得到下一次的 obs,由此反复
for _ in range(self.cfg["num_steps_per_env"]):
# Sample actions
actions = self.alg.act(obs)
# Step the environment
obs, rewards, dones, extras = self.env.step(actions.to(self.env.device))
# Check for NaN values from the environment
if self.cfg.get("check_for_nan", True):
check_nan(obs, rewards, dones)
# Move to device
obs, rewards, dones = (obs.to(self.device), rewards.to(self.device), dones.to(self.device))
# Process the step
self.alg.process_env_step(obs, rewards, dones, extras)
# Extract intrinsic rewards if RND is used (only for logging)
intrinsic_rewards = self.alg.intrinsic_rewards if self.cfg["algorithm"]["rnd_cfg"] else None
# Book keeping
self.logger.process_env_step(rewards, dones, extras, intrinsic_rewards)
2 rollout收集与并行训练
2-1 rollout收集
- rollout指的是策略与环境连续交互若干步、把每一步的
(
o
t
,
a
t
,
r
t
,
d
t
,
V
t
,
log
π
θ
)
(o_t,a_t,r_t,d_t,V_t,\\log\\pi_\\theta)
(ot,at,rt,dt,Vt,logπθ) 存进缓冲区的一段采集过程
说人话:先把旧策略走过的这段路原样记下来,再拿这段路反复算账,算完才更新一次策略。
- 在 PPO 中,我们通过多次与环境交互,收集一定量的数据后(通常包括
[
o
b
s
,
a
c
t
i
o
n
,
r
e
w
a
r
d
,
d
o
n
e
,
v
a
l
u
e
,
l
o
g
_
p
r
o
b
]
[obs, action, reward, done, value, log\\_prob]
[obs,action,reward,done,value,log_prob]),进行反复训练 - 对应到代码中,我们就有了
# Rollout
with torch.inference_mode():
for _ in range(self.cfg["num_steps_per_env"]):
# Sample actions
actions = self.alg.act(obs)
# Step the environment
obs, rewards, dones, extras = self.env.step(actions.to(self.env.device))
# Check for NaN values from the environment
if self.cfg.get("check_for_nan", True):
check_nan(obs, rewards, dones)
# Move to device
obs, rewards, dones = (obs.to(self.device), rewards.to(self.device), dones.to(self.device))
# Process the step
self.alg.process_env_step(obs, rewards, dones, extras)
# Extract intrinsic rewards if RND is used (only for logging)
intrinsic_rewards = self.alg.intrinsic_rewards if self.cfg["algorithm"]["rnd_cfg"] else None
# Book keeping
self.logger.process_env_step(rewards, dones, extras, intrinsic_rewards)
stop = time.time()
collect_time = stop – start
start = stop
# Compute returns
self.alg.compute_returns(obs)
- 拓展:inference_mode表示Rollout 不需要梯度
2-2 并行训练与向量化环境(Vectorized Environment)
2-2-1 介绍
- 需要注意的是,为了加速 PPO 的训练过程,本项目配置了并行训练
- PPO 并行训练就是: 同时运行多个环境,每个环境采集 num_steps_per_env 个时间步,将所有环境的经验汇总成一个 Rollout Batch,再统一进行 PPO 更新。
2-2-2 向量化环境(Vectorized Environment)
- 为了支持并行训练,我们需要支持向量化环境(Vectorized Environment)
- 向量化环境(Vectorized Environment) 指的是把 N 份同构环境装进一个对象,一次 step 同时推进全部 N 份
- 它对外只暴露 get_observations() 与 step(actions) 两个接口,返回张量的首维都是 N
说人话:不是"循环调用 N 次单环境",而是"一次调用内部并行算 N 份",动作、观测、奖励、终止都是同形状的批量张量。
- 本工程这一层由三部分组成,项目自己只写了最后一个
- VecEnv:rsl_rl 定义的抽象接口,规定了上面那两个方法
- RslRlVecEnvWrapper:mjlab 提供的适配器,把环境返回的终止标志整理成 dones 与 time_outs
- NavEnv:本项目的环境,继承 mjlab 的 ManagerBasedRlEnv,一个 Python 对象驱动 4096 份并行仿真
class VecEnv(ABC):
"""Abstract class for a vectorized environment.
The vectorized environment is a collection of environments that are synchronized. This means that the same type of
action is applied to all environments and the same type of observation is returned from all environments.
"""
num_envs: int
"""Number of environments."""
num_actions: int
"""Number of actions."""
max_episode_length: int | torch.Tensor
"""Maximum episode length.
The maximum episode length can be a scalar or a tensor. If it is a scalar, it is the same for all environments.
If it is a tensor, it is the maximum episode length for each environment. This is useful for dynamic episode
lengths.
"""
episode_length_buf: torch.Tensor
"""Buffer for current episode lengths."""
device: torch.device | str
"""Device to use."""
cfg: dict | object
"""Configuration object."""
@abstractmethod
def get_observations(self) –> TensorDict:
"""Return the current observations.
Returns:
The observations from the environment.
"""
raise NotImplementedError
@abstractmethod
def step(self, actions: torch.Tensor) –> tuple[TensorDict, torch.Tensor, torch.Tensor, dict]:
raise NotImplementedError
- 通过将我们的环境适配 rsl_rl 的抽象接口,得以在执行环境 step 的时候被统一并行调用
2-2-3 实现
- 假设我们处理好了配置关系,我们同时并行 4096 个环境进行加速训练
- 那么rsl_rl在处理这一行环境step的时候
obs, rewards, dones, extras = self.env.step(actions.to(self.env.device))
- 就会处理返回所有环境数量的obs, rewards, dones, extras
- 其中以观测为例子,返回的观测的维度就是[4096,obs_shape]
- 此时actor输出采样的动作随之改变,变为[4096, action_shape],也就是说Actor 一次 forward 就可以同时给 4096 个环境产生动作。
2-2-4 整体计算
- 配合我们设置好的参数:
num_steps_per_env: 32
env:
num_envs: 4096
- 那么你的整个rollout就会有
4096
×
32
=
131072
4096 \\times32= 131072
4096×32=131072条 transition - 这对训练显而易见,对于我们之前在 bc-ppo 项目中部署的 pybullet 的 4 线程 CPU 并行环境,使用 mujocolab 的 GPU 并行训练可以达到之前训练的数百倍训练效率
2-3 return
- 回到learn函数
# Rollout
with torch.inference_mode():
for _ in range(self.cfg["num_steps_per_env"]):
# Sample actions
actions = self.alg.act(obs)
# Step the environment
obs, rewards, dones, extras = self.env.step(actions.to(self.env.device))
# Check for NaN values from the environment
if self.cfg.get("check_for_nan", True):
check_nan(obs, rewards, dones)
# Move to device
obs, rewards, dones = (obs.to(self.device), rewards.to(self.device), dones.to(self.device))
# Process the step
self.alg.process_env_step(obs, rewards, dones, extras)
# Extract intrinsic rewards if RND is used (only for logging)
intrinsic_rewards = self.alg.intrinsic_rewards if self.cfg["algorithm"]["rnd_cfg"] else None
# Book keeping
self.logger.process_env_step(rewards, dones, extras, intrinsic_rewards)
stop = time.time()
collect_time = stop – start
start = stop
# Compute returns
self.alg.compute_returns(obs)
- 在每个Rollout的结尾,我们会进行一次return的计算
# Compute returns
self.alg.compute_returns(obs)
- 这行代码展开是
def compute_returns(self, obs: TensorDict) –> None:
"""Compute return and advantage targets from stored transitions."""
st = self.storage
# Compute values for the last step
critic_hidden_state = self.critic.get_hidden_state()
last_values = self.critic(obs).detach()
# Restore the critic's hidden state so the next rollout is not affected by the forward pass
self.critic.reset(hidden_state=critic_hidden_state)
# Compute returns and advantages
advantage = 0
for step in reversed(range(st.num_transitions_per_env)):
# If we are at the last step, bootstrap the return value
next_values = last_values if step == st.num_transitions_per_env – 1 else st.values[step + 1]
# 1 if we are not in a terminal state, 0 otherwise
next_is_not_terminal = 1.0 – st.dones[step].float()
# TD error: r_t + gamma * V(s_{t+1}) – V(s_t)
delta = st.rewards[step] + next_is_not_terminal * self.gamma * next_values – st.values[step]
# Advantage: A(s_t, a_t) = delta_t + gamma * lambda * A(s_{t+1}, a_{t+1})
advantage = delta + next_is_not_terminal * self.gamma * self.lam * advantage
# Return: R_t = A(s_t, a_t) + V(s_t)
st.returns[step] = advantage + st.values[step]
# Compute the advantages
st.advantages = st.returns – st.values
# Normalize the advantages if per minibatch normalization is not used
if not self.normalize_advantage_per_mini_batch:
st.advantages = (st.advantages – st.advantages.mean()) / (st.advantages.std() + 1e-8)
2-3-1 returns介绍
- 这里涉及到的数学概念有点多,我们先统一讲解,
- 在强化学习中,Return(回报) 表示从当前时刻
t
t
t 开始,未来能够获得的累计折扣奖励。通常记为G
t
G_t
Gt,其定义为:G
t
=
r
t
+
γ
r
t
+
1
+
γ
2
r
t
+
2
+
⋯
\\boxed{ G_t=r_t+\\gamma r_{t+1}+\\gamma^2r_{t+2}+\\cdots }
Gt=rt+γrt+1+γ2rt+2+⋯其中:-
r
t
r_t
rt:当前时刻获得的即时奖励; -
γ
\\gamma
γ:折扣因子,用于控制未来奖励的重要程度。
-
- 因此,Return 描述的并不是某一个时刻的单步奖励,而是从当前状态开始,未来一段时间内累计能够获得多少奖励。
2-3-2 Return 与 Value 的关系
- 状态价值函数
V
(
s
t
)
V(s_t)
V(st) 表示:V
π
(
s
t
)
=
E
π
[
G
t
∣
s
t
]
\\boxed{ V^\\pi(s_t) = \\mathbb{E}_\\pi[G_t|s_t] }
Vπ(st)=Eπ[Gt∣st] 也就是说:
Return 是一次实际轨迹得到的累计回报,而 Value 是 Critic 对这个累计回报的期望估计。
- 因此可以简单理解为:
G
t
⏟
实际得到的Return
≈
V
(
s
t
)
⏟
Critic的预测
\\underbrace{G_t}_{\\text{实际得到的Return}} \\approx \\underbrace{V(s_t)}_{\\text{Critic的预测}}
实际得到的Return
Gt≈Critic的预测
V(st) - 那么critic的学习目标就是对于观测obs输入以后得到value值,需要逼近这个累计回报
- 因此,在最简单的情况下,可以直接使用 Monte Carlo Return
G
t
G_t
Gt 作为 Critic 的训练目标。
2-3-3 Return 与 Advantage
- 有了 Return 和 Value 后,就可以进一步得到 Advantage:
A
t
=
G
t
−
V
(
s
t
)
\\boxed{ A_t=G_t-V(s_t) }
At=Gt−V(st)其中:-
G
t
G_t
Gt:实际轨迹得到的 Return; -
V
(
s
t
)
V(s_t)
V(st):Critic 对当前状态价值的估计; -
A
t
A_t
At:Advantage,表示当前动作相对于当前状态平均水平的好坏(A
t
=
A
(
s
t
,
a
t
)
A_t=A(s_t,a_t)
At=A(st,at))
-
- 也就是
A
t
=
实际得到的回报
−
Critic预期的回报
\\boxed{ A_t = \\text{实际得到的回报} – \\text{Critic预期的回报} }
At=实际得到的回报−Critic预期的回报其中如果A
t
A_t
At大于0,说明这次动作带来的结果高于 Critic 对该状态的预期。 - 因此我们可以利用 Advantage 去更新 Actor 网络,来衡量当前动作相对于策略在该状态下平均表现的好坏,并提高 Advantage 为正的动作被选择的概率,降低 Advantage 为负的动作被选择的概率。(这个一会我们详细说)
2-3-4 PPO 中的 Return
- 上面介绍的是最基本的 Monte Carlo Return:
G
t
=
r
t
+
γ
r
t
+
1
+
γ
2
r
t
+
2
+
⋯
G_t=r_t+\\gamma r_{t+1}+\\gamma^2r_{t+2}+\\cdots
Gt=rt+γrt+1+γ2rt+2+⋯ - 但是在 PPO 中,如果直接使用完整的 Monte Carlo Return,会存在方差较大的问题。
- 因此 PPO 通常会结合 TD Error 和 GAE(Generalized Advantage Estimation) 来估计 Advantage。
2-3-5 TD Error 和 GAE(Generalized Advantage Estimation)
- GAE(Generalized Advantage Estimation) 是一种利用多个时间步的 TD Error 加权累积来估计 Advantage 的方法,在降低估计方差的同时控制偏差。
- GAE 不直接把整个未来奖励全部算进去,而是先计算:
δ
t
=
r
t
+
γ
V
(
s
t
+
1
)
−
V
(
s
t
)
\\boxed{ \\delta_t = r_t+\\gamma V(s_{t+1})-V(s_t) }
δt=rt+γV(st+1)−V(st)这就是 TD Error。 - 然后把未来多个 TD Error 按照
γ
λ
\\gamma\\lambda
γλ加权:A
t
G
A
E
=
δ
t
+
γ
λ
δ
t
+
1
+
(
γ
λ
)
2
δ
t
+
2
+
⋯
\\boxed{ A_t^{GAE} = \\delta_t + \\gamma\\lambda\\delta_{t+1} + (\\gamma\\lambda)^2\\delta_{t+2} +\\cdots }
AtGAE=δt+γλδt+1+(γλ)2δt+2+⋯其中:-
γ
\\gamma
γ(折扣因子):控制未来奖励的重要程度。γ
\\gamma
γ 越大,越重视远期奖励;越小,越重视当前奖励。
-
λ
\\lambda
λ(GAE 参数):控制未来 TD Error 对当前 Advantage 的影响范围。λ
\\lambda
λ 越大,考虑的未来信息越多,越接近 Monte Carlo;越小,越偏向当前一步的 TD 估计。
-
2-3-6 bootstrap(自举)
- 下面我们开始讲解代码,由于
A
t
=
G
t
−
V
(
s
t
)
\\boxed{ A_t=G_t-V(s_t) }
At=Gt−V(st),我们首先要拿到最后一个状态V
(
s
t
)
V(s_t)
V(st),但是需要注意的是,因为 rollout 可能只是截取了一个固定长度,我们并没有保证当前最后一个st.values[step]就是回合结束的V
(
s
t
)
V(s_t)
V(st) - 同时我们也不能简单地认为未来价值为 0,因此我们采用Critic 估计:
last_values = self.critic(obs).detach()
- 不过 bootstrap 在 PPO 里一共有两处,上面这一处只是其一,另一处在存 transition 的时候
- 第二处的起因是截断与终止在数学上不是同一件事:
- 终止(success 或 collision)意味着这一段真的结束了,
s
t
+
1
s_{t+1}
st+1 之后不再有奖励,γ
V
(
s
t
+
1
)
\\gamma V(s_{t+1})
γV(st+1) 按 0 计是对的 - 截断(time_out)只意味着本回合到了时间上限,机器人还活着,
s
t
+
1
s_{t+1}
st+1 之后其实还有奖励,γ
V
(
s
t
+
1
)
\\gamma V(s_{t+1})
γV(st+1) 不该按 0 计
- 终止(success 或 collision)意味着这一段真的结束了,
- 如果对截断也按 0 处理,Critic 会学到一个错误的信号:越接近时间上限,价值越低。于是策略会算出一笔糊涂账,倾向于在到达上限之前就草草收场,而不是继续把任务做完
说人话:截断只是"时间到了",不是"任务完了",所以要把"以后还能拿到的回报"折算成当下一步的奖励先发出去,否则 Critic 会以为走到这一步就没有未来。
- 所以代码在存 transition 的时候,就把这一段未来价值直接补进奖励里
# Bootstrapping on time outs
if "time_outs" in extras:
self.transition.rewards += self.gamma * torch.squeeze(
self.transition.values * extras["time_outs"].unsqueeze(1).to(self.device),
1,
)
- 逐项看这行加法:
- extras["time_outs"] 是一个 0/1 掩码,只有被时间上限截断的那些环境取 1
- self.transition.values 是这一步存下来的价值估计,它的来历见下面一条
- 两者相乘之后再乘
γ
\\gamma
γ,加进去的项只在被截断的环境上非零,其余环境的奖励一点不改 - 于是被截断那一步的奖励变成
r
t
+
γ
V
r_t + \\gamma V
rt+γV,正好把 TD 误差里本该有、却被终止标志抹掉的那一段补了回来
- 补完之后,这一步在 GAE 里就可以按终止来算了:dones 里它是 1,next_is_not_terminal 取 0,
γ
V
(
s
t
+
1
)
\\gamma V(s_{t+1})
γV(st+1) 不会重复计入,而那段未来价值已经加进奖励里了 - 有一处实现上的近似值得说明:self.transition.values 是在 act() 里、执行动作之前算出来的,对应
V
(
s
t
)
V(s_t)
V(st),而不是严格意义上的V
(
s
t
+
1
)
V(s_{t+1})
V(st+1)。被截断时状态刚刚向前走了一步,两个价值很接近,于是这里省掉了一次额外的 Critic 前向 - 这也解释了 process_env_step 开头为什么要 rewards.clone():奖励张量要就地累加这一项,不 clone 会改写环境那边传进来的张量
2-3-7
V
(
s
t
)
V(s_t)
V(st)计算
- 对应公式
A
t
G
A
E
=
δ
t
+
γ
λ
δ
t
+
1
+
(
γ
λ
)
2
δ
t
+
2
+
⋯
\\boxed{ A_t^{GAE} = \\delta_t + \\gamma\\lambda\\delta_{t+1} + (\\gamma\\lambda)^2\\delta_{t+2} +\\cdots }
AtGAE=δt+γλδt+1+(γλ)2δt+2+⋯,我们分别计算TD误差和GAE计算Advantage - 我们将上述公式写成迭代的形式,因此有:
A
t
=
δ
t
+
γ
λ
A
t
+
1
A_t=\\delta_t+\\gamma\\lambda A_{t+1}
At=δt+γλAt+1 - 注意到计算
A
t
A_t
At必须要知道A
t
+
1
A_{t+1}
At+1,因此我们必须倒着计算,先获取下一时刻的 Value
next_values = last_values if step == st.num_transitions_per_env – 1 else st.values[step + 1]
- 对于最后一步:
- 没有存储的 st.values[T],所以使用刚刚计算的last_values
- 对于其他时间步,直接使用之前 rollout 时 Critic 保存的
V
(
s
t
+
1
)
V(s_{t+1})
V(st+1)
- 同时这里需要判断下一状态是不是终止状态,因为如果当前 transition 后面已经终止(
s
t
+
1
=
terminal
s_{t+1}=\\text{terminal}
st+1=terminal),那么就不能继续使用γ
V
(
s
t
+
1
)
\\gamma V(s_{t+1})
γV(st+1),要手动关闭
# 1 if we are not in a terminal state, 0 otherwise
next_is_not_terminal = 1.0 – st.dones[step].float()
2-3-8 合成
- 然后就是根据公式合成Advantage和Return
A
t
G
A
E
=
δ
t
+
γ
λ
δ
t
+
1
+
(
γ
λ
)
2
δ
t
+
2
+
⋯
\\boxed{ A_t^{GAE} = \\delta_t + \\gamma\\lambda\\delta_{t+1} + (\\gamma\\lambda)^2\\delta_{t+2} +\\cdots }
AtGAE=δt+γλδt+1+(γλ)2δt+2+⋯R
t
=
A
t
+
V
(
s
t
)
\\boxed{ R_t=A_t+V(s_t) }
Rt=At+V(st) - 对应:
# TD error: r_t + gamma * V(s_{t+1}) – V(s_t)
delta = st.rewards[step] + next_is_not_terminal * self.gamma * next_values – st.values[step]
# Advantage: A(s_t, a_t) = delta_t + gamma * lambda * A(s_{t+1}, a_{t+1})
advantage = delta + next_is_not_terminal * self.gamma * self.lam * advantage
# Return: R_t = A(s_t, a_t) + V(s_t)
st.returns[step] = advantage + st.values[step]
- 这两个分别用于更新actor和critic
- 下面的代码就是绕回来,也就是
A
t
=
R
t
−
V
(
s
t
)
=
(
A
t
+
V
(
s
t
)
)
−
V
(
s
t
)
=
A
t
A_t=R_t-V(s_t)=(A_t+V(s_t))-V(s_t)=A_t
At=Rt−V(st)=(At+V(st))−V(st)=At
# Compute the advantages
st.advantages = st.returns – st.values
2-3-9 Advantage 标准化
if not self.normalize_advantage_per_mini_batch:
st.advantages = (st.advantages – st.advantages.mean()) / (st.advantages.std() + 1e-8)
- 上述标准化是为了让一个 rollout 中的所有
A
t
A_t
At 构成一批 Advantage,其mean
≈
0
\\text{mean}\\approx0
mean≈0、std
≈
1
\\text{std}\\approx1
std≈1
2-3-10 小节
- 在每个Rollout的结尾,我们会进行一次return的计算
# Compute returns
self.alg.compute_returns(obs)
- 计算的核心输出为Advantage以及Return
2-4 Min-batch结构
2-4-1 整体一览
- 有了Rollout 得到的 advantages 和 returns,我们就可以计算 Actor Loss、Critic Loss 等,然后反向传播更新网络。
# Update policy
loss_dict = self.alg.update()
- 展开就是:
def update(self) –> dict[str, float]:
"""Run optimization epochs over stored batches and return mean losses."""
mean_value_loss = 0
mean_surrogate_loss = 0
mean_entropy = 0
# RND loss
mean_rnd_loss = 0 if self.rnd else None
# Symmetry loss
mean_symmetry_loss = 0 if self.symmetry else None
# Get mini-batch generator
if self.actor.is_recurrent or self.critic.is_recurrent:
generator = self.storage.recurrent_mini_batch_generator(self.num_mini_batches, self.num_learning_epochs)
else:
generator = self.storage.mini_batch_generator(self.num_mini_batches, self.num_learning_epochs)
# Iterate over mini-batches
for batch in generator:
original_batch_size = batch.observations.batch_size[0]
# Check if we should normalize advantages per mini-batch
if self.normalize_advantage_per_mini_batch:
with torch.no_grad():
batch.advantages = (batch.advantages – batch.advantages.mean()) / (batch.advantages.std() + 1e-8) # type: ignore
# Perform symmetric augmentation if enabled
if self.symmetry:
self.symmetry.augment_batch(batch, original_batch_size)
# Recompute actions log prob and entropy for current batch of transitions
# Note: We need to do this because we updated the policy with new parameters
self.actor(
batch.observations,
masks=batch.masks,
hidden_state=batch.hidden_states[0],
stochastic_output=True,
)
actions_log_prob = self.actor.get_output_log_prob(batch.actions) # type: ignore
values = self.critic(batch.observations, masks=batch.masks, hidden_state=batch.hidden_states[1])
# Note: We only keep the following tensors for the original samples in case of symmetry augmentation
distribution_params = tuple(p[:original_batch_size] for p in self.actor.output_distribution_params)
entropy = self.actor.output_entropy[:original_batch_size]
# Compute KL divergence and adapt the learning rate
if self.desired_kl is not None and self.schedule == "adaptive":
with torch.inference_mode():
kl = self.actor.get_kl_divergence(batch.old_distribution_params, distribution_params) # type: ignore
kl_mean = torch.mean(kl)
# Reduce the KL divergence across all GPUs
if self.is_multi_gpu:
torch.distributed.all_reduce(kl_mean, op=torch.distributed.ReduceOp.SUM)
kl_mean /= self.gpu_world_size
# Update the learning rate only on the main process
if self.gpu_global_rank == 0:
if kl_mean > self.desired_kl * 2.0:
self.learning_rate = max(1e-5, self.learning_rate / 1.5)
elif kl_mean < self.desired_kl / 2.0 and kl_mean > 0.0:
self.learning_rate = min(1e-2, self.learning_rate * 1.5)
# Update the learning rate for all GPUs
if self.is_multi_gpu:
lr_tensor = torch.tensor(self.learning_rate, device=self.device)
torch.distributed.broadcast(lr_tensor, src=0)
self.learning_rate = lr_tensor.item()
# Update the learning rate for all parameter groups
for param_group in self.optimizer.param_groups:
param_group["lr"] = self.learning_rate
# Surrogate loss
ratio = torch.exp(actions_log_prob – torch.squeeze(batch.old_actions_log_prob)) # type: ignore
surrogate = –torch.squeeze(batch.advantages) * ratio # type: ignore
surrogate_clipped = –torch.squeeze(batch.advantages) * torch.clamp( # type: ignore
ratio, 1.0 – self.clip_param, 1.0 + self.clip_param
)
surrogate_loss = torch.max(surrogate, surrogate_clipped).mean()
# Value function loss
if self.use_clipped_value_loss:
value_clipped = batch.values + (values – batch.values).clamp(–self.clip_param, self.clip_param)
value_losses = (values – batch.returns).pow(2)
value_losses_clipped = (value_clipped – batch.returns).pow(2)
value_loss = torch.max(value_losses, value_losses_clipped).mean()
else:
value_loss = (batch.returns – values).pow(2).mean()
loss = surrogate_loss + self.value_loss_coef * value_loss – self.entropy_coef * entropy.mean()
# RND loss
rnd_loss = self.rnd.compute_loss(batch.observations[:original_batch_size]) if self.rnd else None # type: ignore
# Symmetry loss
if self.symmetry:
symmetry_loss = self.symmetry.compute_loss(self.actor, batch, original_batch_size)
if self.symmetry.use_mirror_loss:
loss = loss + self.symmetry.mirror_loss_coeff * symmetry_loss
# Compute the gradients for PPO
self.optimizer.zero_grad()
loss.backward()
# Compute the gradients for RND
if self.rnd:
self.rnd.optimizer.zero_grad()
rnd_loss.backward()
# Collect gradients from all GPUs
if self.is_multi_gpu:
self.reduce_parameters()
# Apply the gradients for PPO
nn.utils.clip_grad_norm_(self.actor.parameters(), self.max_grad_norm)
nn.utils.clip_grad_norm_(self.critic.parameters(), self.max_grad_norm)
self.optimizer.step()
# Apply the gradients for RND
if self.rnd:
self.rnd.optimizer.step()
# Store the losses
mean_value_loss += value_loss.item()
mean_surrogate_loss += surrogate_loss.item()
mean_entropy += entropy.mean().item()
# RND loss
if mean_rnd_loss is not None:
mean_rnd_loss += rnd_loss.item()
# Symmetry loss
if mean_symmetry_loss is not None:
mean_symmetry_loss += symmetry_loss.item()
# Divide the losses by the number of updates
num_updates = self.num_learning_epochs * self.num_mini_batches
mean_value_loss /= num_updates
mean_surrogate_loss /= num_updates
mean_entropy /= num_updates
if mean_rnd_loss is not None:
mean_rnd_loss /= num_updates
if mean_symmetry_loss is not None:
mean_symmetry_loss /= num_updates
# Construct the loss dictionary
loss_dict = {
"value": mean_value_loss,
"surrogate": mean_surrogate_loss,
"entropy": mean_entropy,
}
if self.rnd:
loss_dict["rnd"] = mean_rnd_loss
if self.symmetry:
loss_dict["symmetry"] = mean_symmetry_loss
# Clear the storage
self.storage.clear()
return loss_dict
- 代码有点长,我们一个个看
2-4-2 训练结构
- 需要说明的是,PPO 在训练中一轮(iter)的时候,是进行如下的行为:
- Rollout 收集了一批数据之后,并不是只用一次,而是让 PPO 在这批数据上进行多轮优化。
- 也就是
一次 Rollout
→
多个 Epoch
→
多个 Mini-batch
\\boxed{ \\text{一次 Rollout} \\rightarrow \\text{多个 Epoch} \\rightarrow \\text{多个 Mini-batch} }
一次 Rollout→多个 Epoch→多个 Mini-batch
generator = self.storage.mini_batch_generator(self.num_mini_batches, self.num_learning_epochs)
- 回顾我们刚刚讲并行环境提到的,一个Rollout一共有
4096
×
32
=
131072
4096 \\times32= 131072
4096×32=131072条 transition,那么配合到这里的参数
algorithm:
class_name: PPO
num_learning_epochs: 5
num_mini_batches: 4
- 也就是一个Rollout的131072的数据会被重复训练 num_learning_epochs 遍。
- 但是考虑到每次都直接使用全部131072的数据进行训练计算梯度,那么单次计算的数据量较大。因此 PPO 会进一步将一个 Epoch 的数据划分成多个 Mini-batch。
- 因此每个Mini-batch大概会有32768条(131072/4)数据去训练
- 整个环境图表如下:
Iteration
│
├── Rollout
│ └── 4096 × 32 = 131072 transitions
│
└── Update
│
├── Epoch 1
│ ├── Mini-batch 1
│ ├── Mini-batch 2
│ ├── Mini-batch 3
│ └── Mini-batch 4
│
├── Epoch 2
│ ├── Mini-batch 1
│ ├── Mini-batch 2
│ ├── Mini-batch 3
│ └── Mini-batch 4
│
├── Epoch 3
│ ├── Mini-batch 1
│ ├── Mini-batch 2
│ ├── Mini-batch 3
│ └── Mini-batch 4
│
├── Epoch 4
│ ├── Mini-batch 1
│ ├── Mini-batch 2
│ ├── Mini-batch 3
│ └── Mini-batch 4
│
└── Epoch 5
├── Mini-batch 1
├── Mini-batch 2
├── Mini-batch 3
└── Mini-batch 4
- 每个mini-batch:
# Iterate over mini-batches
for batch in generator:
2-4-3 RolloutStorage
- 到这里我们已经两次提到 RolloutStorage(1-7-6 往里存,2-4-2 从里取 mini-batch),但还没有看过它本身
- 它就是那块缓冲区:Rollout 阶段往里写,Update 阶段从里读,一轮训练结束时清空,下一轮从第一行重新写起
- 它开的是一整块提前分配好的张量表,而不是一条条追加的列表,每个量都按时间步与环境数两个维度开:
- 第 0 维是时间步
T
T
T,取 num_steps_per_env,本工程为 32 - 第 1 维是环境数
N
N
N,取 num_envs,本工程为 4096 - 再往后才是这个量自身的形状,动作是 3 维,价值与对数概率是 1 维
- 第 0 维是时间步
# 每个量都按 (T, N, …) 开,T = 32,N = 4096
self.observations = TensorDict(..., batch_size=[num_transitions_per_env, num_envs])
self.actions = torch.zeros(num_transitions_per_env, num_envs, *actions_shape, device=self.device)
self.rewards = torch.zeros(num_transitions_per_env, num_envs, 1, device=self.device)
self.values = torch.zeros(num_transitions_per_env, num_envs, 1, device=self.device)
self.actions_log_prob = torch.zeros(num_transitions_per_env, num_envs, 1, device=self.device)
self.returns = torch.zeros(num_transitions_per_env, num_envs, 1, device=self.device)
self.advantages = torch.zeros(num_transitions_per_env, num_envs, 1, device=self.device)
说人话:缓冲区不是一条条塞进去的流水账,而是一张提前铺好的大表,“第几步、第几个环境"就是"第几行、第几列”,按坐标直接写进去。
- 写入靠一个自增计数器 self.step,每存一条加一;写满
T
T
T 条之后若没有 clear() 就继续写,会直接抛 OverflowError
def add_transition(self, transition: Transition) –> None:
if self.step >= self.num_transitions_per_env:
raise OverflowError("Rollout buffer overflow! You should call clear() before adding new transitions.")
self.observations[self.step].copy_(transition.observations)
self.actions[self.step].copy_(transition.actions)
self.rewards[self.step].copy_(transition.rewards.view(–1, 1))
self.dones[self.step].copy_(transition.dones.view(–1, 1))
self.step += 1
- 这个报错是设计上的保险:写入次数由 num_steps_per_env 的循环决定,读取次数由 compute_returns 的循环决定,两者一旦对不上,宁可在这里停住,也不要让两轮的数据静静混进同一张表
- 读出发生在 mini_batch_generator 里,它做三件事:
- 拍平:把
(
T
,
N
,
⋅
)
(T,N,\\cdot)
(T,N,⋅) 的前两维合成一维,得到T
×
N
=
131072
T \\times N = 131072
T×N=131072 条互相独立的 transition。GAE 已经在 compute_returns 里算完了,所以 update 阶段不再需要保留时间结构 - 打乱:用 torch.randperm 生成一个全排列,再按 num_mini_batches 切成等长若干段,同一个 epoch 内的各段互不重叠且合起来覆盖全部数据
- 改名:actions_log_prob 变成 old_actions_log_prob、distribution_params 变成 old_distribution_params,用名字提醒我们这两个量来自旧策略,不能当新策略的量用
- 拍平:把
batch_size = self.num_envs * self.num_transitions_per_env
mini_batch_size = batch_size // num_mini_batches
indices = torch.randperm(num_mini_batches * mini_batch_size, requires_grad=False, device=self.device)
observations = self.observations.flatten(0, 1)
old_actions_log_prob = self.actions_log_prob.flatten(0, 1)
old_distribution_params = tuple(p.flatten(0, 1) for p in self.distribution_params)
for epoch in range(num_epochs):
for i in range(num_mini_batches):
batch_idx = indices[i * mini_batch_size : (i + 1) * mini_batch_size]
yield RolloutStorage.Batch(
observations=observations[batch_idx],
advantages=advantages[batch_idx],
old_actions_log_prob=old_actions_log_prob[batch_idx],
old_distribution_params=tuple(p[batch_idx] for p in old_distribution_params),
)
- 打乱的意义在于让一个 mini-batch 里的样本来自不同时间步、不同环境,而不是连着几十步的同一条轨迹,否则同一批数据内部的梯度高度相关,更新方向会被少数几条轨迹带偏
- 注意 torch.randperm 写在两层循环之外:五个 epoch 用的是同一个排列,也就是同一份数据被反复利用,只是每遍按同样的方式切分,切分方式在 epoch 之间保持不变
- 生命周期上它是一轮一清:PPO.update() 的最后一行调用 self.storage.clear(),把计数器和表一起复位
- 清空是必须的:更新用的是旧策略采出来的数据,策略一变,这批数据的 old_actions_log_prob 就不再对应任何真实策略,留在表里只会被下一轮误用
2-5 Loss计算
2-5-1 重新计算网络的输出
- 由于同一个rollout我们会训练多轮,每一个mini-batch我们都要计算actions_log_prob,所以需要用当前策略重新计算
log
π
θ
(
a
t
∣
s
t
)
\\log\\pi_\\theta(a_t|s_t)
logπθ(at∣st) - 这样PPO才能对比新策略和旧策略(存储在buffer中)计算概率比例
# Recompute actions log prob and entropy for current batch of transitions
# Note: We need to do this because we updated the policy with new parameters
self.actor(
batch.observations,
masks=batch.masks,
hidden_state=batch.hidden_states[0],
stochastic_output=True,
)
actions_log_prob = self.actor.get_output_log_prob(batch.actions) # type: ignore
- 同理我们也要重新计算critic
values = self.critic(batch.observations, masks=batch.masks, hidden_state=batch.hidden_states[1])
2-5-2 Actor:Surrogate Loss
- 这部分是对应的策略网络Actor的损失,在使用GAE计算出
A
t
A_t
At后我们定义:L
actor
=
E
[
max
(
−
r
t
A
t
,
−
clip
(
r
t
,
1
−
ϵ
,
1
+
ϵ
)
A
t
)
]
L_{\\text{actor}} = \\mathbb{E} \\left[ \\max \\left( -r_tA_t, -\\operatorname{clip}(r_t,1-\\epsilon,1+\\epsilon)A_t \\right) \\right]
Lactor=E[max(−rtAt,−clip(rt,1−ϵ,1+ϵ)At)]
ratio = torch.exp(actions_log_prob – torch.squeeze(batch.old_actions_log_prob)) # type: ignore
surrogate = –torch.squeeze(batch.advantages) * ratio # type: ignore
surrogate_clipped = –torch.squeeze(batch.advantages) * torch.clamp( # type: ignore
ratio, 1.0 – self.clip_param, 1.0 + self.clip_param
)
surrogate_loss = torch.max(surrogate, surrogate_clipped).mean()
- 这里就是 PPO 的核心机制:概率比例,即新策略与旧策略在同一个状态-动作对上取到该动作的概率之比
r
t
(
θ
)
=
π
θ
(
a
t
∣
s
t
)
π
θ
o
l
d
(
a
t
∣
s
t
)
r_t(\\theta) = \\frac{\\pi_\\theta(a_t|s_t)} {\\pi_{\\theta_{old}}(a_t|s_t)}
rt(θ)=πθold(at∣st)πθ(at∣st) - 然后进行 Clip,即把比值限制在
[
1
−
ϵ
,
1
+
ϵ
]
[1-\\epsilon, 1+\\epsilon]
[1−ϵ,1+ϵ] 内,超出部分不再提供梯度 - 公式里的
π
θ
o
l
d
(
a
t
∣
s
t
)
\\pi_{\\theta_{old}}(a_t|s_t)
πθold(at∣st) 就是代码中的 batch.old_actions_log_prob,它的来源很明确:Rollout 阶段 act() 里用当时的策略算出 actions_log_prob,存进 RolloutStorage 的 self.actions_log_prob,取出来时被 mini_batch_generator 改名为带 old_ 前缀的字段(见 2-4-3)- 也就是说这个量是算一次、存下来的,而不是更新时现算的;名字里的 old 指的是采数据那一刻的策略,不是"上一个 mini-batch 的策略"
- 分子则相反,是 2-5-1 里用当前参数现算的
log
π
θ
(
a
t
∣
s
t
)
\\log\\pi_\\theta(a_t|s_t)
logπθ(at∣st)。两者相减再取指数,就是概率比值
- 这里用对数相减再取指数,而不是直接拿两个概率相除:概率本身可以小到接近 0,直接相除的数值范围很差,取对数之后两个量都落在温和的区间里,减法再指数化既稳定又等价
说人话:比值就是"同一个动作,新策略比旧策略愿意选它的倍数"。大于 1 说明新策略更倾向这个动作,小于 1 说明更不倾向。
- 为什么要限制它:一批数据在更新前后只隔着几次梯度,本意就是每次只挪一小段。如果某个动作的比值被推到 5 倍,梯度会随着比值一起放大,一次更新就可能把策略甩出去很远,后面那些按旧策略采的数据就全部失去意义
- 截断还有一处单侧性值得单独说一句:
- 当
A
t
>
0
A_t>0
At>0(这个动作比平均水平好)时,比值超过1
+
ϵ
1+\\epsilon
1+ϵ 就被夹住,再涨也不给梯度,防止把一个好动作的概率一次推得太高 - 当
A
t
<
0
A_t<0
At<0(这个动作比平均水平差)时,比值低于1
−
ϵ
1-\\epsilon
1−ϵ 才被夹住,再降也不给梯度,防止把一个坏动作一次压得太低 - 反方向则不设限:好动作的概率被压低、坏动作的概率被抬高时梯度照常存在,因为那是在把策略拉回原处,本来就该有梯度把它拽回来
- 当
- 代码写的是 torch.max(surrogate, surrogate_clipped),两项都带负号,所以取 max 等价于对
r
t
A
t
r_tA_t
rtAt 与clip
(
r
t
)
A
t
\\operatorname{clip}(r_t)A_t
clip(rt)At 取 min,也就是两个候选里永远选更差的那个
这就是 PPO 的悲观下界:无论优化器把比值推到哪里,都不会因为推过头而额外获益,越过截断点之后损失不再变好,梯度自然为 0。
2-5-3 Critic:Value Loss
- 这部分是价值网络critic的损失,定义如下
L
critic
=
E
[
(
R
t
−
V
ϕ
(
s
t
)
)
2
]
L_{\\text{critic}} = \\mathbb{E} \\left[ (R_t-V_\\phi(s_t))^2 \\right]
Lcritic=E[(Rt−Vϕ(st))2]
# Value function loss
if self.use_clipped_value_loss:
value_clipped = batch.values + (values – batch.values).clamp(–self.clip_param, self.clip_param)
value_losses = (values – batch.returns).pow(2)
value_losses_clipped = (value_clipped – batch.returns).pow(2)
value_loss = torch.max(value_losses, value_losses_clipped).mean()
else:
value_loss = (batch.returns – values).pow(2).mean()
loss = surrogate_loss + self.value_loss_coef * value_loss – self.entropy_coef * entropy.mean()
- 其中:use_clipped_value_loss 用于控制是否对 Critic 的价值估计进行裁剪。当启用时,限制新旧 Value 之间的变化幅度,从而避免 Critic 在单次更新中发生过大的参数调整。
2-5-4 Entropy Loss(熵损失)
- Entropy是鼓励策略探索
H
(
π
θ
(
⋅
∣
s
t
)
)
H(\\pi_\\theta(\\cdot|s_t))
H(πθ(⋅∣st))即当前策略在状态s
t
s_t
st 下动作分布的不确定性。
entropy = self.actor.output_entropy[:original_batch_size]
- 需要说明的是,高斯分布的 Entropy 实际上只与 std 有关,与 mean 无关。
- 如果各维独立,那么总 Entropy 就是每个维度 Entropy 的和:
H
=
∑
i
=
1
d
1
2
ln
(
2
π
e
σ
i
2
)
\\boxed{ H = \\sum_{i=1}^{d} \\frac12 \\ln(2\\pi e\\sigma_i^2) }
H=i=1∑d21ln(2πeσi2)也可以写成:H
=
∑
i
=
1
d
[
ln
σ
i
+
1
2
ln
(
2
π
e
)
]
\\boxed{ H = \\sum_{i=1}^{d} \\left[ \\ln\\sigma_i + \\frac12\\ln(2\\pi e) \\right] }
H=i=1∑d[lnσi+21ln(2πe)] - 通过鼓励策略保持较高的动作分布熵,避免 Actor 过早变得过于确定,从而增强训练过程中的探索能力。
L
entropy
=
−
c
e
H
(
π
θ
)
\\boxed{ L_{\\text{entropy}}=-c_eH(\\pi_\\theta) }
Lentropy=−ceH(πθ)其中:-
H
(
π
θ
)
H(\\pi_\\theta)
H(πθ):当前策略的熵 -
c
e
c_e
ce:entropy_coef -
−
–
−:这里选择符号是因为PPO 的优化目标是最小化 Loss,我们希望增加当前策略的熵
-
–self.entropy_coef * entropy.mean()
Entropy Loss 通过最大化策略分布的熵,鼓励 Actor 保持一定的动作随机性,从而避免策略过早收敛到确定性动作,增强训练过程中的探索能力。
2-5-5 Symmetry loss
- 对称性损失(Symmetry Loss):如果机器人/任务具有某种物理对称性,那么希望 Actor 对对称变换前后的状态,输出相应对称变换后的动作。其中:
# Symmetry loss
if self.symmetry:
symmetry_loss = self.symmetry.compute_loss(self.actor, batch, original_batch_size)
if self.symmetry.use_mirror_loss:
loss = loss + self.symmetry.mirror_loss_coeff * symmetry_loss
- 核心的计算方式就是计算:当前 Actor 对原始观测和镜像观测产生的动作,是否满足预期的对称关系。
说人话就是构造当前观测
o
t
o_t
ot的镜像
M
(
o
t
)
M(o_t)
M(ot),输入到Actor网络中,去计算原动作分布
a
=
π
θ
(
o
t
)
a=\\pi_{\\theta}(o_t)
a=πθ(ot)和镜像观测输入后的动作分布
a
=
π
θ
(
M
(
o
t
)
)
a=\\pi_{\\theta}(M(o_t))
a=πθ(M(ot))相差多少
- 公式就是
L
sym
=
∥
π
θ
(
M
(
o
)
)
−
M
a
(
π
θ
(
o
)
)
∥
2
L_{\\text{sym}} = \\left\\| \\pi_\\theta(M(o)) – M_a(\\pi_\\theta(o)) \\right\\|^2
Lsym=∥πθ(M(o))−Ma(πθ(o))∥2 - 展开就是
def compute_loss(self, actor: MLPModel, batch: RolloutStorage.Batch, original_batch_size: int) –> torch.Tensor:
"""Compute the mirror loss between the actor's action means on original and mirrored observations.
If :meth:`augment_batch` has not been called for this batch (i.e. :attr:`use_data_augmentation` is False), the
observations are augmented here first so that the actor is evaluated on both the original and the mirrored
samples.
The returned loss is detached when :attr:`use_mirror_loss` is False so that it can be reported for logging
without contributing to gradients.
"""
# Augment observations if the batch has not already been augmented
if not self.use_data_augmentation:
batch.observations, _ = self.data_augmentation_func(env=self.env, obs=batch.observations, actions=None)
# Action means predicted by the actor on the augmented observation batch
mean_actions = actor(batch.observations.detach().clone())
# Mirror the original-slice action means using the augmentation function. We use the action means here rather
# than the sampled actions in ``batch.actions``, since the symmetry loss is defined on the policy mean.
_, mean_actions_symm = self.data_augmentation_func(
env=self.env, obs=None, actions=mean_actions[:original_batch_size]
)
# MSE between the actor prediction on mirrored obs and the mirrored actor prediction on the original obs
symmetry_loss = nn.functional.mse_loss(
mean_actions[original_batch_size:],
mean_actions_symm.detach()[original_batch_size:],
)
return symmetry_loss if self.use_mirror_loss else symmetry_loss.detach()
2-5-6 Loss合并
loss = surrogate_loss + self.value_loss_coef * value_loss – self.entropy_coef * entropy.mean()
2-6 Adaptive Learning Rate(自适应学习率)机制
2-6-1 总览
- 这一段就是 PPO 的 Adaptive Learning Rate(自适应学习率)机制。核心思想其实很简单:
通过比较新旧策略的 KL 散度,判断当前策略更新幅度是否过大或过小,然后动态调整学习率。
- 我们先给出全部代码,然后下面细致分析
distribution_params = tuple(p[:original_batch_size] for p in self.actor.output_distribution_params)
# Compute KL divergence and adapt the learning rate
if self.desired_kl is not None and self.schedule == "adaptive":
with torch.inference_mode():
kl = self.actor.get_kl_divergence(batch.old_distribution_params, distribution_params) # type: ignore
kl_mean = torch.mean(kl)
# Reduce the KL divergence across all GPUs
if self.is_multi_gpu:
torch.distributed.all_reduce(kl_mean, op=torch.distributed.ReduceOp.SUM)
kl_mean /= self.gpu_world_size
# Update the learning rate only on the main process
if self.gpu_global_rank == 0:
if kl_mean > self.desired_kl * 2.0:
self.learning_rate = max(1e-5, self.learning_rate / 1.5)
elif kl_mean < self.desired_kl / 2.0 and kl_mean > 0.0:
self.learning_rate = min(1e-2, self.learning_rate * 1.5)
# Update the learning rate for all GPUs
if self.is_multi_gpu:
lr_tensor = torch.tensor(self.learning_rate, device=self.device)
torch.distributed.broadcast(lr_tensor, src=0)
self.learning_rate = lr_tensor.item()
# Update the learning rate for all parameter groups
for param_group in self.optimizer.param_groups:
param_group["lr"] = self.learning_rate
2-6-2 计算 KL 散度
- 我们在【生成式模型入门】(一):变分自编码器 VAE — 从 ELBO 推导到机器人轨迹生成 中提到过:
- KL 散度衡量两个分布的差异,定义是
D
K
L
(
q
(
z
)
∥
p
(
z
)
)
=
∫
q
(
z
)
log
q
(
z
)
p
(
z
)
d
z
D_{KL}\\big(q(z)\\,\\Vert\\,p(z)\\big) = \\int q(z) \\log \\frac{q(z)}{p(z)}\\, dz
DKL(q(z)∥p(z))=∫q(z)logp(z)q(z)dz
kl = self.actor.get_kl_divergence(batch.old_distribution_params, distribution_params) # type: ignore
- 其中:
- batch.old_distribution_params:Rollout 时保存的旧策略分布参数
- distribution_params:当前 Actor 根据当前网络参数计算出的新策略分布参数
2-6-3 对 Mini-batch 求平均
- 因为一个 Mini-batch 中有很多状态,每个样本都有一个 KL,所以要求平均
kl_mean = torch.mean(kl)
2-6-4 自适应学习率机制
- 机制本身很直接:KL 太大说明这一步更新跨得太远,把学习率调小;KL 太小说明几乎没学到东西,把学习率调大
- 为什么要有这一层调度,而不是把学习率写死在配置里:
- PPO 的信任域是靠 Clip 实现的,但 Clip 管的是单个样本的比值,管不了整批数据上策略一共移动了多远,真正决定这一步实际挪多大的是学习率
- 而这一步该挪多大与训练处在哪个阶段有关:早期策略离目标行为很远,需要迈大步;后期接近收敛,迈大步会把已经学好的行为破坏掉
- 固定学习率只能取一个折中值,两头都不满意,早期显得太慢、后期显得太猛;更麻烦的是这个折中点还随任务与奖励量级变化,换一个任务就要重新标一次
- 而 KL 正好是"移动了多远"的直接度量,它衡量的就是更新前后新旧策略分布的差异,于是可以用它构成一个反馈环,让学习率自己找到合适的量级
- 这一层调度的实现代价很低:它只改写优化器参数组里的学习率,不需要动网络结构,也不需要额外的前向计算
- 阈值取 desired_kl 的两倍与一半,也就是 KL 均值超过 0.02 就除以 1.5,低于 0.005 就乘以 1.5
- 倍数取 1.5 而不是更大的值,是为了让学习率平滑地移动:调得太猛会在几个 mini-batch 之内从上限跳到下限,本身就成了一个不稳定的环节
- 目标值 desired_kl 取
0.01
0.01
0.01,与 clip_param 的0.2
0.2
0.2 是相称的:D
K
L
≈
0.01
D_{KL}\\approx0.01
DKL≈0.01 对应的比值偏离在百分之十几,与裁剪幅度落在同一个量级,两者说的是同一件事的两种刻度 - 上下界分别锁在 1e-5 与 1e-2,避免学习率在极端情况下发散或归零
- 需要说明的是,self.learning_rate 是 PPO 对象的持久状态,跨 mini-batch、跨 iteration 累积,而不是每轮重置回 YAML 里的 3.0e-4
- 所以 TB 上的 learning_rate 曲线本身就是一条有意义的监控量:长期贴着上界说明每次更新都很小,长期贴着下界说明更新过猛
# Update the learning rate only on the main process
if self.gpu_global_rank == 0:
if kl_mean > self.desired_kl * 2.0:
self.learning_rate = max(1e-5, self.learning_rate / 1.5)
elif kl_mean < self.desired_kl / 2.0 and kl_mean > 0.0:
self.learning_rate = min(1e-2, self.learning_rate * 1.5)
2-7 反向传播、迭代与Gradient Clipping
- 反向传播计算 PPO 梯度,然后调用优化器真正更新 Actor 和 Critic
- Gradient Clipping:如果梯度范数过大:
∥
g
∥
>
g
max
\\|g\\|>g_{\\max}
∥g∥>gmax则进行缩放:g
′
=
g
g
max
∥
g
∥
g' = g\\frac{g_{\\max}}{\\|g\\|}
g′=g∥g∥gmax
防止某次 PPO 更新产生过大的梯度,从而提高训练稳定性。
# Compute the gradients for PPO
self.optimizer.zero_grad()
loss.backward()
# Compute the gradients for RND
if self.rnd:
self.rnd.optimizer.zero_grad()
rnd_loss.backward()
# Collect gradients from all GPUs
if self.is_multi_gpu:
self.reduce_parameters()
# Apply the gradients for PPO
nn.utils.clip_grad_norm_(self.actor.parameters(), self.max_grad_norm)
nn.utils.clip_grad_norm_(self.critic.parameters(), self.max_grad_norm)
self.optimizer.step()
- 这几行是一次参数更新的完整工序,顺序不能换,逐句看:
- self.optimizer.zero_grad():PyTorch 的梯度是累加的,不清零的话上一个 mini-batch 的梯度会跟这一个的加在一起
- loss.backward():反向传播,把损失对每个参数的偏导算出来写进各参数的 .grad。到这一步为止参数本身一个都没变,变的只是梯度
- nn.utils.clip_grad_norm_(…):裁剪的对象是 .grad,所以必须在 step() 之前,否则梯度已经被用掉了
- self.optimizer.step():优化器读 .grad,按自己的更新规则算出这一步的更新量并写回参数。这是整段训练里唯一真正改变网络权重的一句,此前的 act、update、backward 都只是在为它做准备
- step() 内部做的事可以概括成三步,以 Adam 为例:
- 用一阶矩与二阶矩的滑动平均把当前梯度平滑一遍,也就是带动量的那部分
- 按二阶矩对每个参数做逐参数缩放,梯度一直很大的参数步子自动变小,一直很小的参数步子自动变大
- 乘上学习率 lr 再加到参数上,而 lr 正是 2-6 的自适应机制在每个 mini-batch 之后改写的那一项
- 这也解释了自适应学习率为什么不需要改优化器:只要在 step() 之前改掉参数组里的 lr,下一次 step() 就按新的学习率走
- 本工程的 Actor 与 Critic 共用一个优化器对象、同一个学习率,只是裁剪梯度时分两次做,两边的裁剪阈值都取 max_grad_norm
2-8 PPO参数表
- 把上面散落在各处的参数集中列一份,取值来自本工程的 conf/nav.yaml
| num_envs | 4096 | 并行环境数 |
| num_steps_per_env | 32 | 每个环境每轮采集的步数 |
| num_learning_epochs | 5 | 一批 rollout 被重复训练的遍数 |
| num_mini_batches | 4 | 每个 epoch 切成几个 mini-batch |
| clip_param | 0.2 | 重要性比值的裁剪幅度 |
| gamma | 0.99 | 折扣因子 |
| lam | 0.95 | GAE 参数 |
| entropy_coef | 0.005 | 熵奖励系数 |
| learning_rate | 3.0e-4 | 初始学习率,之后由自适应机制接管 |
| schedule | adaptive | 学习率调度方式 |
| desired_kl | 0.01 | 自适应学习率的目标 KL |
| value_loss_coef | 1.0 | 价值损失权重(默认值) |
| max_grad_norm | 1.0 | 梯度裁剪范数(默认值) |
| use_clipped_value_loss | True | 是否裁剪价值损失(默认值) |
| normalize_advantage_per_mini_batch | False | Advantage 是否按 mini-batch 归一化(默认值) |
- 由此可以算出本工程的三个规模量:一个 rollout 有
4096
×
32
=
131072
4096 \\times 32 = 131072
4096×32=131072 条 transition,一次 update 做5
×
4
=
20
5 \\times 4 = 20
5×4=20 次梯度更新,每个 mini-batch 32768 条 - 另有两个参数不在算法段里,但直接决定上面的数字:num_envs 在 env 段,num_steps_per_env 在 rsl_rl 段
2-9 完整 PPO 数据流
#mermaid-svg-8k2wH2rNANAC044z{font-family:\”trebuchet ms\”,verdana,arial,sans-serif;font-size:16px;fill:#333;}@keyframes edge-animation-frame{from{stroke-dashoffset:0;}}@keyframes dash{to{stroke-dashoffset:0;}}#mermaid-svg-8k2wH2rNANAC044z .edge-animation-slow{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 50s linear infinite;stroke-linecap:round;}#mermaid-svg-8k2wH2rNANAC044z .edge-animation-fast{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 20s linear infinite;stroke-linecap:round;}#mermaid-svg-8k2wH2rNANAC044z .error-icon{fill:#552222;}#mermaid-svg-8k2wH2rNANAC044z .error-text{fill:#552222;stroke:#552222;}#mermaid-svg-8k2wH2rNANAC044z .edge-thickness-normal{stroke-width:1px;}#mermaid-svg-8k2wH2rNANAC044z .edge-thickness-thick{stroke-width:3.5px;}#mermaid-svg-8k2wH2rNANAC044z .edge-pattern-solid{stroke-dasharray:0;}#mermaid-svg-8k2wH2rNANAC044z .edge-thickness-invisible{stroke-width:0;fill:none;}#mermaid-svg-8k2wH2rNANAC044z .edge-pattern-dashed{stroke-dasharray:3;}#mermaid-svg-8k2wH2rNANAC044z .edge-pattern-dotted{stroke-dasharray:2;}#mermaid-svg-8k2wH2rNANAC044z .marker{fill:#333333;stroke:#333333;}#mermaid-svg-8k2wH2rNANAC044z .marker.cross{stroke:#333333;}#mermaid-svg-8k2wH2rNANAC044z svg{font-family:\”trebuchet ms\”,verdana,arial,sans-serif;font-size:16px;}#mermaid-svg-8k2wH2rNANAC044z p{margin:0;}#mermaid-svg-8k2wH2rNANAC044z .label{font-family:\”trebuchet ms\”,verdana,arial,sans-serif;color:#333;}#mermaid-svg-8k2wH2rNANAC044z .cluster-label text{fill:#333;}#mermaid-svg-8k2wH2rNANAC044z .cluster-label span{color:#333;}#mermaid-svg-8k2wH2rNANAC044z .cluster-label span p{background-color:transparent;}#mermaid-svg-8k2wH2rNANAC044z .label text,#mermaid-svg-8k2wH2rNANAC044z span{fill:#333;color:#333;}#mermaid-svg-8k2wH2rNANAC044z .node rect,#mermaid-svg-8k2wH2rNANAC044z .node circle,#mermaid-svg-8k2wH2rNANAC044z .node ellipse,#mermaid-svg-8k2wH2rNANAC044z .node polygon,#mermaid-svg-8k2wH2rNANAC044z .node path{fill:#ECECFF;stroke:#9370DB;stroke-width:1px;}#mermaid-svg-8k2wH2rNANAC044z .rough-node .label text,#mermaid-svg-8k2wH2rNANAC044z .node .label text,#mermaid-svg-8k2wH2rNANAC044z .image-shape .label,#mermaid-svg-8k2wH2rNANAC044z .icon-shape .label{text-anchor:middle;}#mermaid-svg-8k2wH2rNANAC044z .node .katex path{fill:#000;stroke:#000;stroke-width:1px;}#mermaid-svg-8k2wH2rNANAC044z .rough-node .label,#mermaid-svg-8k2wH2rNANAC044z .node .label,#mermaid-svg-8k2wH2rNANAC044z .image-shape .label,#mermaid-svg-8k2wH2rNANAC044z .icon-shape .label{text-align:center;}#mermaid-svg-8k2wH2rNANAC044z .node.clickable{cursor:pointer;}#mermaid-svg-8k2wH2rNANAC044z .root .anchor path{fill:#333333!important;stroke-width:0;stroke:#333333;}#mermaid-svg-8k2wH2rNANAC044z .arrowheadPath{fill:#333333;}#mermaid-svg-8k2wH2rNANAC044z .edgePath .path{stroke:#333333;stroke-width:2.0px;}#mermaid-svg-8k2wH2rNANAC044z .flowchart-link{stroke:#333333;fill:none;}#mermaid-svg-8k2wH2rNANAC044z .edgeLabel{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-8k2wH2rNANAC044z .edgeLabel p{background-color:rgba(232,232,232, 0.8);}#mermaid-svg-8k2wH2rNANAC044z .edgeLabel rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-8k2wH2rNANAC044z .labelBkg{background-color:rgba(232, 232, 232, 0.5);}#mermaid-svg-8k2wH2rNANAC044z .cluster rect{fill:#ffffde;stroke:#aaaa33;stroke-width:1px;}#mermaid-svg-8k2wH2rNANAC044z .cluster text{fill:#333;}#mermaid-svg-8k2wH2rNANAC044z .cluster span{color:#333;}#mermaid-svg-8k2wH2rNANAC044z div.mermaidTooltip{position:absolute;text-align:center;max-width:200px;padding:2px;font-family:\”trebuchet ms\”,verdana,arial,sans-serif;font-size:12px;background:hsl(80, 100%, 96.2745098039%);border:1px solid #aaaa33;border-radius:2px;pointer-events:none;z-index:100;}#mermaid-svg-8k2wH2rNANAC044z .flowchartTitleText{text-anchor:middle;font-size:18px;fill:#333;}#mermaid-svg-8k2wH2rNANAC044z rect.text{fill:none;stroke-width:0;}#mermaid-svg-8k2wH2rNANAC044z .icon-shape,#mermaid-svg-8k2wH2rNANAC044z .image-shape{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-8k2wH2rNANAC044z .icon-shape p,#mermaid-svg-8k2wH2rNANAC044z .image-shape p{background-color:rgba(232,232,232, 0.8);padding:2px;}#mermaid-svg-8k2wH2rNANAC044z .icon-shape .label rect,#mermaid-svg-8k2wH2rNANAC044z .image-shape .label rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-8k2wH2rNANAC044z .label-icon{display:inline-block;height:1em;overflow:visible;vertical-align:-0.125em;}#mermaid-svg-8k2wH2rNANAC044z .node .label-icon path{fill:currentColor;stroke:revert;stroke-width:revert;}#mermaid-svg-8k2wH2rNANAC044z :root{–mermaid-font-family:\”trebuchet ms\”,verdana,arial,sans-serif;}
obs
action
Rollout 结束
下一轮 Rollout
Environment
Actorπ(a|s)
Environment
reward
done
obs'
RolloutStorageobs / action / reward / donevalue / log_prob / …
GAE / Return
Advantage
Return
Actor Loss
Critic Loss
PPO Loss
backward()
Gradient Clipping
optimizer.step()
更新 Actor / Critic
2-10 外层训练循环
- 前面九节把一轮里的零件逐个拆过了,最后把它们装回真正的容器 OnPolicyRunner.learn()
- 它就是一个 for 循环,每一轮做五件事:采一批数据、算 return 与 advantage、更新一次策略、写日志、按间隔存盘
for it in range(start_it, total_it):
start = time.time()
# 1) Rollout:见 2-1 与 2-2
with torch.inference_mode():
for _ in range(self.cfg["num_steps_per_env"]):
actions = self.alg.act(obs)
obs, rewards, dones, extras = self.env.step(actions.to(self.env.device))
if self.cfg.get("check_for_nan", True):
check_nan(obs, rewards, dones)
obs, rewards, dones = (obs.to(self.device), rewards.to(self.device), dones.to(self.device))
self.alg.process_env_step(obs, rewards, dones, extras)
intrinsic_rewards = self.alg.intrinsic_rewards if self.cfg["algorithm"]["rnd_cfg"] else None
self.logger.process_env_step(rewards, dones, extras, intrinsic_rewards)
# 2) Return 与 Advantage:见 2-3
self.alg.compute_returns(obs)
collect_time = time.time() – start
# 3) Update:见 2-4 到 2-7
loss_dict = self.alg.update()
learn_time = time.time() – start – collect_time
self.current_learning_iteration = it
# 4) 日志:3-2 那些曲线的唯一来源
self.logger.log(it=it, start_it=start_it, total_it=total_it, collect_time=collect_time,
learn_time=learn_time, loss_dict=loss_dict, learning_rate=self.alg.learning_rate,
action_std=self.alg.get_policy().output_std, rnd_weight=None)
# 5) 存盘:见 3-3
if self.logger.writer is not None and it % self.cfg["save_interval"] == 0:
self.save(os.path.join(self.logger.log_dir, f"model_{it}.pt"))
- 循环次数由 num_learning_iterations 给,起点是 self.current_learning_iteration:从 checkpoint 续跑时它不是 0,所以轮号是接着往下数的
- 采样与 compute_returns 整段在 torch.inference_mode() 里,只有 update() 在梯度模式下跑
- 采样不需要梯度,关掉建图省的是显存与时间;compute_returns 只做 critic 前向与折扣递推,同样不需要建图
- 这个不对称正是 3-2-7 里"采样耗时明显大于更新耗时"的根,不是实现写错了
- save_interval 是隔多少轮存一次,循环结束后再补存最后一次。本工程 400 轮配 200,于是落盘的是第 0 轮、第 200 轮与最后那一轮,这就是 3-3-1 里那三个文件的来历
- init_at_random_ep_len=True 在循环之前把各环境的回合长度随机打散:4096 个环境同步开始会让复位时刻周期性重合,数据里就带上了这个节拍
- 两个只影响日志的项,顺手说清楚:
- check_for_nan 配置里没写,取默认的开。它每个控制步扫一遍 obs、reward 与 done,出现 NaN 当场抛错,比等几十轮之后看到 loss 变成 NaN 再回头查省事得多
- rnd_cfg 在本工程被解析成 None,也就是没开 RND,所以 intrinsic_rewards 那一行恒为 None
- 最后一件要说清的事:这个循环里没有早停,也没有评估。它不看成功率、也不判断有没有变好,只负责把轮数跑满。训练中途好坏只能靠 3-2 的曲线看,最终强弱要看 3-3 的离线报告,两条观察面都不是循环的一部分
3 训练与结果分析
3-1 介绍
- 本节我们配合 TensorBoard 曲线与训练结束后生成的报告图表,说明 PPO 的训练过程中应当如何判断训练是否正常,以及训练结束时策略达到了什么水平
- 两套观察面的分工不同:
- TensorBoard 是在线的,训练每轮写一次标量,回答"这一轮相比上一轮有没有变坏"
- report/ 是离线的,训练结束后在固定的评估图集上重跑,回答"最终的策略到底行不行"
- 判断一个 run 是否正常,本质上是对照三条基准:曲线有趋势、分项奖励符合设计意图、终止原因只剩成功
说人话:训练中的曲线看的是斜率,训练后的报告看的是绝对值。
3-2 训练入口与 TensorBoard
- 不同项目的 train.py 实现方式不同,核心都是对接 rsl_rl 去实现,这里不展开我们项目的全部代码,仅展示核心部分
# scripts/train.py 的核心流程
overrides = list(args.set) # –set 与几个快捷参数都归并到这里
run = load_run_cfg(args.config, overrides) # 覆盖先于 dataclass 构造应用
device = run.env.sim.device
log_dir = run.log_dir(args.log_root) # <root>/<experiment_name>/<时间戳>_<run_name>
# 时间戳只到秒:同一秒起两次会落进同一目录,两套曲线混在一起且不报错
if log_dir.exists() and any(log_dir.iterdir()):
raise SystemExit(f"日志目录已存在且非空:{log_dir}")
log_dir.mkdir(parents=True, exist_ok=True)
dump_resolved(run, log_dir / "resolved_config.json") # 解析后真正生效的那份配置
(log_dir / "describe.txt").write_text(run.describe() + "\\n", encoding="utf-8")
env_cfg = make_env_cfg(run.env, lidar_debug_vis=args.gui) # 绕开 mjlab 的任务注册表
env = NavEnv(env_cfg, device=device)
train_cfg = asdict(runner_cfg(run))
# RslRlVecEnvWrapper 构造时自己会 reset 一次(rsl_rl 不自己 reset),外层不要再 reset
wrapped = RslRlVecEnvWrapper(env, clip_actions=train_cfg.get("clip_actions"))
runner = MjlabOnPolicyRunner(wrapped, train_cfg, str(log_dir), device=str(device))
runner.learn(num_learning_iterations=run.max_iterations, init_at_random_ep_len=True)
- 本脚本故意绕开 mjlab 的任务注册表,直接调 make_env_cfg:注册表里放的是 YAML 默认值,而 register() 是幂等的,从注册表取的话 –set 写的东西一个都不生效,训练却照常跑

- 上图是 TensorBoard 的 SCALARS 面板。查看方式是训练脚本把标量写进 logs/rsl_rl/,另起一个进程读事件文件并起本地 Web 服务
tensorboard –logdir logs/rsl_rl –port 6006
- 浏览器打开 http://localhost:6006,在顶部导航里选 SCALARS(上图被选中高亮的那一项),即可看到按前缀分组的曲线
- 左栏有两个每次看图都要确认的控件:
- Smoothing:曲线的滑动平均系数,默认 0.6。原始点逐轮抖动,平滑只改绘图不改数据;判断趋势用默认值,查突变(例如 loss 或学习率的尖峰)时把它拖到 0
- Ignore outliers in chart scaling:纵轴范围按分位数而不是极值取,勾上之后个别尖峰不会独吞整个纵轴、把其余部分压成一条直线
- 横轴有 STEP、RELATIVE、WALL 三种,分别是训练轮数、相对首轮与墙上时钟;本工程报告里只有 time.png 用墙上时钟,其余都是轮数
- 左栏底部的 Runs 过滤器用于选择要显示哪几次运行:勾选框选 run,下面的正则框按实验名过滤。把改动前后的两个 run 叠在同一张图上,是判断这次改动有没有效果最直接的方式
3-2-1 分小节说明
- 下面按图分组说明,每张图给出正常形态与异常信号。读之前先记住两条前提,它们决定了这些图怎么解读:
- 报告里的地图是冻结的评估图集(env.map.eval_seed),不是训练图池里的图,一共 8 张。换一个权重重跑,图还是同一批,几张曲线正因为这样才可以横着比
- 每张图的纵轴口径不同:termination 是回合数不是比例,reward 是每秒得分不是每回合得分,perf 是秒与步数
需要本节展示的图只是一个示例,并不代表所有环境的训练都应该是这样的图!!!!!!!!!
- report/curves/ 下共八张图:train、reward、termination、loss、policy、perf、time 七组各一张,外加 all.png 全量拼接图
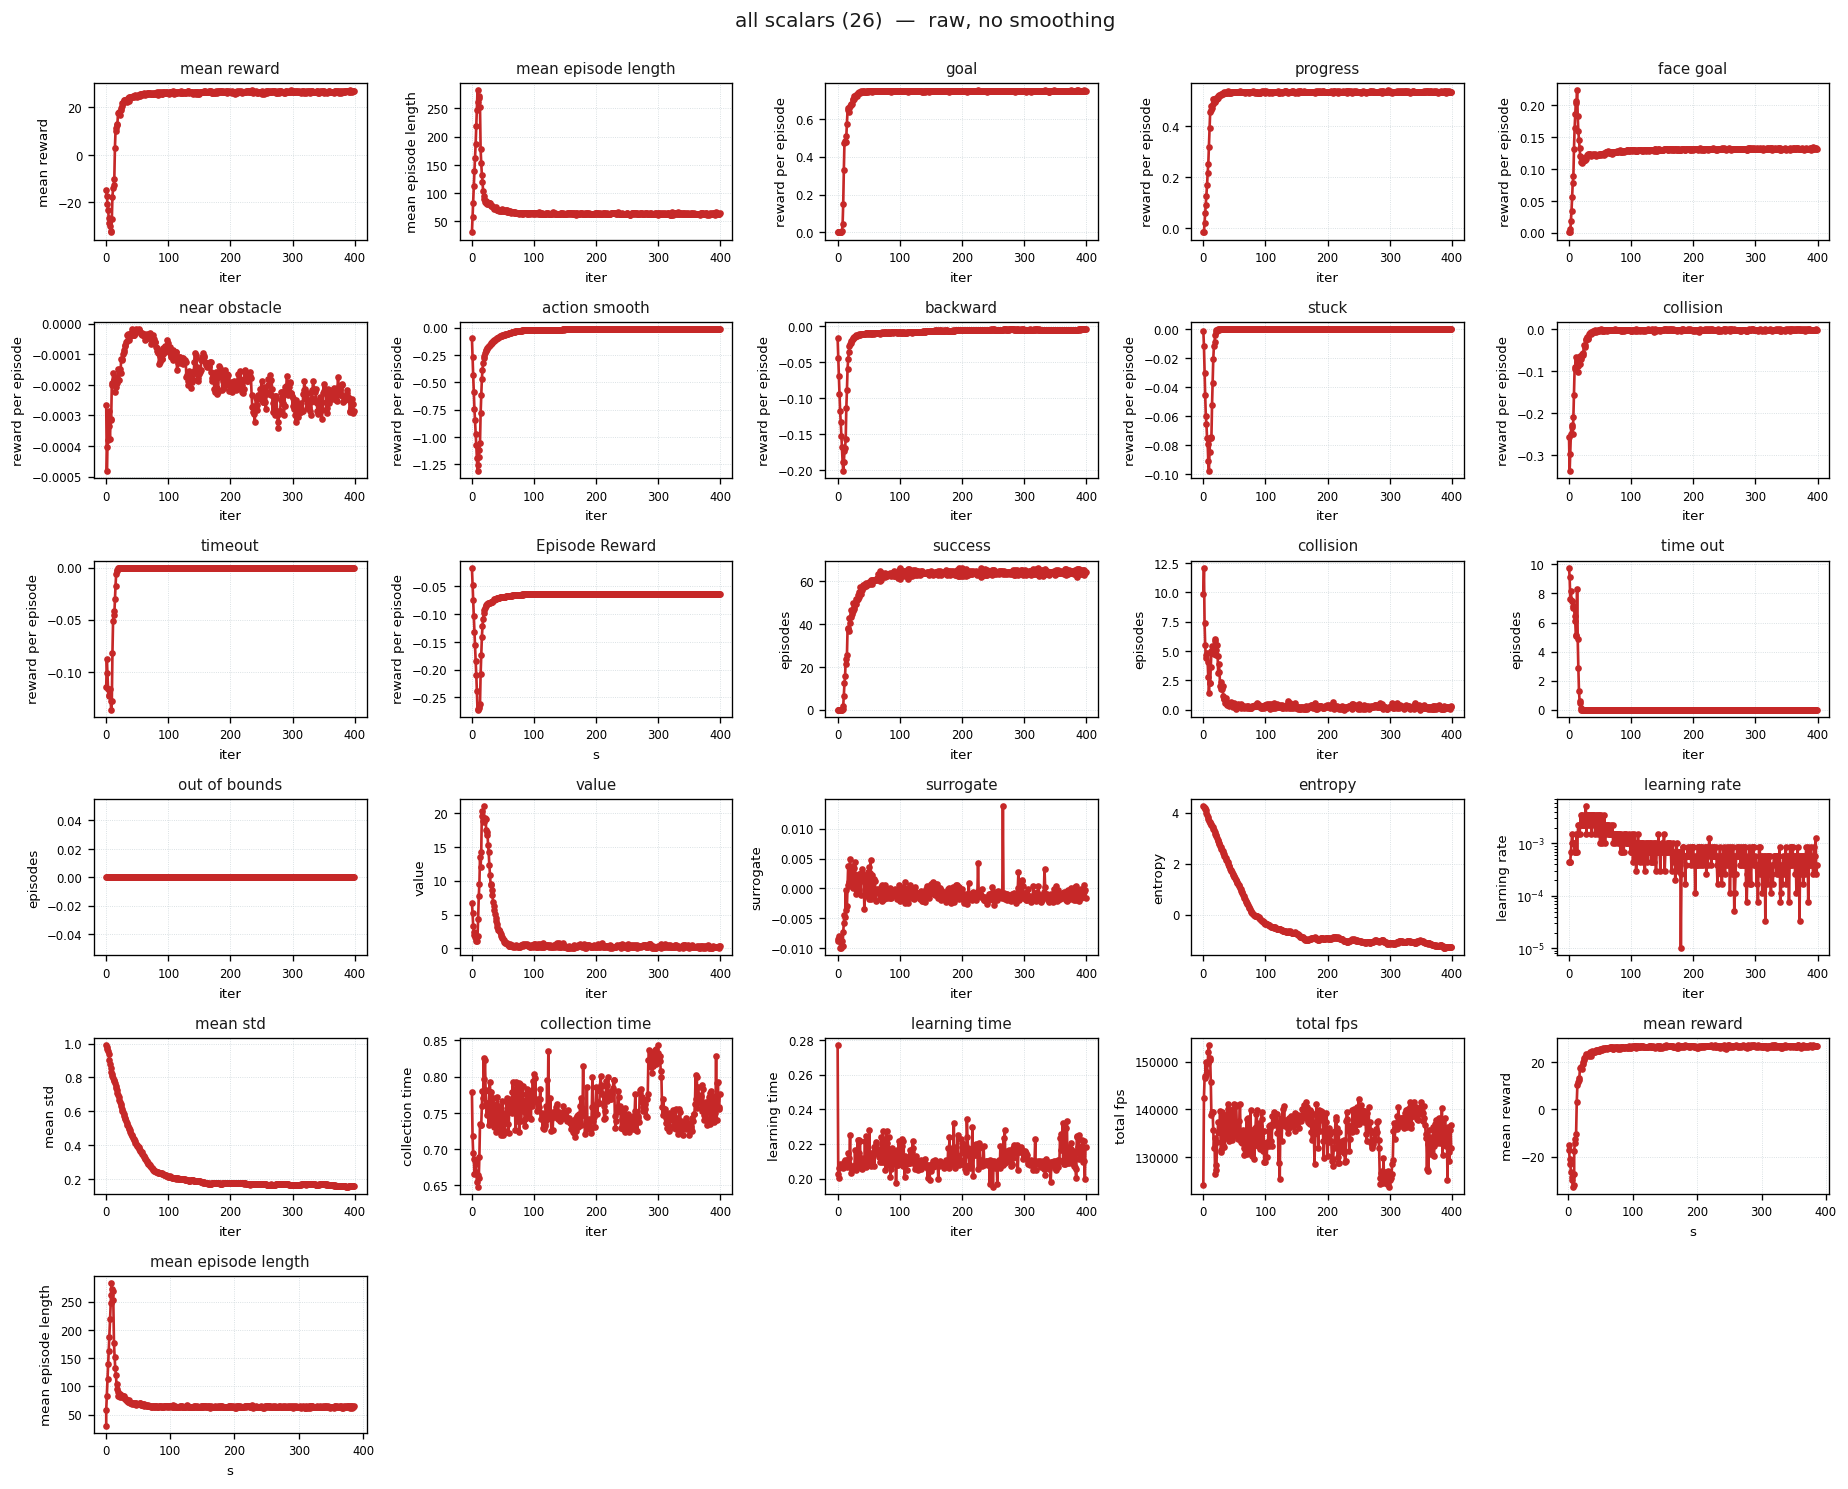
3-2-2 训练进度
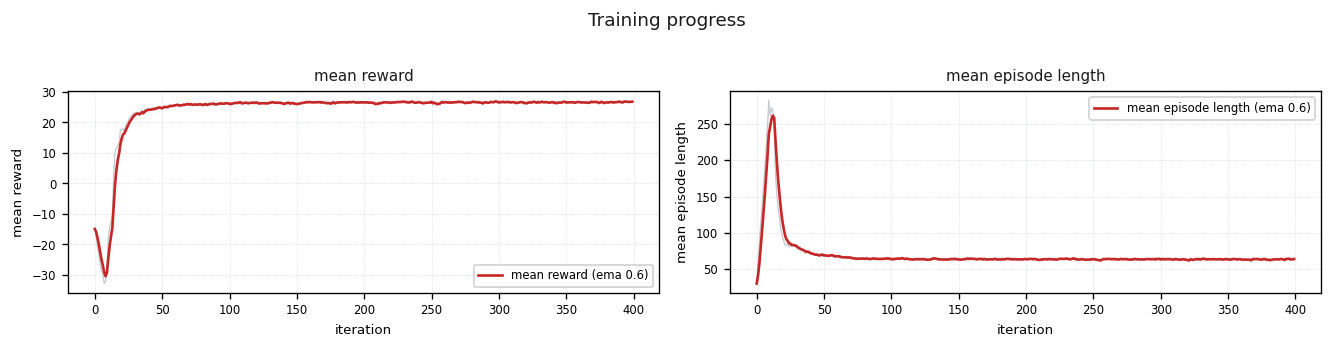
- 两张子图分别是 Train/mean_reward 与 Train/mean_episode_length
- 两者统计的都是最近 100 个已结束回合的均值,所以开局样本少、抖动大
- 正常形态:奖励在几十轮内爬升后进入平台;回合长度先升后降
- 回合长度先升后降是最容易误读的一处,它并不是性能退化:走不到目标的回合会一直跑到步数上限,早期这类长回合占多数,把均值抬高;策略学会直达目标之后,回合长度回落到与最短路步数同量级的水平
- 异常信号:奖励进入平台而回合长度仍在上升,说明策略在绕路或磨时间
- 开局奖励不升反降属于正常(随机策略先撞上 collision 与 time 这类惩罚项),但迟迟不回升就要回头查配置
3-2-3 分项奖励
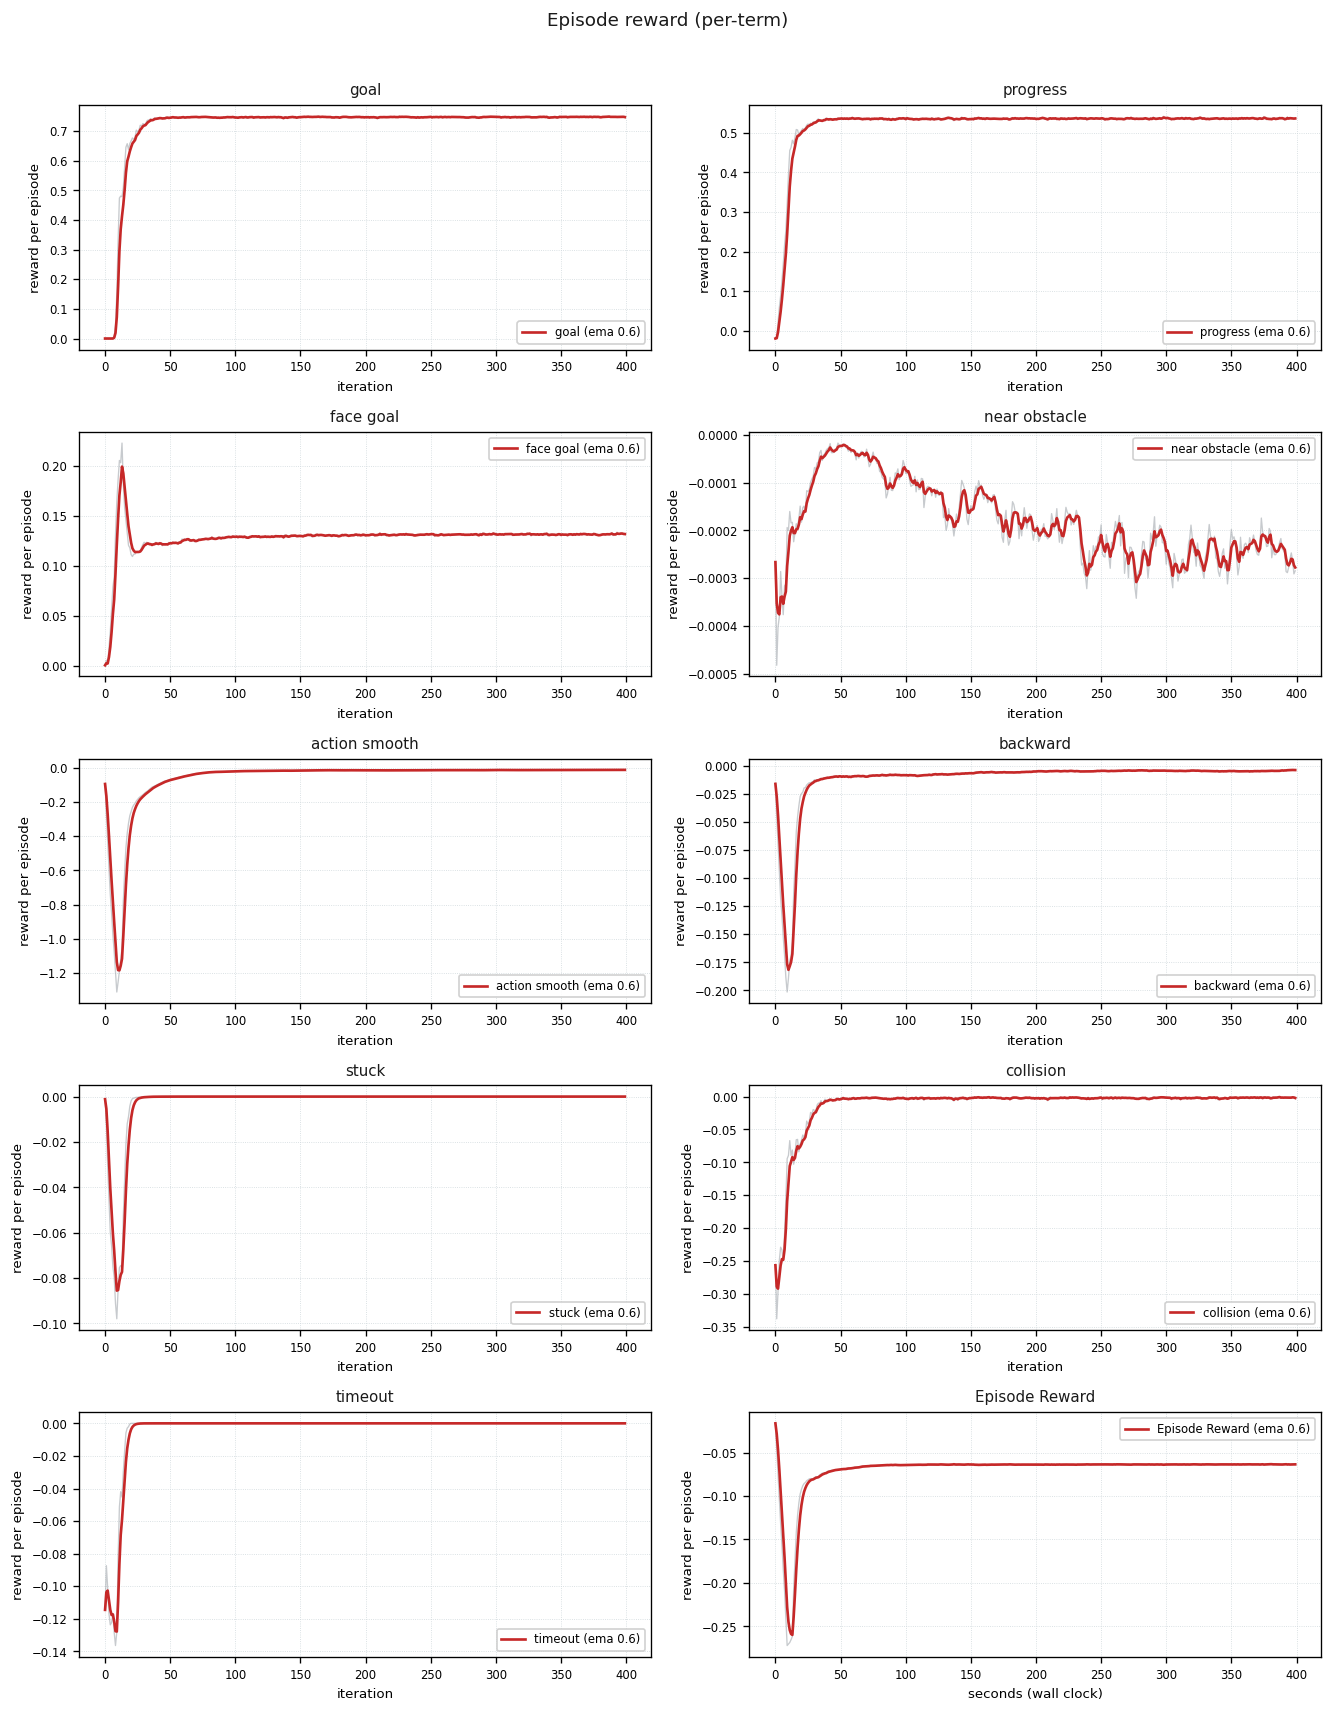
- 十张子图对应 env.reward.terms 里的十项
- 纵轴是"每回合累计值除以最大回合时长",读出来是每秒得分而不是每回合得分;乘回最大回合时长就还原成每回合累计值,十项相加等于 Train/mean_reward
- 正常形态:正向项上升后进入平台;惩罚项早期出现明显负值,随训练衰减到 0 附近,含义是策略不再触发这些行为,而不是惩罚项失效
- 异常信号:惩罚项长期不衰减(策略一直在用撞墙、倒车或原地打转换分);time 的绝对值随回合长度同步增长(在磨时间);near_obstacle 有明显负值(一直贴着墙走)
3-2-4 终止原因
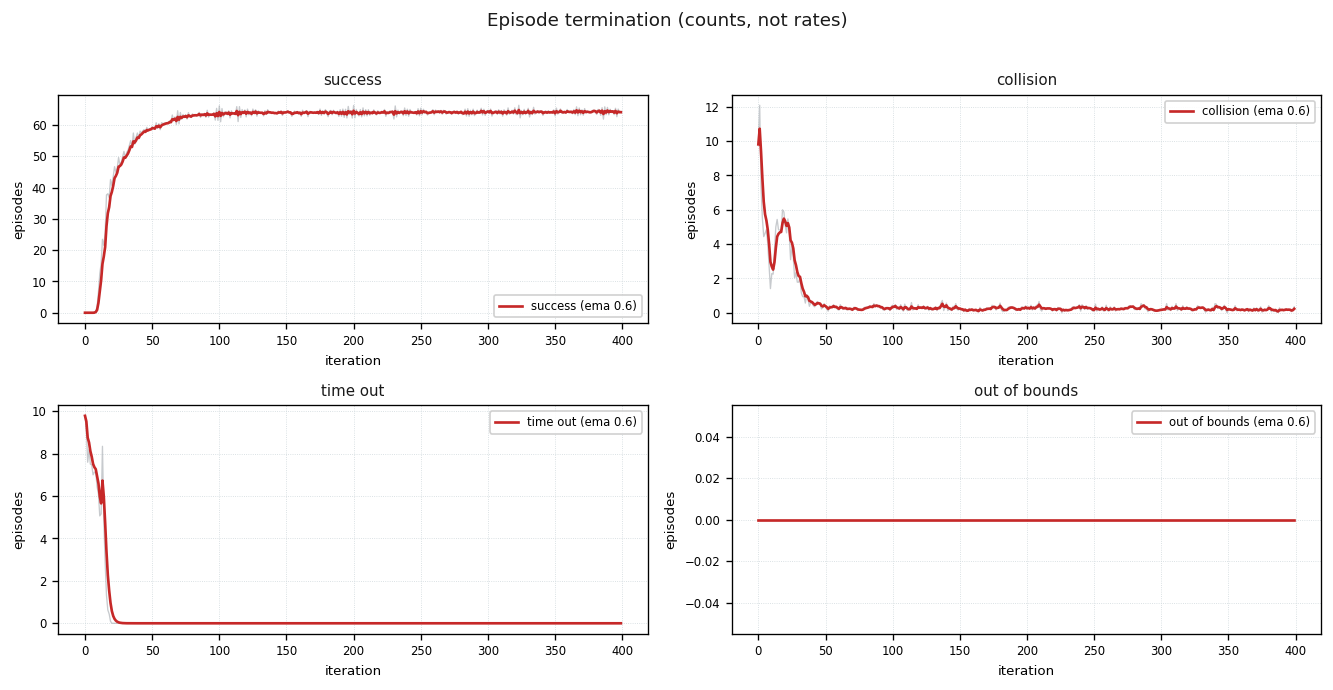
- 四张子图的纵轴是回合数而不是比例,每轮统计这一轮里有多少个回合以该原因结束
- 想看成功率,要把成功数除以当轮结束的回合总数
- 正常形态:成功是唯一长期非零并停在高位的曲线,其余三条随训练衰减到接近 0
- out_of_bounds 一旦非零要先查环境而不是策略:它意味着机器人越过了房间边界,属于物理约束或重置逻辑的问题,与学得好不好无关
- 异常信号:collision 与 success 同时居高,说明策略在贴着障碍抄近路;time_out 不降,说明策略没学会把回合收在到达那一刻
3-2-5 损失与学习率
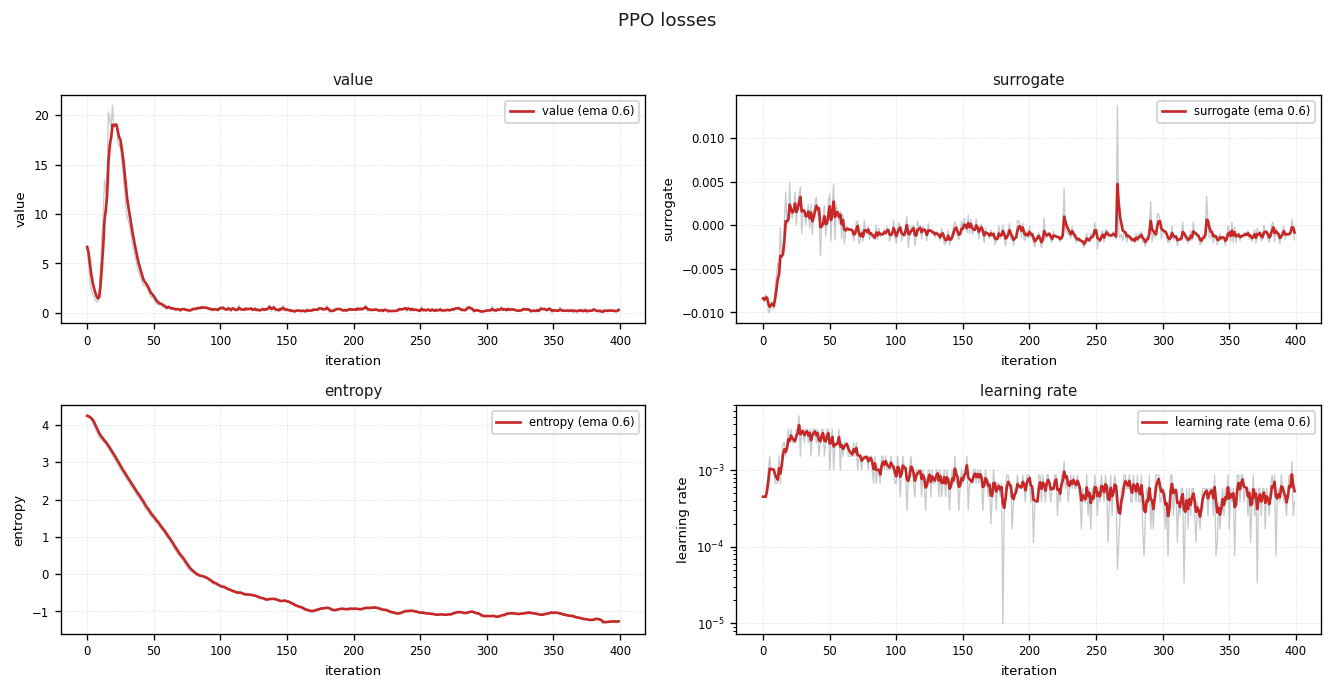
- 四张子图分别是价值损失、替代损失、熵与学习率
- 正常形态:
- 价值损失先起一个峰,之后回落到远低于峰值并趋于平稳。那个峰出现在奖励量级剧变期,价值网络在追赶变化中的回报,属于正常现象
- 替代损失全程在 0 附近小幅震荡,没有趋势。它的绝对值小是 PPO 截断机制在起作用,不能按"损失越小越好"来读
- 熵单调下降后趋于平缓。它是动作高斯分布微分熵在三轴上的和
∑
i
ln
σ
i
+
1.5
ln
(
2
π
e
)
\\sum_i \\ln \\sigma_i + 1.5\\ln(2\\pi e)
∑ilnσi+1.5ln(2πe),σ
\\sigma
σ 小于 1 时ln
σ
\\ln \\sigma
lnσ 为负,所以曲线穿过 0 并不异常 - 学习率没有固定值,由自适应调度按每轮批数据的 KL 与目标值比较,每轮乘或除一个固定倍数,在一个区间内来回升降而不用手工衰减
- 异常信号:替代损失的量级明显放大并伴随学习率长期贴着上限,说明每轮 KL 超出目标值;熵在训练早期就贴平,说明策略过早确定、探索不足,一般伴随成功率上不去
3-2-6 策略分布
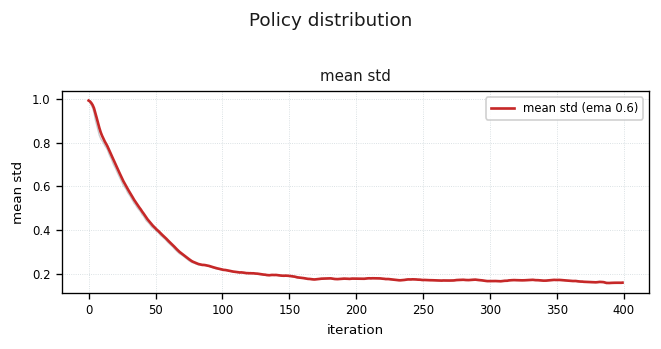
- 一条曲线 Policy/mean_std,是动作分布标准差的均值(本工程的动作标准差与状态无关,是一个可学习标量)
- 正常形态:单调下降并在一个较小的量级上稳定下来
- 它与 Loss/entropy 是同一个量的两种记法,差别只是一个固定常数与三轴求和;两条曲线的形状应当一致,形状不一致说明熵项被别的机制改过
- 异常信号:平台期仍停在较大的值(探索噪声压不下去,动作抖);过早掉到接近 0(策略退化成确定性输出,换了地图没有调整余地)
3-2-7 吞吐与耗时
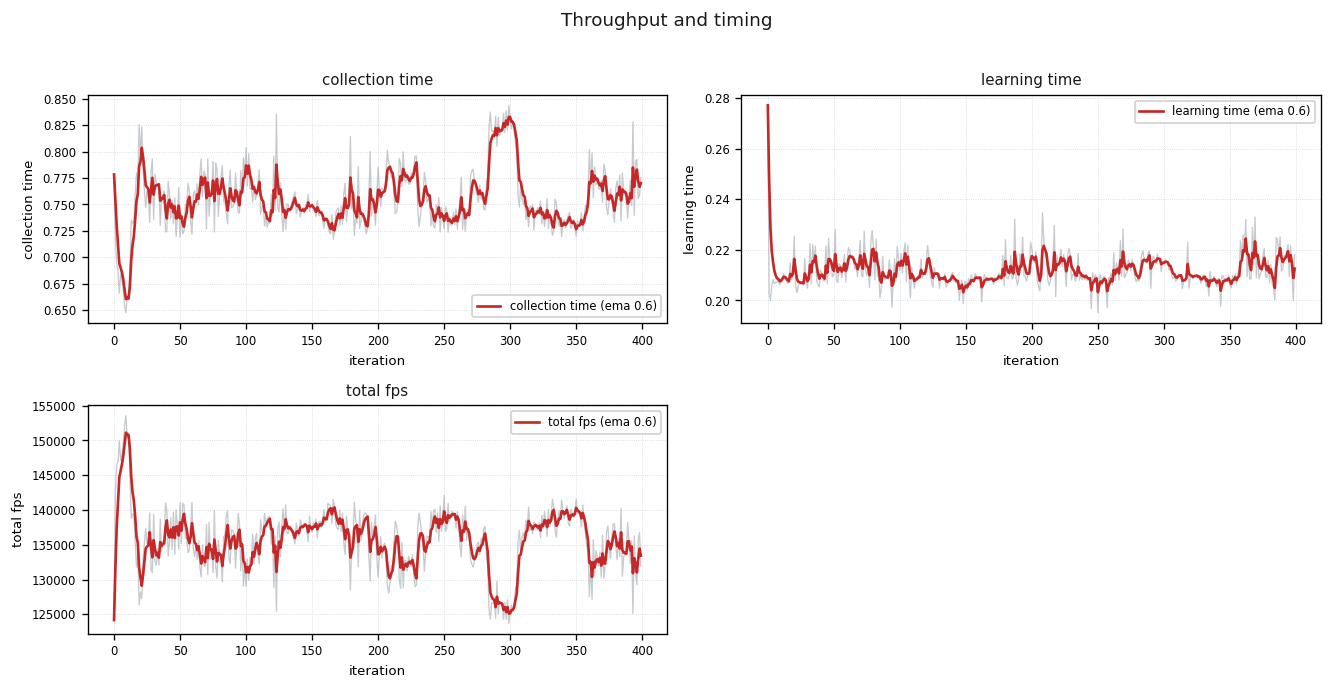
- 三张子图是每轮采样耗时 Perf/collection_time、每轮更新耗时 Perf/learning_time 与每秒环境步数 Perf/total_fps
- 正常形态:两条耗时平稳,total_fps 没有长期下滑趋势
- 采样耗时明显大于更新耗时是本工程的固有结构:每个控制步都要读雷达与接触量,加宽网络并不改变这个比例
- 异常信号:collection_time 随训练单调上升(回合变长或场景变复杂);total_fps 台阶式下跌(地图变大或内存压力)。这类下跌与策略好坏无关,但会直接改变同轮数下实际走了多少步
3-2-8 实时进度
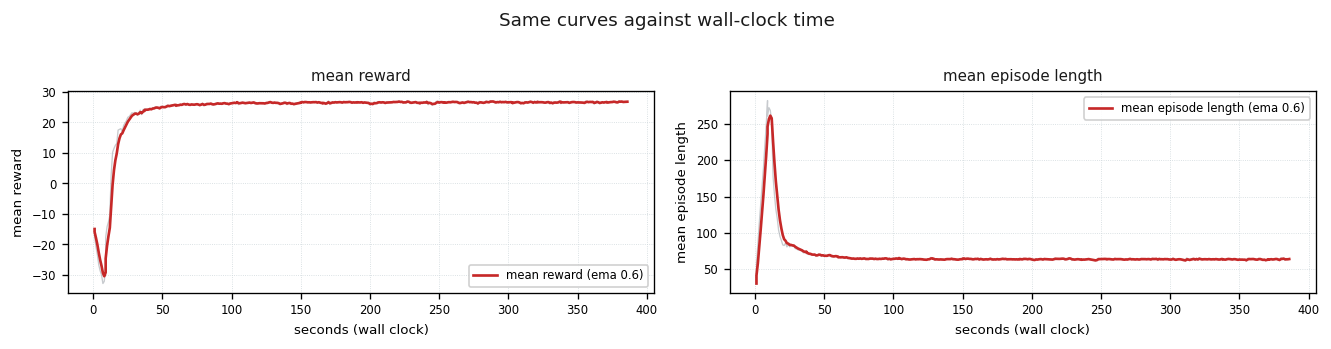
- 横轴换成墙上时钟秒数,只有 Train/mean_reward/time 与 Train/mean_episode_length/time 两条
- 它回答的是"训练跑了多久、这段时间里练到哪一步",把轮数轴上的曲线按时间摊开;斜率变化说明某一段训练变慢了
- 其余所有图的横轴都是轮数,两者不可混读
- 命名上有一个坑:Episode_Reward/time 是时间惩罚那一项奖励,名字也以 /time 结尾,但它的横轴是轮数。判断口径要看它属于哪一组,不是看后缀
3-3 PPO训练结果
3-3-1 说明
- 通过第二章的训练,ppo最终的训练结果配合你设置的参数会有几个pt文件
- 落盘节奏由 runner 配置里的 save_interval 决定:每训满这么多轮存一次,训练结束时再补存最后一次
- 本工程配的是 save_interval: 200、max_iterations: 400,于是这个 run 的目录里落了三个权重:
| model_0.pt | 第 0 轮结束 | 初始化后的策略,作为"训练之前"的对照 |
| model_200.pt | 第 200 轮结束 | 训练中途的策略 |
| model_399.pt | 训练结束 | 训完的策略,也是报告里的终局 |
- 最后一个为什么不是 model_400.pt:记住,程序猿是从0开始数数的!
- 同一个目录里还有三样东西,与权重同等重要:
- resolved_config.json:这个 run 当时真正生效的那份配置。YAML 随时可以改,事后想复现只能看它
- describe.txt:同一份配置的可读摘要
- git/rsl_rl.diff:rsl_rl 那一侧的改动快照,用来回答"这批权重对应的是哪一版代码"
- 上述的生成需要是代码实现哈(rsl_rl)默认不提供
说人话:model_*.pt 里装的是权重,不是模型。单拿一个 pt 出来,观测怎么拼、动作怎么缩放、奖励怎么设全都不知道,等于拿到一个不知道输入是什么的函数。
3-3-2 pt内容
- 一个 pt 就是 torch.save 下来的一个字典,顶层五个键:
| actor_state_dict | 策略网络与它的动作分布 | 需要 |
| critic_state_dict | 价值网络 | 不需要 |
| optimizer_state_dict | Adam 的动量与当时的学习率 | 续训才需要 |
| iter | 存盘时的轮数 | 续训才需要 |
| infos | 环境侧的记账量 | 续训才需要 |
- actor_state_dict 里的条目,以本工程 78 维观测、3 维动作为例:
| mlp.0.weight、mlp.0.bias | (256, 78)、(256,) | 第一层全连接,输入就是策略观测 |
| mlp.2.weight、mlp.2.bias | (256, 256)、(256,) | 第二层全连接 |
| mlp.4.weight、mlp.4.bias | (3, 256)、(3,) | 输出层,输出的是动作高斯分布的均值 |
| distribution.std_param | (3,) | 动作高斯分布的标准差,三个可学习标量,与状态无关 |
| obs_normalizer._mean、._var、._std | (1, 78) | 观测归一化的统计量 |
| obs_normalizer.count | 零维 | 已累计的样本数 |
- 这张表里最容易被忽略的是归一化那三行:网络吃的是归一化之后的观测,只留网络权重、把这三行丢掉,推理时喂进去的观测分布与训练时对不上,动作会明显偏
- 也就是"只装 actor 就能完整复现推理"的依据所在,归一化统计量存在 actor 这一侧,不在环境里
- critic_state_dict 与 actor 结构相同,差别只在输出层是 (1, 256),输出一个标量
- optimizer_state_dict 里只有一个参数组、十三个参数,也就是 actor 的六个权重张量、一个 std_param 与 critic 的六个权重张量共用一个优化器、共用一个学习率(见 2-7)
- infos 里是 mjlab 补进去的 env_state.common_step_counter,记的是环境一共走过多少个控制步,恢复训练时会被写回环境
3-3-3 如何使用
- 拿到一个 pt,需要自己复现的只有四件事,任何 PPO 权重都一样
- 网络结构:从 state_dict 的键反推层数与宽度,不手抄。手抄的结构在训练侧改宽之后,要么形状不匹配,要么形状恰好匹配而结构已经不同
- 预处理:策略吃的是归一化之后的观测,统计量随 actor 存在 pt 里
- 动作解码:网络输出的是动作分布的均值,取它就是确定性策略
- 契约:观测怎么拼、多少维、动作是什么量纲,这三件 pt 里没有,必须随权重一起交付
- 前三件都能从 pt 里读出来。把它们写成一份最小实现,就是一个可以直接部署的策略:
# 从一个 pt 重建策略网络:不依赖任何训练侧脚本
import torch
import torch.nn as nn
class ObsNormalizer(nn.Module):
"""观测归一化。统计量从权重里取,不在部署侧重新统计。"""
def __init__(self, mean, var, std, count, eps=1e-2):
super().__init__()
self.eps = eps
self.register_buffer("_mean", mean)
self.register_buffer("_var", var) # 推理用不到,但它是模块自带的状态,占位才有严格加载
self.register_buffer("_std", std)
self.register_buffer("count", count)
def forward(self, x):
return (x – self._mean) / (self._std + self.eps)
class ActionDistribution(nn.Module):
"""动作分布。确定性部署用不到标准差,但把它放回来,严格加载才能过。"""
def __init__(self, std):
super().__init__()
self.std_param = nn.Parameter(std)
class PolicyNet(nn.Module):
"""按 actor_state_dict 重建:层数、宽度、输入输出维度全部从权重里读出来。"""
def __init__(self, sd):
super().__init__()
idx = sorted(int(k.split(".")[1]) for k in sd
if k.startswith("mlp.") and k.endswith(".weight"))
layers = []
for i, n in enumerate(idx):
w = sd[f"mlp.{n}.weight"]
layers.append(nn.Linear(w.shape[1], w.shape[0]))
if i != len(idx) – 1: # 最后一层是输出层,其余每层后面接激活
layers.append(nn.ELU()) # 激活函数必须与训练侧一致,默认是 elu
self.mlp = nn.Sequential(*layers)
self.obs_normalizer = ObsNormalizer(sd["obs_normalizer._mean"],
sd["obs_normalizer._var"],
sd["obs_normalizer._std"],
sd["obs_normalizer.count"])
self.distribution = ActionDistribution(sd["distribution.std_param"])
def forward(self, obs):
return self.mlp(self.obs_normalizer(obs))
def load_policy(path, device="cpu"):
"""返回一个 callable:观测张量进,动作张量出。"""
# 注意:weights_only=False 会执行 pickle,所以只对自己训出来的文件这么做
sd = torch.load(path, map_location=device, weights_only=False)["actor_state_dict"]
net = PolicyNet(sd).to(device)
net.load_state_dict(sd) # 子模块的属性名与权重键名一一对应,所以能走严格模式
net.eval() # 关掉训练态行为,推理不更新任何统计量
return net
- 这段实现与训练侧唯一的耦合是键名:把子模块的属性名取成与权重键名一致(mlp、obs_normalizer、distribution),load_state_dict 就能走严格模式
- 严格模式在这里是刻意的。归一化统计量如果漏装,宽松加载不会报错(缺的键被当成"不需要"),策略却已经换了一个;严格模式让它当场红掉
- 这份实现与 rsl_rl 自己的 MLP、EmpiricalNormalization 是等价的:拿同一个 pt、同一批观测各算一遍,输出逐位相同。所以它不是"看着差不多"的近似实现,而是一份可以独立交付、独立部署的策略
- 部署时的调用只有四行:
net = load_policy("model_399.pt") # 一个 callable,放进控制循环就能用
with torch.inference_mode(): # 不建计算图,也不更新统计量
action = net(obs) # (N, 3),动作分布的均值
action = action.clamp(–clip, clip) if clip is not None else action # clip 取自训练配置,没配就不裁
v_xy, omega = action[:, :2] * v_max, action[:, 2] * omega_max # 归一化指令变物理量
- 这里冒出来的是第四件事,也是唯一没法从 pt 里读出来的:契约
- 观测的组成与顺序:本工程是 72 维雷达 + 3 维目标极坐标 + 2 维本体系速度 + 1 维角速度,共 78 维
- 每一段观测的单位与裁剪:雷达是距离除以量程,未命中取 1.0,紧贴障碍取 0 附近的小正数
- 动作的量纲:三轴是归一化速度指令,乘 v_max 与 omega_max 才是物理量
- 归一化用的是训练时的统计量,不是部署现场统计出来的
说人话:pt 是函数体,契约是函数签名。少一维、换一个顺序都不会报错,只会让策略莫名其妙地差,而差在哪里没有切入点。
- 契约必须与权重一起交付,这正是 3-3-1 里那份配置与说明文件的作用:它们和 pt 是一套东西,分开之后谁也说不清那个 pt 是什么
- 观测按契约拼出来长这样,顺序与维度都要与训练时逐位一致:
ranges, goal_dist, goal_bearing, v_body, omega = read_sensors()
obs = np.concatenate([
np.clip(ranges, min_range, max_range) / max_range, # 72 维:距离除以量程
[goal_dist, np.sin(goal_bearing), np.cos(goal_bearing)], # 3 维:目标极坐标
v_body, # 2 维:本体系前向与左向速度
[omega], # 1 维:偏航角速度
])
obs = torch.as_tensor(obs, dtype=torch.float32)[None] # (1, 78),补一维 batch
- 目标方位给 sin、cos 而不是角度,是为了避开 ±180° 处的跳变:角度表示会把"目标在正后方偏左一度"和"偏右一度"当成相距很远的状态,而它们在物理上是同一个方向
- 对接外部只有两种形态,选哪种看部署侧的语言:
- Python 侧:load_policy 返回的就是一个 callable,直接放进控制循环
- 非 Python 侧(C++、嵌入式、推理引擎):把网络导出成中间表示再调用。这一步不用自己写,rsl_rl 的策略模块自带两个导出入口:
# 导出的是完整图:归一化层在模型内部,不会漏在 Python 这一侧
runner.export_policy_to_jit("exported", "policy.pt") # TorchScript
runner.export_policy_to_onnx("exported", "policy.onnx", verbose=False) # ONNX,输入名 obs,输出名 actions
- 导出用的那两个包装类做的正是上面手写的三件事:归一化、过 MLP、取均值。所以自己写一遍的价值在于把这三步搞清楚,而不是为了绕开库
- 回到 pt 的另一种用法:接着往下训。它与推理共用同一个加载函数,靠参数区分:
runner.load(ckpt, load_cfg={"actor": True}) # 只装策略:换过 critic 结构、改过奖励的旧权重照样能评
runner.load(ckpt) # 全量:优化器动量与轮数一起装回来,从 pt 里的轮数接着数
- 确定性来自两处:eval 模式加上取均值,同一个权重、同一份观测必然得到同一个动作。要复现训练时的探索行为,就用 pt 里存的标准差去采样,而不是取均值
说人话:只装 actor 是"只要策略那一半",全量加载是"原封不动接着跑"。两件事共用同一个函数,靠这个参数分开。
3-4 PPO轨迹复现
- 我们可以读取这个pt,部署一下
- 部署就是 3-3-3 里那件事:加载 actor、不更新权重、按动作分布的均值输出。轨迹复现只多一条对齐要求,用冻结的评估图集,与出指标时是同一批图、同一批起始位姿,否则两次跑出来的差异里混进了"这次图不一样"
- 这里我们可以加载环境,绘制出不同pt对应的轨迹
- 轨迹图是在内存里采完直接画的,不是事后补画:折线只活在采集过程里,环境一复位机器人的位姿就没了,刚才走的那条线没有任何地方存着
- 于是顺序是固定的:建一次环境,逐个权重加载策略、跑满一个回合集,把每个环境那一条折线记下来,最后统一出图
- 有两个约定决定了采出来的数据可不可用:
- 建环境用 auto_reset=False:自动复位会让终止那一帧被立刻覆盖,最后停在哪、为什么停就都丢了
- 每个环境只记第一回合:一个三步就撞的环境在一个回合集的预算里能产出几十个回合,全记下来是一小撮短回合把分母灌满,长回合反被挤掉
- 这里我们给出部分代码
- 下面是这一段的骨架,函数名按职责取,与具体工程的命名无关
# 复现轨迹的骨架:一次建环境,逐个权重跑一个回合集,最后统一出图
# 1. 建一次环境。auto_reset=False 才读得到终止那一帧
env = make_env(cfg, auto_reset=False)
opt = np.array([optimal_length(lay, cfg.map) for lay in layouts]) # SPL 的分母
templates = [lay.template for lay in layouts]
budget = int(cfg.episode.max_length) + 2 # 超时也是终止,必然在这之内结束
for it, ck in checkpoints: # 要评的权重,例如 200 与 399
# 2. 装权重、取推理策略:与 3-3-3 是同一件事
policy = build_policy(ck, env, cfg)
tracker = RolloutTracker(optimal_length=opt, templates=templates)
# 3. 跑满一个回合集:折线、终止原因、路径长度比都记在 tracker 里
run_rollout(env, policy, tracker, n_envs=n_envs, budget=budget)
# 按环境号取轨迹:环境是异步终止的,回合号与地图号不是一回事
traj[it] = {tracker.env_of(k): tracker.trajectory(k)
for k in range(len(tracker.outcomes()))}
del policy # 每个权重用完即弃,否则几个权重一起占着显存
env.close()
-
上面那个 optimal_length 与轨迹图一起,就是导航通用指标的分母。两个指标的口径在这里简单交代,它不是本文的重点:
- 成功率 SR:是否在步数耗尽前进入到达半径。到达判据是一个半径 goal_radius 的圆盘而不是一个点,所以贴着目标绕一小圈也算成功,SR 天然比"必须停在点上"宽松
- SPL:
S
P
L
=
S
⋅
ℓ
∗
/
max
(
p
,
ℓ
∗
)
\\mathrm{SPL} = S \\cdot \\ell^{*} / \\max(p, \\ell^{*})
SPL=S⋅ℓ∗/max(p,ℓ∗),其中S
S
S 是这一回合是否成功,p
p
p 是实际路程,ℓ
∗
\\ell^{*}
ℓ∗ 是最短路 - 分母里的
max
\\max
max 是公式的一部分,不是补丁:走得比最短路还短时不额外加分。少了它会刷出大于 1 的分去抬高平均值,而"比最短路还短"通常说明最短路算粗了,不是策略更强 - 失败回合的 SPL 记 0 而不是不记,于是 SPL 恒不超过 SR,两个数同向
- 路程
p
p
p 由相邻控制步的位置增量累加:不降采样、也不扣掉被墙弹回的位移,否则绕行会被抹掉,而 SPL 的全部意义就是惩罚绕行 - 最短路
ℓ
∗
\\ell^{*}
ℓ∗ 在折线上量,不在栅格路径上量。栅格阶梯效应会让一条斜线长出四成,那会系统性抬高所有 SPL
-
这两个数由评估脚本在固定的评估图集上算,逐图一行记进报告;PPO 本身不优化它们,它们只是训练结果的度量
-
采集循环里几乎每一行都踩在一个"错了不报错"的约定上,内层单独看:
# 采集循环的内层
snap = env.snapshot() # 这一帧就是终止那一帧,auto_reset=False 的全部意义
tracker.observe(snap.xy, snap.goal, snap.reason, snap.contact)
done = snap.done_mask()
fresh = done & ~recorded # 只收每个环境的第一回合
if fresh.any():
tracker.finalize(fresh)
recorded |= fresh
if not recorded.all(): # 终止了的环境必须复位,否则下一步直接抛错
obs = env.reset(env_ids=np.flatnonzero(done))
action = np.asarray(policy(obs), dtype=np.float32)
if clip is not None: # 与训练同一份 clip_actions
action = np.clip(action, –clip, clip)
obs = env.step(action)
- 出图这一步与显卡无关:轨迹采完之后,画图只要 matplotlib。逐图一张,再用同一份数据拼一张总览
plot_grid(items, cfg.map, "trajectories_all.png",
goal_radius=cfg.episode.goal_radius, robot_radius=cfg.robot.radius,
ncol=4, # 每行四张图
legend_labels=[f"iter {it}" for it in iters]) # 图例按训练先后排
- 效果如下:
- 每一张子图对应评估图集里的一张图,同一个权重在八张图上是一种颜色,颜色顺序见图底部的图例
- 读这张图要看的四处:
- 深色带贴着墙的那一圈,是膨胀吃掉的通过半径;轨迹压进去说明规划器认为那儿不通
- 起点是实心圆并带朝向,终点是空心蓝圈,半径是 env.episode.goal_radius
- 灰点线是起点到终点的直线。门控要求它必须被挡住,所以它一定是穿墙的,那是设计不是 bug
- 这张图能回答的问题有两层:
- 同一张子图里两个权重比,回答"训练有没有变好"
- 同一个权重横着看八张子图,回答"哪些地图还没拿下",也就是泛化
总结
- 本文用一个二维激光雷达导航任务,把 PPO 从单步交互一路拆到权重部署:观测怎么构造、动作怎么采样、奖励与终止怎么判、rollout 怎么收集、GAE 与 return 怎么合成、mini-batch 怎么更新,以及训练曲线怎么看、训出来的 pt 怎么接出去。
- 核心要点回顾:
- 观测:每一项自己负责把自己弄到 O(1),归一化的分母取自配置或本回合的量,不写场景常量;只有仿真知道的特权量只允许进 critic 组,这就是非对称 AC 的收益所在
- 一步:act 采样并记下对数概率与价值,step 推进环境,process_env_step 把这条 transition 写进缓冲区;rsl_rl 不调用 reset,复位由包装器构造期与 auto-reset 完成
- 一轮:一次 rollout 采到的数据要被反复使用
5
5
5 个 epoch,每个 epoch 再切成4
4
4 个 mini-batch;截断替代损失、价值损失与熵项合成总 loss,学习率由 KL 自适应升降,梯度裁剪兜底 - 并行:
4096
4096
4096 个环境各走32
32
32 步凑成一个 rollout,共131072
131072
131072 条 transition,mini-batch 怎么切决定了同一批数据的训练强度 - 怎么看:训练中用 TensorBoard 看趋势,训练后用报告看绝对值,两者回答的不是同一个问题
- 怎么交付:pt 里只有网络权重与归一化统计量,观测与动作的契约必须跟着权重一起交付,否则换个人接上去就是另一套策略
- 如有错误,欢迎指出!
- 感谢观看!