Python数据采集教学项目实战指南
1. 项目背景与需求分析\"数据采集作业2 102302111 海米沙\"这个标题看似简单,实际上包含了多个关键信息点。作为一名长期从事数据采集工...
1. 项目背景与需求分析\"数据采集作业2 102302111 海米沙\"这个标题看似简单,实际上包含了多个关键信息点。作为一名长期从事数据采集工...
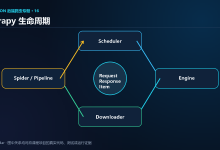
Python后端爬虫专题16:代码只有两个回调,数据却走了十站——从Engine到Pipeline理解Scrapy上一篇练习完整答案...
前言 2026年的小红书,早已不是那个单纯的“境外购物攻略”社区。今天,它是中国3.5亿月活用户每日“种草”与“被种草”的第一阵地,是品牌方新品首发的重要战场...
1. 社交媒体用户关系网络分析概述在当今数字化社会中,社交媒体平台积累了海量用户交互数据,这些数据背后隐藏着复杂的社交网络结构。通过...
Python Scrapy 爬虫框架:分布式数据采集实战指南Scrapy 是 Python 生态中最强大的爬虫框架,它异步、可扩展、...
一、为什么要用Scrapy? 在大数据时代,数据就是企业的核心资产。而获取外部数据最直接的方式之一,就是爬虫。目前主...
爬虫开发中,请求—下载—解析—存储是最基础的四段流水线。请求和下载部分各语言方案大同小异,真正拉开效率差距的是解析层。Beautif...
1. 项目概述:智能比价爬虫系统的核心价值 在电商购物时,我们经常遇到同一商品在不同平台价格差异巨大的情况。作为技术从业者,我花了三个月时间开发了一套基于Py...
Scrapy 是一个用 Python 编写的高性能、可扩展的开源网络爬虫框架,原生设计为单机架构,不直接支持分布式爬虫。但通过结合外...
前言 在 Scrapy 爬虫开发与部署过程中,下载延时(Download Delay) 是保障爬虫稳定运行、规避目标站点反爬机制、降低服务器访问压力的核心配置...
 admin