Python后端爬虫专题16:代码只有两个回调,数据却走了十站——从Engine到Pipeline理解Scrapy
上一篇练习完整答案
授权链路是:① GET /login,服务器在 HTML 中给出表单 CSRF token,并通过 Set-Cookie 产生 targetlab_csrf;② 同一个 Session POST 用户名、密码和 token,请求自动携带 CSRF Cookie;③ 校验成功的响应通过 Set-Cookie 产生 targetlab_session;④ Session GET /internal/jobs,自动携带会话 Cookie。CSRF Cookie 证明 token 与发起表单的浏览器会话相符,session Cookie 才代表登录身份。
运行 pytest tests/test_auth_session.py -q 时,正确账号应获得内部页面;错误密码触发 AuthenticationFailed,底层状态为 401;伪造 CSRF 得到 403。二者都不适合盲目重试:凭据错误重复提交可能触发锁定,CSRF 错误说明流程或页面合同已变化。
可直接采用的授权清单为:系统与数据负责人姓名;书面授权编号和有效期;允许的 scheme、host 与路径;禁止字段;专用只读账号权限;每秒与每日限额;维护窗口;凭据存储和轮换责任人;发现 401/403/429、数据异常或负责人撤销授权时的自动停止开关;日志与快照保留期。没有这些信息,技术上能登录也不代表应该采集。
为什么已有 HTTPX 还要学 Scrapy
JobRadar 的顺序与 asyncio 流水线适合后端开发者理解每一层;Scrapy 则把请求调度、去重、下载中间件、robots、重试、节流、统计和 Feed 导出组织成成熟运行时。当来源更多、链接图更复杂、需要持续调度时,它能少写大量基础设施。
但迁移不意味着重写数据规则。parse_listing、parse_detail 与 JobItem 已经经过测试,Scrapy 只负责何时发请求、把响应交给哪个回调。框架适配器越薄,两个采集入口越不容易产生两套字段口径。
跟踪一个列表请求的完整旅程
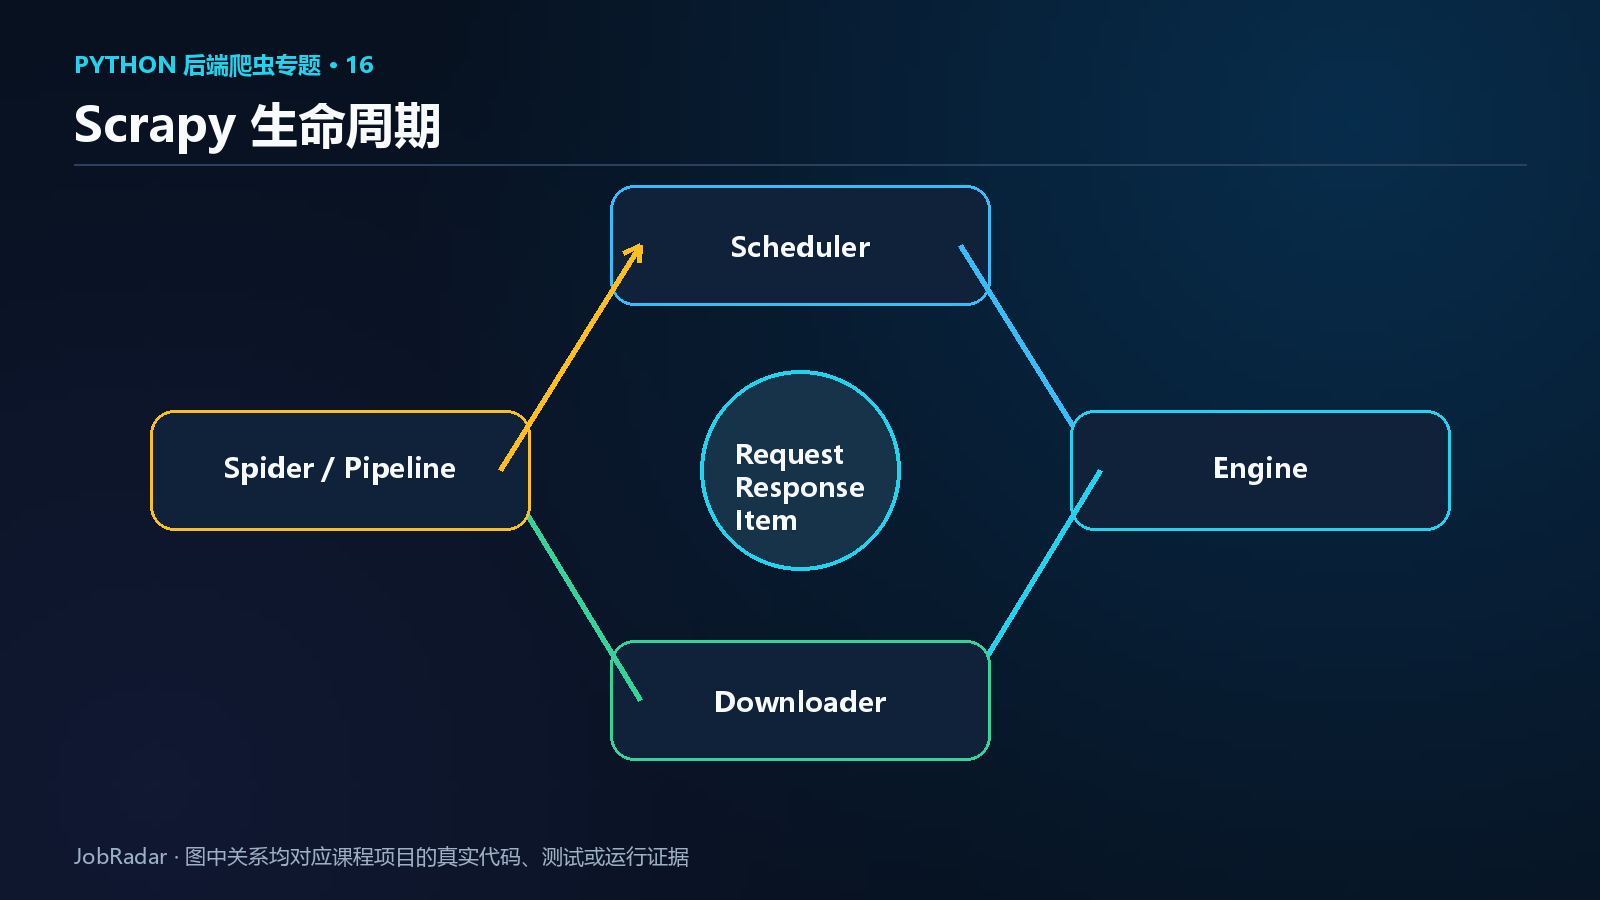
Spider 产生 Request 后,Scheduler 去重并入队;Engine 取出请求,依次经过 downloader middleware;Downloader 发出网络请求;Response 逆向经过中间件回到 Engine;Engine 根据 Request.callback 调用 parse;回调可以 yield 新 Request 或 item;Request 再回 Scheduler,item 则经过 Item Pipeline;最后 Stats Collector 汇总计数和耗时。
这里的 “Pipeline” 是 Scrapy item pipeline,不等于 JobRadar 的 pipeline.py 应用服务。前者通常做 item 清洗、持久化或丢弃,后者组织 HTTPX、快照、解析与 Repository。命名相似但调用者不同,面试时应能说清。
JobSpider 的两个回调
构造函数接收绝对 seed_url,验证 scheme 与 hostname,从中生成 start_urls 和 allowed_domains。列表回调 parse 把 response.text、response.url 交给共享 parse_listing,为每个详情 yield 一个 Request,并为 next_url yield 回到 parse 的分页请求。
详情回调 parse_job 调共享解析器得到 Pydantic 模型,然后 model_dump(mode="json")。mode="json" 会把 date 转为字符串,使 Scrapy Feed exporter 能直接序列化。若 yield JobItem 对象或 Selector,下游合同就不稳定。
运行本篇检查点:
cd project
.\\.venv\\Scripts\\python.exe –m pytest tests\\test_framework_adapters.py::test_scrapy_spider_emits_detail_and_pagination_requests –q
测试创建真实 HtmlResponse 并调用 Spider 回调,断言产生两个详情 Request 和一个分页 Request,还检查 callback 分别指向 parse_job 与 parse。它不启动公网下载,所以运行稳定;验证的是我们的路由合同,不是重测 Scrapy 的 Downloader。
yield 为什么不是 return list
生成器每获得一个结果就交还 Engine,不必等整页所有链接装进列表后再返回。更重要的是,Scrapy 会识别 yield 对象类型:Request 进入调度,dict 进入 item 流。若 return [requests],简单场景也可能工作,但失去流式表达,异常位置与扩展中间件都更难理解。
回调不是我们主动调用的普通业务函数,而是 Engine 在响应回来后调用。因此 callback 只传函数对象 self.parse_job,不能写成 self.parse_job();后者会在创建 Request 时立刻执行,而且没有 response 参数。
去重、allowed_domains和业务规范化各做什么
Scheduler 的请求指纹避免相同请求重复调度;allowed_domains 防止链接意外爬离站点;JobRadar normalize_url 清掉 fragment 和跟踪参数;数据库唯一约束保证跨运行幂等。四者保护不同阶段,不能说“Scrapy 自带去重,所以数据库不需要唯一键”。重启、参数差异和不同 Spider 运行都可能绕开内存/磁盘调度去重。
哪里会失败
构造时种子不是绝对 HTTP URL,应尽早 ValueError;列表结构改变,parse_listing 返回空或明确报错;详情缺字段,Pydantic/PageParseError 让 item 不进入数据库;网络失败由 RetryMiddleware 按配置处理。生产项目还需监听 spider_error、item_dropped 等信号,把错误与业务 task_id 关联。
本篇完整 Scrapy 适配模块
先只理解“请求如何流动”,不要急着加数据库 Pipeline。本模块刻意保持薄:解析规则只有一份。下一篇会真正执行 Spider 并检查 JSON 输出。
"""让 Scrapy 的调度能力复用 JobRadar 已验证的解析合同。"""
from collections.abc import Iterable
from urllib.parse import urlsplit
import scrapy
from scrapy.http import Response
from jobradar.parsing import parse_detail, parse_listing
class JobSpider(scrapy.Spider):
"""采集 TargetLab 列表与详情;item 字段与 JobItem 完全一致。"""
name = "jobradar_jobs"
custom_settings = {
"ROBOTSTXT_OBEY": True,
"AUTOTHROTTLE_ENABLED": True,
"CONCURRENT_REQUESTS_PER_DOMAIN": 2,
"DOWNLOAD_TIMEOUT": 10,
"RETRY_HTTP_CODES": [429, 500, 502, 503, 504],
"FEED_EXPORT_ENCODING": "utf-8",
}
def __init__(self, seed_url: str, *args: object, **kwargs: object) –> None:
super().__init__(*args, **kwargs)
parts = urlsplit(seed_url)
if parts.scheme not in {"http", "https"} or not parts.hostname:
raise ValueError("seed_url must be an absolute HTTP(S) URL")
self.start_urls = [seed_url]
self.allowed_domains = [parts.hostname]
def parse(self, response: Response, **kwargs: object) –> Iterable[scrapy.Request]:
listing = parse_listing(response.text, response.url)
for detail_url in listing.detail_urls:
yield scrapy.Request(detail_url, callback=self.parse_job)
if listing.next_url:
yield scrapy.Request(listing.next_url, callback=self.parse)
def parse_job(self, response: Response) –> Iterable[dict[str, object]]:
item = parse_detail(response.text, response.url)
yield item.model_dump(mode="json")